취약점을 찾은 에이전트를 다른 에이전트가 반박한다, Cloudflare의 보안 감사 스킬
Cloudflare의 오픈소스 security-audit 스킬을 부품별로 뜯었습니다. 정찰·장부·사냥꾼·검증자·검증 스크립트·샌드박스가 각각 무엇을 건네받고 무엇을 남기는지, 사내 수치는 어떻게 읽는지 정리했습니다.
Cloudflare가 GitHub에 MIT 라이선스로 공개한 security-audit 스킬의 핵심은 에이전트를 몇 개 띄우느냐가 아니라 “찾은 쪽은 자기 결과를 채점하지 못한다”는 규칙 하나입니다. 정찰, 장부, 사냥꾼, 점검관, 검증자, 검증 스크립트, 샌드박스, 예산 같은 부품은 모두 이 규칙이 깨지지 않게 받치는 장치이고, 이 규칙이 보고서에서 “확정”이라는 단어에 무게를 줍니다. 2026-10-27 UTC 기준 저장소는 별 4만 8천 개(48.2k), 포크 3천 개, 커밋 14개이며 마지막 커밋은 9월 14일입니다. 이 글은 그 저장소의 파일을 겉에서 속으로 열어 가며, 부품마다 무엇을 건네받고 무엇을 남기는지 따라갑니다.
설치하면 내려오는 스무 개 파일 중 코드는 네 개
설치는 skills.sh의 Skills CLI로 합니다. 사용자 계정 전체에 깔려면 --global을 붙이고, 에이전트를 고르는 옵션은 npx skills --help에 나옵니다.
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
스킬 폴더(skills/security-audit/)에는 파일이 20개 들어 있습니다. 열다섯 개는 에이전트가 읽는 마크다운이고 하나는 결과 규격 JSON이며, 실행되는 코드는 검증 스크립트 두 개와 그 시험 파일 두 개가 전부입니다.
skills/security-audit/
├── SKILL.md                         진입점: 모드, 안전 규칙, 프로필·예산, 원칙
├── RECONNAISSANCE.md                1단계 지침 (정찰, 장부 만들기)
├── HUNTING.md                       2단계 지침 (사냥꾼 배정, 점검관)
├── VALIDATION-AND-REPORTING.md      3~6단계 지침 (검증, 출력, 재검증, 보고)
├── ATTACK-CLASSES.md                기본 공격 유형 9개, 동반 문서를 고르는 규칙
├── (동반 문서 10개)                 메모리 안전·바이너리, AI·LLM, 웹 프로토콜·인증,
│                                    클라이언트, 공급망·릴리스, 클라우드·배포,
│                                    RPC·메시징, 자원 고갈, 데이터 격리, 데스크톱·모바일
├── report-schema.json               결과 기록 규격
├── validate-findings.cjs            + 시험 파일
└── validate-coverage-ledger.cjs     + 시험 파일
요구 사항은 두 가지입니다. 도구 호출과 병렬 서브 에이전트를 지원하는 모델이 붙은 코딩 에이전트, 그리고 검증 스크립트를 돌릴 Node.js입니다. 첫 실행은 다음 순서입니다.
- 감사할 저장소의 커밋을 정리하고 그 폴더에서 에이전트를 시작합니다. 스킬은 검토한 커밋과 작업 트리가 깨끗했는지를
run-metadata.json에 적습니다. - README의 예시처럼 요청합니다.
security audit this codebase,find security vulnerabilities in ./src,do a security review, output to ~/audits/my-project같은 문장입니다. - 요청이 모호하면 에이전트가 파일을 만들기 전에 한 가지만 되묻습니다. 보고서 파일까지 만드는 전체 감사인지, 궁금한 부분만 보는 것인지입니다.
- 끝나면 출력 폴더의
REPORT.md첫 절에서 범위, 프로필, 부분 점검 여부, 예산부터 읽습니다.
모드는 둘입니다. 기본인 “안내 모드”는 필요한 부분만 쓰고 파일을 만들지 않으며, 감사나 모의 침투 요청, 종합 점검, 보고서 파일 요청이 있을 때만 “전체 감사 모드”가 여섯 단계를 모두 돌립니다. 출력 폴더를 지정하지 않으면 ~/security-audit-skill/<저장소 이름>/run-<번호>에 쓰고, 버전 관리가 완전히 무시하는 폴더를 직접 고른 경우에만 대상 저장소 안에 씁니다. 한 번 돌리면 다음 구성이 생깁니다.
~/security-audit-skill/my-project/run-1/
├── run-metadata.json      프로필, 범위, 예산, 검토한 커밋, 실행 상태
├── architecture.md        정찰 결과 (약 1,000단어)
├── coverage-ledger.json   칸마다 상태와 점검 기록
├── findings.json          확정 / 검증 필요 / 기각 기록
├── REPORT.md              범위, 요약, 확정 표, 검증 필요 표, 보강 권고, 장부 요약
├── FINDINGS-DETAIL.md     확정된 중간 이상 건의 경로와 수정안
├── NEEDS-VALIDATION.md    풀리지 않은 건의 막힌 이유와 확인 계획
└── agents/<id>/           에이전트별 scratch/ 와 artifacts/
여섯 칸 몸통에서 새 에이전트가 맡는 자리
README는 감사를 정찰, 장부 중심 사냥, 후보 검증, 구조화 출력, 기록 재검증, 보고의 여섯 단계로 나눕니다. 아래 그림은 칸마다 일하는 쪽과 남기는 파일을 한 장에 놓은 것입니다. 주황은 새로 부른 에이전트, 어두운 칸은 부모(감사를 총괄하는 에이전트)나 스크립트가 하는 일입니다.
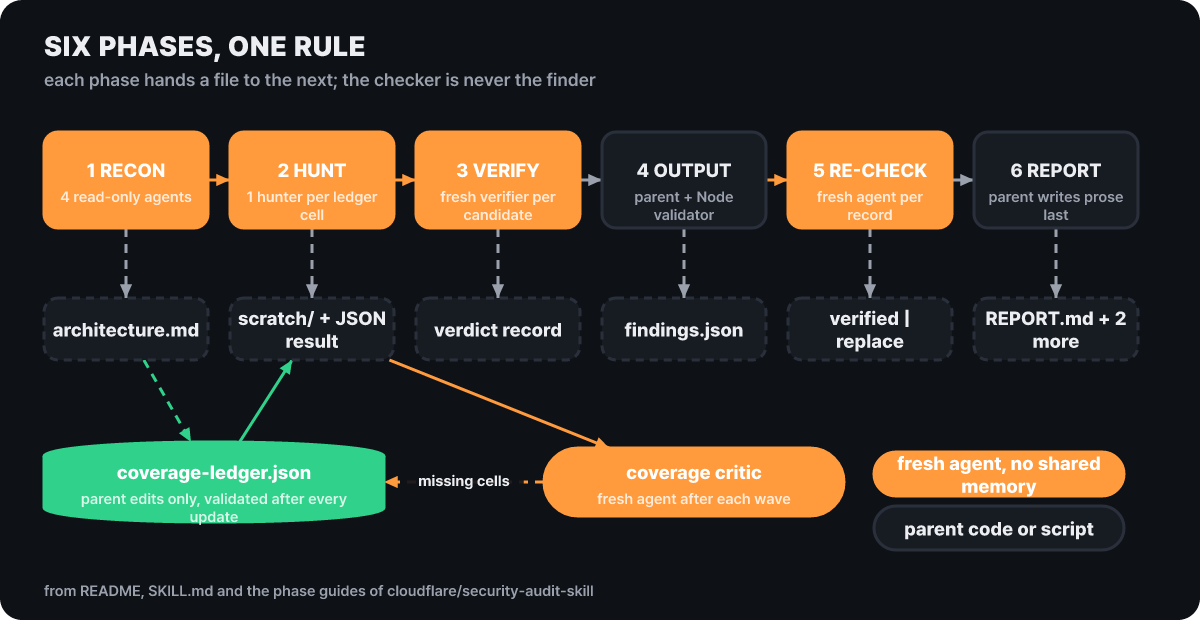 그림 1. 에이전트가 일하는 칸(주황)과 부모·스크립트가 일하는 칸(어두운 색)이 번갈아 나온다
그림에서 눈여겨볼 것은 파일을 쓰는 쪽입니다. 장부와 findings.json을 고칠 수 있는 것은 부모뿐이고, 사냥꾼은 자기 임시 폴더(scratch/) 밖에 쓰지 못합니다. 에이전트는 결과를 JSON 하나로 돌려줄 뿐이며, 그것을 장부에 반영하고 검증 스크립트에 통과시키는 것은 부모의 몫입니다. 상태를 쥔 쪽과 일하는 쪽이 갈라져 있어서 에이전트 하나가 잘못 판단해도 장부 전체가 오염되지 않습니다.
Cloudflare 블로그(Build your own vulnerability harness, 2026년 6월 18일)가 설명한 원본 스킬은 지금의 공개판과 조금 다릅니다. 약 450줄짜리 스킬로 시작했을 때는 정찰 에이전트가 셋이었고 단계는 일곱 개였으며, 마지막 일곱 번째가 살아남은 결과를 사내 수집 API로 보내는 일이었습니다. 공개판은 사내 시스템에 의존하는 마지막 단계를 빼고 보고서로 끝나는 여섯 단계이고, 정찰은 넷으로 나뉘어 그중 하나가 “로컬에서 어디까지 돌려 볼 수 있나”를 맡습니다.
한 가지 한계도 구조에서 바로 보입니다. 스킬은 마크다운 지침이라서 “새 에이전트를 부르라”는 규칙을 실제로 지키는지는 스킬을 돌리는 호스트 에이전트에 달려 있습니다. Semgrep이 2026년 7월에 낸 오픈소스 AI 보안 하네스 비교 글이 이 스킬을 “호스트의 토큰만 드는 방법론”으로 분류한 것도 같은 맥락입니다. 지능과 격리는 호스트에서 오고, 스킬이 제공하는 것은 절차와 기록 규격입니다. 장부와 결과 파일의 형식을 코드로 검사하는 스크립트가 따로 있는 것은 이 간극을 메우려는 것으로 읽힙니다.
정찰 에이전트 넷이 만드는 1,000단어짜리 지도
정찰은 읽기 전용 research 에이전트 네 개가 병렬로 맡습니다. 대상을 읽고, 로컬 빌드·설정 상태를 보고, 구조화된 사실을 부모에게 돌려줍니다. 배포된 엔드포인트, 외부 인증 서비스, 레지스트리, 클라우드 API에는 접속하지 않고, 파일도 쓰지 않으며, 이 단계에서는 빌드나 테스트도 돌리지 않습니다.
| 에이전트 | 맡은 질문 | 돌려주는 것 |
|---|---|---|
| 1a 제품·스택·로컬 운영 | 무엇을 하는 소프트웨어인가 | 제품 유형과 사용자, 언어·프레임워크, 진입점과 하위 시스템 경계, 오프라인 빌드·테스트 명령(실행하지는 않음), 대상이 통제하는 입력, 빠진 툴체인 |
| 1b 주체·권한·통제 | 누가 무엇을 할 수 있나 | 신뢰가 낮은 주체와 그들에게 설계된 동작, 진입점마다의 인증, 자원별 인가와 테넌트 범위, 권한 변경·폐기·복구 경로, 배포 환경에 기대는 통제 |
| 1c 진입면·복사본·싱크 | 입력이 어디로 흘러가나 | 소스에서 보이는 모든 입력 진입점(HTTP, RPC, 파일, 명령줄·설정, 플러그인, 클라우드 이벤트, 모델 도구 인자, 딥링크, 로컬 IPC), 변환과 복사와 싱크, 한도, 병렬 경로 |
| 1d 로컬 실행·배포 가시성 | 어디까지 돌려 볼 수 있나 | 오프라인 테스트와 픽스처, 격리된 루프백에서 돌릴 수 있는 프로세스, 금지할 명령(의존성 내려받기, 게시, 유료 API), 저장소 밖에 있어서 결정적인 통제, 플랫폼이 샌드박스를 강제할 수 있는지 |
배포 방식이나 하위 시스템이 뚜렷하게 다르면 부모가 전담 정찰을 더 붙일 수 있습니다. 예산 때문에 막히면 그 영역은 에이전트를 띄우지 않고 deferred 칸으로 심은 뒤 보고서에 빈 곳으로 밝힙니다.
네 결과는 architecture.md로 합쳐지며 분량은 약 1,000단어로 제한됩니다. 제품·주체·보호 대상, 비교 대상 소프트웨어의 기준선(마땅한 비교 대상이 없으면 생략), 기술 스택과 오프라인 빌드의 한계, 진입면과 소스에서 싱크까지의 주요 경로, 경계마다 소스에서 보이는 가장 강한 통제, 저장소 기준 시작 경로, 이전 실행의 빈 곳과 재검증 대상, 동반 문서 선택 요약의 여덟 항목입니다. 비교 기준선 항목에는 단서가 붙어 있습니다. 보정용이지 입증된 취약점을 기각하는 근거가 아니라는 것입니다. 이 문서는 곧 사냥꾼에게 통째로 전달되므로, 모자라면 모든 사냥꾼이 같은 곳을 놓칩니다.
장부 한 칸이 사냥꾼 한 명의 일감이 되는 과정
정찰이 끝나면 부모가 장부(coverage-ledger.json)를 만듭니다. 한 칸(단위)은 진입면 × 신뢰 경계 × 하위 시스템 × 공격 유형이고, 깊게 볼 때는 수명주기(생성·갱신·삭제 같은 상태 변화)가 더해집니다. 칸의 식별자는 라벨이 아니라 소스에서 뽑은 안정적인 참조를 유니코드 NFC로 정규화하고 퍼센트 인코딩해 ::로 이은 것입니다. 웨이브 번호, 에이전트, 판정, 심각도, 줄 번호는 식별자에 들어가지 않으므로 다음 실행에서도 같은 칸이 같은 이름을 갖습니다. 이름은 같은데 내용이 다른 칸이 생기면 합치지 않고 충돌로 거부합니다.
칸마다 상태가 붙습니다.
| 상태 | 뜻 |
|---|---|
planned · in_progress |
배정 전, 사냥꾼이 일하는 중 |
covered |
본 경로와 점검 내용이 비어 있지 않고 풀지 못한 사실이 없음 |
candidate |
후보가 나옴. 검증자에게 넘어갈 차례 |
blocked |
사냥꾼이 소스·로컬로는 더 갈 수 없음 |
deferred |
예산이나 프로필 때문에 미룸. 배정 안 된 상태일 수 있음 |
out_of_scope · not_applicable |
범위 밖(나중의 전체 실행용으로 남김), 해당 없음 |
칸을 사냥꾼에게 나눠 주는 순서는 정해져 있습니다. 에이전트 수가 한도에 걸리면 위의 것부터 배정하고, 같은 순위에서는 식별자 순서로 가르며, 그 이유를 장부에 적습니다.
- 인증이 없거나 신뢰가 가장 낮은 진입면
- 자격 증명, 다른 테넌트의 데이터, 코드 실행, 릴리스 권한처럼 가치가 큰 자원을 지키는 경계
- 이전 실행에서 비어 있던 곳, 재검증 대상, 소스가 바뀐 곳
- 이 대상 유형에서 확정 결과가 자주 나온 칸 종류
사냥꾼에게 건네는 지시문은 아홉 부분이 정해진 순서로 이어집니다. 역할 소개 두 문장, architecture.md 전문, 맡은 칸의 ID와 시작 경로, 선택된 공격 유형 블록의 원문, 일부러 뺀 블록과 그 이유, 사냥 방법과 후보 승격 절차, 검증 규칙, 같은 소스에서 이미 확정된 건의 목록과 다른 사냥꾼이 맡은 칸, 그리고 자기 임시 폴더 경로와 결과 규격입니다. 공격 유형을 이름으로만 언급하지 않고 원문 블록을 그대로 넣게 한 점이 이 스킬의 특징입니다. 기본 유형은 아홉 가지(주입, 접근 통제, 자원·파일 처리, 암호·비밀 값, 업무 로직, 기능 오용과 유출, 연쇄·신뢰 경계, 와일드카드, 뻔한 것)이고, 동반 문서 열 개는 정찰이 그 문서가 다루는 신뢰 경계를 실제로 찾았을 때만 붙습니다. 언어나 의존성 이름이 비슷하다고 고르지는 않습니다. 예컨대 AI·LLM 동반 문서는 검색 증강 생성, 에이전트 기억, 도구 호출 루프, MCP 서버처럼 모델이 신뢰가 걸린 결정에 끼는 코드에 쓰이고, 프롬프트 주입만으로는 취약점이 아니며 결정적인 권한 검사가 빠졌거나 우회되는 코드 수준의 경계 실패가 있어야 한다는 단서가 붙어 있습니다.
사냥꾼은 일을 마치면 JSON 객체 하나를 돌려줍니다. 문장으로 된 보고는 중복 제거도 검증도 할 수 없다는 이유로 스킬이 금지합니다. 뼈대는 이렇습니다.
{
  "units":      [ 칸마다 disposition(covered | candidate | blocked), 본 경로, 점검 내용(방법은 source 또는 local) ],
  "candidates": [ 스키마 모양의 후보. 판정 칸은 proposed_verdict ],
  "hardening":  [ 취약점은 아닌 보강 메모 ],
  "uncovered":  [ 못 본 곳과 그 이유 ]
}
사냥꾼 웨이브(한 차례의 병렬 탐색)가 끝나면 점검관(coverage critic)이 바로 붙습니다. 새로 부르는 읽기 전용 에이전트로 소스는 읽지만 쓰거나 대상을 실행하지 않고, 연결되지 않은 진입점, 형제 경로, 빠진 수명주기, 짝이 없는 동반 문서, 이유 없는 제외, 경로나 점검 없이 닫힌 칸을 찾아 새 칸 후보와 재배정할 칸을 돌려줍니다. 점검관이 내놓는 것은 발견이 아니라 “여기도 봐라”는 배정입니다. 재배정된 칸은 새 에이전트가 빈 손으로 시작하고 이전 증거는 attempts에 보관할 뿐 복사하지 않아서, 앞선 사냥꾼의 결론이 뒷사람을 끌고 가지 못합니다. 웨이브는 점검관이 새 일감을 내놓는 동안, 또 planned 칸이 남아 있는 동안 반복되고, standard와 deep에서는 마지막에 별도로 예약한 점검관이 한 번 더 확인해 아무것도 지적하지 않아야 끝납니다.
후보 명단에 이름을 올리는 문턱
사냥꾼이 후보를 내려면 소스에서 보이는 사실이 한 줄로 이어져야 합니다. 누가(낮은 신뢰의 주체), 무엇으로(입력이나 동작), 어떤 통제를 거쳐야 했고, 그 통제가 어떻게 무너져 어떤 경계를 넘었으며, 그 결과 누구의 무엇이 영향을 받는지, 그리고 소스를 따라가거나 로컬에서 본 결과가 무엇인지입니다. 후보 규칙은 이 밖에도 엄격합니다. 충돌 하나를 코드 실행으로, 평범한 작업을 공유 가용성 문제로, 같은 주체의 행동을 권한 상승으로 부풀리지 말라고 하고, 소스에서 안 보이는 사실은 needs_validation으로 정확한 막힘 이유와 함께 보냅니다. 남은 것이 없으면 빈 후보 배열을 돌려줍니다.
후보가 되는 것
- 신뢰가 낮은 주체에서 시작해 의도된 통제를 지나쳐 가는 소스 경로와, 그 경로의 가장 강한 방어
- 같은 뿌리 원인을 소스에서 뽑은 지문(fingerprint)으로 식별할 수 있는 것
- 배포 설정처럼 저장소 밖의 사실이 정확히 하나 남아서
needs_validation이 된 것 - 입증된 영향에 맞춰 낮춘 주장
여기서 걸러지는 것
- 모범 사례가 빠졌다는 지적이나 막는 층이 하나 더 있으면 닫히는 방어층 부족(보강 권고로만 기록)
- 제공자·프록시·브라우저·배포 동작에 대한 추측
- 같은 권한 안의 자기 영향, 의도된 권한 행사
- 실제 관측한 것보다 강하게 쓴 파서·런타임 효과
- 이미 확정된 같은 소스의 건을 다시 보고하는 것
지문은 줄 번호, 웨이브, 에이전트, 심각도, 판정을 넣지 않고 소스에서 뽑는 값입니다. 같은 뿌리 원인을 여러 사냥꾼이 다른 말로 적어도 한 후보로 합쳐지고, 다음 실행이 어제의 확정 건을 알아보는 열쇠가 되기 때문에 설계의 중심에 있습니다.
반박 에이전트에게 건네는 것과 돌려받는 것
중복을 합친 후보는 후보를 만들지 않은 새 에이전트(general)에게 갑니다. 이 검증자가 받는 입력은 일부러 좁습니다. 후보 한 건, 그 후보가 속한 칸의 점검 기록과 증거 경로, 필요한 구조 정보, 해당 동반 문서의 검증 블록, 증거를 승격하는 절차, 소스와 로컬 실행의 경계, 판정 세 갈래의 규격, 같은 지문의 이전 기록이고, 다른 검증자의 결론은 보여 주지 않습니다. 맡은 일은 다음과 같습니다.
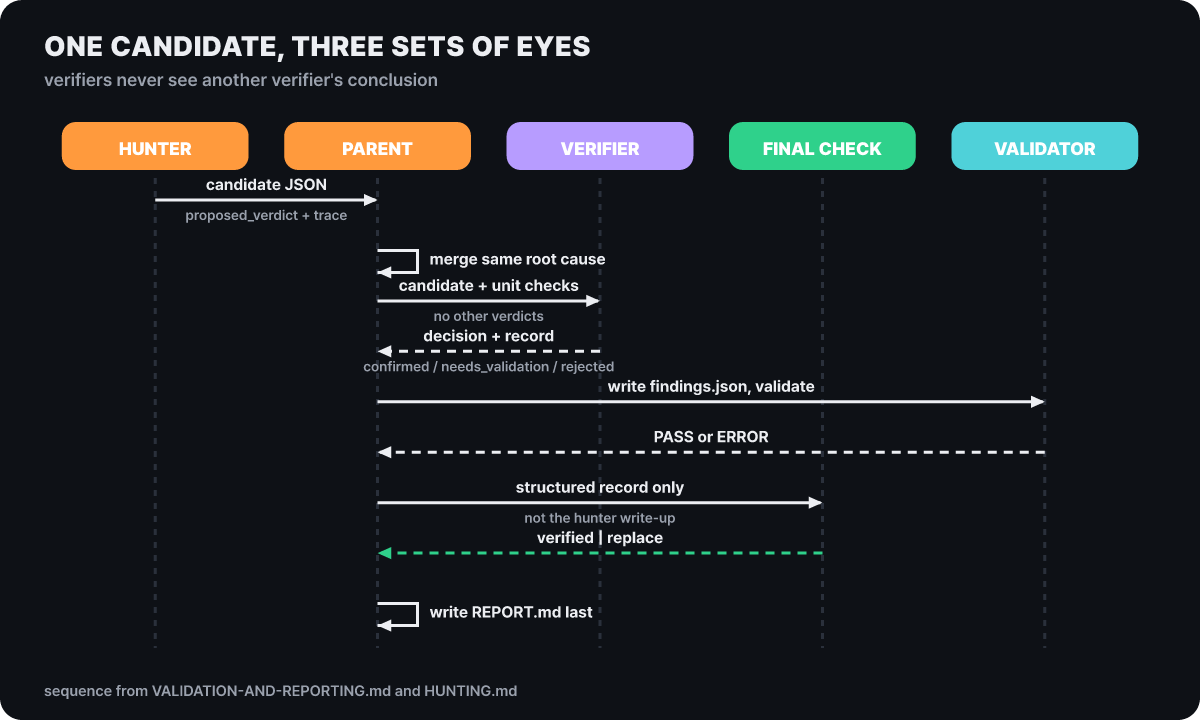 그림 2. 후보 한 건을 따라가면 서로의 결론을 보지 못하는 눈이 세 쌍 있다(사냥꾼, 검증자, 최종 검증자)
- 인용된 소스 위치를 모두 다시 읽고, 경로가 진짜 신뢰가 낮은 진입점에서 시작해 주장한 싱크에서 끝나는지 확인합니다.
- 경로 위에서 보이는 가장 강한 통제를 다시 세웁니다. 반박은 이 지점에서 시작합니다.
- 확정 후보라면 안전할 때 최소한의 관측 결과를 직접 재현합니다.
- 가능성, 영향, 확신도, 제안된 수정이 증거와 맞는지 점검합니다.
needs_validation후보라면 막힌 이유가 정말 소스와 로컬 관찰 밖에 있는지 판단합니다.
검증자는 결론을 산문 없이 {"decision": "confirmed|needs_validation|rejected", "record": {...}} 형태 하나로 돌려줍니다. 세 갈래의 정의와 꼭 들어가야 하는 것은 다음과 같습니다.
| 판정 | 조건 | 심각도 | 기록에 꼭 있어야 하는 것 |
|---|---|---|---|
confirmed (확정) |
검증자가 전체 경로를 독립적으로 세우고 제한된 관측 결과가 있음 | 있음 | 뿌리 원인, 의도된 동작, 성립 조건, 실행 증거, 관측 결과, 수정 전략, 확신도(낮음·중간·높음)와 이유 |
needs_validation (검증 필요) |
배포나 런타임 사실이 정확히 하나 남음 | 없음 | 주장한 뿌리 원인, 경로, 증거, 막힌 이유, 로컬 또는 배포 환경에서 볼 확인 계획 |
rejected (기각) |
소스, 로컬 동작, 보이는 통제, 영향 없음, 불가능한 전제가 후보를 반박함 | 없음 | 기각 이유와 따라간 경로 |
기각 기록은 버려지지 않습니다. 다음 실행이 증거가 달라지지 않은 같은 주장을 되풀이하지 않도록 남깁니다. needs_validation은 소스 문서의 표현으로 “추측한 아이디어를 놓아 두는 주차장”이 아니고, 한 건이 남기는 공백은 정확히 하나여야 하며 로컬이나 배포 쪽의 확인 계획이 적용 가능해야 합니다.
심각도는 가능성과 영향을 각각 다섯 단계(참고, 낮음, 중간, 높음, 치명)로 매겨 종합하며 전체 심각도는 입증된 영향을 넘을 수 없습니다. 치명은 인증 없는 코드 실행이나 데이터 저장소 전체 접근, 임의 계정 탈취 같은 것이고, 높음은 명시된 통제를 완전히 무력화하고 실제 결과가 있는 경우입니다. 통제를 완전히 무너뜨렸나, 약하게 만들었나가 가르는 질문이며, 구체적 피해를 말할 수 없으면 한 단계 낮추라고 되어 있습니다. 깨끗하게 끝난 실행에 낮음 등급 취약점을 지어내지 말라는 문구도 있습니다. 수정안은 소스를 직접 고치지 않고 “가장 작은 소스 수정”으로 제시합니다. 지켜야 할 불변 조건을 말하고, 신뢰 결정이 내려지는 마지막 지점에서 가장 좁게 바꾸고, 회귀 테스트를 곁들이는 형식입니다.
5단계에서는 또 다른 새 research 에이전트가 최종 confirmed와 needs_validation 기록을 하나씩 대조합니다. 사냥꾼이 쓴 글이 아니라 구조화된 기록을 입력으로 받아 verified 또는 replace를 돌려줍니다. 판정을 올리거나 뿌리 원인·경로·영향을 실질적으로 바꾸는 교체는 다시 새 독립 검증자를 거쳐야 적용됩니다. quick 프로필에서는 이 검증이 3단계 검증자 한 명에게 합쳐집니다.
형식은 스크립트가, 내용은 에이전트가 본다
4단계는 부모가 findings.json을 쓰고 곧바로 검증 스크립트를 돌리는 칸입니다. 스크립트는 의존성이 없는 Node.js 파일이고, 호출 형식은 단순합니다.
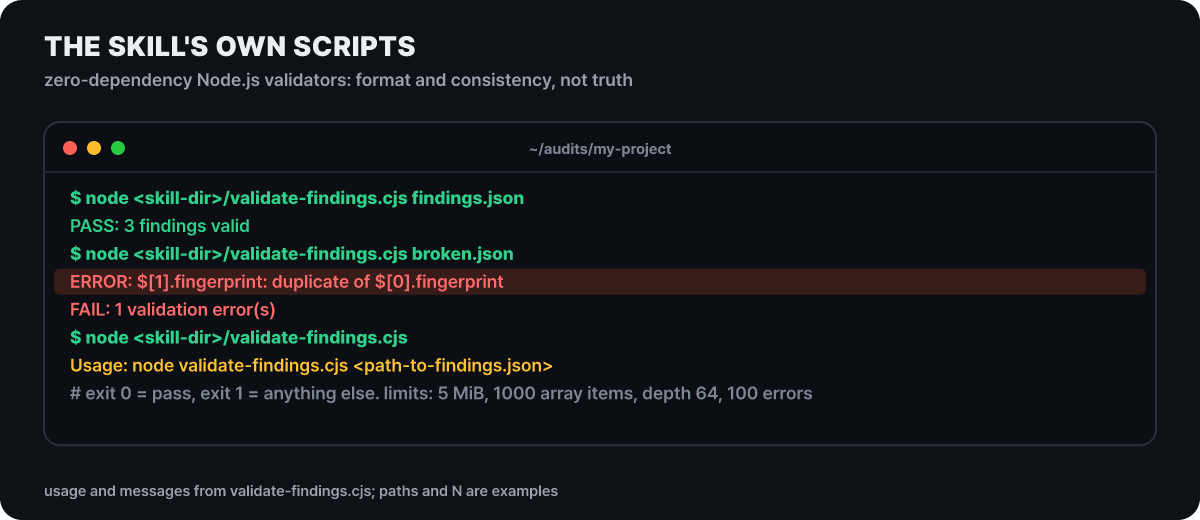 그림 3. 소스에 적힌 메시지 형식. 경로와 통과 건수는 예시이고 결과는 종료 코드 0 또는 1
종료 코드는 통과가 0이고 나머지 모든 실패가 1입니다. 입력이 심볼릭 링크이거나 일반 파일이 아니면 읽지 않고, 5 MiB를 넘거나 UTF-8이 아니면 거부하며, 배열 항목은 1,000개(결과 기록뿐 아니라 모든 배열에 적용), 중첩은 64단계, 한 번에 보고하는 오류는 100개로 묶습니다. report-schema.json은 스크립트와 같은 폴더에서 읽고, 장부 검증기(validate-coverage-ledger.cjs)는 단위 10,000개와 순회하는 값 500,000개까지를 한도로 삼습니다. 파이프라인은 장부를 처음 만든 뒤, 칸을 고칠 때마다, 그리고 6단계 보고서를 쓰기 전에 이 검증기를 돌리고, 오류가 있는 장부로는 사냥꾼을 배정하지 않습니다.
PASS가 뜨면 안전하다는 뜻이 아닙니다. 확인되는 것은 형식과 일관성(필수 필드, 경로 단계의 순서, 지문의 중복 같은 것)뿐이고 내용이 옳은지는 보증하지 못합니다. 내용의 신뢰는 앞 절의 독립 검증자와 사람의 검토에 달려 있습니다. 순서도 일부러 이렇게 잡혀 있습니다. findings.json을 쓰고 검증하는 것이 4단계, 5단계에서 기록을 재검증하고, 6단계에서 5단계가 통과한 뒤에야 REPORT.md, FINDINGS-DETAIL.md, NEEDS-VALIDATION.md라는 산문을 만듭니다. 산문이 먼저 나오고 JSON이 거기에 맞춰지는 일, 즉 산문과 JSON이 엇갈리는 것을 스킬은 안티패턴으로 꼽습니다. REPORT.md는 실행 프로필과 범위, 예산, 검토한 커밋, 샌드박스 상태, 이전 실행 사용 여부, 미룬 곳과 범위 밖을 첫 절에 적고, 이어서 보안 요약, 확정 표와 건별 상세, 검증 필요 표, 보강 메모, 마지막으로 장부 요약과 최종 점검관의 결과를 싣습니다.
두 번째 실행은 첫 실행의 장부를 읽고 시작한다
같은 저장소를 다시 돌리면 부모는 이전의 coverage-ledger.json과 findings.json을 모두 읽고 지금의 소스와 대조합니다. 소스가 그대로인지 바뀌었는지에 따라 기록의 운명이 갈립니다.
| 이전 기록 | 소스가 그대로 | 소스가 바뀜 |
|---|---|---|
| 확정 | 같은 지문으로 이월. 사냥꾼의 제외 목록에 올라 다시 보고하지 않음 | 재검증 칸이 됨. 이전 판정을 가정하지 않고 사냥에서도 제외하지 않음 |
| 검증 필요 | 현재 소스가 경로를 뒷받침할 때만 막힌 이유와 함께 이월 | 다시 일감 |
| 미룸·막힘·범위 밖 | 항상 다시 일감. 일을 억제하는 데 쓰지 않음 | 항상 다시 일감 |
| 기각 | 소스와 증거가 같은 그 주장만 억제 | 증거가 바뀌면 다시 열림 |
가장 조심할 대목은 quick이나 범위를 지정한 이전 장부가 “나머지는 괜찮다”는 뜻이 아니라는 점입니다. 호환되지 않거나 없는 장부는 “비어 있음”이 아니라 없는 것으로 기록되고, 한 번의 실행이 대상을 다 훑었다고 말하는 일은 없습니다. README가 한 번 돌린 결과는 반복 실행이 찾는 것의 약 절반이라고 적은 것도 이 장부로 이어 가는 반복을 전제로 합니다. 쇼핑몰 API를 출시 전날 quick으로 한 바퀴 돌린 경우를 예로 들면(편집부가 만든 가정), 점검관이 찾아 미룬 칸은 deferred로 남고 보고서 첫 절에는 “부분 점검”이 들어가며, 출시 뒤 standard로 돌리면 그 칸이 일감 목록의 앞쪽에서 다시 나옵니다.
대상 코드를 돌리는 방은 OS가 잠근다
사냥꾼과 검증자는 후보를 확인하려고 대상 프로젝트의 빌드, 테스트, 프로세스를 돌려야 할 수 있습니다. 대상은 남의 코드이거나 아직 믿을 수 없는 코드일 수 있어서 SKILL.md는 이 실행을 OS가 강제하는 샌드박스 안에서만 허용하고, 네 가지 조건을 모두 요구합니다.
- 외부 네트워크가 없다(필요하면 격리된 루프백 네임스페이스만)
- 허용 목록으로 채운 비어 있는 환경 변수와 임시 폴더 안의
HOME - 대상과 툴체인은 읽기 전용이고, 쓰기는 배정된
scratch/에만 - CPU, 메모리, 프로세스 수, 파일 크기, 디스크, 실행 시간에 낮은 한도
하나라도 강제하지 못하면 대상 코드를 실행하지 않고, 확인하지 못한 능력을 needs_validation의 막힘 이유로 적습니다. 의존성은 설치하지 않으며 빌드가 내려받게 두지도 않습니다. 더미 주체와 더미 비밀 값만 쓰고, 운영 중인 엔드포인트와 공유 인프라, 다른 사람의 데이터, 유료 API 할당량은 건드리지 않습니다. 후보가 성립하는 최소한의 지역 결과에서 멈추고 확장하지 않는다는 것도 규칙입니다.
임시 폴더에 만든 파일은 곧바로 증거가 되지 않습니다. 부모 쪽의 신뢰된 코드가 허용 목록과 파일별·누적 바이트 한도를 정해 두고, 파일을 하나씩 열어 읽을 때 심볼릭 링크를 따라가지 않으며, 심볼릭 링크, FIFO, 장치 파일, 하드 링크, 디렉터리, 읽는 중에 크기가 바뀌는 파일은 거부합니다. 옮기기에 실패한 파일은 증거로 인정하지 않습니다. 에이전트와 대상 프로세스가 쓸 수 있는 곳은 scratch/뿐이고, 증거 폴더(artifacts/)는 부모만 관리합니다. 소스를 읽기만 하는 감사는 이 방이 없어도 돕니다. 샌드박스가 없으면 실행으로만 확인되는 후보가 needs_validation에 머무를 뿐입니다.
프로필과 예산이 몸통의 크기를 정한다
여러 에이전트를 병렬로 부르는 구조라 호출 수가 빠르게 늘 수 있고, 조절 장치는 두 가지입니다.
| 프로필 | 쓰임 | 동작 |
|---|---|---|
quick |
작은 대상, 재실행, 빠른 첫 점검 | 사냥꾼 웨이브 한 번과 점검관 한 번. 후보당 검증자 하나가 검증과 최종 검증을 겸함. 점검관이 찾은 추가 칸은 deferred. 칸을 표면 × 경계 × 공격 유형으로 뭉뚱그림 |
standard (기본) |
일반 감사 | 문서에 적힌 전체 흐름. 점검관이 깨끗해질 때까지 반복하고 마지막에 별도 점검관 |
deep |
중요하거나 큰 대상 | 칸을 하위 시스템 × 수명주기로 쪼갬. 검증과 최종 검증을 서로 다른 새 에이전트가 맡음. 같은 소스로 이미 덮은 칸도 독립적인 두 번째 패스 |
프로필은 폭과 중복만 바꾸고 증거 기준은 바꾸지 않습니다. 후보 문턱, 실행 경계, needs_validation 규율, 스키마 검증, 확정 기록의 독립 검증은 어떤 프로필에서도 같습니다. 일부 경로나 하위 시스템, 동반 문서 영역, 두 커밋 사이의 변경분만 보는 범위 지정 실행은 범위 밖을 out_of_scope로 표시하고 “점검함”으로 세지 않으며, 범위 지정 실행과 quick 실행은 보고서에 “부분 점검”이라고 밝혀야 합니다.
예산은 모든 단계를 통틀어 에이전트를 몇 번까지 부를지의 최댓값입니다. 스킬은 사냥을 시작하기 전에 몫을 먼저 떼어 놓습니다.
- 정찰 에이전트 4회와 점검관(
quick은 1회, 나머지는 2회), 검증자 최소 1회의 몫을 예약합니다. - 남는 몫으로 우선순위가 높은 칸부터 사냥꾼을 배정하고, 넘치는 칸은
deferred로 미룹니다. - 웨이브가 끝날 때마다 다음 웨이브를 시작하기 전에 점검·검증 몫이 남았는지 다시 확인하고, 모자라면 웨이브를 줄입니다.
- 후보가 검증 몫보다 많으면 사냥을 멈추고 지문 순서대로 검증합니다. 검증하지 못한 후보는
candidate로 남고findings.json에 오르지 않습니다.
예산 40으로 인증 폴더 하나를 deep으로 돌린다면 정찰 4, 점검관 2, 검증자 1이 먼저 예약되어 7이 빠지고 33이 사냥꾼과 후보 검증에 쓰입니다(편집부 계산). 최소 몫을 감당하지 못하면 에이전트를 하나도 띄우지 않고 더 큰 예산, 좁은 범위, 다른 프로필 중 하나를 요구합니다. 그대로 진행하면 run_status가 incomplete로 기록되고 budget_cannot_fund_reconnaissance_and_reserves 같은 정확한 이유가 남습니다. 예산이 모자라서 멈춘 사실을 숨기고 “완전히 점검했다”고 말하는 것을 막는 장치입니다. 스킬에 별도 요금은 없고 비용은 호스트 에이전트의 토큰이나 구독 할당량으로 나가므로, 프로필과 범위 지정이 비용을 가장 크게 좌우합니다.
사내 하네스의 두 숫자와 후보 깔때기
공개 스킬과 Cloudflare 블로그의 숫자는 같은 물건에서 나온 것이 아닙니다. 블로그의 수치는 사내 하네스(발견용 VDH, 검증·수정용 VVS)가 128개 저장소를 훑어 얻은 값이고, 이 하네스는 정찰·탐색·검증에 빈 곳 채우기, 중복 정리, 의존하는 저장소로 번지는 추적, 피드백, 보고를 더한 연속 파이프라인입니다. 블로그는 하네스 자체도 곧 뒤따를 것으로 기대한다고만 적었고 날짜는 적지 않았습니다. 스킬을 약 6주 키워 이 하네스가 되었다는 것이 Cloudflare의 설명입니다.
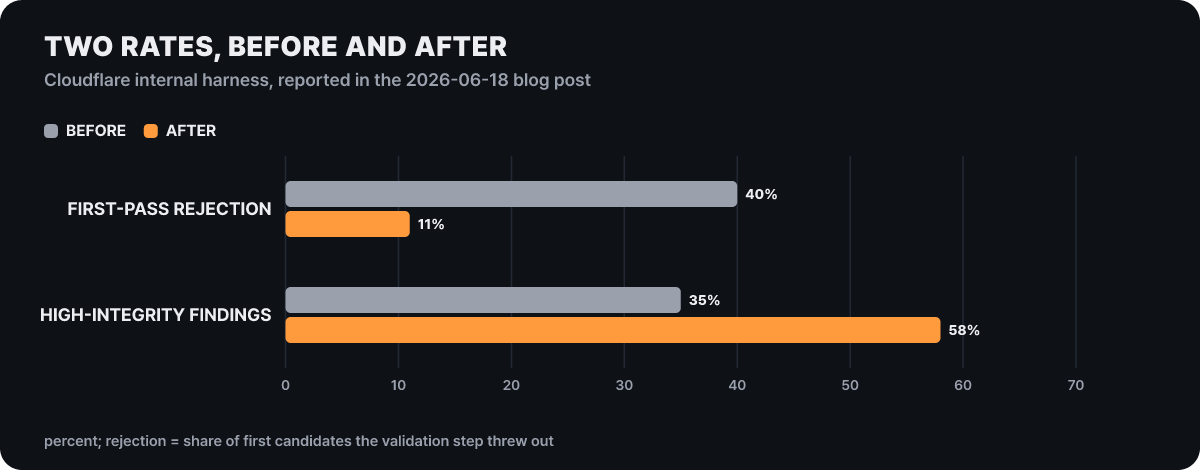 그림 4. 사내 하네스가 보고한 두 비율의 전후. 저자들은 기각률 하락을 정찰 맥락을 넣는 방식이 나아진 덕이라고 설명한다
기각률이 40%에서 11%로 내려간 것은 사냥꾼이 내놓는 후보의 질이 올랐다는 뜻이고, 낮을수록 검증에 드는 낭비가 적습니다. 고신뢰 발견의 비율이 35%에서 58%로 오른 것은 같은 방향의 다른 면입니다. 이 값은 “공개 스킬을 그대로 돌리면 나오는 비율”이 아니라 정찰 맥락 주입을 개선한 사내 시스템의 시계열이라는 점을 구분해서 읽어야 합니다. 같은 글에는 에이전트 하나가 컨텍스트 창의 25% 미만만 쓰도록 한다는 설계 원칙, 사냥꾼이 정적 분석 도구 Semgrep을 한 달 동안 0회 호출했다는 관찰, 그리고 사냥꾼이 필요하지만 없는 도구나 자원을 적어 두는 “wishlist”가 가장 많이 쓰인 도구였고 128개 저장소에서 25,472건이 적혔다는 값이 함께 있습니다.
후보가 거친 깔때기는 다음과 같이 보고되었습니다. 사내 하네스가 만든 원시 후보가 20,799건, 검증을 통과한 것이 약 12,057건이고, 다른 하네스의 결과가 합류한 중앙 풀 13,841건은 조치 대상 7,245건, 중복 5,442건, 재분류 1,154건으로 갈렸습니다.
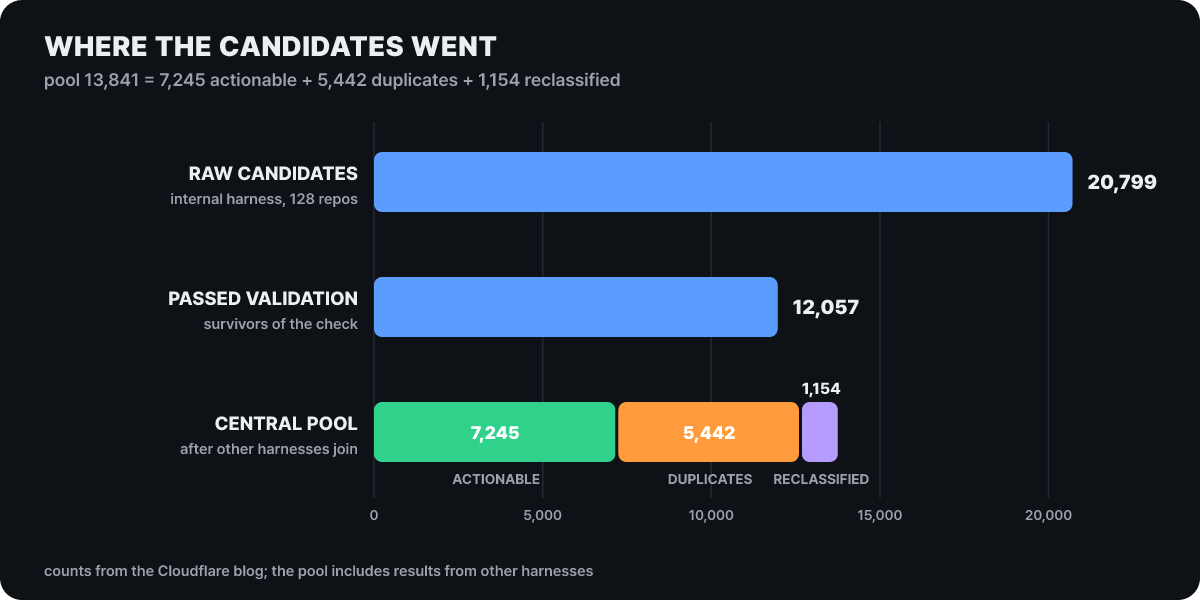 그림 5. 위 두 막대는 사내 하네스의 후보, 아래 막대는 다른 하네스가 합류한 풀의 내역(세 값의 합이 풀 전체)
위의 두 막대와 아래 막대는 이어지는 한 줄기가 아닙니다. 풀에는 다른 하네스의 결과가 들어 있어서 12,057에서 13,841로 곧바로 건너가는 계산은 성립하지 않습니다. 막대로 읽을 수 있는 것은 풀의 거의 40%(5,442건)가 중복이라 중복 정리 전용 에이전트가 후보 부피를 크게 줄인다는 점입니다. 블로그가 스스로 밝힌 한계도 같이 읽어야 합니다. 놓친 취약점의 비율(거짓 음성률)은 주장하지 않는데, 모든 실제 버그에 라벨을 붙인 정답 집합이 없기 때문입니다. 수치는 작성 시점의 스냅샷이고, 시험 환경에서 벌인 격리된 연구 실험의 결과이며, 운영 중인 미패치 취약점의 수가 아닙니다. 약 3만 줄 저장소에서 후보 100건이 정리 후 80건이 되고 발견부터 수정 요청까지 약 14시간이라는 예시는 한 번의 측정이 아니라 현실적으로 그려 본 시나리오이고, 수정 에이전트는 병합하지 않고 사람이 모든 가지를 검토합니다.
열린 풀 리퀘스트 64건이 보여 주는 저장소의 지금
2026-10-27 UTC에 GitHub 저장소를 다시 열어 보면 몸통은 9월 14일 그대로입니다. 6월 18일 첫 커밋 이후 14개 커밋이 쌓였고 가장 최근은 9월 14일에 안내 모드와 전체 감사 모드를 나눠 설명한 변경이며, 9월 10일에는 워크플로, 결과 규격, 검증기가 처음부터 끝까지 다시 정비되었습니다. 6월 24일 폴더 구조 수정(npx skills add 호환), 7월 2일 경로 순서 검증, 7월 4일 메모리 안전·바이너리 동반 문서가 외부 기여로 들어왔고, 7월 6일에는 AI·LLM, 웹 프로토콜·인증, 클라이언트 동반 문서가 추가되었습니다. 릴리스는 없고 별은 48.2k, 포크는 3.0k, 지켜보는 사람은 180명입니다.
달라진 것은 몸통 바깥입니다. 열린 풀 리퀘스트가 64건, 닫힌 것이 8건이고 열린 이슈가 34건인데, 10월 21일부터 26일 사이에만 번호가 91번에서 113번까지 올라갔습니다. 내용이 눈에 띕니다. 상당수가 이 스킬의 경계 자체를 겨눕니다.
- 대상 저장소의 이름이 출력 경로와 이전 실행 재사용을 좌우해 경로 이탈이나 이전 실행 오염이 생길 수 있다는 이슈(#94)와 그에 대응하는 풀 리퀘스트(#95, #96)
- 대상 저장소의 내용을 모든 에이전트 프롬프트에서 신뢰하지 않는 입력으로 다루자는 제안(#108)
- 검증기가 같은 키가 두 번 나오는 JSON을 거부하게 하자는 두 건(#102, #103)과 객체 필드 1,000개 한도를
findings.json검증기에 더하자는 건(#107, #111) O_NOFOLLOW가 없는 플랫폼(Windows)에서도 검증기가 돌게 하는 대체 경로(#99, #113)- 암호·키 관리 동반 문서(#101), 에이전트 플러그인용
plugin.json(#110), 수정안 설계를 발견 단계에서 떼어 읽기 전용 별도 단계로 옮기자는 제안(#109)
이 목록은 이 스킬이 앉은 자리를 보여 줍니다. 감사 대상은 신뢰할 수 없는 코드이고, 그 코드의 저장소 이름과 파일 내용이 곧 에이전트 프롬프트와 출력 경로에 들어가는 재료입니다. “찾는 쪽과 채점하는 쪽을 가른다”는 규칙은 판정의 독립성을 지켜 주지만, 대상이 감사 도구로 되돌려 보내는 입력이 도구를 흔드는 길은 따로 막아야 합니다. 위 이슈와 풀 리퀘스트는 바로 그 입구를 사람들이 찾아 메우는 과정이고, 9월 14일 이후 병합된 커밋이 없는 지금은 아직 열린 채로 쌓여 있습니다. 그래서 이 스킬로 낸 보고서를 읽을 때는 확정 표만큼이나, 어떤 사본(커밋)의 스킬로 어느 폴더에 출력했는지가 해석의 기준이 됩니다.



