패치가 나왔는데 내 서버는 왜 아직 안전하다고 못 할까
리눅스 커널 TCP의 use-after-free CVE-2026-98432를 질문 하나로 따라갑니다. 수정이 기다리는 것, 배포판 패키지와 업스트림 커밋의 거리, 설치와 실행의 차이, 컨테이너가 같은 커널을 쓰는 이유를 공식 문서와 직접 돌린 실험으로 풉니다.
커널 보안 공지에 수정됨이라는 글자가 올라왔는데도, 내 서버가 안전하다고 적어도 되는 날은 언제일까요? 이 글은 CVE-2026-98432라는 하나의 결함을 소재로 이 질문 하나만 따라갑니다. 답은 패키지를 설치한 날이 아니라, 아래에서 차례로 건너는 다섯 개의 관문을 모두 지난 날입니다. 관문마다 편집부가 직접 돌려 본 실험이나 공식 문서를 하나씩 붙였습니다. 날짜와 시각은 모두 UTC이며, 사건에 관한 사실은 Debian, Ubuntu, Red Hat이 낸 공식 트래커와 공지에서만 가져왔습니다. 공식 문서를 바탕으로 한 원리 설명과 직접 돌린 실험, 편집부의 분석은 각각 편집부 해설, 편집부 실험이라고 표시했습니다. 공격 절차와 코드는 다루지 않고, 결함 자체를 재현하는 실험도 하지 않았습니다.
패치 하나가 건너야 하는 다섯 관문
먼저 사건의 뼈대만 짚습니다. 아래 사양표는 세 곳의 공식 페이지에 공통으로 적힌 내용입니다.
- 결함
- 리눅스 커널 IPv4 TCP의 use-after-free. 재전송된 연결 요청과 소켓 이전(migration)이 동시에 처리될 때 소켓 옵션 메모리가 쓰이는 도중에 해제됨(Red Hat CVE 페이지)
- 점수
- Ubuntu와 Red Hat 모두 CVSS 3.1 기준 9.8(Critical), 벡터 AV:N/AC:L/PR:N/UI:N, 분류 CWE-825
- 수정
- 옵션 메모리를
kfree()대신kfree_rcu()로 해제. 업스트림 커밋e3f33b0a1d89d738e2b913dab519226eaf76e15b, Debian 페이지 기준 7.3-rc7에 포함 - 공개
- Ubuntu 페이지 게시 10월 15일(갱신 10월 30일), Red Hat 보안 공지 RHSB-2026-016은 10월 30일
패치가 있다는 말은 이 중 수정 줄 하나가 참이라는 뜻일 뿐입니다. 내 서버가 안전하려면 아래 다섯 가지가 차례로 참이어야 합니다.
- 결함이 정확히 무엇인지 알아서, 내 서버가 그 경로에 놓여 있는지 판단할 수 있다.
- 수정이 그 결함을 실제로 막는 원리를 이해한다. 고친 줄이 무엇을 기다리는지 모르면 고쳐졌다를 믿을 근거가 없다.
- 내가 쓰는 배포판이 그 수정을 내 커널 계열에 넣은 패키지 빌드를 냈고, 내 서버의 패키지가 그 빌드다.
- 그 패키지가 설치되었고, 서버가 재시작되어 그 커널이 실제로 돌고 있다.
- 같은 커널을 쓰는 다른 실행 환경(컨테이너, 노드, 이미지 레지스트리의 부팅 이미지)도 같은 상태다.
각 관문은 서로 다른 방식으로 거짓 안심을 만들어 냅니다. 첫 두 관문은 이해의 문제이고, 나머지 셋은 서로 다른 목록(패키지 목록, 부팅 기록, 인프라 목록)을 맞춰 보는 일입니다.
첫 관문: SYN 한 개가 서버 안에서 남기는 것
결함이 어디에 있는지 보려면 TCP 연결이 맺어지는 동안 서버 커널이 메모리에 무엇을 만들어 두는지부터 봐야 합니다. 이 절은 편집부 해설이며, 핸드셰이크 설명은 RFC 9293을 따릅니다.
RFC 9293은 연결을 맺는 절차를 세 번 주고받는 핸드셰이크(three-way handshake)로 정의합니다. 서버가 LISTEN 상태에서 SYN을 받으면 SYN-ACK를 돌려보내며 SYN-RECEIVED 상태로 들어가고, 클라이언트의 마지막 ACK가 도착해야 ESTABLISHED가 됩니다. RFC는 SYN-RECEIVED를 연결 요청을 받고 보낸 뒤 확인 응답을 기다리는 상태로 정의합니다. 이 상태에 머무는 연결 하나하나가 서버 메모리의 무언가를 차지합니다. RFC 4987은 서버가 SYN이 올 때마다 연결 상태를 만들어 두기 때문에 수가 한정되어 있고, 구현마다 그 한계에 닿았을 때의 동작이 표준화되어 있지 않다고 설명합니다. 커널 문서(ip-sysctl)도 SYN_RECV 상태의 요청 소켓 하나가 약 304바이트를 쓴다고 적습니다.
리눅스는 이 반쯤 열린 연결을 요청 소켓(request socket)이라는 가벼운 객체로 표현하고, 마지막 ACK가 와야 애플리케이션이 받아 쓰는 자식 소켓(child socket)을 만듭니다. 이 구조가 이번 결함의 무대입니다. 두 소켓이 같은 SYN에서 나온 정보를 나눠 들게 되기 때문입니다.
나눠 드는 정보 중에 이번 글의 주인공이 있습니다. IPv4 옵션입니다. RFC 791은 IP 헤더의 IHL(Internet Header Length) 필드가 헤더 길이를 32비트 워드 단위로 나타내며 정상 값의 최솟값이 5라고 정의합니다. 5워드는 20바이트, 옵션 없는 기본 헤더입니다. 옵션이 붙으면 IHL이 5보다 커지고, 옵션은 종류 한 바이트만 있거나(끝, No Operation) 종류, 길이, 데이터가 이어지는 형태입니다. RFC 791이 정의한 옵션에는 경로를 기록하는 Record Route(종류 7), 송신자가 경로를 지정하는 Loose Source Route(131)와 Strict Source Route(137), 시각을 남기는 Internet Timestamp(68)가 있습니다. 같은 RFC는 옵션이 모든 IP 구현에서 지원되어야 한다고 적었습니다. 그래서 옵션 처리 코드는 정상적인 커널이라면 반드시 존재하는 경로입니다. 커널 문서도 IPv4의 accept_source_route 설정이 소스 라우팅 옵션을 받을지 정하며 기본값이 라우터는 참, 일반 호스트는 거짓이라고 적고 있어서, 옵션은 설정에 따라 일부가 걸러지기도 하는 대상입니다.
여기서 흔한 오해 하나를 짚어 둡니다. RFC 9293이 정의한 TCP 옵션(MSS, 윈도 스케일, SACK 허용, 타임스탬프 등)과 IP 옵션은 다른 층의 다른 것입니다. 일반 연결의 SYN에는 거의 항상 TCP 옵션이 붙고 IP 옵션은 거의 붙지 않습니다. 이번 결함은 공식 트래커 서술상 IP 옵션을 보관하는 객체에서 일어납니다. 두 옵션을 구별해 보여 주려고 편집부가 직접 loopback 위에서 SYN을 잡아 봤습니다.
편집부 실험 환경은 일회용 Alpine 컨테이너(커널은 호스트의 LinuxKit 6.12.5)이고, 같은 컨테이너 안에서 서버 소켓과 클라이언트가 loopback으로 통신합니다. 결함을 건드리는 시도는 없으며, 평범한 연결과 IP 옵션 4바이트가 붙은 연결을 한 번씩 맺습니다. 먼저 평범한 연결에서 잡은 SYN과 SYN-ACK입니다.
IP (tos 0x0, ttl 64, id 9684, offset 0, flags [DF], proto TCP (6), length 60)
    127.0.0.1.44544 > 127.0.0.1.9000: Flags [S], seq 2119922374, win 65495,
    options [mss 65495,sackOK,TS val 331999809 ecr 0,nop,wscale 7], length 0
IP (tos 0x0, ttl 64, id 0, offset 0, flags [DF], proto TCP (6), length 60)
    127.0.0.1.9000 > 127.0.0.1.44544: Flags [S.], seq 1157465599, ack 2119922375, win 65483,
    options [mss 65495,sackOK,TS val 331999809 ecr 331999809,nop,wscale 7], length 0
options [...]에 보이는 것이 TCP 옵션입니다. MSS, SACK 허용, 타임스탬프, 윈도 스케일이 한 줄에 들어 있고, 전체 길이는 60바이트입니다. IP 헤더 20바이트에 TCP 헤더가 40바이트(기본 20, 옵션 20)입니다. 다음은 클라이언트 소켓에 4바이트 IP 옵션(No Operation 세 개와 끝 표시)을 붙여서 연결한 결과입니다.
IP (tos 0x0, ttl 64, id 49698, offset 0, flags [DF], proto TCP (6), length 64, options (NOP,NOP,NOP,EOL))
    127.0.0.1.46060 > 127.0.0.1.9000: Flags [S], seq 1672936102, win 65495,
    options [mss 65495,sackOK,TS val 331981633 ecr 0,nop,wscale 7], length 0
같은 SYN인데 첫 줄에 options (NOP,NOP,NOP,EOL)이 따로 나타나고 길이가 64바이트입니다. 괄호 안이 IP 옵션이고 대괄호 안이 TCP 옵션입니다. 이 실험에서 서버 커널은 이 SYN도 문제없이 받아 핸드셰이크를 끝냈고 연결은 0.000초 만에 맺어졌습니다. 이 옵션은 아무 일도 하지 않는 채움 바이트이며, 결함을 건드리려는 값이 아닙니다. 요점은 서버 커널이 이런 SYN을 받으면 옵션을 읽어 요청 소켓에 보관하는 정상 경로가 있다는 것, 그리고 그 경로를 지나는 데이터의 크기가 평소 패킷보다 4바이트 늘어난다는 것입니다. 그 4바이트가 이번 결함의 입구 조건이기도 합니다.
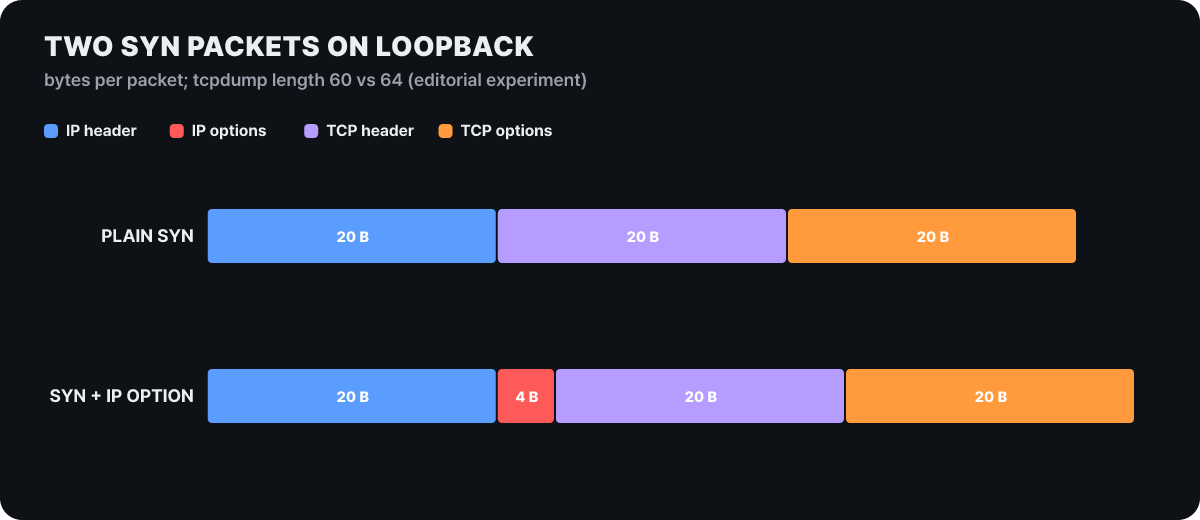 그림 1. 같은 loopback에서 잡은 두 SYN의 바이트 구성(편집부 실험, tcpdump length 60과 64)
위 그림은 두 패킷을 구성 요소로 쪼갠 것입니다. 아래 막대만 붉은 4바이트가 더 있습니다. 패킷 수준에서 옵션 달린 SYN은 눈에 띄게 다른 모양이므로, 뒤에서 임시 방어를 다룰 때 이 4바이트가 필터의 기준이 됩니다.
두 번째 관문: 같은 포인터를 든 두 손
이제 Debian 트래커가 적은 원인을 따라갑니다. 옵션은 SYN이 도착할 때 요청 소켓의 ireq_opt 필드에 보관됩니다. 연결이 완성되는 순간 tcp_v4_syn_recv_sock()이 자식 소켓을 만드는데, 트래커의 서술로는 이 함수가 요청 소켓의 옵션을 복사하지 않고 포인터만 자식 소켓으로 옮깁니다. 옵션 객체 하나를 요청 소켓과 자식 소켓이 같은 주소로 가리키는 상태가 생기는 셈입니다. 소유권 이전이라고 보면 한 번에 한 쪽만 만지는 한 문제가 없습니다.
IPv6 쪽을 보면 이 설계의 의미가 선명해집니다. Debian과 Ubuntu 모두 tcp_v6_syn_recv_sock()은 옵션을 복제해서 자식에게 주므로 첫 번째 문제는 IPv4에만 해당한다고 적었습니다. 복제하면 각자 자기 몫을 갖기 때문에 한쪽이 해제해도 다른 쪽이 영향을 받지 않습니다. IPv4 쪽은 복사를 아낀 대가로 소유자가 불분명해졌습니다.
문제는 시간입니다. Debian 트래커에 따르면 요청 소켓은 이제 리스너 잠금 없이 처리됩니다. 그래서 한 CPU가 최종 ACK로 연결을 완성하는 동안, 다른 CPU가 클라이언트가 다시 보낸 SYN에 대한 SYN-ACK를 같은 요청 소켓에서 만들 수 있습니다. 재전송은 정상적인 TCP 동작입니다. 커널 문서에 따르면 수신 측 SYN-ACK 재전송 횟수(tcp_synack_retries) 기본값은 5이고, 마지막 재전송까지 31초가 걸리며 최종 타임아웃은 63초입니다. 이 시간 동안 같은 요청 소켓을 둘러싼 이벤트가 여러 CPU에서 오갈 수 있다는 뜻입니다. 자식 소켓에는 SOCK_RCU_FREE가 없고 소멸 함수 inet_sock_destruct()가 옵션을 즉시 kfree()로 해제합니다. 자식이 사라진 뒤에 SYN-ACK 조립 쪽이 ip_options_build()에서 그 옵션을 읽으면 이미 반납된 메모리를 읽게 됩니다. Ubuntu 설명도 같은 내용입니다.
아래 그림은 이 경쟁을 순서대로 그린 것입니다. 왼쪽부터 상대편, CPU A, 옵션 객체, CPU B 순서이며 붉은 화살표 두 줄이 문제 구간입니다.
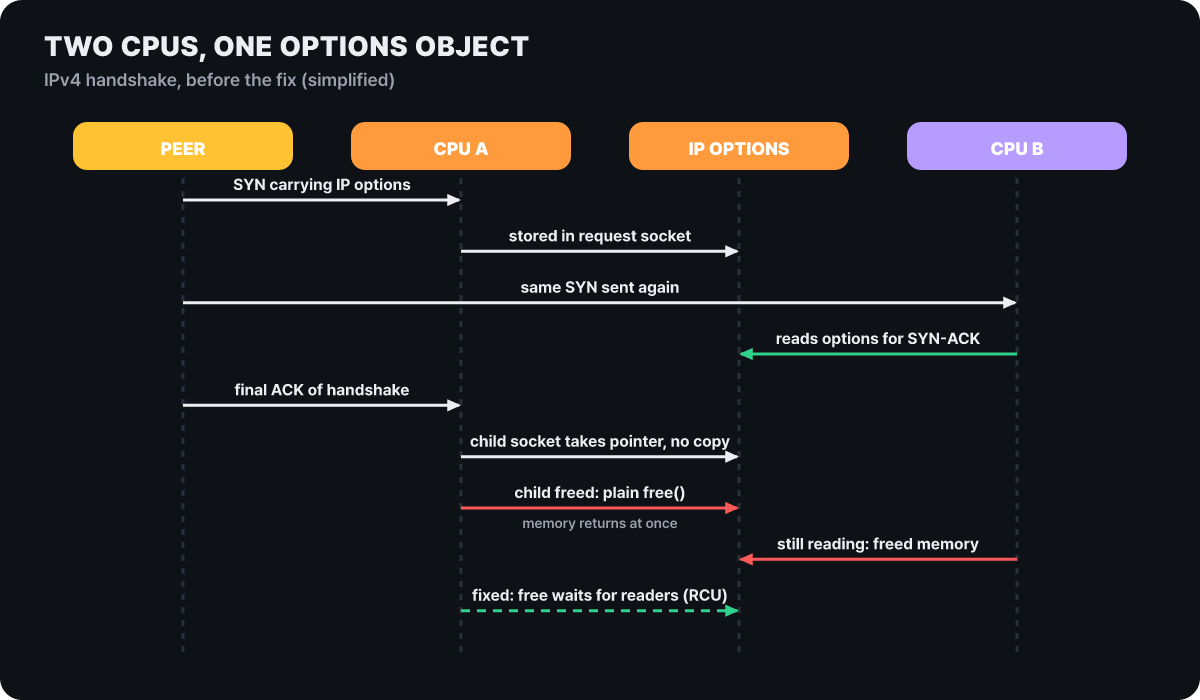 그림 2. 수정 전 핸드셰이크의 경쟁 구간을 단순화한 시퀀스(편집부 도식, Debian·Ubuntu 트래커 서술 기반)
그림에서 읽을 것은 두 가지입니다. 첫째, 객체를 해제하는 쪽은 자기 일을 정상적으로 끝낸 것이고, 읽는 쪽도 자기 일을 정상적으로 하던 중입니다. 어느 한 쪽의 코드가 잘못 쓰인 것이 아니라 둘이 만나는 순서가 보호받지 못한 것입니다. 둘째, 맨 아래 초록 점선이 수정이 바꾸는 한 줄입니다. 뒤에서 이 줄이 무엇을 기다리는지 봅니다.
같은 구조를 소유자 중심으로 다시 그리면 이렇습니다. 아래 그림에서 옵션 객체는 하나이고 이를 가리키는 손이 여럿입니다.
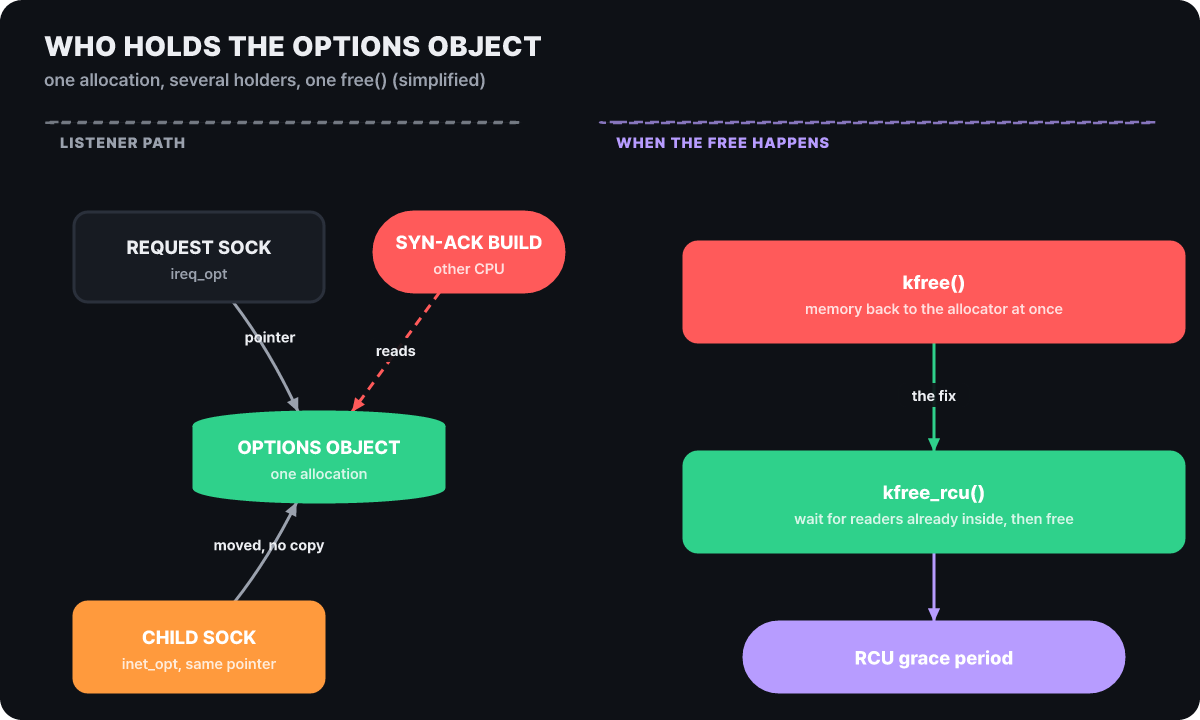 그림 3. 옵션 객체 하나와 그것을 든 소유자들, 그리고 두 가지 해제 방식(편집부 도식)
왼쪽 영역에서 요청 소켓과 자식 소켓이 같은 객체를 가리키고, 점선으로 그려진 다른 CPU의 SYN-ACK 조립도 읽고 있습니다. 오른쪽에서 kfree()는 반납을 즉시 하고 kfree_rcu()는 이미 들어와 있는 읽기를 기다린 다음 반납합니다.
수정의 두 번째 갈래도 같은 그림으로 이해됩니다. Debian과 Ubuntu에 따르면 요청 소켓 이전(migration) 기능을 쓰는 환경, 곧 net.ipv4.tcp_migrate_req=1이거나 BPF_SK_REUSEPORT_SELECT_OR_MIGRATE 방식의 eBPF 프로그램을 쓰는 환경에서는 원래 요청 소켓과 그 복제본이 같은 ireq_opt를 공유합니다. 그 상태에서 tcp_v4_reqsk_destructor()가 같은 방식으로 즉시 해제하면 똑같은 문제가 생깁니다. 커널 문서는 tcp_migrate_req가 리스너가 닫힐 때 대기 중이거나 수락된 자식 소켓을 같은 포트의 다른 리스너로 옮기는 설정이며 기본값이 0이라고 적습니다. 편집부가 위 컨테이너 커널에서 읽어 본 값도 0이었습니다.
$ cat /proc/sys/net/ipv4/tcp_migrate_req
0
이 값이 0이면 두 번째 갈래의 조건 중 하나는 해당하지 않습니다. 하지만 이 설정이 0이라는 사실이 첫 번째 갈래의 안전을 뜻하지는 않습니다. 첫 번째 갈래는 이전 기능과 무관하게 재전송된 SYN과 연결 완성의 경쟁에서 생기기 때문입니다.
Red Hat 공지가 이 결함에 정밀한 타이밍이 필요하다고 적은 이유도 이 그림에서 나옵니다. 두 CPU의 순서가 어긋나는 짧은 틈에서만 문제가 생기므로 같은 패킷을 보내도 매번 같은 결과가 나오지 않습니다(편집부 해설). 그래서 서버 로그가 조용하다는 것은 안전의 증거가 못 됩니다. 문제가 생기지 않은 날과 문제가 생기지 않을 수 있는 서버는 다릅니다.
해제된 메모리를 읽으면 생기는 일, 작은 장난감으로
해제된 메모리를 읽는다는 말은 추상적입니다. 읽으면 무슨 일이 생기는지를 보이려고 편집부가 사용자 공간에서 돌아가는 작은 C 프로그램을 만들었습니다. 커널과 아무 관계가 없는 장난감이며, 커널 결함의 재현이 아닙니다. 객체 하나를 두 곳에서 가리키다가 한쪽이 해제했을 때 일반적인 메모리 할당기가 어떻게 행동하는지만 보여 줍니다.
struct opt *a = malloc(sizeof *a); strcpy(a->data, "OPT-OF-CONN-A");
struct opt *stale = a;                /* 같은 주소를 든 두 번째 손 */
free(a);                              /* 소유자가 즉시 반납 */
struct opt *b = malloc(sizeof *b);    /* 할당기가 그 자리를 다른 쪽에 줌 */
strcpy(b->data, "SECRET-OF-B");
printf("%s\n", stale->data);          /* 해제된 포인터로 읽기 */
Alpine(musl)에서 컴파일해 실행한 출력입니다.
stale==b ? yes (same slot reused)
holder reads through stale pointer: SECRET-OF-B
해제한 자리를 할당기가 곧바로 다른 용도로 내주었고, 낡은 포인터로 읽으니 원래 값(OPT-OF-CONN-A)이 아니라 새 주인의 값이 나왔습니다. 이 출력에서 얻을 것이 두 가지입니다. 첫째, 해제된 메모리를 읽는 코드는 곧바로 죽지 않을 수 있고, 읽은 값이 엉뚱하다는 사실을 프로그램은 모른 채 계속 돌아갑니다. 둘째, 그 엉뚱한 값은 누가 그 자리를 새로 얻었는가에 따라 달라집니다. 커널은 같은 메모리 풀을 네트워크 버퍼, 소켓, 파일 구조체가 나눠 쓰므로, 낡은 포인터가 읽는 내용은 커널 안의 다른 용도일 수 있습니다. 이것이 use-after-free가 단순한 충돌(서비스 거부)과 메모리 손상 양쪽의 위험으로 분류되는 이유입니다. Red Hat 공지도 현실적인 영향은 충돌이고 메모리 손상도 가능하다고, 임의 코드 실행은 정밀한 힙 제어가 필요하다고 구분해서 적었습니다.
이 부류의 오류를 잡는 도구가 커널 문서에 있습니다. KASAN(Kernel Address Sanitizer)은 문서의 정의로 범위 밖 접근(out-of-bounds)과 use-after-free를 찾는 동적 메모리 안전 검사기입니다. Generic 모드는 커널 메모리의 8분의 1을 그림자 메모리로 쓰는데, 그림자 바이트 하나가 실제 8바이트의 접근 가능 여부를 나타내며 00이면 전부 접근 가능, 음수 값이면 레드존이나 해제된 메모리 같은 접근 불가를 뜻합니다. 컴파일러가 모든 메모리 접근 앞에 __asan_load*()와 __asan_store*() 검사를 끼워 넣습니다. 문서에 따르면 Generic KASAN만 해제된 객체의 재사용을 늦추는 격리(quarantine)를 둡니다. 이 문서 내용을 이 글의 장난감에 비춰 보면, 위에서 본 즉시 재사용이 검사기가 막으려는 상황의 반대입니다. 검사 보고서에는 잘못된 접근의 스택, 할당 지점의 스택, 해제 지점의 스택이 함께 나옵니다. use-after-free를 고치려면 누가 읽었고 누가 먼저 해제했는가를 모두 알아야 하기 때문입니다. 이 CVE의 수정 설명이 두 함수(inet_sock_destruct(), tcp_v4_reqsk_destructor())를 지목한 것도 같은 방식으로 읽힙니다.
한 가지 짚습니다. KASAN은 느리고 메모리를 많이 써서 보통 디버깅용 커널에서 돌립니다(문서가 Generic 모드를 디버깅용, 상당한 성능과 메모리 오버헤드로 설명). 문서에 따르면 arm64 하드웨어 태그 방식(HW_TAGS)은 오버헤드가 낮아 운영에서도 쓸 수 있는 선택지이지만 첫 번째 오류만 보고합니다. 디버그용 빌드가 아닌 커널에서는 이 결함이 일어나도 KASAN 보고서가 로그에 남아 알려 주기를 기대할 수 없습니다. 로그가 깨끗하다는 말이 왜 안전의 근거가 못 되는지 하나 더 늘어난 셈입니다(편집부 해설).
세 번째 관문: 고친 코드가 기다리는 것
수정은 짧습니다. 옵션 메모리를 반납하는 두 곳에서 kfree()를 kfree_rcu()로 바꿨습니다. 그런데 이 바꿈이 왜 문제를 없애는지 이해하지 못하면 고쳐졌다는 문장은 믿음일 뿐입니다. 그래서 커널 문서의 RCU 설명을 읽어 봤습니다.
RCU(Read-Copy-Update)는 문서가 지우는 쪽은 이미 읽기 구간에 들어와 있는 읽는 쪽이 모두 끝날 때까지 기다린 다음에 메모리를 반납한다는 방식으로 설명하는 동기화 방법입니다. 읽는 쪽은 rcu_read_lock()과 rcu_read_unlock()으로 읽기 구간을 표시하고, 문서에 따르면 그 안에서 접근한 데이터는 구간이 끝날 때까지 회수되지 않은 채 남습니다. 지우는 쪽은 먼저 포인터를 제거해 새 읽는 쪽이 객체에 닿지 못하게 만든 다음, synchronize_rcu()로 기다리거나 call_rcu()로 콜백을 예약합니다. 문서는 synchronize_rcu()가 모든 CPU에서 이미 진행 중이던 읽기 구간이 끝날 때까지 기다리며 이후에 시작한 읽는 쪽은 기다리지 않는다고 적습니다. 이 기다리는 시간이 유예 기간(grace period)입니다. 콜백이 단순히 kfree() 호출뿐이라면 kfree_rcu(old_fp, rcu) 한 줄로 쓸 수 있다고도 문서가 안내합니다. CVE-2026-98432 수정이 바로 이 한 줄입니다.
이 설명에 이 결함의 그림을 대입하면 수정의 효과가 보입니다. 앞의 그림 2에서 CPU B는 옵션 객체를 읽는 중이었습니다. 수정 후에는 자식 소켓이 사라져 kfree_rcu()가 호출되어도, 그 시점에 이미 읽기 구간에 들어와 있던 CPU B가 구간을 나올 때까지 반납이 미뤄집니다. 반대로 말하면 이 수정은 읽는 쪽이 RCU 읽기 구간 안에서 객체를 읽는다는 전제 위에 서 있습니다. 해제 쪽만 바꿔서는 읽는 쪽이 구간 밖에서 읽는 경로가 있을 때 효과가 없습니다. 수정이 두 줄로 작아 보여도 그 한 줄은 읽는 쪽의 규칙과 맞물려 있습니다(편집부 해설).
이를 사용자 공간 장난감으로도 확인했습니다. 앞의 C 프로그램의 두 번째 부분은 느린 읽는 쪽이 객체를 쥐고 있는 동안 지우는 쪽이 포인터를 먼저 끊고(새 읽는 쪽 차단), 읽는 쪽 수가 0이 될 때까지 기다린 다음 해제합니다. 진짜 RCU가 아니라 읽는 쪽 개수를 세는 흉내이며, 같은 순서를 눈으로 보려는 용도입니다.
reader still sees: OPT-OF-CONN-A
free after readers done, waited about 120 ms
읽는 쪽은 자기 일을 끝낼 때까지 원래 값을 정상적으로 봤고, 해제는 약 120ms 뒤에 일어났습니다. 첫 장난감과 같은 객체, 같은 두 손인데 해제 시점만 바뀌었습니다. 이 기다림이 kfree_rcu()의 값입니다. 유예 기간 동안 메모리가 붙들려 있으므로 해제가 늦춰진 만큼 반납이 미뤄지고, 문서도 call_rcu() 계열은 호출 비율을 제한해야 한다고 적습니다. 그리고 수정이 들어간 커널은 이전 커널과 해제 시점이 다른 코드입니다. 이 차이가 바로 다음 관문의 주제와 이어집니다. 수정은 업스트림에서 한 번 쓰이고, 각 배포판이 자기 커널 계열에 맞게 다시 옮겨 담습니다.
네 번째 관문: 업스트림 커밋과 내 패키지 사이
수정이 원리상 맞아도, 내 서버에 도착하는 것은 업스트림 커밋이 아니라 배포판이 만든 패키지입니다. 여기서 숫자가 사람을 속입니다.
Debian 트래커는 업스트림 수정 커밋이 Linux 7.3-rc7에 들어갔다고 적었습니다. 그런데 같은 페이지의 상태표에서 수정된 패키지는 bookworm의 6.1.190-1, trixie의 6.12.113-1입니다. 커널 계열이 6.1과 6.12이므로 업스트림 7.3 소스를 올린 것이 아니라, 수정을 해당 계열 소스에 옮겨 담은 패키지(백포트)입니다. 같은 이름의 배포판 릴리스 안에서 6.1.176-1은 취약이고 6.1.190-1은 수정으로 기록되어 있습니다. 두 패키지는 둘 다 Debian 12이고 둘 다 6.1입니다. 릴리스 이름도 커널 계열 숫자도 구별해 주지 못하고, 패키지 빌드 번호만 구별해 줍니다(편집부 해설).
아래 그림은 같은 사실을 격자로 보인 것입니다. 각 행은 릴리스와 패키지 빌드의 조합이며, 한 행에서는 한 칸만 켜집니다.
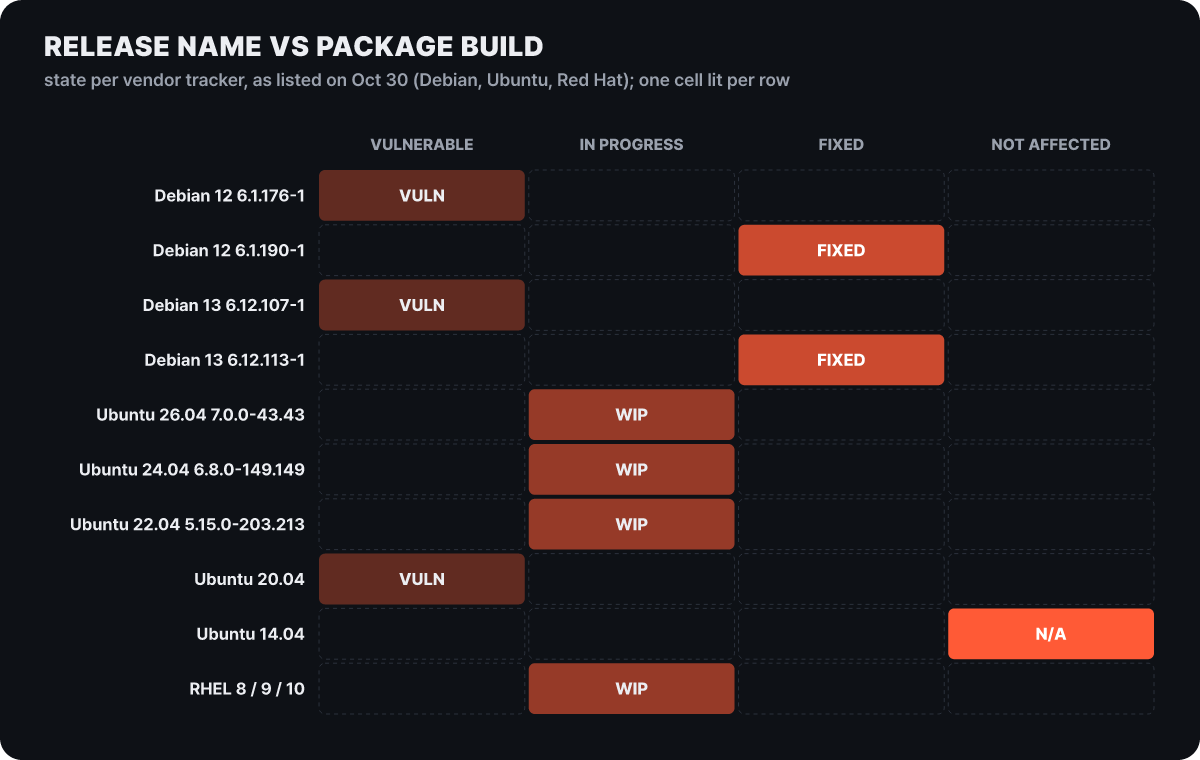 그림 4. 공식 트래커가 10월 30일 기준으로 적은 릴리스·패키지 빌드별 상태(Debian, Ubuntu, Red Hat)
그림에서 읽을 점이 세 가지 있습니다. 첫째, Debian의 두 행씩을 보면 같은 릴리스가 취약 칸과 수정 칸에 각각 나타납니다. 상태가 릴리스에 붙는 것이 아니라 빌드에 붙는다는 뜻입니다. 둘째, Ubuntu는 22.04, 24.04, 26.04가 모두 진행 중(WIP)이고 20.04는 취약, 14.04는 영향 없음으로 칸이 갈립니다. 같은 배포판 안에서도 지원이 끝난 릴리스는 수정 없이 남을 수 있습니다. 셋째, Red Hat은 영향 제품을 RHEL 8, 9, 10과 OpenShift로 적고 상태를 진행 중으로 표기했으며 공지 시점에 에라타가 없었습니다. 이 칸들의 상태는 시간이 지나며 움직입니다. 이 글의 값은 10월 30일 시점 기록이고, 읽는 날에는 각 트래커의 현재 기록이 기준입니다.
이 격자는 내 서버의 버전 번호를 어디에 넣어 어느 칸에 놓을지를 묻습니다. 실무 절차는 이렇습니다.
- 패키지 빌드를 정확히 적기:
uname -r은 실행 중인 커널 릴리스를, 패키지 관리자 조회는 설치된 패키지 빌드를 보여 줍니다. 둘이 다를 수 있으므로 둘 다 적습니다. - 트래커의 같은 칸 찾기: 배포판의 보안 페이지에서 내 릴리스와 빌드 번호를 찾아 칸을 정합니다. Debian은 릴리스별 표, Ubuntu는 릴리스별 상태, Red Hat은 RHSB와 에라타가 기준입니다.
- 변경 이력으로 대조하기: 패키지 변경 이력에 CVE 번호가 있는지 읽습니다. 번호 비교가 아니라 이력 대조라서, 버전 숫자의 착시를 피합니다.
한 가지 더 있습니다. 업스트림 버전 번호와 비교하는 방식이 의미를 갖는 경우는 배포판 패키지가 아니라 직접 빌드한 커널을 쓸 때뿐입니다. 이때는 업스트림 커밋이 내 소스 트리에 들어 있는지를 소스에서 직접 봐야 합니다. 기준이 7.3-rc7 이상이라는 한 줄로 끝나는 것이 아니라, 내가 쓰는 안정 계열 브랜치가 이 수정을 받았는지의 문제이기 때문입니다.
다섯 번째 관문: 설치한 커널과 돌고 있는 커널
패키지가 올바른 빌드라고 확인되었다고 해도 아직 끝나지 않았습니다. 커널은 실행 중인 프로그램이 아니라 부팅할 때 메모리에 올라온 코드입니다. 패키지를 설치하면 디스크에 새 커널 파일이 생기고 부트로더 항목이 바뀌지만, 이미 돌고 있는 커널은 그대로입니다. 재시작하기 전까지 서버는 이전 커널입니다.
설치한 것과 돌고 있는 것을 구별하는 가장 간단한 방법은 두 값을 나란히 놓는 것입니다.
uname -r                      # 지금 메모리에 올라와 있는 커널 릴리스
# Debian 계열: 설치된 커널 이미지 패키지 목록
dpkg -l 'linux-image-*' | grep '^ii'
# RPM 계열: 설치된 커널 패키지 목록
rpm -q kernel
last -x reboot | head -3      # 마지막 재시작 시각
uname -r이 목록에서 가장 새로운 패키지의 릴리스와 같고, 마지막 재시작 시각이 패키지 설치 시각보다 뒤라면 그 서버는 새 커널로 돌고 있는 것입니다. 하나라도 어긋나면 설치는 되었고 적용은 안 된 서버입니다. Ubuntu 트래커가 상태 칸에 적은 수정 작업 중(WIP)과 별개로, 이미 수정판이 나온 Debian 쪽에서도 이 어긋남은 흔합니다. 자동 설치 설정을 쓰는 서버는 패키지는 최신인데 재시작이 밀려 이전 커널로 돌고 있는 상태가 되기 쉽습니다(편집부 해설).
재시작이 어려운 서버를 위해 일부 배포판과 벤더는 라이브 패치를 제공합니다. 실행 중인 커널 메모리의 함수를 바꿔치는 방식이라, 라이브 패치가 적용된 서버는 재시작 없이 수정판처럼 동작합니다. 다만 라이브 패치가 이 CVE를 덮는다는 것은 해당 벤더가 이 CVE용 패치를 냈을 때 성립하는 조건입니다. 라이브 패치 서비스를 쓴다는 사실이 모든 CVE를 덮는다는 뜻이 아니므로, 서비스 제공자의 공지에서 CVE 번호를 찾아야 합니다. 그래서 라이브 패치를 쓰는 서버도 벤더의 CVE 목록에서 번호를 찾은 뒤에야 이 관문을 지났다고 적을 수 있습니다.
관문 4와 5를 함께 보면 하나의 사실이 나옵니다. 서버가 안전한 상태는 패키지 목록 상 수정된 빌드가 설치됨과 부팅 기록 상 그 커널로 부팅됨이라는 서로 다른 두 장부가 모두 맞아야 성립합니다. 패키지 관리 장부만 보고 보고서를 쓰면 5번째 관문을 건너뛰게 됩니다.
같은 커널을 쓰는 서버가 몇 대인지 세는 법
관문 5는 한 대의 서버 이야기였습니다. 마지막 관문은 서버 대수를 세는 방식의 문제입니다. 컨테이너는 호스트의 커널을 공유합니다(편집부 해설). 이를 편집부가 눈으로 확인한 실험이 있습니다. 앞의 일회용 컨테이너 안에서 운영체제 배포판 정보와 커널 릴리스를 읽었습니다.
$ uname -r
6.12.5-linuxkit
$ cat /etc/alpine-release
3.24.3
컨테이너 이미지의 사용자 공간은 Alpine 3.24.3인데 커널은 그 이미지와 상관없는 호스트 쪽 LinuxKit 6.12.5입니다. 이미지를 아무리 최신 보안 패치로 다시 빌드해도 uname -r의 값은 바뀌지 않습니다. 컨테이너 이미지 안의 패키지 목록에는 커널이 없거나 있어도 실행에 쓰이지 않습니다. 그래서 이 CVE처럼 커널이 원인인 결함은 이미지 스캐너가 취약점 없음이라고 보고해도 해결되지 않습니다(편집부 해설).
이 점은 Red Hat 공지에도 나타납니다. 공지는 영향 제품으로 RHEL, OpenShift Container Platform을 적고, RHEL CoreOS와 OpenStack Platform, Virtualization 같은 상위 제품도 영향받을 수 있다고 안내합니다. 컨테이너 플랫폼의 노드가 커널을 호스트로 쓰기 때문에, 플랫폼 제품 이름이 영향 목록에 올라오는 것입니다. 그렇다면 센다는 문제는 이렇게 바뀝니다. 점검 대상은 배포한 서비스 수가 아니라 서로 다른 커널이 몇 개 돌고 있는가입니다. 노드 100대 위에서 서비스 1,000개가 돌아도, 취약 여부를 결정하는 단위는 노드 100대의 커널입니다. 반대로 서비스 한 개가 노드 세 종류에 걸쳐 있다면, 그 서비스는 세 개의 다른 상태 위에 올라가 있습니다.
노드를 새로 만들어 교체하는 운영 방식에서는 질문이 한 단계 앞으로 옮겨 갑니다. 새 노드를 띄울 때 쓰는 부팅 이미지(클라우드 이미지, 골든 이미지)에 수정 커널이 들어 있느냐가 기준입니다. 이미지를 고치지 않은 채 노드만 교체하면 취약한 커널이 다시 올라옵니다. 클라우드의 관리형 노드 서비스는 공급사가 커널을 교체하는 시점이 서비스마다 다릅니다. Ubuntu 트래커에 클라우드 파생 패키지(linux-aws, azure, gcp, oracle, gke 등)가 별도 줄로 올라가 있고 지원 중인 릴리스 대부분이 진행 중, 오래된 릴리스는 취약으로 표기된 것도 같은 구조를 보여 줍니다. 파생 커널은 기본 커널과 상태 줄이 따로 있습니다. 그러므로 Ubuntu 24.04의 상태를 한 번 읽는 것으로 24.04 서버 전체를 말할 수 없습니다. 내 서버가 어떤 커널 패키지(linux, linux-aws, linux-hwe 등)를 쓰는지 알아야 올바른 줄을 읽습니다.
가상 머신 환경도 비슷합니다. 게스트 커널은 게스트가 관리하므로 하이퍼바이저 쪽을 업데이트해도 게스트 서버의 커널은 그대로입니다. 반대로 게스트를 고쳤다고 호스트가 고쳐지지는 않습니다. 이번 결함은 TCP를 받는 쪽 커널의 문제이므로, 외부 TCP 연결을 받는 서비스가 어느 커널 위에 있는지를 지도로 그려 두는 것이 첫 일입니다.
이 지도에는 열 개 안팎의 항목이면 충분합니다. 서버 이름, 커널 패키지 이름과 빌드, 마지막 재시작 시각, 위에서 도는 컨테이너 플랫폼, 부팅 이미지 이름입니다. 항목은 적지만 항목들이 서로 다른 장부(패키지 관리, 부팅 기록, 이미지 레지스트리, 노드 풀 정의)에 흩어져 있어 모으는 일이 어렵습니다.
패치가 없는 동안 입구에서 할 수 있는 일과 한계
수정 커널이 아직 없거나 재시작 일정을 잡을 수 없는 서버에는 Red Hat이 임시 필터를 안내했습니다. 공지에 따르면 완전한 해결은 패치뿐이고, 필터는 업무에 필요한 통신을 방해할 수 있으니 시험 환경에서 먼저 확인해야 하며, 패치 뒤에는 규칙을 삭제합니다. 규칙은 nftables에서 IP 헤더 길이가 5워드를 넘는 IPv4 TCP 패킷을 세고 버리는 형태입니다. 위 두 번째 관문에서 본 IHL 개념이 그대로 규칙의 조건이 됩니다. IHL이 5보다 크다는 것은 옵션이 붙었다는 뜻이기 때문입니다.
이 규칙이 실제로 의도대로 동작하는지를 편집부가 직접 확인했습니다. 같은 일회용 컨테이너 안에서 이름만 다른 테이블을 만들고(hotfix_demo), 먼저 세기만 하는 규칙으로 평범한 연결과 옵션 달린 연결을 한 번씩 맺었습니다.
table inet hotfix_demo {
	chain g {
		type filter hook input priority filter - 10; policy accept;
		ip protocol tcp ip hdrlength > 5 counter packets 4 bytes 232
	}
}
두 번 연결을 맺었는데 카운터는 4패킷, 232바이트입니다. 규칙은 IP 옵션이 붙은 패킷만 세므로, 옵션을 붙인 연결 쪽의 패킷들이 센 것입니다. 두 연결 모두 0.000초에 성립했고 이 단계에서는 아무것도 버려지지 않았습니다. 이어서 counter 뒤에 drop을 붙이고 같은 두 연결을 다시 맺었습니다.
plain connected in 0.000s
opt failed: TimeoutError after 3.0s
... ip protocol tcp ip hdrlength > 5 counter packets 3 bytes 192 drop
평범한 연결은 그대로 성립했고, 옵션이 붙은 연결은 3초 대기 끝에 시간 초과로 실패했습니다. 카운터에는 3패킷이 찍혔습니다. 옵션 달린 SYN이 재전송될 때마다 걸러진 숫자입니다. 같은 규칙이 입구에서 옵션 달린 SYN만 골라 버린다는 것과, 그 SYN이 서버 소켓에 닿지 않는다는 것이 확인되었습니다. 이 규칙을 nft delete table로 지우고 rc=0을 확인했습니다. 임시 규칙은 적용한 만큼 제거 절차도 기록해 두는 것이 안전합니다. 앞의 그림 1에서 붉게 칠한 4바이트가 이 필터가 보는 유일한 신호입니다. IHL 값이 5냐 6이냐가 곧 규칙의 조건입니다.
규칙을 넣기 전에 알아 둘 한계도 있습니다(편집부 해설).
- 서버 단위 필터는 그 서버로 들어오는 패킷만 거릅니다. 앞단 로드 밸런서나 방화벽에서 옵션 패킷을 버리면 한 번에 여러 서버를 덮을 수 있습니다. 반대로 앞단이 옵션을 그대로 통과시키는 장비라면 규칙은 각 서버에 필요합니다. 앞단 장비가 옵션 패킷을 이미 버린다는 것은 장비 설정과 카운터로 확인한 경우에만 믿습니다.
- 옵션을 쓰는 정상 트래픽이 있으면 같이 버려집니다. RFC 791의 Record Route나 Timestamp 같은 옵션을 쓰는 진단 도구, 일부 특수한 장비 연동이 해당합니다. 규칙의 조건이 옵션 있음 전부라서 정상과 비정상을 구별하지 않습니다.
- 이 필터는 IPv4 TCP 입구에 대한 것입니다. 결함의 첫 갈래가 IPv4 옵션 경로에서 나오므로 그 입구를 줄이는 효과가 있고, 결함의 원인인 코드를 고치지는 않습니다. 완전한 해결은 수정 커널이라는 Red Hat 공지의 문장이 이 한계를 정리합니다.
- 소켓 이전 설정 확인은 별개입니다. 두 번째 갈래는
tcp_migrate_req=1이거나 이전용 eBPF 프로그램이 있을 때 해당합니다. 값을 읽는 명령sysctl net.ipv4.tcp_migrate_req는 상태를 바꾸지 않고,ss -tnlp는 리스너를 보여 줍니다.
여기서 RFC 4987의 SYN 상태 이야기가 한 번 더 도움이 됩니다. 문서는 SYN 쿠키가 SYN-RECEIVED에서 상태를 할당하지 않는다고 설명하고, SYN 쿠키가 TCP 옵션과 호환되지 않는 경우를 지적합니다. 커널 문서의 tcp_syncookies도 기본값 1에서 SYN 백로그가 넘칠 때만 쿠키를 보내며 이를 부하가 높은 서버를 돕는 용도로 쓰지 말라고 적습니다. 편집부가 위 컨테이너에서 읽은 값도 1이었고 tcp_max_syn_backlog는 2048이었습니다. 이 설정들은 SYN 홍수에 대응하는 장치이고, 이번 CVE의 완화책으로 공지에 오른 것은 Red Hat의 옵션 패킷 필터입니다. 그러므로 SYN 쿠키가 켜져 있다는 사실로 이 결함의 노출을 판단할 수 없습니다.
안전이라는 문장에 붙는 날짜
여기까지 세 가지 장부를 맞춰 보았습니다. 패키지 장부는 어떤 빌드가 설치되었는지, 부팅 장부는 그 커널로 실제로 시작했는지, 인프라 장부는 같은 커널 위에 몇 개의 실행 환경이 올라 있는지를 말합니다. 세 장부는 각각 다른 사람이 쓰고 다른 주기로 갱신됩니다. 그래서 안전하다는 문장은 마침표가 아니라 날짜가 붙은 기록으로 적는 편이 정확합니다. 11월 2일 기준, 이 서버는 이 패키지 빌드로 이 시각에 재시작해 돌고 있다는 문장은 나중에 트래커의 상태가 바뀌었을 때 다시 읽고 고칠 수 있지만, 날짜 없이 적은 패치 완료는 공지가 갱신되는 순간부터 근거를 잃습니다. 이 사건에서 트래커의 칸들은 아직 움직이고 있었고(Ubuntu의 진행 중과 Red Hat의 진행 중이 그 예), 서버의 칸도 같이 움직입니다. 패치가 나왔는지를 묻는 질문이 같은 날짜의 부팅 기록을 함께 찾게 만든다면, 이 글이 던진 질문은 제 몫을 한 것입니다.
출처
- Debian Security Tracker security-tracker.debian.org
- Ubuntu Security ubuntu.com
- Red Hat CVE access.redhat.com
- Red Hat RHSB-2026-016 access.redhat.com
- Linux kernel docs: RCU kernel.org
- Linux kernel docs: KASAN kernel.org
- Linux kernel docs: ip-sysctl kernel.org
- RFC 9293 rfc-editor.org
- RFC 791 rfc-editor.org
- RFC 4987 rfc-editor.org