스킬 31,132개 중 26.1%가 취약했다, 설치 전에 검사하는 SkillSpector
26.1%라는 숫자가 어떤 표본과 방법에서 나왔는지 읽고, NVIDIA의 스킬 검사기 SkillSpector가 이를 점수로 바꿀 때 무엇을 밖으로 보내고 무엇을 못 보는지 정리했습니다.
스킬 네 개 중 하나가 취약하다는 숫자와, 의심스러운 스킬은 0.52%뿐이라는 숫자가 같은 해에 나왔습니다. 앞의 것은 2026년 1월 논문 “Agent Skills in the Wild”가 31,132개를 분석해 낸 26.1%이고, 뒤의 것은 3월에 나온 “Context Matters”가 저장소 맥락을 더해 다시 걸러서 얻은 값입니다. 둘은 서로를 반박하지 않습니다. 분모와 표본, 검사 방식이 다르기 때문입니다. NVIDIA가 GitHub(NVIDIA/SkillSpector)에 공개한 SkillSpector는 앞의 논문을 연구 배경으로 밝힌 스킬 검사기이고, 2026-10-27 UTC 기준 별 21,973개, 포크 1,924개, Apache-2.0 라이선스이며 최신 릴리스는 10월 23일의 v2.13.1입니다. 이 글은 26.1%가 어떻게 만들어졌는지 분모부터 읽고, 같은 숫자가 검사기를 바꾸면 어떻게 움직이는지 본 다음, SkillSpector가 그 숫자를 점수로 바꿔 쓸 때 무엇을 믿고 무엇을 컴퓨터 밖으로 보내는지 따라갑니다.
42,447개가 31,132개로 줄어든 길
논문 팀은 2025년 12월에 스킬 장터 두 곳을 훑었습니다. skills.rest에서 27,365개, skillsmp.com에서 15,082개를 모아 합이 42,447개이고, 여기에 딸린 스크립트가 54,980개였습니다. 그런데 최종 분석 대상은 31,132개입니다. 차이 11,315개(편집부 계산)는 네 가지 조건으로 빠졌습니다. 내용이 같은 파일은 SHA-256 해시로 하나만 남겼고, 지침이 10줄 미만인 스킬, 영어가 아닌 스킬, 그리고 저장소가 이미 삭제된(404) 스킬을 뺐습니다. 이 가운데 삭제된 저장소가 7,353개로 처음 수집량의 17.3%입니다. 남은 31,132개는 두 장터에 skills.rest 20,048개(64.4%), skillsmp.com 11,084개(35.6%)로 나뉩니다.
스크립트 쪽 변화는 더 큽니다. 54,980개 중 51,406개가 빠져 3,574개만 남았습니다(93.5% 감소). 빠진 것의 68%는 여러 스킬이 복사해 쓴 같은 파일, 24%는 상용구, 8%는 스킬이 아닌 코드였습니다. 그래서 이 논문의 세는 단위는 스크립트가 아니라 스킬이고, 스킬 하나는 한 번만 셉니다.
분모에서 읽을 점은 두 가지입니다. 하나는 이 숫자가 영어로 쓰인 스킬만의 값이라는 것입니다. 다른 하나는 저장소가 지워진 스킬이 처음부터 빠졌다는 점입니다. 악의가 있는 스킬일수록 일찍 신고되어 사라졌다면 지워진 쪽에 더 많았을 텐데, 그 쪽이 통째로 표본 밖입니다. 논문도 이를 생존 편향으로 적고, 12월 시점의 스냅샷이 기업 환경이나 이후 생태계를 대표하지 않을 수 있다고 한계에 밝혀 둡니다. 그래서 26.1%는 “스킬 전체의 26.1%“가 아니라 “2025년 12월에 두 장터에 살아 있던 영어 스킬 31,132개 중 26.1%“로 읽어야 합니다.
26.1%를 100칸으로 쪼개면
이제 분자입니다. 취약점을 하나 이상 가진 스킬은 8,126개이고, 논문은 패턴마다 심각도를 미리 정해 두고 스킬 하나를 가장 높은 심각도로 한 번만 셉니다. 아래 그림은 31,132개를 100칸으로 줄여, 어느 심각도가 얼마를 차지하는지 칸 수로 세게 합니다.
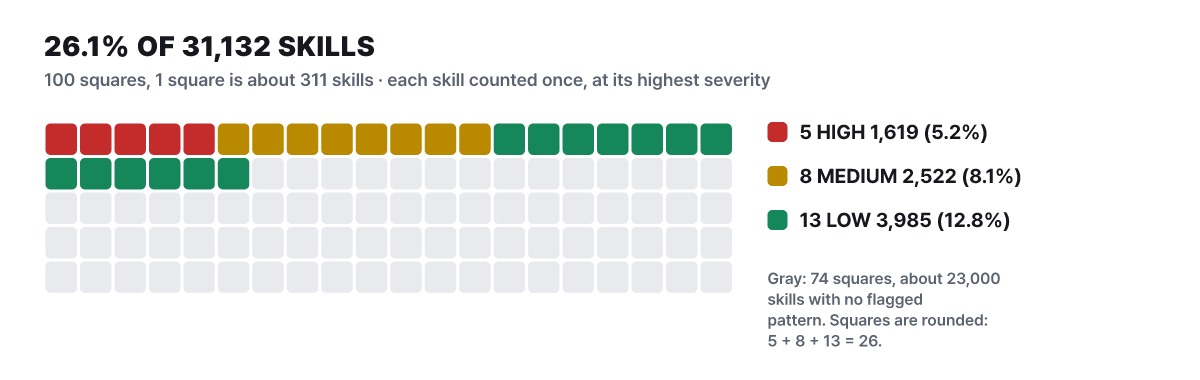 그림 1. 취약 스킬 8,126개의 심각도 구성. 칸 수는 반올림이고 개수·비율은 논문 값
칠해진 26칸 가운데 절반이 낮음(12.8%)입니다. 이 칸에는 버전을 고정하지 않았거나 권한을 넓게 요청한 정도의 위생 문제가 많이 들어갑니다. 악의를 시사하는 높음은 5.2%로 가장 작습니다. 범주로 가르면 데이터 유출이 4,133개(13.3%), 권한 상승이 3,671개(11.8%), 공급망이 2,296개(7.4%)이고 프롬프트 주입은 209개(0.7%)입니다. 네 숫자를 더하면 10,309로 8,126을 넘는데, 취약 스킬의 44.2%(3,594개)가 둘 이상의 범주에 걸치기 때문입니다.
그렇다면 5.2%는 악성 스킬의 비율일까요? 논문은 그렇게 말하지 않습니다. 높음으로 분류된 1,619개 가운데 위험도가 가장 높은 87개를 사람이 직접 검토했고, 명백한 악의의 지표가 나온 것은 23개였습니다. 25개를 실제로 돌려 본 소규모 검증에서는 18개(72%)가 악용 가능한 동작을 보였고 4개는 판단이 갈렸으며 3개는 오탐이었습니다.
23은 위험도 최상위 87개 중의 값이라서 1,619개 전체로 늘려 읽을 수 없습니다. 논문 스스로도 26.1%가 고의적 악성, 부주의한 관행, 모호한 패턴을 한데 묶은 값이라고 적습니다. 논문 초록은 5.2%를 “악의를 시사하는 높은 심각도 패턴”이라 쓰는데, SkillSpector README는 이를 “악의가 있을 법한” 비율로 줄여 적습니다. 줄여 부르는 사이 “패턴”이라는 단어가 빠지는 것이 숫자가 옮겨 다니는 전형적인 모양입니다.
정밀도 86.7%는 200개 표본에서 나왔다
숫자를 만든 검사기의 정확도는 사람이 라벨을 단 표본에서 쟀습니다. 검증 집합은 200개이고 그중 63개(31.5%)가 취약한 스킬입니다. 정적 패턴만 썼을 때는 정밀도 71.4%에 재현율 91.2%, LLM 분류를 더한 최종 구성은 정밀도 86.7%(±4.7)에 재현율 82.5%(±5.3), F1은 84.6%입니다. 아래 그림은 이 두 줄 아래에 논문 부록 F의 비교를 이어 붙였습니다. 아래 네 줄은 취약 50개, 정상 50개의 100개 부분집합에서 범용 검사기 세 개와 논문 도구를 잰 값이라 표본이 다릅니다.
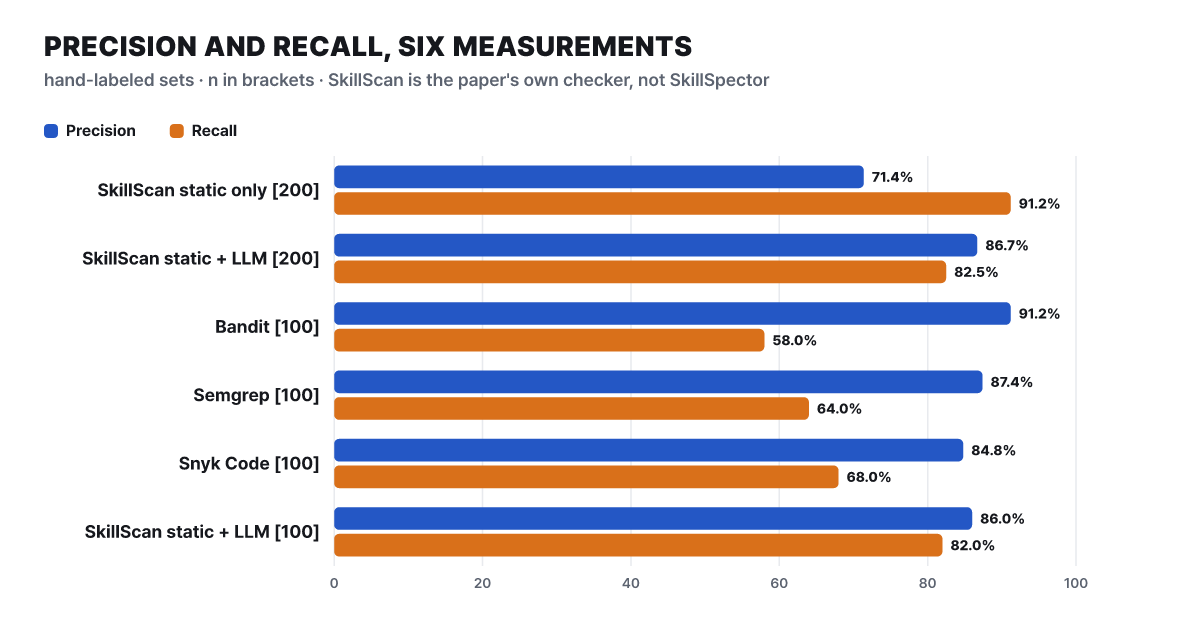 그림 2. 논문 검증 집합의 정밀도·재현율. 값은 논문 부록, 괄호의 숫자는 표본 크기
위쪽 두 줄은 정적 패턴이 그물을 넓게 쳐서 놓치는 것은 적지만 오탐이 많다는 것을 보여 줍니다. os.environ을 읽기만 해도 걸립니다. LLM 단계가 그 오탐을 걷어 내는 대가로 재현율이 8.7포인트 내려갑니다(편집부 계산). 최종 구성의 숫자를 개수로 풀면 취약한 63개 중 52개를 찾았고, 정상 137개 중 129개를 정상으로 판정했으므로 오탐은 8개입니다(편집부 계산). 52개를 찾고 8개를 잘못 걸었으니 정밀도는 52 ÷ 60으로 86.7%가 맞습니다. 아래쪽 네 줄에서는 범용 검사기의 재현율이 58~68%에 그치는데, 프롬프트 주입에서는 세 도구 모두 0%였고 논문 도구는 78.6%였습니다. 반대로 정밀도는 Bandit이 91.2%로 가장 높습니다. 코드 패턴 검사기는 확실한 것만 걸러서 틀리는 일이 적지만, 지침 속 문장이 위협인 경우는 보지 못합니다. 이 막대의 SkillScan은 논문이 만든 검사기이고 SkillSpector와는 다른 도구입니다.
숫자의 흔들림도 논문이 직접 잽니다. LLM 분류를 세 번 돌렸을 때 판정의 94.5%가 같았고, 프롬프트를 세 가지로 바꿨을 때는 91.0%가 같았습니다. 그래서 실제 비율을 2330% 사이로 보고 26.1%를 중심값으로 둡니다. 표본 추출로 생기는 95% 신뢰구간은 23.130.2%, 검사기 오분류를 보정한 값은 26.5%입니다.
보안 도구 스킬은 점수가 높게 나오는 것이 정상입니다. 보안·레드팀 분야 스킬의 검출률은 67.4%로 다른 분야와 비교가 안 될 만큼 높았습니다. 사람이 60개를 검토해 보니 68.3%는 정당한 도구의 정상 동작(자격 증명 접근, 파일 탐색)이었고, 이 분야의 보정한 비율은 21.4%로 내려갔습니다. 이 범주를 빼면 전체 정밀도가 90.6%, 보정한 유병률이 24.8%가 됩니다.
같은 장터를 아홉 번 재면 3.8%에서 41.9%
26.1%를 다른 방법으로 다시 재 본 논문이 이어서 나왔습니다. Holzbauer 외의 “Context Matters”는 3월 17일 공개되어 6월 1일 개정됐고 AgentSkills ’26 워크숍(CAIS)에서 최우수 논문상을 받았습니다. 장터 사이의 중복을 걷어 내고 남은 ClawHub 16,755개, SkillsDirectory 17,611개, Skills.sh 112,231개, GitHub 91,583개를 합해 고유 스킬 238,180개를 모았고, 여러 스캐너의 판정을 장터별로 먼저 모았습니다. 서문은 장터별 스캐너 보고서가 악성으로 분류한 비율을 ClawHub 46.8%, Skills.sh 23.0%, SkillsDirectory 6.0%로 적습니다.
같은 장터 안에서도 도구마다 값이 다릅니다. 논문 표 2의 불합격(fail) 판정 비율을 점으로 찍으면 이렇습니다. 점선이 26.1%이고 띠는 95% 신뢰구간입니다.
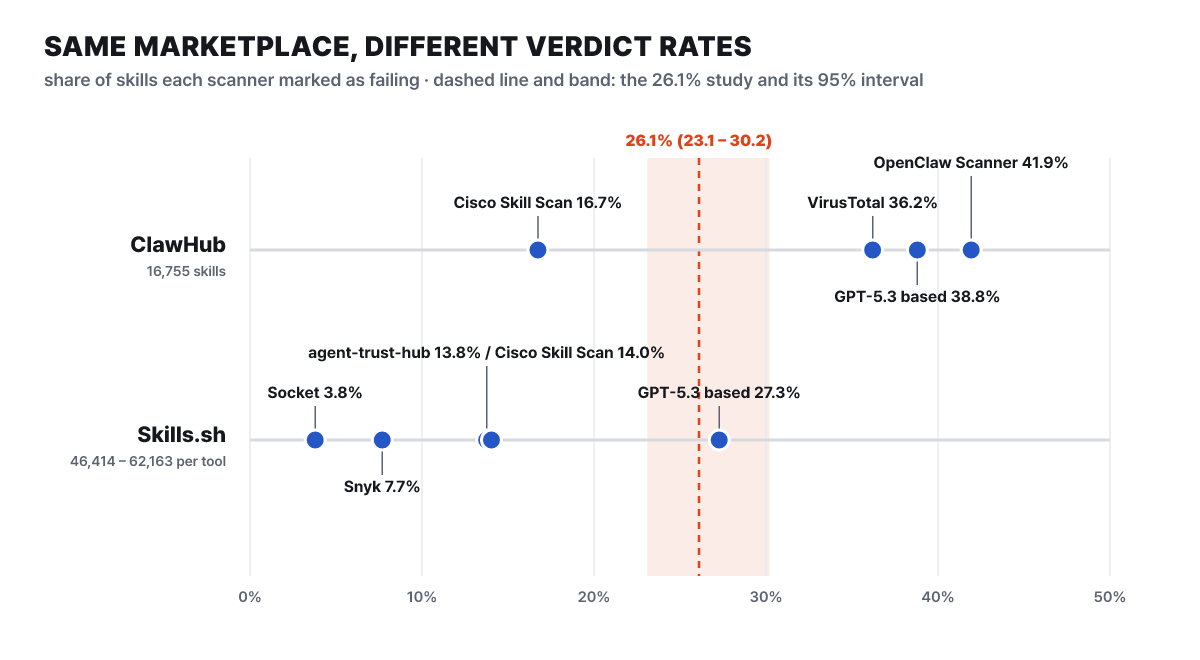 그림 3. 같은 장터를 도구별로 잰 판정 비율. 값은 Context Matters 표 2, 26.1%와 구간은 Liu 외 논문
ClawHub에서는 Cisco Skill Scan이 16.7%, VirusTotal이 36.2%, GPT-5.3 기반 분석이 38.8%, OpenClaw Scanner가 41.9%로 판정했습니다. Skills.sh에서는 Socket 3.8%, Snyk 7.7%, agent-trust-hub 13.8%, Cisco Skill Scan 14.0%, GPT-5.3 기반 분석 27.3%입니다. 각 도구가 훑은 스킬 수도 달라서 분모가 46,414개에서 62,163개까지 벌어집니다. 눈여겨볼 것은 점들이 26.1%의 양쪽에 고르게 흩어진다는 점입니다. 어떤 도구는 논문보다 훨씬 후하고 어떤 도구는 훨씬 깐깐합니다. 다섯 도구가 모두 훑은 Skills.sh 스킬 27,111개 가운데 다섯이 전부 불합격으로 판정한 것은 33개였습니다.
이 논문의 핵심은 그다음 단계입니다. Cisco Skill Scan(높음 이상)과 GPT-5.3 분석(3점 초과)이 모두 걸러 낸 스킬·저장소 조합이 8,153개였고, 여기서 저장소가 없는 ClawHub 스킬과 저장소 루트에 놓인 스킬을 뺀 뒤 3,000개를 무작위로 골랐습니다. 복제에 실패한 113개를 빼고 2,887개에 저장소 맥락 점수(메타데이터 30%, 코드베이스 70%)를 매기자 60점 이상이 1,393개(48.3%), 40~60점이 1,373개(47.6%), 40점 미만이 121개(4.2%)였습니다. 이렇게 점수를 보고 나서도 의심이 남은 조합은 15개, 곧 2,887개의 0.52%입니다. 사람 두 명이 표본 20개를 검토해 볼 수 있었던 18개를 모두 정상으로 판단했습니다.
여기서 0.52%의 분모를 잘 봐야 합니다. 238,180개의 0.52%가 아니라, 이미 두 검사기가 걸러 낸 뒤 저장소가 있는 2,887개 조합의 0.52%입니다. 이 숫자가 알려 주는 것은 “스킬의 99.5%가 깨끗하다”가 아니라 “검사기 둘이 동시에 걸어도 저장소 맥락을 보면 대부분이 정상 프로젝트의 일부로 보인다”입니다. 같은 논문은 저장소 주인이 사라진 스킬 121개가 일곱 개의 저장소로 이어진다는 점도 지적합니다. 그 이름을 제3자가 차지할 수 있는 구조여서, 직접 배포 방식을 쓰라고 권합니다. 정리하면 검사기 하나의 판정을 바로 악성의 수로 읽으면 안 되고, 반대로 맥락을 더한 낮은 숫자를 안전의 증거로 읽어도 안 됩니다.
조사 네 개를 한 표에 놓으면 보이는 단위 차이
같은 시기에 나온 조사들을 한 줄에 놓아 봅니다. 표본도 정의도 달라서 우열을 가리려는 표가 아니라, 각 숫자가 무엇을 세었는지 보려는 표입니다.
| 조사 | 시기 | 표본 | 판정 방식 | 보고한 수치 |
|---|---|---|---|---|
| Liu 외 논문 | 2026-01-15 | 장터 두 곳, 영어·저장소 생존 스킬 31,132개 | 정적 패턴 + LLM 분류(SkillScan) | 취약점 1개 이상 26.1%, 높은 심각도 5.2% |
| Snyk | 2026-02-05 | 3,984개(ClawHub 전체 + skills.sh 상위 100) | 스캐너 8종(LLM 판정 + 규칙), 사람 확인 | 악성 확인 76개, 치명 이슈 1개 이상 13.4%(534개), 그 밖 등급 이슈 36.82%(1,467개) |
| Holzbauer 외 | 2026-03-17(6월 1일 개정) | 238,180개 | 장터 스캐너 + 저장소 맥락 | 장터 판정 최대 46.8%, 맥락 반영 뒤 2,887개 중 15개(0.52%) |
| ESET H1 2026 보고서 | 2026-07-08 | 2025년 12월~2026년 5월에 본 약 90만 개 | ESET 자체 분석 | 수천 개가 명백한 악성 |
26.1%는 “패턴이 하나라도 있는 스킬”, Snyk의 13.4%는 “치명 등급 이슈가 있는 스킬”, 76개는 “사람이 악성으로 확인한 스킬”, ESET의 숫자는 “명백한 악성”입니다. 이름은 모두 “취약하다”나 “위험하다”로 줄여 불리지만 세는 대상이 다릅니다. 한 가지 더, 사람이 확인하거나 맥락을 본 숫자는 한 자릿수 퍼센트에 그칩니다. Snyk의 76개는 3,984개의 약 1.9%(편집부 계산)이고, ESET의 수천 개는 약 90만 개 가운데 1% 안팎입니다.
패턴 71개가 점수 한 줄이 되는 계산
SkillSpector는 이 연구를 사용 가능한 도구로 옮긴 쪽입니다. README는 패턴 71개를 17개 범주로 소개하고, NVIDIA 호스팅 안내문은 68개로 적습니다. 범주는 프롬프트 주입, 거부 억제, 데이터 유출, 권한 상승, 공급망, 과도한 권한, 출력 처리, 시스템 프롬프트 유출, 메모리 조작, 도구 오용, 상주 에이전트, 트리거 남용, 행동 구문 트리, 오염 추적, YARA 서명, MCP 최소 권한, MCP 도구 오염입니다. 보고서에는 번호가 붙은 규칙 ID가 그대로 찍힙니다. 지시 덮어쓰기(P1)와 주석·보이지 않는 글자 속 지시(P2), 환경 변수 수집(E2)과 외부 URL 전송(E1), 대화 문맥 유출(E4), SSH 키·토큰 읽기(PE3), 내려받아 바로 실행(SC2), 난독화(SC3), 이름만 비슷한 패키지(SC6), 알려진 CVE(SC4), 버전 미고정(SC1)이 자주 마주치는 것들입니다.
흐름은 단순합니다. 입력(폴더, zip, Git 주소, 단일 파일)을 로컬 폴더로 풀고, 파일 목록과 내용으로 맥락을 만든 다음, 분석 노드를 한꺼번에 돌리고, 결과를 모아 점수를 냅니다. 개발 문서는 분석 노드를 22개로 셉니다. LLM이 켜져 있으면 메타 분석이 발견 항목을 파일별로 다시 읽는데, 이때 정적 분석이 찾은 항목은 모델이 동의하지 않아도 사라지지 않습니다. 확인해 주지 않은 항목에는 llm-unconfirmed 태그가 붙고, 항목별 검토 결과는 JSON의 evidence.llm_review_outcome에 confirmed, disagreed, low-confidence, missing, failed 중 하나로 남습니다. 이 구조 덕분에 LLM이 “괜찮아 보인다”고 말해도 결정적인 위험 신호가 지워지지 않습니다.
점수는 발견 항목의 심각도를 더해 계산합니다. CRITICAL은 +50, HIGH는 +25, MEDIUM은 +10, LOW는 +5이고, 실행 스크립트가 있는 스킬은 합계에 1.3배를 곱합니다. 범위는 0~100입니다.
| 점수 | 심각도 | 권고 |
|---|---|---|
| 0 ~ 20 | LOW | SAFE |
| 21 ~ 50 | MEDIUM | CAUTION |
| 51 ~ 80 | HIGH | DO NOT INSTALL |
| 81 ~ 100 | CRITICAL | DO NOT INSTALL |
공식이 구간에 어떻게 닿는지 가상의 스킬 다섯 개로 계산해 봅니다. 실제 점수는 도구가 낸 값을 그대로 읽고, 아래는 공식을 이해하려는 계산 연습입니다.
| 가상의 스킬 | 발견 항목 | 스크립트 | 계산 | 권고 |
|---|---|---|---|---|
| 지침만 있는 번역 스킬 | MEDIUM 1 | 없음 | 10 | SAFE |
| 보고서 생성 스킬 | LOW 4 | 없음 | 20 | SAFE |
| 같은 스킬에 LOW 1개 추가 | LOW 5 | 없음 | 25 | CAUTION |
| 자동 설치 스킬 | HIGH 1 + MEDIUM 1 | 있음 | (25+10)×1.3 = 45.5 | CAUTION |
| 숨은 전송 코드가 든 스킬 | CRITICAL 1 + MEDIUM 1 | 있음 | (50+10)×1.3 = 78 | DO NOT INSTALL |
작은 문제가 다섯 개 쌓이면 CAUTION으로 넘어가고, 치명 항목 하나에 스크립트가 붙으면 곧바로 설치 금지 구간입니다. 점수는 심각도를 더한 값이라 확률이 아니라 정렬 기준으로 읽는 편이 맞습니다. README의 예시 출력은 HIGH 두 건에 78점을 보여 주는데, 공식으로는 (25+25)×1.3 = 65이므로 예시는 보고서의 모양을 보여 주는 용도로만 읽으세요. 점수보다 항목이 중요합니다. 항목마다 파일과 줄 번호, 걸린 코드 조각, 확신도(예: 94%), 설명이 붙어서 사람이 먼저 읽을 곳을 정해 줍니다. NVIDIA 안내문은 조치도 제시합니다. 높음이나 치명은 고치거나 공식적으로 수용할 때까지 막고, 숨은 지시와 도구 오염은 내용을 지우고, 선언하지 않은 기능은 권한 목록을 고치거나 동작을 없애고, 취약한 의존성은 올리거나 버전을 고정하거나 이유를 남기라는 식입니다.
실행 한 번에 컴퓨터를 떠나는 것
이 도구에서 가장 먼저 확인할 부분입니다. README의 신뢰 모델은 방어 수단이지 샌드박스가 아니라고 못 박고, 스킬 코드는 실행하지 않으며 정규식, 파이썬 구문 트리, YARA, 그리고 선택적 LLM으로 내용만 읽는다고 합니다. 데이터가 나가는 길은 세 갈래입니다.
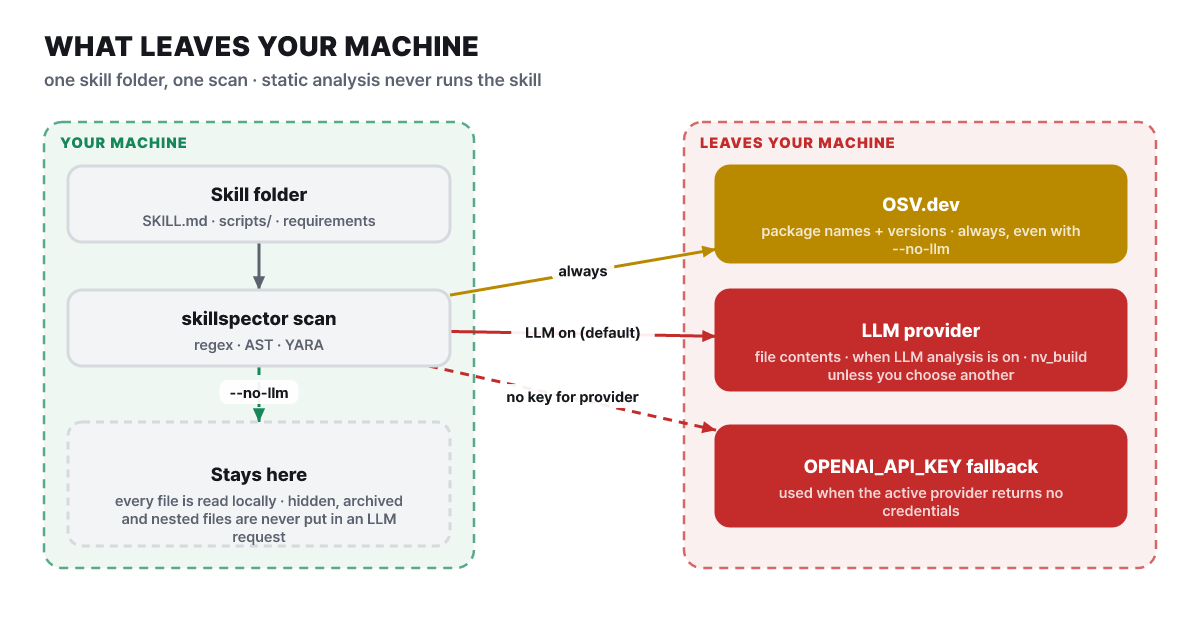 그림 4. 검사 방식별 데이터 이동. 숨김·압축·중첩 파일은 분석하되 외부 LLM 요청에는 넣지 않는다
첫째, 의존성 조회(SC4)는 --no-llm에서도 켜져 있습니다. 스킬이 선언한 패키지 이름과 버전을 OSV.dev에 묶어 보내고, 키는 필요 없으며 결과는 1시간 캐시하고 접속이 안 되면 내장 목록으로 대체합니다. 파일 내용은 보내지 않습니다. 둘째, README는 LLM 분석이 켜져 있는 것을 기본으로 적고, 켜져 있으면 분석에 쓰는 파일 내용이 활성 제공자로 갑니다. 기본 제공자는 NVIDIA Build(nv_build)이고 기본 모델은 z-ai/glm-5.3입니다. 10월 16일의 v2.13.0 릴리스 노트에 NVIDIA Build 기본 모델 교체가 들어 있습니다. 호스팅 안내문은 같은 단계를 “선택”이라고 설명하므로 두 문서가 어긋나 보입니다. 어느 쪽이든 내용을 밖으로 내보내고 싶지 않다면 --no-llm을 명시하는 것이 가장 단순한 답입니다. 셋째, 내용이 가는 곳은 제공자를 고른 대로입니다. OpenAI, Anthropic, AWS Bedrock, Gemini, Azure OpenAI, NVIDIA Build, Ollama, OpenAI 호환 엔드포인트를 쓸 수 있고, 로컬 claude·gemini·opencode 명령은 API 키 없이 로그인 세션을 쓰며 키를 지운 하위 프로세스에서 스킬 내용을 표준 입력으로만 받습니다. codex_cli는 읽기 전용 샌드박스가 호스트 파일을 읽을 수 있어 LLM 분석에서 막혀 있습니다.
제공자 키를 따로 안 줘도 환경 변수가 있으면 갈 수 있습니다. 활성 제공자가 자격 증명을 주지 못하면 OPENAI_API_KEY가 두 번째 대체로 쓰인다고 README가 적습니다. 셸에 이 변수가 이미 있다면 파일 내용이 의도하지 않은 OpenAI 쪽으로 갈 수 있습니다. 반대 방향의 보고도 있습니다. 10월 25일 접수된 이슈 #908은 LLM이 기본으로 켜진 채 제공자 키가 없으면 2.13.1에서 검사 전체가 종료 코드 2로 끝나고 출력이 하나도 없었다고 적습니다(Windows 보고, 10월 27일 현재 열려 있음). 이 경우 --no-llm이 우회로입니다.
HTTP 방식의 MCP 서버는 인증이 없어서 127.0.0.1 같은 루프백에만 묶이고, 호스트의 다른 파일을 읽지 못하도록 로컬 경로와 file:// 주소를 거부합니다. 비교 대상인 Snyk Agent Scan은 방식이 다릅니다. 컴퓨터에 설치된 에이전트·MCP 서버·스킬을 자동으로 찾아내고, Snyk API 토큰이 필요하며, 스킬 내용을 포함한 분석 정보를 Agent Scan API로 보내되 비밀 값은 가립니다. MCP 설정을 검사할 때는 설정에 적힌 명령을 실제로 실행하므로 샌드박스를 권하고, CLI 출력 형식은 실험적이라 바뀔 수 있다고 README가 밝힙니다. SkillSpector가 파일을 읽기만 하고 안정된 종료 코드와 JSON을 약속하는 것과 대조됩니다.
설치부터 첫 보고서까지
공식 안내대로 Python 3.12 이상에서 uv로 설치합니다. 설치 때 서드파티 오픈소스를 함께 내려받는다는 안내가 README에 있으니 라이선스 고지를 확인하세요. 아래는 모두 파일을 읽기만 하는 명령입니다.
- 폴더에 무엇이 들었는지 눈으로 봅니다.
scripts/가 있는 스킬은 논문이 보여 준 대로 취약 비율이 높은 쪽입니다(40.6% 대 24.2%, 승산비 2.12) - 내용을 밖으로 보내지 않는 정적 검사를 먼저 돌립니다
- 점수보다 항목 목록을 읽고, 걸린 파일 줄로 가서 직접 확인합니다
- 결과를 파일로 저장해 팀과 나눕니다(JSON, Markdown, SARIF)
uv tool install git+https://github.com/NVIDIA/skillspector.git

# 폴더 구조 보기 (읽기 전용)
ls -R ./my-skill | head -40

# 파일 내용을 밖으로 보내지 않는 정적 검사
skillspector scan ./my-skill/ --no-llm

# 보고서 저장 (파일은 소유자만 읽도록 0600으로 만들어진다)
skillspector scan ./my-skill/ --no-llm --format markdown --output report.md
echo "종료 코드: $?"
단일 파일(skillspector scan ./SKILL.md), 압축 파일(./my-skill.zip), Git 저장소 주소도 같은 방식으로 줄 수 있습니다. README의 예시 출력은 이런 모양입니다(형식을 보여 주는 예시이고 앞의 계산 연습과는 별개입니다).
 SkillSpector Security Report  v2.0.0
 Score           78/100
 Severity        HIGH
 Recommendation  DO NOT INSTALL

Issues (2)
  HIGH: Env Variable Harvesting (E2)
    Location: scripts/sync.py:23
    Confidence: 94%
  HIGH: External Transmission (E1)
    Location: scripts/sync.py:45
    Confidence: 89%
한 스크립트에서 환경 변수 수집(E2)과 외부 전송(E1)이 함께 나오면 두 항목을 하나의 이야기로 읽어야 합니다. 보고서의 설명 문장도 그 연결을 짚어 줍니다.
CI에 붙이려면 종료 코드를 알아야 합니다. 0은 “점수 50 이하(SAFE 또는 CAUTION)이고 켠 엄격 옵션에 걸리지 않음”, 1은 “점수 50 초과이거나 엄격 옵션에 걸림”, 2는 “입력 오류나 내부 실패”입니다. 기본 설정에서는 SAFE와 CAUTION이 모두 0이라서 CAUTION에서도 빌드를 멈추려면 --fail-on-findings(활성 항목이 있으면 실패), --fail-on-incomplete(검사가 부분적이면 실패), --min-coverage 퍼센트(검사 범위 하한)를 더하거나 JSON의 recommendation 값을 직접 읽으세요. 이미 검토한 결과는 기준선 파일에 넣어 두면 다음 검사부터 새 항목만 점수에 들어갑니다.
skillspector baseline ./my-skill/ -o .skillspector-baseline.yaml

skillspector scan ./skills/new-skill --no-llm \
  --baseline .skillspector-baseline.yaml \
  --format sarif --output skill.sarif --fail-on-incomplete
에이전트가 스스로 검사하게 하고 싶으면 skillspector[mcp]를 설치하고 claude mcp add skillspector -- skillspector mcp로 등록합니다. scan_skill 도구가 risk_score, severity, recommendation, safe_to_install과 함께 llm_used, scan_mode를 돌려줘서, 정적만 돌린 낮은 점수가 완전한 검사로 오해되지 않게 합니다. README는 이 stdio 경로의 초기화 멈춤(이슈 #199)이 아직 해당한다고 적지만, 이슈 자체는 7월 12일 보고자가 원인이 명령 샌드박스 제한이었음을 확인하고 닫았습니다. 설정 직후 한 번 호출해 보고 CLI로 대체할 길을 열어 두면 됩니다. 스킬을 보안 쪽에서 활용하는 사례는 Cloudflare가 만든 보안 감사 스킬에, 스킬 규격의 앞날은 Agent Skills가 재단으로 옮겨진 소식에 정리해 두었습니다.
상한에 닿으면 점수보다 부분 분석이 먼저다
README의 한계 목록은 짧습니다. 영어가 아닌 내용의 패턴을 놓칠 수 있고, 이미지 속 글자, 암호화되거나 컴파일된 코드, 실행 시점 동작은 볼 수 없습니다. 거기에 문서에서 읽은 자원 상한이 더해집니다.
| 항목 | 상한 |
|---|---|
| 한 스킬이 담을 수 있는 항목 수 | 10,000개 |
| 분석용으로 캐시하는 원본 | 64 MiB |
| 검사 전체 시간 | 600초 |
| 압축 파일 안쪽 | 깊이 3단계, 항목 1,000개, 펼친 크기 25 MiB, 5초, 한 항목 압축비 100:1 |
| 원격 입력 | 100 MiB, zip 항목 10,000개 |
| 파일 하나 | 1 MB까지 분석, 16 MiB 넘는 파일은 외부 모델에 보내지 않음 |
상한에 닿으면 검사기는 실패하는 대신 “부분 분석”으로 기록하고, 제외한 범위가 있으면 SAFE 권고가 나오지 않습니다. 문서는 이 상한을 “안전 경계이지 깨끗하다는 증거가 아니다”라고 설명합니다. 오탐도 현실입니다. v2.13.1은 HTML 주석 사이의 보이는 글을 숨은 지시(P2)로 잘못 잡던 문제를 고쳤지만, 셸 주석 속 백틱이 HIGH를 띄운다는 접수(#901)나 올바른 DB 매개변수 바인딩을 출력 주입(OH1)으로 보는 접수(#888)처럼 열린 오탐 보고가 10월 20일 이후에도 이어집니다. 기준선도 조심해서 써야 합니다. 지문 방식은 소스를 바꾸거나 SkillSpector 버전을 올리면 해당 항목이 다시 활성으로 돌아오지만, 사람이 쓴 글로브 규칙은 파일이 바뀌어도 계속 적용되어 범위가 넓으면 나중에 들어온 악성 내용까지 가립니다.
일부러 검사기를 속이는 쪽에 대한 숫자도 나와 있습니다. 7월 6일자 Cloud Security Alliance 연구 노트는 ClawHub에서 확인된 악성 스킬 1,613개를 상용·오픈소스 스캐너 8종에 통과시켰습니다. 스킬을 스스로 풀리는 포장으로 감싸자 대부분의 설정에서 99%를 넘게 우회했고, 구조만 흐려도 우회율이 80~96%였습니다. 노트가 시험한 스캐너 목록에 SkillSpector는 적혀 있지 않습니다. 다만 SkillSpector가 걸러 내는 것도 파일에 드러난 내용이고, README가 암호화·컴파일된 코드와 실행 시점 동작을 한계로 적는 것과 같은 맥락입니다.
26.1%를 읽을 때 표본과 방법을 붙인 것처럼, SkillSpector의 점수에도 조건이 붙습니다. 같은 폴더라도 --no-llm으로 돌렸는지, 어느 제공자와 모델이었는지, 상한에 걸려 부분 분석이 됐는지, 어느 버전이었는지에 따라 다른 측정입니다. 8월 28일의 v2.11.0부터 10월 23일의 v2.13.1까지 두 달 사이에 릴리스가 여섯 번 나올 만큼 규칙이 빨리 바뀌므로, 보고서를 남길 때는 점수와 함께 scan_mode와 버전을 같이 보관해 두어야 한 달 뒤에 그 점수가 무엇을 잰 값인지 설명할 수 있습니다.



