Anthropic이 Agent Skills를 재단에 넘겼다, SKILL.md는 무엇이 달라질까
Anthropic이 10월 22일 Agent Skills를 AAIF에 기증했지만 SKILL.md 형식은 그대로입니다. 공개된 pdf 스킬 폴더를 직접 내려받아 파일별로 뜯어 보며 읽히는 순서와 점검법을 정리했습니다.
$ wc -c pdf/SKILL.md pdf/forms.md pdf/reference.md
    8072 pdf/SKILL.md
   11854 pdf/forms.md
   16692 pdf/reference.md
   36618 total
Anthropic이 공개 저장소에 올려 둔 pdf 스킬을 내려받아 파일 크기를 잰 결과입니다. 에이전트에게 PDF 일을 시켜도 이 3만 6천 바이트를 전부 읽지 않습니다. 두 PDF를 합쳐 달라는 요청에는 8천 바이트만 읽고, 양식을 채워 달라는 요청에는 2만 바이트를 읽습니다. 요청마다 읽는 양이 갈리는 이 구조가 Agent Skills입니다. 이 형식을 만든 Anthropic이 10월 22일(UTC) 이름·로고·GitHub 조직·도메인을 Agentic AI Foundation(AAIF)에 기증했고, 사양 문서의 필드와 제한은 그대로입니다. 이 글은 위의 폴더를 겉에서 속으로 뜯어 보면서, 스킬이 무엇이고 재단 이전이 무엇을 건드렸는지, 남이 만든 폴더는 어떻게 읽어야 하는지를 확인합니다.
이름과 도메인만 옮겨 갔다
에이전트는 목표를 받으면 스스로 도구를 골라 쓰며 일을 이어 가는 AI입니다. 스킬은 그런 에이전트에게 “우리는 이 일을 이 순서로 한다”는 절차를 폴더 하나로 건네는 형식이고, 폴더에는 SKILL.md가 반드시 들어갑니다. Anthropic은 코딩 에이전트 Claude Code를 만드는 과정에서 이 형식이 나왔다고 설명하며, 2025년 12월에 개방 표준으로 공개했다고 밝혔습니다. AAIF는 Linux Foundation 아래에서 에이전트 관련 표준을 맡는 재단이고, 2025년 12월 9일 Anthropic의 MCP, Block의 goose, OpenAI의 AGENTS.md 세 프로젝트로 출범했습니다.
날짜 순서로 놓으면 한 해 동안의 흐름이 이렇습니다. 점 다섯 개 중 붉은 점이 이번 기증이고, 오른쪽 끝은 오늘 기준 저장소의 모습입니다.
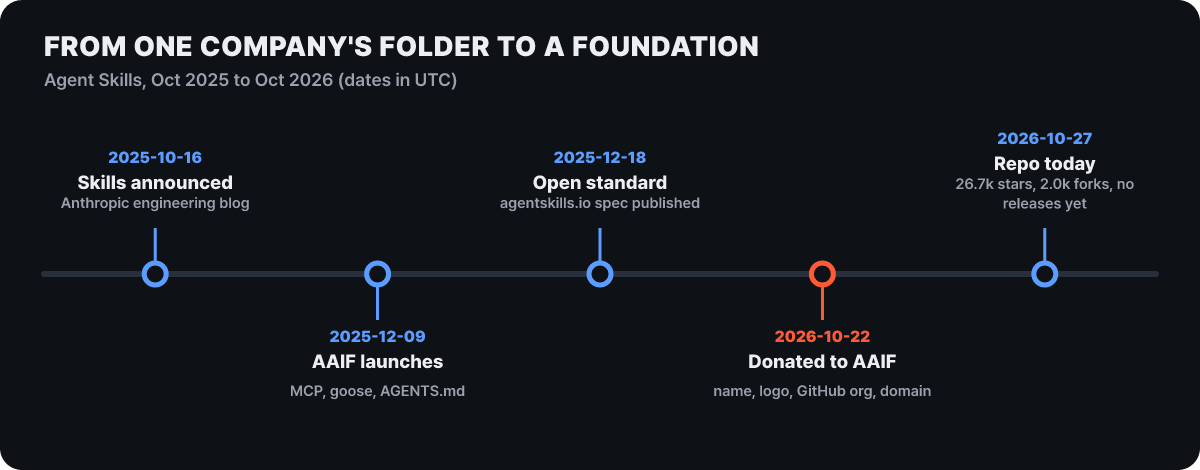 그림 1. Agent Skills의 날짜 다섯 개. 저장소 수치는 2026-10-27 확인
기증으로 넘어간 것은 Agent Skills라는 이름과 로고, GitHub 조직, agentskills.io 도메인입니다. 이후 사양은 Anthropic·Google·OpenAI 등의 엔지니어가 회사가 아닌 개인 자격으로 유지하고, 총괄은 David Soria Parra와 Mahesh Murag입니다. 쓰거나 기여하는 데 AAIF 가입은 필요하지 않습니다. Anthropic이 로드맵으로 제안한 것은 버전을 붙인 릴리스, 공식 제안 절차, 스킬 작성·설치 보안 가이드 세 가지입니다. 아직 제안 단계라서 저장소의 Releases 목록은 10월 27일 현재 비어 있고, 사양 문서의 필드·제한에도 바뀐 곳이 없습니다.
발표에 실린 규모는 70개가 넘는 에이전트 플랫폼(ChatGPT, Cursor, GitHub Copilot, VS Code 포함), 공개 스킬 100만 개, 누적 설치 약 2억 8천만 회이며 모두 Anthropic의 집계입니다. 저장소 쪽 숫자는 별 26.7k, 포크 2.0k, 열린 풀 리퀘스트 55개, 라이선스는 코드 Apache 2.0과 문서 CC-BY-4.0입니다. AAIF가 호스팅하는 프로젝트는 출범 때의 3개에서 10개가 되었습니다. 이미 만들어 둔 스킬이 있다면 손볼 것은 없다는 뜻이고, 나머지 이야기는 폴더 안쪽에 있습니다.
내려받은 pdf 스킬 폴더의 열두 파일
뜯어 볼 대상은 anthropics/skills 저장소의 pdf 폴더입니다. 같은 저장소의 skills 폴더에는 docx·pptx·xlsx·mcp-builder 같은 폴더도 들어 있어서, 실물 스킬이 어떻게 생겼는지 보기에 좋은 표본입니다. 2026-10-27 기준 main 브랜치의 파일을 내려받아 줄 수와 바이트를 직접 쟀습니다. 초록색 SKILL.md만 스킬이 선택되는 순간 읽히고, 나머지는 필요할 때만 열립니다.
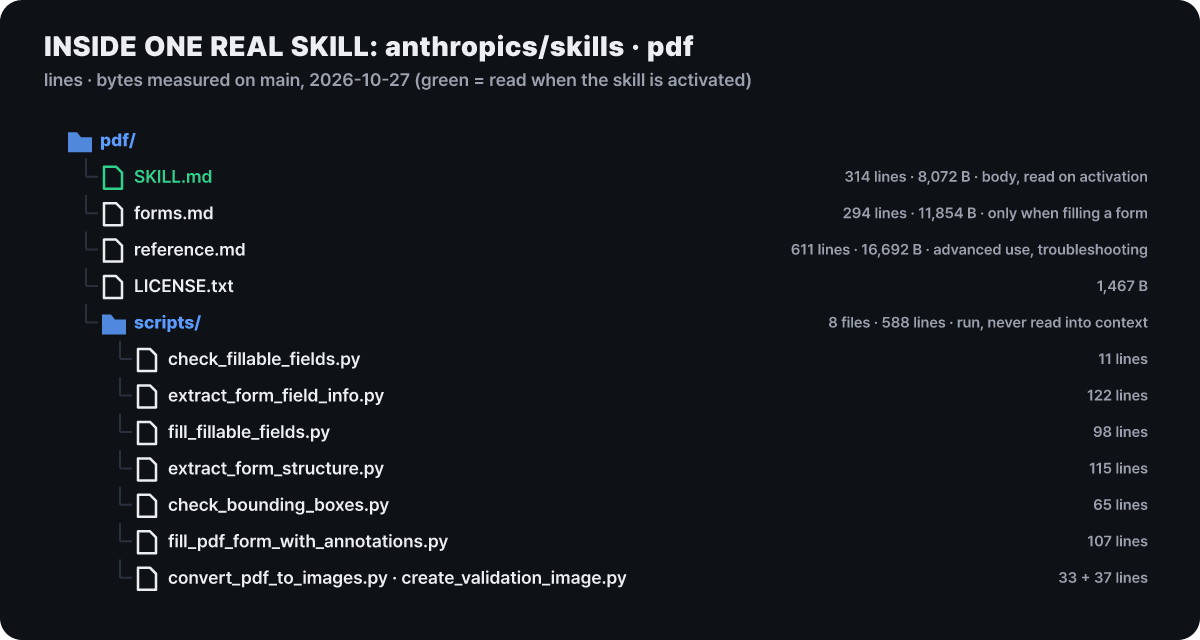 그림 2. pdf 스킬 폴더. SKILL.md 하나에 문서 둘, 라이선스, 스크립트 여덟 개
파일의 역할은 크기로 대략 갈립니다. SKILL.md는 라이브러리별 사용법과 자주 하는 작업이 담긴 본문입니다. forms.md는 양식 채우기만 다루는 절차서, reference.md는 JavaScript 라이브러리와 고급 명령, 문제 해결을 모은 사전입니다. scripts/의 파이썬 파일 여덟 개는 양식 작업의 단계마다 하나씩 맡습니다. 가장 짧은 check_fillable_fields.py는 11줄이고, 가장 긴 extract_form_field_info.py도 122줄입니다.
LICENSE.txt가 있는 이유는 머리말에서 곧 보입니다. 형식이 개방 표준이어도 개별 스킬의 이용 조건은 폴더가 따로 정합니다. 이 폴더의 license 항목은 별도 약관을 가리키는 값이고, 같은 저장소의 다른 스킬이 어떤 조건인지는 폴더마다 열어 봐야 합니다.
머리말에 든 약속 세 줄
SKILL.md는 위쪽에 YAML 머리말을 두고 아래에 마크다운 본문을 씁니다. 에이전트가 시작할 때 읽는 것은 머리말의 name과 description뿐입니다. pdf 스킬의 머리말을 뼈대만 옮기면 이렇습니다.
---
name: pdf
description: (영문 437자) PDF로 하는 열 가지 작업을 나열하고, .pdf 파일이 언급되거나 PDF를 만들라는 요청이면 이 스킬을 쓰라고 끝맺음
license: Proprietary. LICENSE.txt has complete terms
---description은 첫 문장이 “PDF와 관련된 일이면 무엇이든 이 스킬을 쓴다”는 취지이고, 이어서 텍스트·표 추출, 병합, 분할, 회전, 워터마크, 생성, 양식 채우기, 암호화·복호화, 이미지 추출, 스캔본 OCR을 하나씩 꼽습니다. 무엇을 하는지와 언제 쓰는지를 함께 적으라는 사양의 권고를 그대로 따른 모양입니다. 길이는 437자로 한도 1,024자의 절반이 안 됩니다. 시작할 때 모든 스킬의 이 부분만 읽히므로, 스킬 하나가 목록에 차지하는 몫은 이름과 합쳐 50~100토큰 안팎입니다.
사양이 정한 머리말 필드는 여섯 개이고, 이 스킬은 그중 셋만 썼습니다.
| 필드 | 사양의 제한 | pdf 스킬 |
|---|---|---|
name (필수) |
1~64자, 소문자·숫자·하이픈, 하이픈으로 시작·끝 금지, 연속 하이픈 금지, 폴더 이름과 같아야 함 | pdf, 폴더 이름과 일치 |
description (필수) |
1~1,024자, 하는 일과 쓸 상황을 함께 | 437자 |
license |
라이선스 이름 또는 파일 이름 | 별도 약관 파일을 가리킴 |
compatibility |
1~500자, 필요한 환경(패키지·네트워크 등) | 쓰지 않음 |
metadata |
문자열 키-값 묶음, 고유한 키 권장 | 쓰지 않음 |
allowed-tools |
미리 허용할 도구를 공백으로 이은 문자열, 실험적 항목 | 쓰지 않음 |
실물을 보면 compatibility가 필요 없는 스킬이 대부분이라는 사양의 말이 실감 납니다. pdf 스킬은 파이썬 패키지를 쓰지만 환경 요구를 머리말에 적지 않고, 필요한 설치는 해당 예제 옆(예를 들어 OCR 예제의 pip install 안내)에 둡니다. 검증은 느슨한 편이 관례입니다. 구현 가이드는 폴더 이름과 name이 달라도, name이 64자를 넘어도 경고만 남기고 불러오라고 권하고, description이 비었거나 YAML을 읽을 수 없는 스킬만 건너뛰라고 합니다.
314줄 본문이 일부러 하지 않는 일
본문 SKILL.md는 314줄, 8,072바이트입니다. 영문 4바이트를 1토큰으로 어림하면 약 2,000토큰(편집부 계산)이라서 사양이 권하는 5,000토큰·500줄 한도 안에 넉넉히 들어옵니다. 소제목은 개요, 빠른 시작, 파이썬 라이브러리, 명령줄 도구, 자주 하는 작업, 빠른 참조표, 다음 단계 순서입니다. 이 중 파이썬 라이브러리 절이 161줄로 본문의 절반을 차지하는데, pypdf로 병합·분할·회전, pdfplumber로 텍스트·표 추출, reportlab으로 PDF 생성을 코드 예제로 보입니다.
눈에 띄는 것은 빠진 부분입니다. PDF가 어떤 파일 형식인지 설명하는 문단이 없고, 개요 다음에 바로 코드가 나옵니다. 에이전트가 이미 아는 것은 쓰지 말고 모르는 것만 쓰라는 모범 사례를 그대로 실천한 셈입니다. 더 눈에 띄는 것은 양식 채우기가 본문에 세 줄(개요의 안내 한 줄, 빠른 참조표 한 행, 다음 단계 한 줄)로만 나온다는 점입니다. 가장 복잡한 일의 절차는 본문이 아니라 forms.md로 넘겨 두었습니다.
넘기는 방식도 배울 만합니다. 개요의 문장은 “양식을 채워야 한다면 FORMS.md를 읽고 지시를 따르라”처럼 조건과 파일을 함께 적습니다. 막연히 “자세한 내용은 참고 문서에서”라고 쓰면 에이전트가 언제 열어야 할지 알 수 없지만, 조건이 있으면 그 상황이 올 때만 엽니다. 한 가지 어긋남도 있습니다. 본문은 FORMS.md·REFERENCE.md로 가리키는데 내려받은 파일 이름은 소문자 forms.md·reference.md이고, 대문자 이름의 raw 주소는 없는 파일로 나옵니다. 대소문자를 구분하는 파일 시스템에서는 링크 이름과 실제 이름이 어긋날 수 있으니, 내 스킬에서는 본문이 부르는 이름과 파일 이름을 글자 하나까지 맞춰야 합니다.
같은 폴더인데 요청마다 읽는 양이 다르다
요청 네 가지로 이 폴더가 읽히는 양을 계산해 보겠습니다. description은 항상 목록에 있고, 본문은 스킬이 선택되면 읽히고, forms.md와 reference.md는 본문의 안내가 가리키는 상황에서만 열린다고 가정합니다.
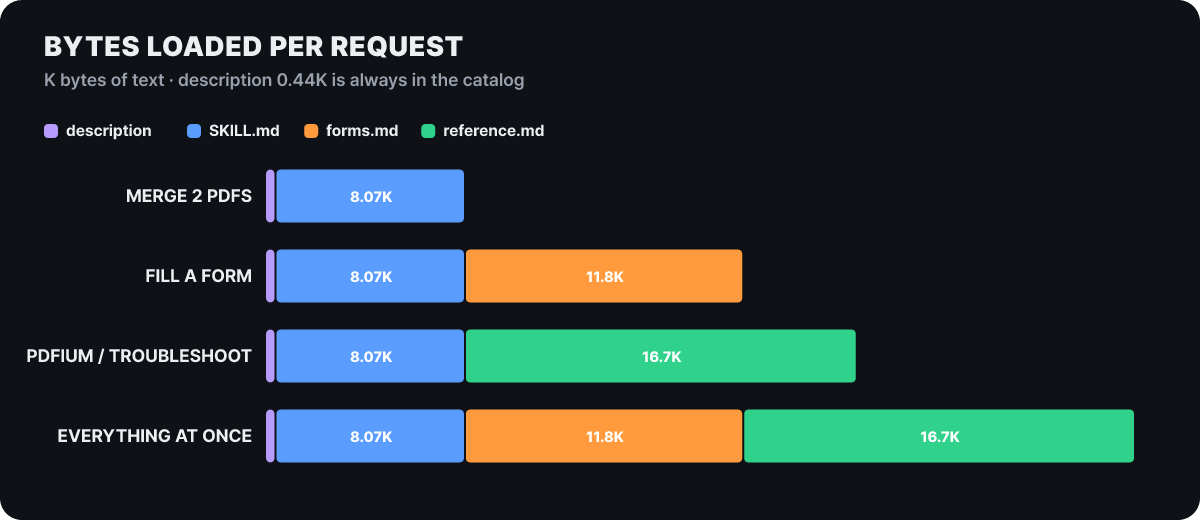 그림 3. 요청별로 읽히는 텍스트의 양(K바이트). 파일별 값은 실측, 합산은 편집부 계산
병합 요청은 8.51K로 끝납니다. 양식 채우기는 20.36K로 2.4배, 고급 렌더링이나 문제 해결은 25.20K로 3.0배이고, 세 파일을 한꺼번에 읽는 경우는 37.06K로 4.4배입니다. 한 파일에 모두 담았다면 모든 요청이 맨 아래 막대의 비용을 냈을 것이고, 폴더로 나눈 덕에 대부분의 요청은 맨 위쪽 길이로 끝납니다. 스크립트는 이 막대에 아예 없습니다. 에이전트는 스크립트를 실행하고 그 출력만 받기 때문입니다.
스킬이 많아져도 같은 원리가 이어집니다. 스킬이 50개 깔려 있다면 시작할 때 읽히는 목록은 스킬당 100토큰으로 어림해 약 5,000토큰이지만, 50개의 본문을 상한(5,000토큰)씩 모두 읽는다면 25만 토큰입니다(편집부 계산). 스킬을 하나 활성화하면 본문이 최대 5,000토큰 더해져 약 10,000토큰이 됩니다. 참조 파일을 한 단계 깊이까지만 두라는 권고는 이 계산을 지키기 위한 장치입니다.
양식 채우기 한 건이 폴더를 지나는 길
가장 긴 경로를 따라가 보겠습니다. 입력 PDF에 채울 수 있는 칸이 이미 있는 경우의 순서이고, forms.md가 정한 대로입니다. 위에서 아래로 시간이 흐르고, 붉은 화살표가 본문에서 절차서로 넘어가는 순간입니다.
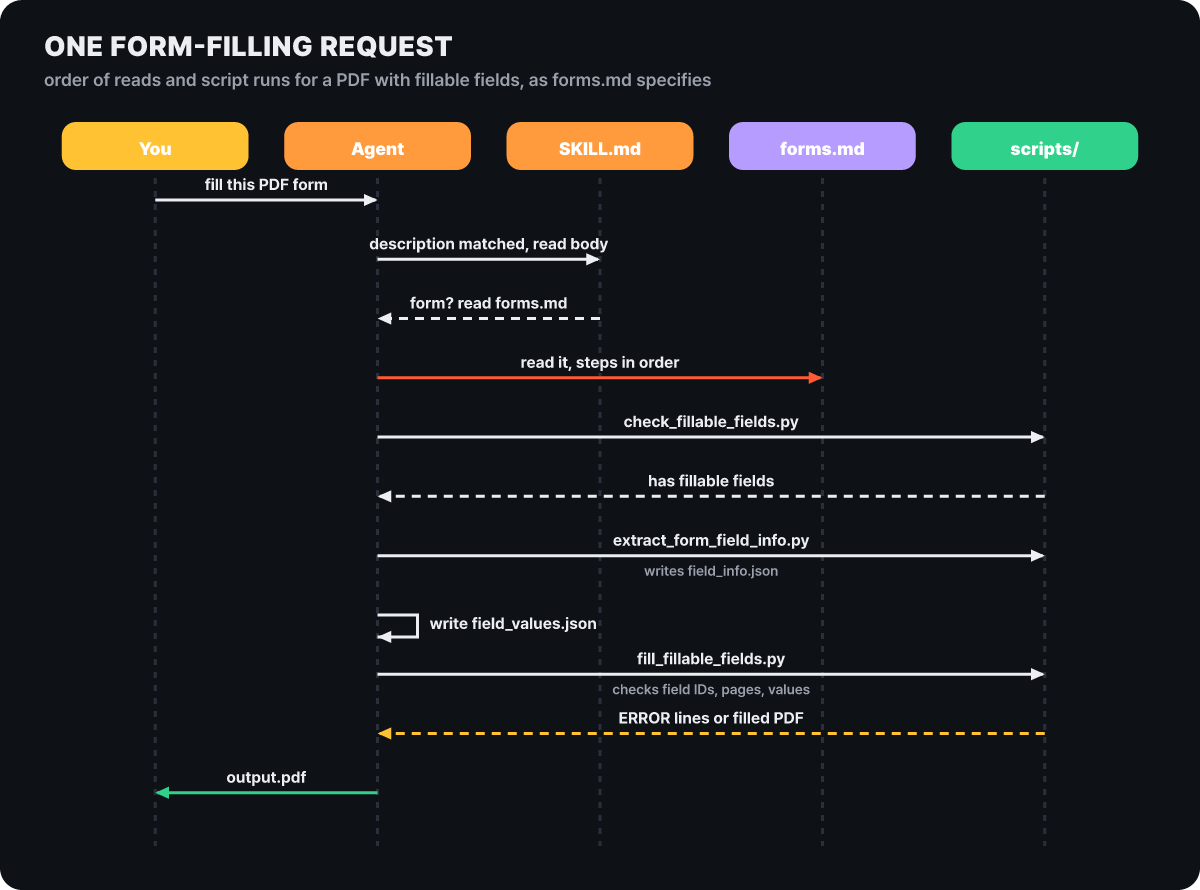 그림 4. 양식 채우기 요청 하나의 읽기와 실행 순서
forms.md는 맨 윗줄에서 순서대로 따라가라고, 코드부터 쓰기 시작하지 말라고 못박습니다. 먼저 check_fillable_fields.py로 PDF에 채울 수 있는 칸이 있는지 보고 갈래를 나눕니다. 칸이 있으면 extract_form_field_info.py가 칸마다 field_id, 쪽 번호, 좌표, 종류(텍스트·체크박스·라디오 묶음·선택지)를 JSON으로 뽑습니다. 에이전트는 convert_pdf_to_images.py가 만든 쪽별 이미지로 각 칸의 용도를 파악하고, field_values.json에 칸마다 넣을 값을 적습니다. 마지막으로 fill_fillable_fields.py를 실행합니다.
이 마지막 스크립트가 핵심입니다. 채우기 전에 에이전트가 쓴 field_values.json을 원본의 칸 목록과 대조해, 존재하지 않는 field_id, 쪽 번호 불일치, 칸 종류에 맞지 않는 값이면 오류 줄을 찍고 종료 코드 1로 끝납니다. 에이전트는 그 오류를 읽고 값을 고쳐 다시 실행합니다. 모범 사례 문서가 말하는 “계획을 만들고, 원본과 대조해 검증하고, 그다음에 실행한다”는 패턴이 실제 폴더에서는 이렇게 생겼습니다.
채울 수 있는 칸이 없는 PDF는 갈래가 더 깁니다. 먼저 extract_form_structure.py로 PDF 안의 글자와 선 위치에서 칸의 좌표를 얻는 방법(문서가 우선으로 권하는 쪽)을 시도합니다. 안 되면 쪽을 이미지로 바꿔 눈으로 좌표를 어림하고 확대해서 보정하는 방법으로 물러납니다. 두 방법을 섞는 경우에는 이미지 좌표를 PDF 좌표로 환산하는 식까지 적혀 있습니다. 좌표가 정해지면 check_bounding_boxes.py가 칸끼리 겹치는지, 글자 크기에 비해 칸이 너무 작은지를 검사하고, 통과해야 fill_pdf_form_with_annotations.py가 글자를 얹습니다. 마지막은 결과를 다시 이미지로 바꿔 위치가 맞는지 눈으로 보는 단계입니다.
스크립트는 읽히지 않고 실행된다
여덟 스크립트를 모두 합치면 588줄, 약 20.6KB입니다. 이 코드가 에이전트의 맥락에 올라간다면 그림 3의 막대에 한 칸이 더 붙었겠지만, 에이전트는 실행만 하고 출력만 받습니다. Anthropic의 엔지니어링 글이 PDF 스킬로 설명한 구조가 이것입니다. 11줄짜리 check_fillable_fields.py는 PDF 전체를 읽는 대신 “채울 수 있는 칸이 있다/없다”는 한 문장만 돌려줍니다. 큰 입력을 작은 답으로 줄이는 일을 코드에 맡기는 셈입니다.
모범 사례 문서는 에이전트가 쓰는 스크립트의 조건을 몇 가지 꼽습니다. 키보드 입력을 기다리는 대화형 질문을 하지 않을 것, 인자가 틀리면 사용법을 알려 줄 것, 데이터는 표준 출력으로 진단은 표준 오류로 낼 것, 같은 명령을 다시 실행해도 안전할 것, 의미 있는 종료 코드를 쓸 것, 출력이 길면 하네스가 10~30K자 안팎에서 잘라 내니 요약을 기본으로 할 것입니다. 이 기준으로 pdf 스킬의 여덟 스크립트를 읽어 보면 이렇습니다.
- 입력을 기다리는
input()호출은 하나도 없습니다. - 여덟 개 중 일곱 개가 인자 개수가 틀리면 사용법을 출력하고 종료 코드 1로 끝납니다. 나머지 하나는 인자만 받는 11줄짜리입니다.
--help옵션을 처리하는 파서(argparse)는 쓰지 않았습니다. 대신 본문과forms.md가 모든 명령을 실행 예와 함께 적어 두어 에이전트가 사용법을 따로 물을 일이 없습니다.
기준은 권고이지 규칙이 아니라는 것을 보여 주는 사례입니다. 사용법을 문서 쪽에 충분히 적어 두면 스크립트 쪽은 짧게 갈 수 있습니다.
받은 폴더를 읽는 네 번의 확인
스크립트가 코드이니 남이 만든 스킬을 설치하는 일은 코드를 내 환경에 들이는 일이고, 본문의 지침도 에이전트를 움직입니다. Anthropic의 엔지니어링 글은 스킬이 취약점을 만들거나 데이터를 밖으로 내보내게 시킬 수 있다고 경고하며, 믿을 만한 출처에서만 설치하라고 합니다. 덜 믿는 스킬은 번들 파일의 코드 의존성·이미지·스크립트까지 읽고, 믿지 못할 외부 네트워크에 연결하라는 지시를 살피라는 조언입니다. 방금 뜯어 본 pdf 스킬에 스킬 스크립트는 실행하지 않고 읽기 전용 명령만 써 본 결과가 아래입니다.
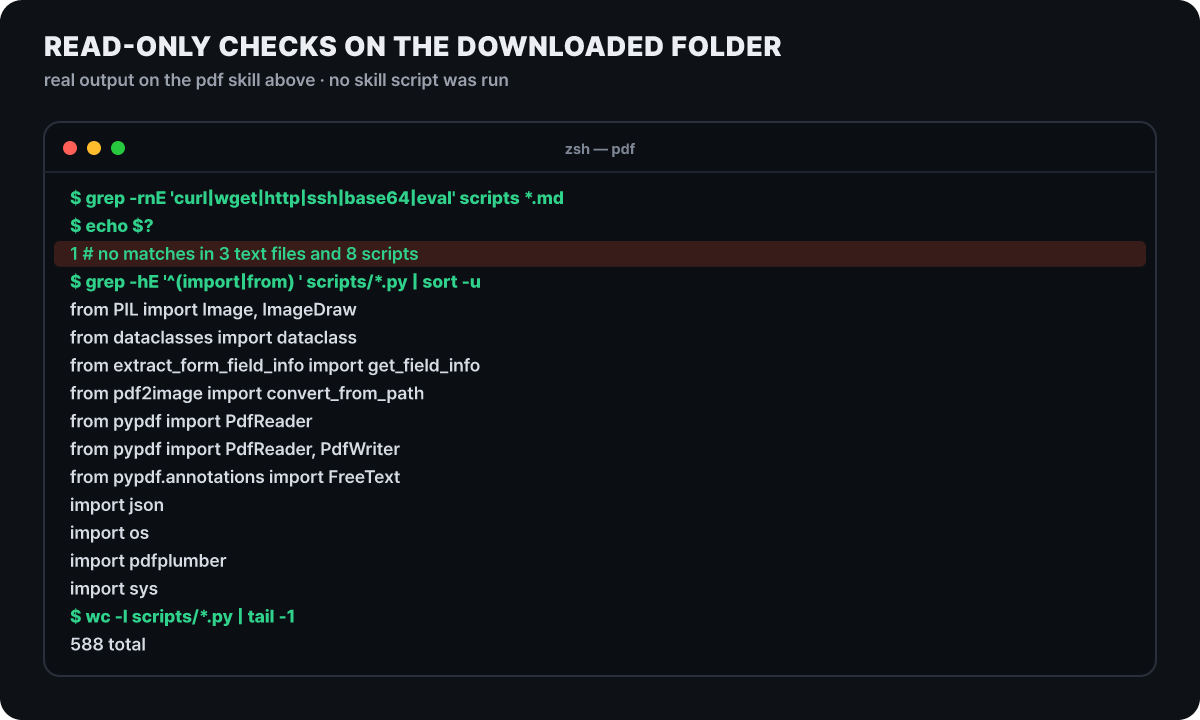 그림 5. 네트워크 관련 단어는 한 건도 없고, 외부 패키지는 PDF·이미지 라이브러리뿐
curl·wget·http·ssh·base64·eval 중 하나라도 있는 줄을 찾는 grep이 스크립트와 마크다운 세 개 어디에서도 아무것도 찾지 못해 종료 코드 1이 나왔습니다. 가져오는 모듈은 pypdf, pdfplumber, pdf2image, PIL과 표준 모듈뿐이고, 파일을 열고 쓰는 경로는 모두 명령 인자로 받은 것입니다. 다만 단어 검색은 훑어보기이지 감사가 아니어서, 본문이 에이전트에게 시키는 일은 눈으로 읽어야 합니다.
- 폴더를 열어
SKILL.md를 읽고, 지침이 설명과 다른 일을 시키지 않는지 본다. scripts/를 단어 검색으로 훑어 네트워크 호출, 인코딩된 문자열, 임의 코드 실행 흔적이 있는지 본다.- 머리말의
allowed-tools가 하는 일에 비해 넓지 않은지 본다. - 잘 모르겠으면 격리된 작업 폴더에서 먼저 실행하고, 출처가 불분명한 스킬은 쓰지 않는다.
가장 위험한 경우는 내가 설치하지 않은 스킬입니다. 처음 보는 저장소를 내려받아 에이전트를 켜면 그 안의 프로젝트 스킬이 에이전트의 맥락에 지침을 넣을 수 있습니다. 사양의 구현 가이드가 프로젝트 스킬을 폴더를 신뢰한다고 확인한 뒤에만 불러오라고 권하는 이유입니다. Claude Code 문서에는 이와 이어지는 항목이 몇 개 더 있습니다. 본문의 ! 명령은 에이전트가 스킬을 보기도 전에 실행되고 기본 2분 제한이 걸리며, 설정의 disableSkillShellExecution을 true로 두면 실행 대신 차단 안내문으로 바뀝니다. 특정 스킬을 막으려면 Skill(deploy *) 같은 거부 규칙을 쓰고, 스킬 전체를 끄려면 Skill 도구 자체를 거부 목록에 넣습니다. allowed-tools는 신뢰하지 않는 폴더에서도 적용되므로 저장소에 든 스킬은 실행 전에 이 항목부터 확인해야 합니다.
도구마다 같은 폴더를 다르게 부르는 곳
사양은 폴더의 안쪽만 정하고 어디에서 찾고 어떻게 부르는지는 도구에 맡깁니다. 구현 가이드는 <프로젝트>/.agents/skills/와 ~/.agents/skills/를 도구 사이의 공용 관례로 소개하고, 일부 구현은 .claude/skills/도 함께 훑는다고 적습니다. Claude Code는 자기 폴더를 쓰고, 같은 이름이 여러 곳에 있을 때의 순서는 아래와 같습니다.
- 엔터프라이즈관리 설정 폴더에 조직이 배포. 같은 이름이면 가장 먼저 이김
- 개인
~/.claude/skills/. 내 모든 프로젝트에서 쓰임 - 프로젝트
.claude/skills/. 저장소에 커밋해 팀과 공유. 하위 폴더의.claude/skills/는 그 폴더 안에서 연 세션에만 적용 - 플러그인
/플러그인:스킬이름으로 분리되어 충돌 없음
사양의 구현 가이드는 프로젝트 스킬이 사용자 수준 스킬을 덮는 것을 기존 구현의 공통 관례로 소개하는데, Claude Code 문서의 순서는 개인이 프로젝트보다 앞입니다. 어느 쪽이 맞는지보다 같은 이름을 쓰면 도구에 따라 다른 쪽이 실행될 수 있다는 점이 요지입니다. 이름을 pdf처럼 흔하게 짓는 것은 그래서 위험합니다.
또 하나, Claude Code는 사양에 없는 머리말 필드를 더합니다. 모르는 필드는 오류 없이 무시하지만, 그 필드를 단 채로 다른 곳에 올리면 막힙니다.
| 필드 | 하는 일 |
|---|---|
disable-model-invocation: true |
에이전트가 스스로 부르지 못하고 /이름으로만 부름. 설명도 맥락에서 빠짐 |
user-invocable: false |
/ 메뉴에서 숨기고 에이전트만 부름 |
context: fork |
대화 기록이 없는 하위 에이전트에서 실행 |
paths |
파일 경로 패턴으로 자동 활성화 범위를 제한 |
when_to_use |
설명에 덧붙는 추가 조건. 설명과 합쳐 1,536자에서 잘림 |
model / effort |
호출된 동안의 모델과 추론 강도 |
claude.ai 업로드와 Skills API는 name, description, license, compatibility, metadata, allowed-tools 여섯 개만 받고, 다른 키가 있으면 업로드에서 오류가 납니다. 여러 도구에 올릴 스킬이라면 표준 여섯 필드만 남기는 편이 안전합니다. 한 번 불러온 스킬은 대화에 계속 남아 맥락을 차지하는데, 대화가 요약될 때 Claude Code는 스킬마다 가장 최근 호출분의 앞 5,000토큰을 다시 붙이고 전체를 25,000토큰 안에서 맞춥니다. 스킬을 많이 부른 긴 세션에서는 오래된 스킬이 빠질 수 있다는 뜻입니다.
내 폴더로 옮겨 적을 때 가져갈 것
pdf 스킬에서 가져갈 습관과 모범 사례 문서가 더하는 패턴을 합치면 다섯 가지입니다. 첫째, 본문은 에이전트가 모르는 것만 씁니다. 문장마다 “이 말이 없으면 틀릴까”를 묻고 아니면 지웁니다. 둘째, 도구를 고르게 하지 말고 기본값 하나를 정합니다. pdf 스킬의 빠른 참조표가 “텍스트 추출은 pdfplumber, 병합은 pypdf”처럼 작업마다 한 도구를 지정한 방식입니다. 셋째, 에이전트가 자주 틀리는 환경의 사실을 함정 목록으로 모읍니다. 넷째, 단계에 의존이 있으면 체크리스트를, 틀리기 쉬우면 검증 스크립트를 붙입니다. 다섯째, 일괄·파괴적 작업은 계획 파일을 만들고 원본과 대조한 뒤에 실행합니다.
아래는 이 원칙을 작은 스킬에 옮긴 편집부의 예시입니다.
---
name: release-notes
description: 커밋 목록으로 릴리스 노트 초안을 만든다. 릴리스 노트, 변경 내역 정리를 요청받았을 때 사용.
---

1. 지난 태그 이후의 커밋 제목을 읽는다.
2. 기능·수정·내부 변경으로 나눠 한 줄씩 정리한다.
3. 초안만 출력하고 파일은 쓰지 않는다.

## 함정
- 병합 커밋과 "wip" 커밋은 목록에서 뺀다.
- 내부 리팩터링은 사용자에게 보이는 변경이 아니므로 "내부" 항목으로만 묶는다.
스킬이 정말 도움이 되는지는 같은 요청을 스킬이 있을 때와 없을 때(또는 이전 버전)로 나눠 통과율·시간·토큰을 재야 알 수 있습니다. 문서의 예시값은 통과율 83% 대 33%, 시간 45초 대 32초, 토큰 3,800 대 2,100입니다. 13초와 약 1,700토큰을 더 쓰고 통과율이 50%포인트 오르니 쓸 만하다는 판단입니다. 스킬 없이도 늘 통과하는 검사 항목은 스킬의 가치를 알려 주지 못하니 빼라는 조언도 있습니다.
막히기 쉬운 곳 네 가지
스킬을 만들었는데 에이전트가 자동으로 부르지 않는다
사양 문서가 권하는 점검은 이렇습니다. 부르는 질의 810개와 부르지 않는 질의 810개, 약 20개를 만들어 각각 3번씩 실행하고(60번 호출) 스킬이 불렸는지 도구 기록으로 셉니다. 부르는 질의는 호출 비율 0.5 이상, 부르지 않는 질의는 0.5 미만이면 통과이고, 설명을 고칠 때 쓰는 훈련 질의와 일반화를 확인하는 검증 질의를 6 대 4로 나눕니다. 부르지 않는 질의는 단어가 겹치지만 필요한 일은 다른 근접 사례(CSV 스킬이라면 “엑셀 예산표의 수식을 고쳐 줘”)가 값집니다. 한 단계짜리 단순 요청은 설명이 완벽히 맞아도 기본 도구로 처리될 수 있습니다. 급하면 Claude Code에서 /이름으로 직접 부르는데, 이름이 메시지 맨 앞에 있어야 바로 실행됩니다.
폴더 이름과 name이 다르면 스킬이 아예 안 되나
사양은 둘이 같아야 한다고 정하고, 검증 도구 skills-ref validate가 이름 규칙을 점검합니다. 하지만 구현 가이드는 이름 불일치나 64자 초과는 경고만 남기고 불러오라고 권합니다. 도구마다 다를 수 있으니 검증 도구를 통과시키는 쪽이 가장 확실합니다.
description에 콜론이 들어가면 문제가 되나
따옴표 없는 값에 콜론(:)을 넣으면 엄밀히는 잘못된 YAML입니다. 다른 도구에서는 우연히 읽히는 경우가 있어서 구현 가이드는 따옴표로 감싸 다시 읽어 보는 방어 처리를 권합니다. 쓰는 쪽은 설명 전체를 따옴표나 블록 문자열로 감싸 두면 어느 도구에서나 안전합니다.
기증 이후에 스킬을 만들거나 올리려면 AAIF에 가입해야 하나
필요하지 않습니다. 형식은 그대로 쓸 수 있고, 사양 변경에 대한 의견은 GitHub 저장소 토론과 프로젝트 Discord로 낼 수 있습니다.
같은 재단에 들어온 세 프로젝트와 이어서 읽을 곳
10월 22일 AAIF는 스킬 말고 세 프로젝트를 더 받았습니다. OpenAI가 기증한 Open Responses는 Responses API를 바탕으로 한 오픈 사양으로, 공통 스키마·일관된 스트리밍 이벤트·확장 가능한 도구 규격을 두어 요청과 출력을 한 번 쓰면 여러 모델 업체에서 돌게 하는 것이 목표입니다. Hugging Face가 기증한 OpenEnv는 강화학습 환경을 만들고 나누는 프레임워크이자 커뮤니티 허브이고, 환경을 컨테이너 서비스로 띄워 에이전트 인터페이스·MCP·Gym 훈련 규약으로 노출합니다. Alibaba가 기증한 OpenSandbox는 AI 응용을 위한 범용 샌드박스 플랫폼으로 여러 언어의 SDK, 통합 API, Docker·Kubernetes 런타임을 제공하고, 코딩·GUI 에이전트, 평가, 코드 실행, 강화학습 훈련을 용도로 듭니다. 앞서 있던 여섯 프로젝트는 MCP, goose, AGENTS.md, Agent2Agent, Agent Router, agentgateway입니다.
스킬 쪽으로 이어서 읽을 만한 곳은 다섯 군데입니다.
- 사양 전문: agentskills.io/specification
- 만드는 쪽: skill-creation/best-practices와 같은 사이트의 설명 최적화·평가 문서
- 도구를 만드는 쪽: client-implementation/adding-skills-support
- 기증 발표: Anthropic 발표문과 Linux Foundation 보도자료
- 뜯어 볼 실물: anthropics/skills의 pdf·docx·pptx·xlsx 폴더



