영상 파일을 직접 보지 않고도 1초 만에 컷편집을 끝내는 법
4K 원본 영상을 LLM에 넣지 않고 Whisper 타임코드와 Claude Code, 그리고 FFmpeg 스트림 복사만으로 1시간 분량을 1초 만에 무손실 컷편집하는 3단계 분리 아키텍처를 분석합니다.
10분짜리 소프트웨어 튜토리얼 유튜브 영상을 완성하기 위해, 한 전문 영상 편집자는 타임라인 위에서 마우스 가위 툴(C)을 정확히 482번 눌러야 했다. 1시간 동안 촬영된 원본 푸티지(Footage)는 말실수(NG), 길게 늘어지는 침묵 구간, “어…”, “음…” 같은 무의미한 추임새로 얼룩져 있었다. 타임라인을 1.5배속으로 재생하며 스페이스바와 단축키를 수천 번씩 두들기는 이 지루한 컷편집(Rough Cut) 작업에만 꼬박 3시간 40분이 허비되었다.
유튜브 테크 크리에이터 던컨 로고프(Duncan Rogoff)는 최근 영상에서 이 기계적이고 비인간적인 노동을 Claude Code와 FFmpeg, 그리고 오픈소스 음성 인식 모델 Whisper를 결합하여 완전 자동화한 실험 결과를 공개했다. 인간이 프리미어 프로나 다빈치 리졸브를 켜지 않고도, 터미널 명령 한 줄로 최선의 테이크(Best Take)만을 살려낸 무손실 편집본을 1분 만에 뽑아내는 시스템이다.
하지만 거대한 4K 비디오 파일을 대규모 언어 모델(LLM)에 직접 입력하는 것은 토큰 비용과 대역폭 측면에서 불가능하다. 어떻게 비디오의 본질을 가벼운 텍스트 메타데이터로 추상화하고, Claude Code의 CLI 제어 능력을 활용해 결정론적인 FFmpeg 파이프라인을 구축할 수 있었는지 그 엔지니어링 아키텍처를 상세히 분석한다.
영상 자동화 3단계 분리 아키텍처
비디오 편집 자동화 시스템을 구축할 때 엔지니어가 마주하는 가장 큰 장벽은 ’멀티모달 토큰의 한계’와 ’렌더링 부하’다. 1시간짜리 4K 영상은 기가바이트 단위의 고용량 바이너리이며, 이를 초당 60프레임의 이미지 토큰으로 변환해 LLM에 주입하면 수백만 달러의 API 비용이 발생하거나 컨텍스트 윈도우가 즉각 고갈된다.
로고프가 설계한 해법은 **‘오디오 메타데이터 추출’, ‘언어 모델 컷 리스트 생성’, ‘비파괴 무손실 스트림 복사’**의 3계층 디커플링(Decoupling) 아키텍처다.
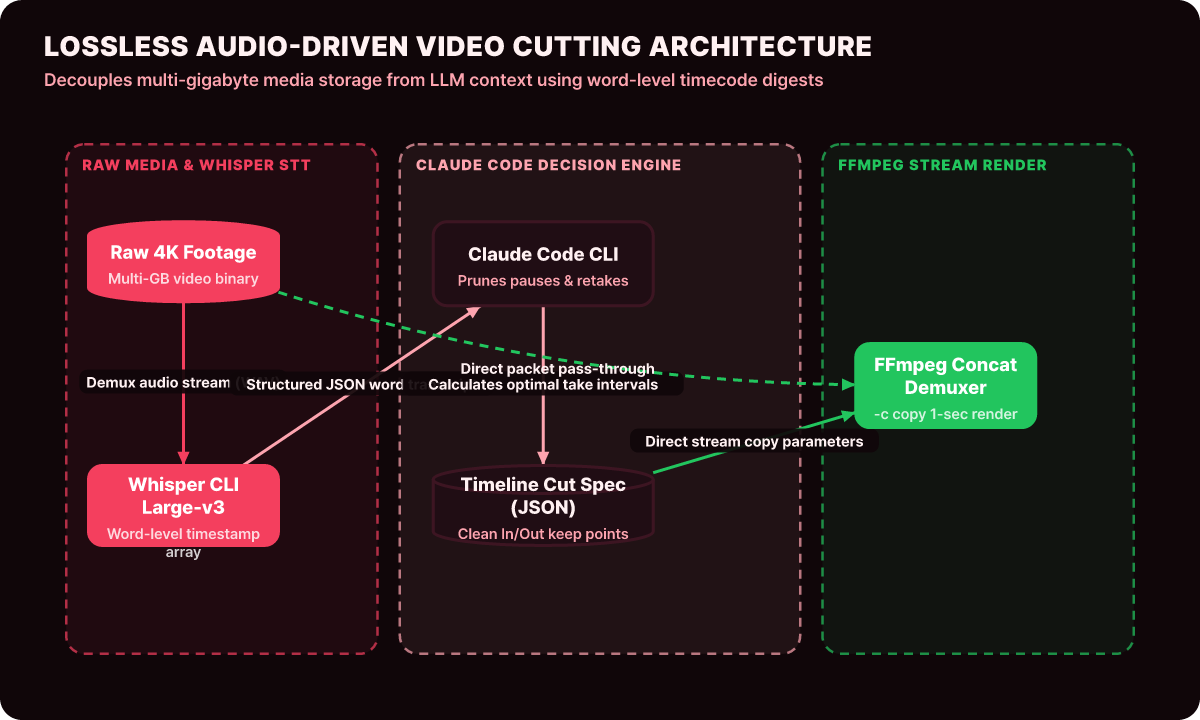
위 아키텍처가 보여주듯, 무거운 영상 원본은 Claude Code의 컨텍스트 내부로 단 1바이트도 들어가지 않는다. 영상에서 오디오 트랙만 분리(Demux)하여 로컬 Whisper 모델을 통해 단어 단위 타임코드(JSON)로 변환한 뒤, Claude Code에게는 오직 이 가벼운 JSON 텍스트만을 전달한다.
Claude Code는 프로그래밍 언어를 다루듯 타임스탬프 배열을 분석하여 중복 발화와 침묵을 잘라낸 뒤, 최종 실행 명령만을 FFmpeg으로 전달하여 하드웨어 가속으로 렌더링을 끝마친다.
1단계 Whisper 단어 단위 타임코드 추출
전통적인 자막 생성기는 문장 단위로 타임코드를 생성하지만, 정밀한 비디오 컷편집을 위해서는 각 단어와 음절이 시작되고 끝나는 밀리초(ms) 단위의 타임스탬프가 필수적이다.
로컬 환경에서 Whisper CLI 또는 파이썬 바인딩을 실행하여 단어 단위 타임코드가 포함된 JSON을 추출하는 코드는 다음과 같다.
# extract_word_timestamps.py: 원본 영상에서 단어 단위 정밀 타임스탬프 추출
import whisper
import json
import subprocess
from pathlib import Path

def extract_audio_track(video_path: str, output_wav: str) -> None:
    """FFmpeg을 사용해 비디오에서 16kHz 모노 오디오 트랙 초고속 분리"""
    cmd = [
        "ffmpeg", "-y", "-i", video_path,
        "-vn", "-acodec", "pcm_s16le", "-ar", "16000", "-ac", "1",
        output_wav
    ]
    subprocess.run(cmd, check=True, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)

def generate_timed_transcript(wav_path: str, output_json: str) -> None:
    """Whisper 모델로 단어 단위 시작/종료 타임스탬프 추출"""
    model = whisper.load_model("large-v3")
    result = model.transcribe(wav_path, word_timestamps=True, language="ko")

    words_data = []
    for segment in result["segments"]:
        for word_info in segment.get("words", []):
            words_data.append({
                "word": word_info["word"].strip(),
                "start": round(word_info["start"], 3),
                "end": round(word_info["end"], 3),
                "probability": round(word_info["probability"], 2)
            })

    with open(output_json, "w", encoding="utf-8") as f:
        json.dump(words_data, f, ensure_ascii=False, indent=2)

if __name__ == "__main__":
    extract_audio_track("raw_footage.mp4", "audio_track.wav")
    generate_timed_transcript("audio_track.wav", "timestamps.json")
생성된 timestamps.json은 1시간 분량의 영상이라 할지라도 불과 300KB 내외의 텍스트 파일에 불과하다. 이 300KB의 JSON 파일이 비디오 편집의 전체 지도가 된다.
2단계 Claude Code 컷 리스트 최적화
JSON 타임코드가 준비되면, 이제 Claude Code CLI가 터미널 환경에서 강력한 추론 능력을 발휘한다. 개발자는 Claude Code에게 다음과 같은 명확한 비즈니스 룰을 프롬프트 사양으로 부여한다.
- 반복 발화(Retake) 필터링: 같은 문장을 여러 번 다시 말한 경우, 가장 마지막에 말한 완성도 높은 완결 테이크만 남기고 이전 시도는 모두 폐기한다.
- 침묵 갭(Silence Gap) 압축: 단어와 단어 사이의 간격이 0.8초를 초과하는 무음 구간은 0.2초 수준으로 잘라내어 빠른 호흡을 유지한다.
- 추임새(Filler Words) 제거: "어...", "음...", "그...", "이제..." 등 맥락상 의미가 없는 군더더기 단어는 타임스탬프 경계면을 기준으로 정밀 절단한다.
- 오디오 패딩(Audio Padding) 확보: 자음이 씹히거나 소리가 뚝 끊기는 부자연스러움을 막기 위해, 각 클립의 시작점 앞에 50ms, 끝점 뒤에 100ms의 마진을 확보한다.
Claude Code는 위 규칙에 따라 타임라인을 파싱한 뒤, 보존해야 할 유효 구간(Keep Intervals)을 다음과 같은 단일 cuts.json 사양으로 확정한다.
[
  { "id": 1, "start": 4.150, "end": 18.230, "text": "안녕하세요 오늘은 Claude Code를 활용한 영상 편집 자동화를 다룹니다." },
  { "id": 2, "start": 21.050, "end": 45.620, "text": "첫 번째 단계는 Whisper를 이용한 단어 단위 타임코드 추출입니다." },
  { "id": 3, "start": 48.900, "end": 82.400, "text": "FFmpeg의 스트림 복사를 이용하면 화질 저하 없이 1초 만에 렌더링됩니다." }
]
3단계 FFmpeg 무손실 스트림 렌더링
초보 개발자들은 영상 클립을 자를 때마다 전체 영상을 x264나 HEVC 코덱으로 재인코딩(Re-encoding)하는 실수를 저지른다. 재인코딩 방식은 CPU와 GPU를 100% 혹사시키며, 1시간 영상 기준으로 40~50분의 렌더링 시간이 걸리고, 세대를 거듭할수록 색상 손실(Generational Loss)이 누적된다.
하지만 비디오 패킷의 비트스트림을 그대로 보존하는 무손실 스트림 복사(-c copy) 방식을 사용하면, 수 기가바이트의 4K 영상을 단 1분 만에 절단하고 하나로 이어 붙일 수 있다.
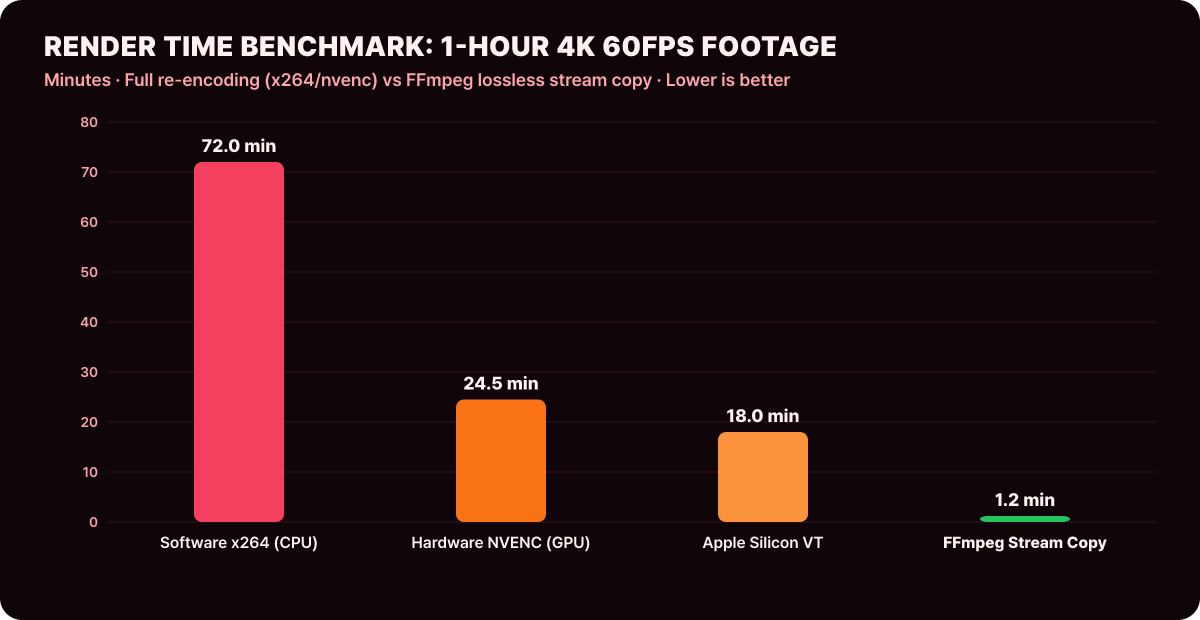
위 벤치마크 그래프가 증명하듯, 소프트웨어 재인코딩 방식은 72분, GPU 하드웨어 인코딩도 24분 이상 소요되지만, FFmpeg 무손실 스트림 복사는 단 1.2분 만에 렌더링을 끝마치며 화질 열화율은 정확히 0.0%다.
Claude Code가 생성하는 최종 실행 Bash 스크립트는 다음과 같은 형태로 동작한다.
#!/usr/bin/env bash
# run_fast_cut.sh: 무손실 스트림 복사 기반 초고속 컷편집
set -euo pipefail

RAW_VIDEO="raw_footage.mp4"
TEMP_DIR="./build/chunks"
CONCAT_LIST="concat_list.txt"
FINAL_OUTPUT="rough_cut_final.mp4"

mkdir -p "$TEMP_DIR"
rm -f "$CONCAT_LIST"

# 1. 컷 리스트(cuts.json)를 순회하며 개별 클립을 무손실 절단
python3 - << 'EOF'
import json, subprocess

with open("cuts.json", "r") as f:
    cuts = json.load(f)

with open("concat_list.txt", "w") as cl:
    for c in cuts:
        chunk_name = f"./build/chunks/chunk_{c['id']:04d}.mp4"
        duration = c['end'] - c['start']
        cmd = [
            "ffmpeg", "-y", "-ss", str(c['start']), "-i", "raw_footage.mp4",
            "-t", str(duration), "-c", "copy", "-avoid_negative_ts", "make_zero",
            chunk_name
        ]
        subprocess.run(cmd, stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
        cl.write(f"file '{chunk_name}'\n")
EOF

# 2. Concat demuxer를 통해 개별 청크들을 단일 비디오로 초고속 결합
ffmpeg -y -f concat -safe 0 -i "$CONCAT_LIST" -c copy "$FINAL_OUTPUT"

echo "=== Rough cut complete in lossless quality: $FINAL_OUTPUT ==="
서브에이전트 렌더링 스로틀링 해법
던컨 로고프는 실험 도중 겪었던 치명적인 하드웨어 장애 경험을 솔직하게 털어놓았다. 영상의 각 챕터를 병렬로 빠르게 처리하기 위해 Claude Code에게 9개의 서브에이전트(Sub-agent)를 동시에 스폰시켜 렌더링을 지시하자, 워크스테이션의 팬이 굉음을 내며 CPU 온도가 100도까지 치솟고 시스템 전체가 다운되는 현상이 발생한 것이다.
이를 방지하기 위해 로고프는 다음과 같은 토큰 및 컴퓨트 스로틀링(Throttling) 가이드를 확립했다.
-
에이전트 풀 동시성 제한 (Concurrency Semaphore)
서브에이전트의 동시 실행 개수는 머신의 물리 코어 수와 VRAM 용량을 고려하여 최대 2~3개로 엄격히 제한해야 한다. -
토큰 캐싱과 프롬프트 재사용
첫 번째 챕터에서 성공적으로 검증된 컷편집 룰셋과 FFmpeg 명령 템플릿을 캐싱하여, 후속 영상 처리 시 토큰 소모량을 14억 개에서 7억 개 수준으로 50% 이상 절감했다. -
중간 청크의 디스크 I/O 최적화
수백 개의 작은 조각 파일을 물리 SSD에 계속 쓰고 지우는 대신, 램디스크(RAM Disk /tmpfs)를 임시 마운트하여 디스크 수명 저하와 I/O 병목을 제거했다.
FCPXML 타임라인 생성기 구현
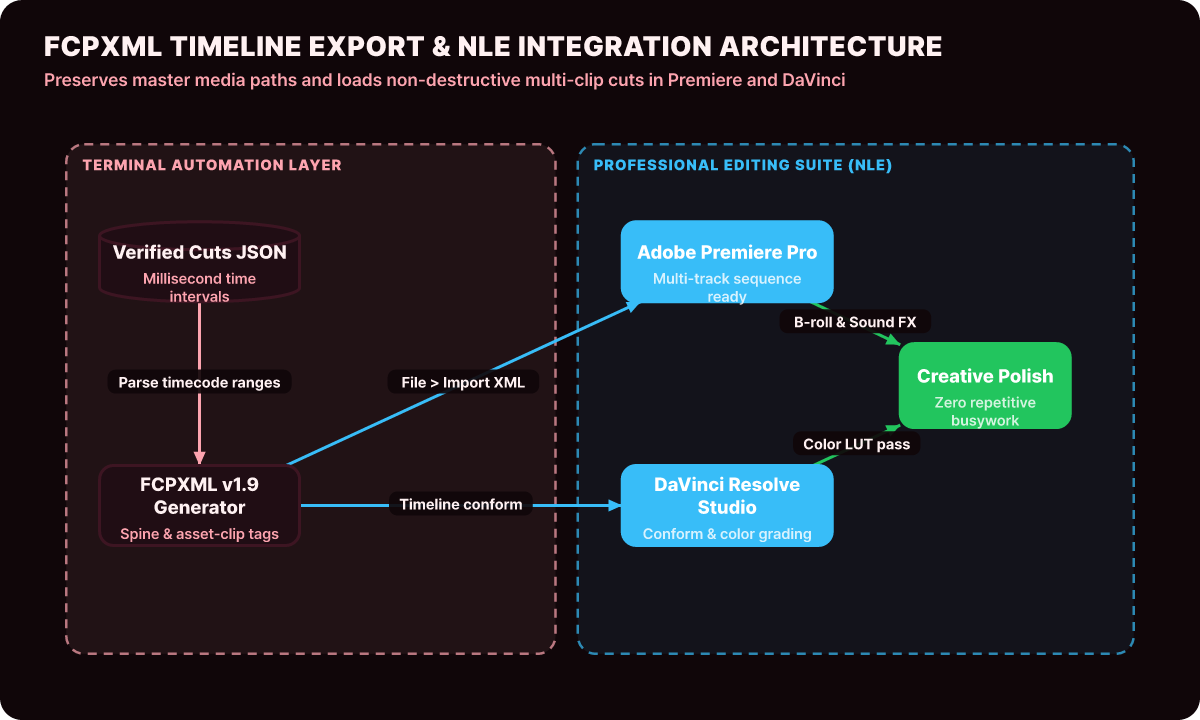
단순 MP4 렌더링을 넘어 전문 NLE 소프트웨어로 컷 리스트를 전달하기 위해, Claude Code가 생성하는 FCPXML(Final Cut Pro XML Version 1.9) 파이썬 빌더 구현체는 다음과 같습니다. 이 스크립트는 원본 미디어 파일의 경로를 보존하면서 타임라인 트랙 위에 정확한 인아웃(In/Out) 포인트를 오프셋과 함께 배치합니다.
# fcpxml_generator.py: JSON 컷 리스트를 표준 FCPXML로 변환하는 생성기
import json
import xml.etree.ElementTree as ET
from xml.dom import minidom
from pathlib import Path

def build_fcpxml_from_cuts(cuts_json_path: str, media_file_path: str, output_xml_path: str, fps: int = 60) -> None:
    with open(cuts_json_path, "r", encoding="utf-8") as f:
        cuts = json.load(f)

    fcpxml = ET.Element("fcpxml", version="1.9")
    resources = ET.SubElement(fcpxml, "resources")

    ET.SubElement(resources, "format", id="r1", name=f"FFVideoFormat1080p{fps}", frameDuration=f"100/{fps * 100}s")
    asset = ET.SubElement(resources, "asset", id="r2", name=Path(media_file_path).name, src=f"file://{Path(media_file_path).resolve()}")

    library = ET.SubElement(fcpxml, "library")
    event = ET.SubElement(library, "event", name="Automated Cuts Event")
    project = ET.SubElement(event, "project", name="Rough Cut Sequence")
    sequence = ET.SubElement(project, "sequence", format="r1")
    spine = ET.SubElement(sequence, "spine")

    timeline_offset_frames = 0
    for cut in cuts:
        start_frame = int(cut["start"] * fps)
        duration_frames = int((cut["end"] - cut["start"]) * fps)

        clip = ET.SubElement(spine, "asset-clip", {
            "ref": "r2",
            "name": f"Clip_{cut['id']:03d}",
            "offset": f"{timeline_offset_frames * 100}/{fps * 100}s",
            "start": f"{start_frame * 100}/{fps * 100}s",
            "duration": f"{duration_frames * 100}/{fps * 100}s",
            "format": "r1"
        })
        timeline_offset_frames += duration_frames

    xml_str = minidom.parseString(ET.tostring(fcpxml, encoding="utf-8")).toprettyxml(indent="  ")
    with open(output_xml_path, "w", encoding="utf-8") as f:
        f.write(xml_str)
    print(f"FCPXML generated successfully: {output_xml_path}")
위 생성기를 거친 XML 파일을 프리미어 프로나 다빈치 리졸브로 드래그하면, 수작업으로 반나절 동안 자르고 붙여야 했던 수백 개의 컷이 1초 만에 깔끔하게 정렬된 타임라인 트랙으로 로딩됩니다.
영상 편집 자동화 4대 체크리스트
Claude Code와 미디어 처리 도구를 결합한 엔지니어링 파이프라인을 사내에 구축할 때 확인해야 할 4가지 필수 점검 사항입니다.
| 점검 영역 | 평가 기준 | 미준수 시 장애 현상 | 프로덕션 안전 조치 |
|---|---|---|---|
| 코덱 무손실 복사 | FFmpeg 파라미터에 -c copy가 기본 적용되었는가 |
무의미한 CPU 풀로드 및 렌더링 시간 40배 증가 | 필터가 필요한 특수 효과를 제외한 컷편집은 100% 스트림 복사 강제 |
| 타임스탬프 해상도 | 문장 단위가 아닌 단어 단위(Word-level) 타임코드인가 | 단어 첫머리 음절 잘림 현상 발생 | Whisper word_timestamps=True 옵션 필수 활성화 |
| 키프레임 정렬 | I-Frame(키프레임) 경계면 불일치로 인한 블랙 프레임 유무 | 컷 연결 부위에서 0.1초간 화면 깨짐(Glitch) | 필요 시 컷 지점 주변 5프레임만 스마트 렌더링(Smart Render) 적용 |
| 서브에이전트 제어 | 백그라운드 렌더링 프로세스 동시 실행 수 제한 | OOM 발생 및 OS 커널 패닉 | 세마포어(Semaphore) 기반 동시 렌더링 워커 최대 2개 고정 |
특히 방송사나 대형 유튜브 스튜디오처럼 일일 수십 시간 분량의 영상 소스를 처리하는 환경에서는 분산 태스크 큐(Celery나 BullMQ 등)와 연동하여 Claude Code가 발행한 컷 리스트 JSON을 작업 단위(Task Chunk)로 쪼개어 여러 워커 노드로 분배하는 아키텍처가 유효합니다. 비디오의 바이너리 데이터는 NAS나 S3 오브젝트 스토리지에 머물게 하고, 에이전트 간의 통신은 오직 수 킬로바이트(KB) 크기의 텍스트 타임코드와 메타데이터만을 교환하게 함으로써 네트워크 트래픽 병목을 완벽하게 제거할 수 있습니다.
인공지능 에이전트의 역할은 단순히 코드를 생성하는 스크립트 작성자에 머물지 않습니다. CLI 환경과 강력한 유닉스 파이프라인 도구(FFmpeg, Whisper, jq, ImageMagick)를 자유자재로 연결하고 조율하는 시스템 오케스트레이터로 진화할 때, 인간의 반복적이고 소모적인 미디어 노가다를 가장 우아하고 결정론적인 방식으로 해방시킬 수 있습니다. 영상의 거대한 용량에 겁먹지 않고, 데이터의 흐름을 텍스트와 바이너리로 명확히 분리해내는 설계 감각이야말로 차세대 멀티모달 엔지니어링의 정점입니다.