Claude Code도 부하로 쓰는 Orkas, 막힌 일은 어떻게 풀리나
복습이 21번 연속 0건이었다는 소스 주석에서 출발해, Orkas에 일을 맡기는 다섯 장면을 공식 소스의 상수와 편집부 실험으로 따라간다.
21번. Orkas의 복습 스케줄러 소스에 적힌 주석에 나오는 숫자다. 예전 설계는 오랫동안 활동이 없던 에이전트도 일주일에 한 번은 억지로 복습 대상으로 올렸는데, 그 결과 작성자가 진단한 컴퓨터에서 주기가 21번 연속으로 돌았는데도 복습은 한 건도 일어나지 않았다고 한다. 복습 칸 다섯 개를 전부 일할 게 없는 같은 에이전트들이 차지하고 있었기 때문이다. 이 주석은 버그 보고서가 아니라 지금 코드가 왜 이런 모양인지 설명하는 근거로 남아 있다.
Orkas는 사령관(Commander) 한 명이 에이전트 여럿을 부리는 MIT 라이선스 데스크톱 앱이다. 앱 안의 전문 에이전트 16종과, 사용자의 컴퓨터에 이미 설치된 Claude Code, Codex, OpenCode, OpenClaw, Hermes-Agent를 한 대화창에서 섞어 쓴다. 기능 목록은 README에 잘 정리되어 있으니 이 글은 목록을 옮기지 않는다. 대신 이 앱에 일을 맡겼을 때 무언가 막히거나, 넘치거나, 꺼지거나, 바뀌는 순간 다섯 장면을 세우고, 그 순간마다 소스의 어떤 장치가 움직이는지 따라간다.
장면 속 요청과 파일 이름, 시각은 모두 편집부가 만든 예시다. 장면이 기대는 사실은 저장소 README, 소스 코드의 상수와 주석, 릴리스 노트에서 읽은 것이고, 2026-11-02 기준 main 브랜치다. 직접 돌려 본 것은 편집부 실험으로 따로 표시했다. 실험은 앱을 설치하거나 모델을 호출한 것이 아니다. 소스 파일 하나(context-budget.ts)는 원본을 그대로 실행했고, 나머지는 소스의 짧은 계산 함수를 옮겨 적어 돌렸다. 소스를 읽은 해석은 편집부 해설로 구분한다.
리팩터링을 넘기면 먼저 갈리는 세 길
금요일 오후 네 시, 청구 모듈의 날짜 처리가 낡았다는 것을 알게 된 개발자가 Orkas 대화창에 이렇게 쓴다고 하자. “결제 모듈 날짜 처리를 새 라이브러리로 바꾸고, 바뀐 부분은 따로 검토해서 알려 줘.” 한 문장이지만 사령관 입장에서는 성격이 다른 일이 섞여 있다. 코드를 고치는 일, 고친 결과를 눈으로 검증하는 일, 그 사이에 필요한 잔일(어디서 옛 함수를 부르는지 찾는 일)이다.
README는 사령관이 일을 넘기는 방식을 도구 세 개로 설명한다. 도구 이름이 곧 구분이다.
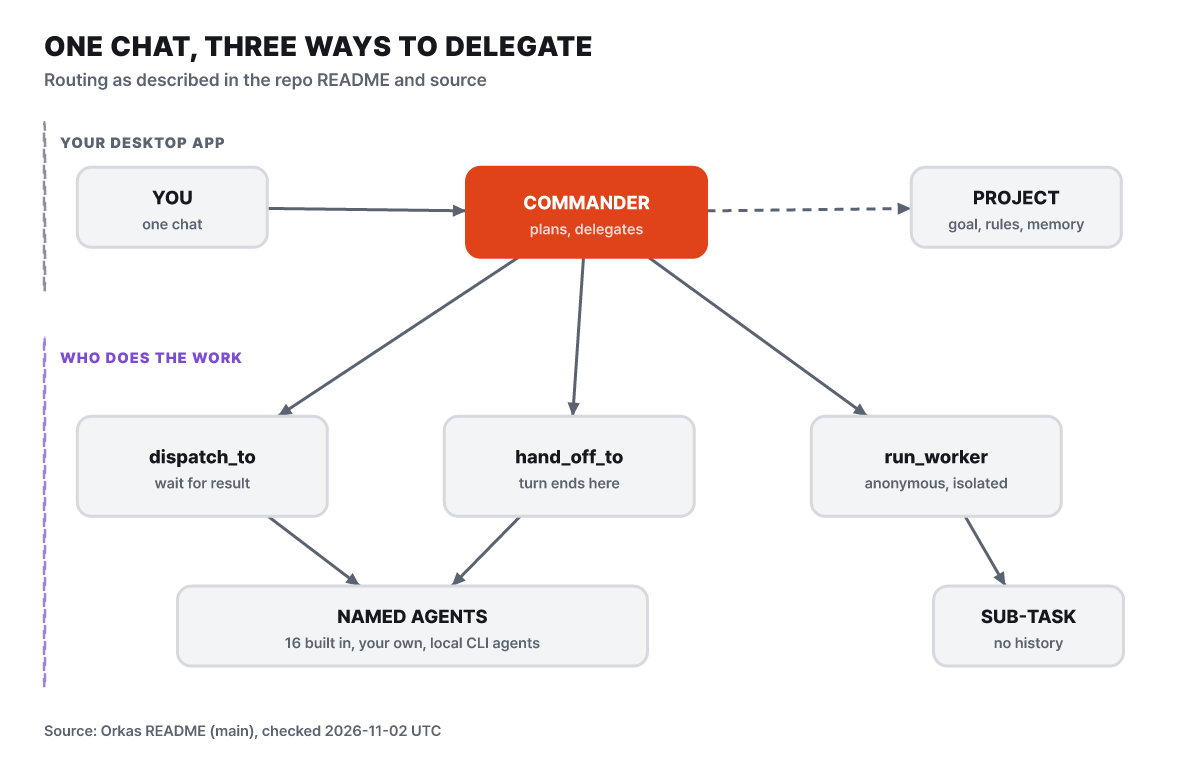
그림 1. 위임 구조(README 기준 편집부 도식). 이름 있는 에이전트에게 맡기는 길이 둘, 이름 없는 작업자에게 맡기는 길이 하나다.
그림에서 먼저 볼 곳은 가운데 길과 왼쪽 길의 차이다. 왼쪽 dispatch_to는 이름 있는 에이전트를 돌려 결과를 사령관이 돌려받는다. 결과를 기다리며 이어서 일할 수도 있고, 비동기로 던져 놓고 끝났다는 알림을 받을 수도 있다. 가운데 hand_off_to는 남은 일을 통째로 넘기고 사령관의 차례를 끝낸다. 답은 받은 에이전트가 직접 사용자에게 하고, 선택적으로 이어받기를 걸어 두면 사령관이 나중에 더 큰 작업으로 돌아온다. 오른쪽 run_worker는 이름도 대화 기록도 스킬도 없는 익명 하위 작업을 띄워 결과만 비공개로 받는다.
그러므로 위 요청은 이렇게 갈린다. 날짜 처리를 바꾸는 일은 코딩 에이전트에게 dispatch_to로 맡긴다. 바꾼 결과를 사령관이 받아 쥐고 있어야 다음 단계를 이을 수 있기 때문이다. 옛 함수를 부르는 곳을 찾는 열두 개 폴더의 점검은 대화 맥락이 필요 없는 잔일이라 run_worker로 흩뿌린다. 마지막 검토는 Codex 같은 다른 에이전트에게 hand_off_to를 쓴다. 검토자가 사용자에게 직접 말하게 하면 사령관이 검토 결과를 다시 요약하며 흐리는 일이 없다. 어느 에이전트에게 무엇을 맡길지는 사령관의 판단이고, 이 분배가 의도와 다르게 나오면 사용자는 대화창에서 고쳐 지시한다.
dispatch_to를 쓰는 때
- 결과를 받아 다음 단계에 써야 한다
- 사령관이 끝까지 조율한다
- 비동기로 돌려 두고 다른 일을 이어 간다
hand_off_to를 쓰는 때
- 남은 일의 책임을 받은 쪽이 진다
- 답이 받은 에이전트의 목소리로 나온다
- 필요하면 이어받기로 사령관이 복귀한다
여기서 Claude Code가 어떤 자리에 있는지 짚어 둔다. README는 Orkas가 이미 설치된 CLI 에이전트를 로컬 세션으로 실행한다고 설명한다. 사령관과 내장 에이전트는 앱의 모델 설정 하나를 함께 쓰지만, 외부 CLI 에이전트는 자기 모델 설정을 그대로 유지한다. 같은 대화에서 모델이 둘 이상 오가는 구조라는 뜻이다. 릴리스 노트에서 이 줄기를 다듬은 흔적을 찾을 수 있다. v2026.8.29는 Codex와 로컬 CLI 실행이 끊긴 스트림, 시작 방식의 차이, 병렬 도구 결과에 더 잘 버티도록 고쳤다고 적었고, v2026.9.11은 로컬 코딩 에이전트의 질문에 답하거나 대기 중인 입력을 취소해도 주변 작업이 사라지지 않게 했다. v2026.10.17은 끊긴 CLI 프로세스의 기록과 걸린 시간을 남기되 이미 끝난 작업을 다시 재생하지 않도록 했다. 외부 CLI를 팀원으로 쓰는 일이 처음부터 매끄러웠다기보다 릴리스마다 모서리를 깎아 온 부분이라는 것이 릴리스 노트의 모양이다.
열 칸 중 네 칸, 같은 파일은 한 줄로
이제 그 열두 개 폴더 점검이 동시에 나가면 어떤 일이 생기는지 보자. README는 세션 잠금과 동시성 제한이 병렬 작업을 묶는다고만 쓰고, 값은 소스에 있다. src/main/util/locks.ts와 group_chat/bus.ts의 해당 주석, actor-budgets.ts를 열어 정리하면 이 장면에 관련된 장치는 다섯 개다.
| 장치 | 값 | 이 장면에서의 역할 |
|---|---|---|
| 대화별 잠금 | 대화 하나에 1 | 앞 차례가 끝나기 전에 같은 대화에서 새 차례가 시작되지 않는다 |
| 전역 슬롯 | 10 | 앱 전체의 동시 모델 호출 상한 |
| 익명 작업자 슬롯 | 4 | run_worker 중첩 호출의 동시 상한 |
| 대화당 이름 있는 에이전트 실행 | 4 | 한 대화에서 동시에 도는 에이전트 작업 상한 |
| 파일 편집 잠금 | 경로 하나에 1 | 같은 파일을 두 작업이 동시에 고쳐 한쪽 수정이 사라지는 것을 막는다 |
열두 건의 run_worker가 한꺼번에 요청되면 익명 작업자 슬롯 4개가 먼저 차고 나머지 8건은 줄을 선다. 한 건이 모델 호출 한 차례에 해당하는 시간이 걸린다고 두면 4건씩 세 번, 모두 세 파로 끝난다(편집부 계산: 12 ÷ 4 = 3). 줄 선 작업이 다른 곳을 막지 않게 하려는 설계가 아래에서 보인다. 슬롯 4는 환경 변수 ORKAS_MAX_DISPATCH_CONCURRENCY로, 대화당 이름 있는 에이전트 작업의 상한 4는 ORKAS_MAX_CONVERSATION_TASKS로 바꾼다. 소스로 띄우는 사람이 쓰는 손잡이다.
# 소스로 실행할 때 익명 작업자의 동시 상한을 2로 낮추는 예(편집부가 쓴 예시)
ORKAS_MAX_DISPATCH_CONCURRENCY=2 ./run.sh
익명 작업자 슬롯이 전역 슬롯 10과 따로 있는 이유가 소스 주석에 그대로 적혀 있다. 사령관 아래에서 중첩으로 도는 실행은 전역 슬롯을 일부러 건너뛴다. 부모 차례가 이미 슬롯을 쥔 채 자식이 같은 슬롯을 기다리면 둘 다 영원히 기다리는 교착이 생기기 때문이다. 대신 중첩 실행에는 자체 상한이 필요하고, 한 건이 모델 호출 한 차례를 통째로 쓰므로 전역 값보다 낮게 4로 잡았다. 주석은 이 슬롯을 잡는 쪽이 사령관뿐이라서 재진입이 없고 교착도 없다고 덧붙인다. 작업자와 에이전트는 위임 도구를 받지 않는다. 사령관에서 한 단계 내려가는 구조이지 위임의 사슬이 아니라는 뜻이다. 이름 있는 에이전트의 실행도 같은 이야기를 한다. bus.ts 주석에 따르면 대화당 4개 상한은 사령관의 차례를 세지 않고(사령관은 행위자당 직렬이라 한 번에 하나다), 한 대화가 붐벼도 다른 대화의 슬롯을 먹지 않으며, 대기열에서 실행을 시작할지 말지는 정해진 규칙으로 결정하고 모델이 판단에 끼지 않는다.
편집부가 이 숫자들에서 읽은 것은 하나다. 10이라는 수는 열 에이전트가 동시에 일한다는 뜻이 아니다. 전역 슬롯은 앱이 거는 모델 호출을 세는 값이고, 익명 작업자와 이름 있는 에이전트 실행은 각자의 문이 따로 있다. 외부 CLI 에이전트가 자기 프로세스에서 쓰는 모델 호출은 이 슬롯과 무관하게 돈다는 것이 README의 구조 설명에서 읽힌다. 그래서 열두 건을 흩뿌려도 동시에 열두 줄이 달리는 일은 없고, 빨라지는 폭은 최대 4배다.
같은 파일을 두 곳에서 고치는 문제는 파일 편집 잠금이 맡는다. 소스 주석을 풀면 이렇다. 병렬 작업자는 서로 다른 실행이지만 한 프로세스와 한 파일 시스템을 쓴다. edit_file 도구는 파일의 상태를 확인하고, 읽고, 쓰는 세 단계를 거치는데, 같은 파일에 두 실행이 이 세 단계를 엇갈리게 밟으면 한쪽의 수정이 사라진다. 그래서 절대 경로를 열쇠로 잠금 하나를 두고 신선도 확인과 쓰기를 한 덩어리로 만들었다. 다른 파일끼리는 서로 기다리지 않는다. 이 잠금 장부도 사연이 있다. 주석에 따르면 예전에는 세션 번호와, 쓰기가 일어난 모든 경로마다 만들어진 잠금이 지도에서 사라지지 않고 영원히 늘어났다. 지금은 잠금을 쥔 쪽과 기다리는 쪽의 수를 세어, 0이 되고 풀려 있을 때만 장부에서 지운다. 기다리는 쪽이 있는데 지우면 다음 호출자가 새 잠금을 받아 배타성이 깨지기 때문에 세는 방식을 택했다고 한다. 릴리스 노트에도 v2026.8.25에 파일 변경본이 모델 라운드를 건너 살아 있게 하는 수정과 편집 신선도 복구 안내를 맞춘 수정이 올라와 있다.
편집부 해설. 주석이 말하는 범위는 Orkas 자신의 edit_file 도구다. Claude Code가 자기 도구로 고치는 파일은 이 잠금 밖의 일이라는 것이 소스 문구의 자연스러운 읽기다. 그래서 같은 파일을 외부 CLI 에이전트 둘에게 동시에 맡기는 지시는 처음부터 피하는 편이 안전하다. 금요일 오후의 리팩터링이라면 폴더를 나눠 맡기는 정도로 충분하다.
월요일 9시의 리서치와 닫힌 노트북
두 번째 장면은 반복되는 일이다. 같은 개발자가 매주 월요일 아침에 경쟁 제품 네 개의 릴리스 노트 변화를 보고서로 받고 싶어 한다고 하자. 이 요청은 한 번 묻고 끝나는 대화가 아니라서, Orkas는 프로젝트와 자동화라는 개념을 쓴다. README의 설명대로 프로젝트는 목표와 규칙, 기억, 파일을 담는 단위여서 새 대화가 항상 그 내용에서 출발한다. 프로젝트마다 사람과 에이전트가 함께 쓰는 할 일 목록이 있고, 자동 진행을 켜면 팀이 다음 할 일을 스스로 집어 들어 끝난 결과를 검토용으로 가져온다. 자동화는 작업을 매시간, 매일, 매주, 매월 반복한다.
보고서를 만드는 에이전트는 내장 DeepResearcher다. README의 표는 이 에이전트를 출처가 확인된 근거, 표시된 모순, 감사할 수 있는 보고서를 내는 쪽으로 소개한다. 프로젝트의 규칙에 “가격표 변화는 표로, 출처 링크는 문장마다”를 적어 두면 월요일마다 이 규칙에서 시작한다. 이전 보고서를 참고하게 하고 싶을 때는 기억이 세 칸으로 나뉜다는 점이 쓸모 있다. 사용자의 선호와 프로젝트 사실은 지속 노트에, 사용자가 넣은 문서는 라이브러리에, 지난 대화는 chat_history 도구 검색에 있다. 라이브러리는 문서를 조각으로 나눠 로컬 SQLite 벡터 인덱스에 담고, 임베딩 모델도 기기에서 돌며(소스 첫 실행에서 약 95MB를 내려받는다), library 도구가 파일 목록, 관련 조각 검색, 원문 읽기를 한다. FAQ는 이 라이브러리에서 나온 답에 출처 조각으로 돌아가는 인용이 붙는다고 설명한다. 보고서가 지난주 파일을 근거로 삼을 때 인용을 눌러 원문을 확인할 수 있다는 이야기다.
결과를 보내는 방법이 커넥터다. Gmail, 구글 캘린더·시트·드라이브, Notion, Slack, Shopify, Stripe 같은 서비스에 붙고, README에 따르면 기본값은 보내기, 게시, 삭제 앞에서 사용자에게 묻는 것이다. v2026.9.11 릴리스 노트는 이 연결에 안내형 설정과 작업 범위로 한정한 권한이 더해졌다고 적는다. 월요일 보고서를 Slack에 올리는 단계는 승인을 기다리는 단계로 남는다. 사람 눈을 한 번 거친다는 점에서 월요일 아침 아홉 시에 아무도 없는 상태로 메시지가 나가는 일은 없다. 이 사실이 다음 질문과 이어진다. 아홉 시에 아무도 없다면, 컴퓨터는 켜져 있나.
README의 FAQ는 이 질문에 단호하다. Orkas는 사용자 컴퓨터에서 도는 앱이라서 컴퓨터가 깨어 있고 앱이 실행 중이어야 자동 진행과 자동화가 돈다. v1.9부터는 놓친 자동화 가운데 가장 최근 한 건을 컴퓨터가 깨어나거나 앱이 시작될 때 12시간 이내이면 따라잡아 실행한다.
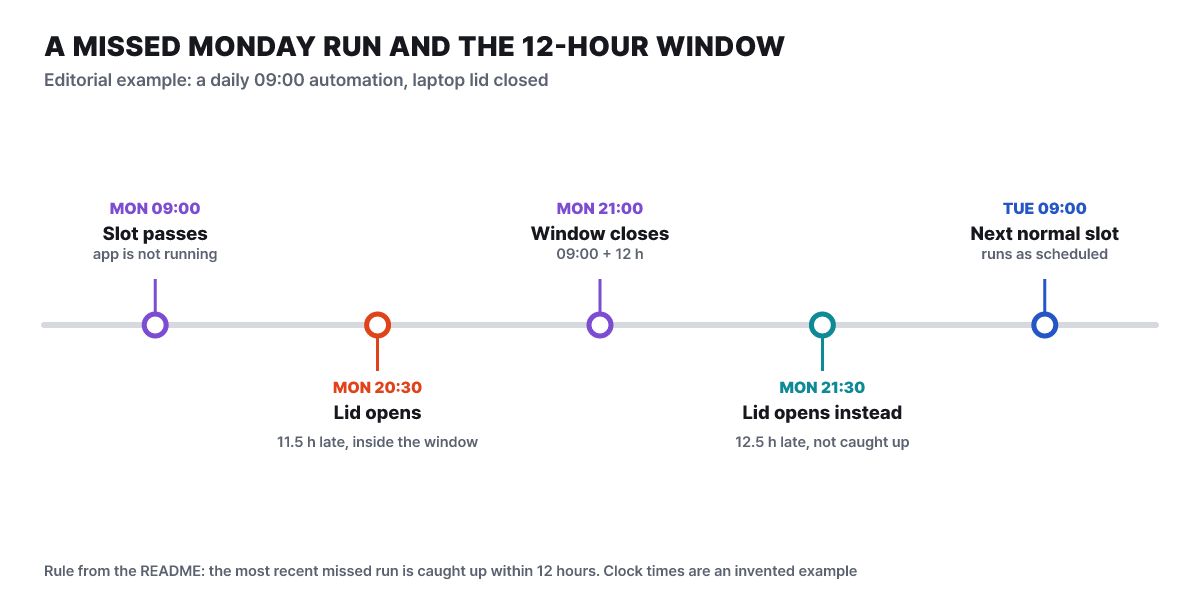
그림 2. 편집부가 만든 예시 시각으로 그린 12시간 창. 매일 09:00 자동화가 있고 노트북 뚜껑이 닫혀 있었다고 가정했다.
이 시간표에서 볼 것은 빨간 점과 청록 점의 차이다. 월요일 20시 30분에 뚜껑을 열면 놓친 슬롯으로부터 11시간 30분이 지났을 뿐이라 따라잡기가 일어나고, 21시 30분에 열면 12시간 30분이라 이번 실행은 건너뛰고 화요일 아홉 시 정규 슬롯을 기다린다. 편집부 해설: README의 문장을 ‘놓친 슬롯으로부터 12시간 이내’로 읽은 것이고, 앱이 놓친 시점을 어떤 시계로 재는지는 문서에 더 적혀 있지 않다. 이 읽기가 맞다면 실무적 결론이 두 가지다. 매일 도는 일은 하루 걸러도 큰 손실이 없지만, 매주 월요일 한 번만 도는 보고서는 월요일에 12시간 안에 앱이 켜지지 않으면 그 주 보고서가 통째로 건너뛰어진다. 또 따라잡기는 가장 최근 한 건뿐이다. 사흘 연휴 동안 꺼 두었다면 사흘치가 한꺼번에 쏟아지지 않고, 가장 마지막 슬롯만 조건이 맞을 때 실행된다.
앱을 열었을 때 무엇을 보게 되는지도 릴리스 노트에서 읽힌다. v2026.10.17의 핵심 변경은 끝내지 않은 할 일과 읽지 않은 작업 결과를 모아 보는 사령관 홈이고, v2026.10.27은 저장된 자동화와 연결된 할 일을 카드에서 바로 여는 개선을 올렸다. 월요일 아침 출근해서 노트북을 열었다면 첫 화면이 지난 주말에 쌓인 결과의 입구라는 이야기다. 컴퓨터를 켜 두기 어려운 상황이라면 자동화 시각을 퇴근 직전이나 출근 직후로 두어 12시간 창에 자주 걸리게 하는 정도가 이 구조 안에서 쓸 수 있는 선택이다. 이 정도가 앱이 문서로 약속한 범위다.
도구 호출 500번째 라운드의 컨텍스트
세 번째 장면은 일이 길어지는 경우다. 내장 ProductDeveloper(README의 표에서 저장소를 읽고 구현, 버그 수정, 리팩터링, 검토를 하는 에이전트)에게 이백 개 파일에 걸친 설정 형식 이전을 맡겼다고 하자. 에이전트는 파일을 읽고, 고치고, 테스트 명령을 돌리는 도구 호출을 몇백 번 반복한다. 호출마다 결과가 대화 기록에 쌓이므로 어느 순간 모델의 입력 한도에 닿는다. 외부 CLI가 아니라 Orkas 자체 실행기가 돌리는 에이전트라서, 이 한도를 다루는 코드가 소스에 있다.
우선 라운드 수 자체에 상한이 있다. actor-budgets.ts에 따르면 사령관과 이름 있는 에이전트는 한 차례에 도구 호출 라운드를 500번까지 돌 수 있다(익명 작업자는 스키마 기본값을 따른다). 주기적인 체크포인트, 하드 상한, 반복 호출 보호, 유휴 감시자가 긴 작업을 묶는다고 파일 머리 주석이 적는다. 500이라는 상한 안쪽에서는 runner.ts의 넛지, 곧 모델에게 상황을 점검하라고 건네는 신호가 세 가지 조건으로 나온다. 편집부가 코드의 짧은 함수를 옮겨 계산해 보면 이렇다. 편집부 실험.
- 라운드가 100, 200, 300, 400번째가 되면 마무리를 점검하라는 신호가 나온다. 100은
TOOL_LOOP_CHECKPOINT_INTERVAL이고, 500에 닿으면 신호가 아니라 상한이 대신한다. - 한 번의 실행이 8분 이상 지나고 도구 호출이 8번 이상이면 시간 기준의 신호가 나온다.
- 컨텍스트 압축이 2번 이상 일어났고 호출이 상한의 75%인 375번째에 닿았다면, 또는 압축에 2분 이상 걸린 채 호출이 8번을 넘었다면 ‘압축 뒤 맴돌기’ 신호가 나온다. 374번째는 아니고 375번째부터다. 압축이 1번뿐이면 450번째여도 이 신호는 나오지 않는다.
소스 주석은 세 번째 신호가 중단이 아니라는 것을 분명히 한다. 정당하게 긴 실행에서는 무엇이 끝났고 무엇이 남았는지 확인하고 수렴하라는 한마디일 뿐 에이전트를 멈추지 않는다. 압축을 거치면서 앞서 한 일을 잊고 같은 작업을 되풀이하는 증상, 곧 압축 뒤 맴돌기를 알아채려는 장치다.
그 압축은 어떻게 일어나나. README는 이를 두 단어로 설명한다. 완료된 대화는 제한된 최근 기록 창을, 긴 활성 작업은 체크포인트를 쓴다. 코드로 내려가면 층이 몇 겹 있다.
- 지난 대화최근 5차례까지만 원문으로 싣고, 크기는 3만 토큰과 차례 시작 시 여유 입력 공간의 20% 중 작은 쪽
- 진행 중 작업앞쪽 과정을 요약해 접는 체크포인트. 한 번에 요약기에 넘기는 입력은 최대 15만 토큰
- 도구 결과 하나컨텍스트에 그대로 들어올 수 있는 크기 1만 토큰, 스킬 문서는 통째로 읽도록 2만 5천 토큰까지
- 성장 여유다음 점검 전까지 자랄 몫으로 창 여유의 6분의 1을 비워 둠
이 층들 가운데 이 장면에서 중요한 것은 구조화된 작업 기록이다. README는 파일 읽기, 파일 변경, 명령 실행에 별도의 구조화된 기록이 있어 컨텍스트가 압축되어도 살아남는다고 적는다. workspace-state.ts의 상수가 그 크기를 보여 준다. 관찰 기록은 최대 256건, 파일 스냅샷은 하나당 최대 512,000자(전체 800만 자), 압축된 뒤에도 최대 2,048개 경로와 16개 차례의 변경, 256건의 읽기 기록을 지킨다. 모델 입력으로 올리는 요약에는 파일 20개와 명령 6개까지만 담는다. 이백 개 파일을 바꾸는 작업에서 ‘어느 파일을 어디까지 바꿨는지’를 요약 문장의 기억에만 맡기지 않는다는 뜻이다. 요약이 놓친 사실은 기록으로 다시 확인하면 된다.
압축 자체가 실패하면 어떻게 되는지도 소스 주석에 길게 적혀 있다. 연속 3번 실패하면 LLM 기반 압축 시도를 멈춘다(MAX_CONSECUTIVE_COMPACTION_FAILURES). 성공한 압축에는 횟수 상한을 두지 않았다. 주석의 설명이 흥미롭다. 실행당 압축 횟수 상한은 이미 두 번 있었고 두 번 다 같은 방식으로 실패했다고 한다. 상한에 닿는 순간부터 컨텍스트는 늘기만 하고, 결과를 넣을 수 있는 인라인 공간이 0으로 줄어들며, 에이전트는 자기가 볼 수 없는 결과를 내는 도구를 계속 부르다 요청이 넘치는 순간에야 오류를 만난다. 첫 번째 상한을 3에서 도구 예산에 비례하는 값으로 올렸을 때도 벽을 옮겼을 뿐이었다. 그래서 지금은 낭비를 직접 막는 장치, 곧 같은 상태를 두 번 압축하지 않는 지문 검사와 요약이 컨텍스트를 실제로 비워야 한다는 조건을 둔다. 압축 호출 하나에도 시간 예산이 있다. 첫 응답을 60초 안에 주지 않으면 다른 후보 모델로 갈아타고, 응답이 시작된 뒤에는 60초 이상 침묵하면 안 되며, 한 번의 압축 단계가 쓸 수 있는 벽시계 시간은 10분이다.
README가 한 줄로 적은 ‘이름 있는 에이전트 작업은 개별로 추적하고 취소할 수 있으며, 대기열에 들어갔다고 완료된 결과로 보지 않는다’도 이 장면의 마지막 장치다. 이백 개 파일의 작업이 반쯤 진행되다 멈춰도 ‘끝났다’는 거짓 표시가 남지 않고 개별 작업만 취소하면 된다는 뜻이다.
200K 창에서 접히는 지점을 계산해 보면
이 층들의 숫자는 창의 크기에 따라 달라진다. context-budget.ts는 부수 효과가 없는 순수 산술 파일이라서, 편집부는 이 파일을 원본 그대로 가져다 실행해 보았다. 편집부 실험. 입력은 모델의 사용 가능 입력 200,000토큰으로 했고, 프롬프트와 도구 정의가 차지하는 고정 오버헤드 12,000토큰과 상주 상태 3,000토큰은 가정이다(실제 값은 앱이 실행 중에 측정한다).
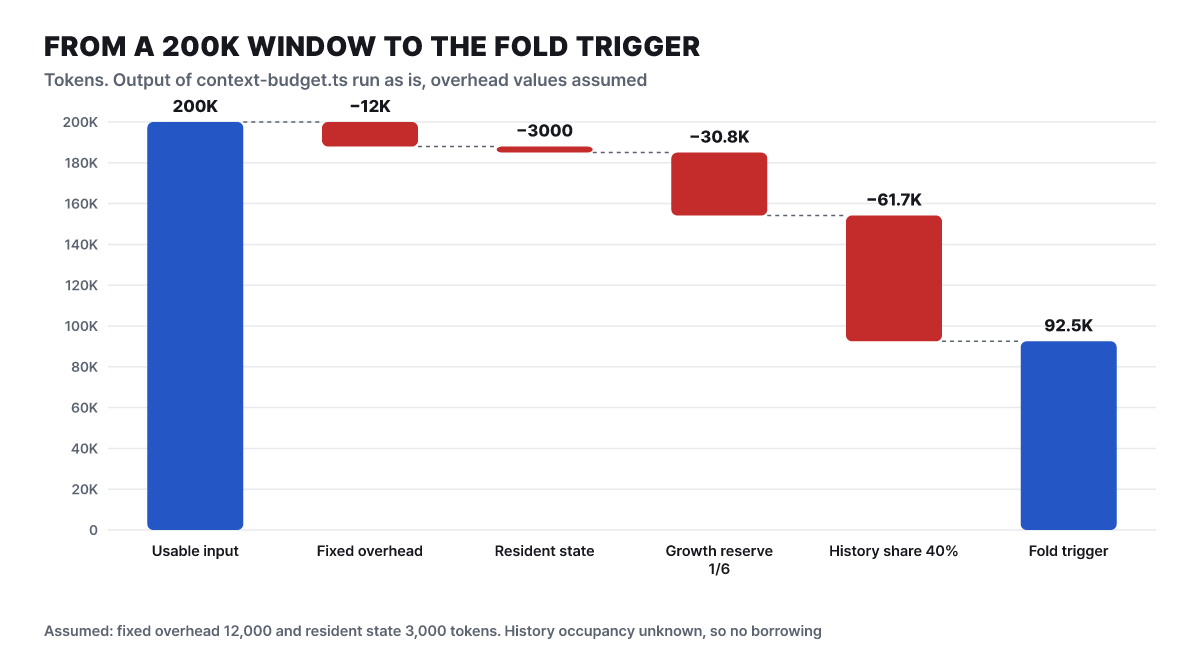
그림 3. 200K 창에서 접기 시작 시점까지의 계산(편집부 실험, 가정한 입력 포함).
폭포에서 볼 것은 오른쪽 파란 막대다. 200,000토큰 중 오버헤드와 상주 상태를 빼면 185,000토큰이 계획에 쓸 수 있는 여유(room)다. 여기서 6분의 1인 30,833토큰을 성장 여유로 떼고 남은 154,167토큰을 활성 작업 60%와 지난 대화 40%로 나눈다. 지난 대화 몫이 61,667토큰이고, 활성 작업이 이만큼 차면 접는 시점은 92,500토큰이다. 여기에 도구 결과 하나가 최대 1만 토큰이니 한 번에 대략 아홉 건의 큰 결과를 받으면 닿는 지점이다(편집부 계산).
접는 한 번의 크기도 이 값에서 나온다. 같은 실행에서 접을 때 남겨 두는 최근 꼬리는 활성 몫의 45%인 41,625토큰, 한 번에 접는 최대 단위는 그 절반인 20,812토큰이고, 요약 하나의 목표 길이는 활성 몫의 2%를 1,200과 6,000 사이로 맞춘 1,850토큰(저장 상한 3,083)이다. 소스 주석이 이 비례의 이유를 적었다. 고정된 1,200토큰 요약이 27만 토큰어치 과정을 대신하면 60K 창에서 요약이 쥔 공간보다 사실 하나당 공간이 훨씬 줄고, 잃어버린 사실은 곧 다시 읽기라는 비용으로 돌아온다. 그래서 창이 클수록 요약도 크게 잡는다.
지난 대화가 실제로 차지한 만큼은 활성 작업이 빌려 쓴다. 이 파일은 historyOccupancyTokens로 지난 대화의 점유량을 받아, 40% 몫 가운데 안 쓰는 부분을 활성 작업 몫에 더해 준다. 같은 200K 창에서 입력을 바꿔 돌린 값은 이렇다. 지난 대화가 0토큰이면 접는 시점이 154,167토큰, 20,000토큰이면 134,167토큰, 40,000토큰이면 114,167토큰이고, 61,667토큰을 다 채우면 92,500토큰으로 돌아온다. 기존 대화가 길게 이어진 프로젝트의 긴 작업은 빌릴 여유가 적어 일찍 접히고, 새 대화에서 시작한 긴 작업은 더 길게 원문을 쥐고 간다는 뜻이다. 한 번의 체크포인트가 요약기에 넘기는 입력은 15만 토큰이 상한이라 활성 작업 몫이 큰 창에서는 다 들어가지 못한 묶음이 다음 배치로 미뤄진다. 코드 주석의 문구로는 ‘들어가지 않는 완전한 묶음은 원문으로 남는다’.
아무도 안 쓰는 밤에 도는 복습
네 번째 장면에는 사용자가 없다. 일주일 쓴 뒤 주말에 앱을 켜 둔 채 자리를 비웠다고 하자. README는 이 시간대에 앱이 한가할 때 백그라운드에서 최근 활동을 돌아보는 작업이 돌고, 에이전트마다 자기 평가 파일 COMPETENCE.md, 재사용 가능한 방법을 적는 LEARNING_STRATEGIES.md, 학습된 스킬을 고칠 수 있다고 설명한다. 이 작업을 지휘하는 파일이 reflection-orchestrator.ts다. 머리 주석이 설계를 길게 적고 있어 장면의 순서를 거기서 뽑을 수 있다.
앱이 시작되고 시작 구간이 지나면 첫 주기가 돌고, 그 뒤로는 14시간마다 한 번이다(CYCLE_INTERVAL_MS). 주기가 돌아도 모든 에이전트를 복습하지는 않는다. 에이전트마다 먼저 쿨다운(같은 에이전트 사이 최소 4시간)을 통과해야 하고, 그다음 ‘더러움 검사(dirty gate)’를 통과해야 한다. 마지막 검토 이후 signals.jsonl에 그 에이전트의 신호가 새로 쌓였거나 세션 기록 파일이 더 최근에 바뀌었을 때만 복습 대상이다. 사령관이 직접 처리한 대화는 _default라는 가상의 에이전트 번호에 모인다. 처음 복습하는 에이전트는 최근 48시간 기록을 돌아본다. 후보가 5개를 넘으면 가장 오래 손대지 않은 순으로 5개만 뽑고 나머지는 다음 주기로 넘어가며, 에이전트가 사라지지는 않는다. 앱을 쓰는 중이면 10분 뒤에 한 번만 다시 시도하고, 사용자가 돌아오면 진행 중이던 복습도 양보한다.
한 에이전트의 복습은 120초 안에 끝나야 한다. 주석에 따르면 실제 복습은 두 메타 파일을 읽고 갱신을 쓰는 데 25초쯤 걸린다고 측정되었고, 최악의 경우도 모델 호출 다섯 번으로 막혀 있다. 이 마감 시간에도 설계 사연이 있다. 예전에는 주기 전체를 30초짜리 하나의 조각 시간으로 묶었는데, 파일을 읽고 갱신을 쓰는 느린 에이전트가 자기 자신뿐 아니라 주기 전체를 끝내 버렸다. 한편 ‘저장할 것이 없다’는 답은 5초면 끝나니 빠른 에이전트만 살아남는 선택 압력이 생겼다. 지금은 에이전트마다 따로 마감을 두고, 주기 전체의 그물은 5개 × 120초 + 60초, 곧 11분으로 잡았다.
복습의 결과도 네 갈래다. 갱신을 써서 남기거나(reflected), 기록을 읽고 저장할 것이 없다고 판단하거나(nothing_to_save), 그 구간에 활동 자체가 없었거나, 쓰기를 보류하는 경우다. 리뷰 프롬프트가 복습을 위한 복습을 하지 말고 ‘저장할 것 없음’이라고 답하게 하므로, 저장할 것 없음은 실패가 아니라 정상 종료로 센다. 주석은 이 구분이 없던 시절 이 기능이 몇 주 동안 아무도 모르게 동작하지 않은 채 돌았다고 적는다. 응답이 왔다는 사실과 무언가 남겼다는 사실이 같은 것으로 집계되었기 때문이다. 지금 복습이 남기는 쓰기는 metacognition 도구의 write와 skill_manage의 create, patch, delete뿐으로 정해져 있고, 읽기와 목록은 컨텍스트 수집용이라 쓰기로 세지 않는다.
복습 결과가 에이전트의 행동을 바꾼다는 점은 알아 둘 만하다. 갱신된 평가·방법 파일이 다음 실행의 입력이 되므로, 같은 에이전트라도 시간이 지나면 처음과 다르게 행동할 수 있다. 같은 결과가 반복되어야 하는 업무라면 이 파일들을 가끔 열어 보는 것이 편집부의 제안이다.
복습이 모델 호출 비용을 쓰는 일이라는 점도 코드에 반영되어 있다. 설정된 모델 후보가 전부 쿨다운 중이면 그 주기를 통째로 건너뛴다. 어차피 에이전트마다 실패한 시도만 하나씩 소비하기 때문이다.
실패한 복습이 64시간을 못 채우는 이유
실패를 다루는 쪽을 따로 보자. 주석에 따르면 일시적 실패(공급자 오류, 읽을 수 없는 원본)는 기준 시각을 앞으로 옮기지 않아 다음 주기에 다시 시도하되, 시도 자체는 기록해서 쿨다운과 순번이 마지막 시도를 기준으로 정해진다. 쿨다운은 실패가 이어질 때마다 두 배가 된다. 기본 4시간에 2의 거듭제곱을 곱하고 지수는 4에서 멈춘다.
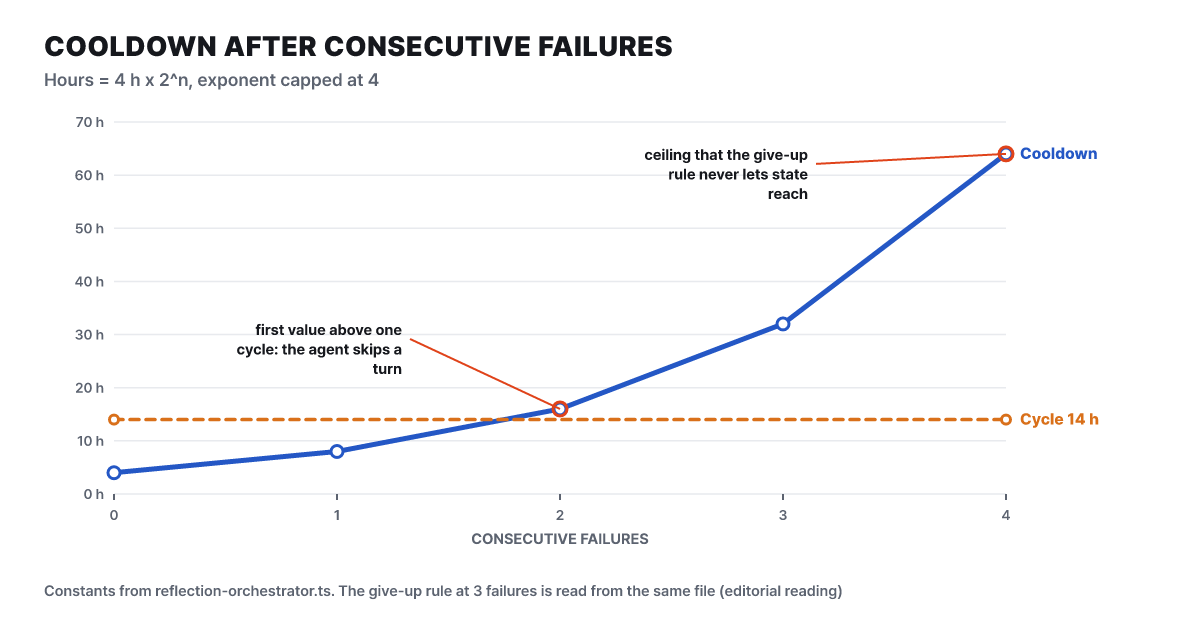
그림 4. 연속 실패 횟수별 쿨다운(소스 상수 기준 편집부 계산).
선에서 볼 곳은 14시간 점선과 처음 만나는 지점이다. 실패 2회의 쿨다운이 16시간이라 처음으로 주기(14시간)를 넘고, 그 에이전트는 한 주기를 건너뛴다. 그러나 같은 파일에는 연속 3번 실패하면 그 구간을 포기하고 기준 시각을 앞으로 옮기며 연속 실패 기록을 지운다는 규칙도 있다. 두 규칙을 함께 읽으면 쿨다운 계산에 들어가는 연속 실패 횟수는 많아야 2다.
이를 직접 돌려 본 것이 아래 편집부 실험이다. 소스의 쿨다운 함수와 선별 규칙을 옮겨 적고, 모든 에이전트에 새 활동이 계속 있다고 가정한 모의다. 먼저 에이전트 여덟 개가 항상 복습 대상일 때 주기마다 뽑히는 에이전트다.
| 주기 | 시각 | 뽑힌 에이전트(상한 5) |
|---|---|---|
| 1 | +0시간 | A1 A2 A3 A4 A5 |
| 2 | +14시간 | A6 A7 A8 A1 A2 |
| 3 | +28시간 | A3 A4 A5 A1 A2 |
| 4 | +42시간 | A6 A7 A8 A1 A2 |
가장 오래 손대지 않은 순서라는 규칙이 돌아가면서 모두에게 기회를 준다. 5개 상한이 에이전트를 잃게 하지 않는다는 주석의 설명과 같은 결과다. 다음은 계속 실패하는 에이전트 하나(주기 14시간)의 모의다.
| 주기 | 시각 | 일어나는 일 |
|---|---|---|
| 1 | +0시간 | 시도 실패, 연속 1 |
| 2 | +14시간 | 쿨다운 8시간이 지났으므로 시도, 실패, 연속 2 |
| 3 | +28시간 | 쿨다운 16시간이 아직 안 지나 건너뜀 |
| 4 | +42시간 | 시도 실패, 연속 3, 구간 포기와 기록 초기화 |
| 5 | +56시간 | 새 구간의 첫 시도 |
이 표에서 같은 패턴이 +56시간부터 되풀이된다. 연속 실패 3, 4, 5회의 쿨다운인 32시간, 64시간은 이 흐름에서는 계산되지 않는다. 편집부 해설: 64시간 상한은 코드에 있지만, 구간 포기 규칙이 연속 기록을 먼저 지우므로 기본값 설정에서는 닿지 않는 값으로 읽힌다. 이 판단은 주석과 함수 몇 개를 옮겨 돌린 결과에 근거한 것이고, 오케스트레이터 전체를 실행해 확인한 것은 아니다. 21번 연속 0건이라는 오프닝의 숫자와 합치면 이 설계의 취지가 읽힌다. 실패한 에이전트가 줄 맨 앞을 차지하지 못하게 하고, 같은 입력으로 같은 실패를 되풀이하지 않으며, 활동이 없는 에이전트는 복습 칸을 먹지 못하게 한다.
모델을 32K짜리 로컬로 바꾸는 순간
마지막 장면은 모델을 바꾸는 일이다. 보고서를 만들던 팀이 민감한 자료를 다루게 되어 클라우드로 나가지 않는 로컬 모델로 돌리기로 했다고 하자. FAQ가 알려 주는 경로는 계정 설정의 모델(Models)에서 채팅 모델을 추가하고 ‘Custom’을 골라 OpenAI 호환 또는 Anthropic 호환을 선택한 뒤 기본 URL, 정확한 모델 ID, API 키를 입력하는 것이다. FAQ는 Ollama나 LM Studio를 예로 든다. v2026.10.27 릴리스 노트는 사용자 정의 모델을 OpenAI의 Responses, Chat Completions 방식과 Anthropic 방식으로 연결할 수 있게 하면서 용량 검증과 자격 증명 복구를 더 분명히 했다고 적었다. 소스 빌드는 로컬 모델 엔드포인트만 붙이면 완전히 오프라인으로 돌릴 수 있다고 FAQ가 밝힌다.
바꾸기 전에 이해해 둘 것은 모델 설정의 범위다. 사령관과 내장 에이전트는 앱의 모델 설정 하나를 함께 쓰므로 한 번에 바뀐다. 그러나 Claude Code, Codex 같은 외부 CLI 에이전트는 자기 모델 설정을 유지한다. 로컬 모델로 바꿨는데 Claude Code가 그대로 클라우드로 호출을 보내는 상황은 설정이 틀린 것이 아니라 이 구조에서 나온 결과다. 데이터가 어디로 가는지는 구성마다 다르다.
자기 키 또는 로컬 엔드포인트
- 모델 호출이 기기에서 제공자(또는 로컬 서버)로 직접 간다
- 키는 기기에서 암호화되고 클라우드 동기화 대상에서 빠진다
- 소스 빌드라면 완전 오프라인 구성이 된다
내장 Orkas 모델과 음성 입력
- 내장 모델은 Orkas가 운영하는 서비스를 거친다
- 음성 입력은 Orkas API 키가 필요하고 소리가 인식을 위해 Orkas로 전송된다
- 선택 동기화와 공유 프로젝트는 고른 데이터가 Orkas 서버에 저장된다
민감한 자료를 로컬 모델로만 처리하려는 목적이라면 이 구성표에서 오른쪽을 켜지 않는 것이 조건이다. 로컬 모델 한 줄 연결이 끝나면 일이 끝난 듯하지만 앱 안쪽에서는 한 가지가 다시 계산된다. 컨텍스트 예산이다. 세 번째 장면에서 본 숫자들은 모델의 사용 가능 입력에서 나오므로 창이 작아지면 모든 층이 같이 줄어든다. 편집부가 같은 파일을 창 크기만 바꿔 돌렸다. 편집부 실험. 입력은 오버헤드 12,000토큰, 상주 상태 3,000토큰 가정이다.
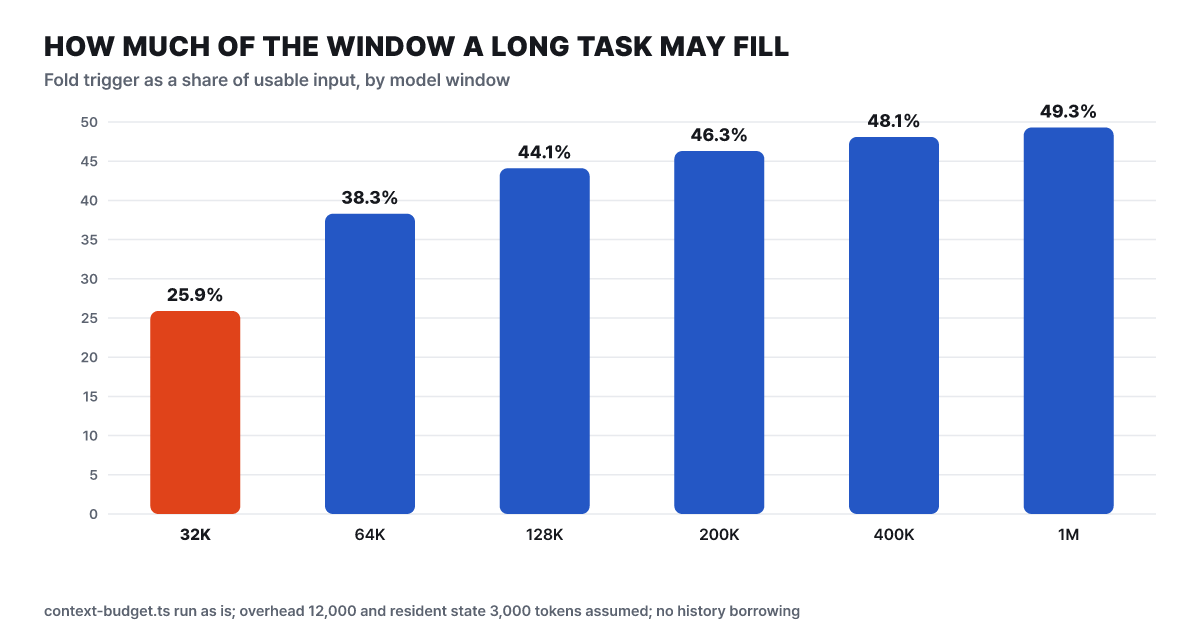
그림 5. 창 크기별 접기 시작 시점이 창에서 차지하는 비율(편집부 실험, 가정한 입력 포함).
막대는 창이 클수록 비율이 완만하게 올라 50%에 가까워지고, 32K 창에서 25.9%로 떨어지는 것을 보여 준다. 숫자로 풀면 32K 창은 여유가 17,000토큰이고 접기 시작 시점이 8,280토큰이다. 같은 일을 200K 창에서 하면 92,500토큰, 1M 창에서 하면 492,500토큰이다. 접히는 시점이 이르다는 것은 접기가 더 자주 일어난다는 뜻이다. 한 번의 접기는 요약 호출이라는 모델 호출을 쓰고, 요약 길이는 창이 작으면 바닥값인 1,200토큰에 머무른다. 요약 목표 길이는 32K, 64K, 128K 창에서 모두 1,200토큰이고 200K에서 1,850, 400K에서 3,850, 1M에서 6,000으로 올라 상한에 닿는다. 같은 가정 아래에서 32K 창은 접기가 25.9% 지점에서, 1M 창은 49.3% 지점에서 시작된다는 계산이다. 접기가 일찍 시작되면 요약과 다시 읽기를 거치는 횟수가 늘 수 있으므로, 작은 창의 로컬 모델에는 일을 작은 단위로 쪼개 주는 쪽이 이 설계와 맞는다는 것이 편집부 해설이다.
한 가지 더, 사용자 정의 모델의 창 크기를 앱이 모르면 어떻게 되는가. 소스는 창을 알 수 없거나 쓸 수 없는 값일 때 기본 예산으로 돌아가도록 짜여 있다. 이 기본값은 여유 36,000토큰을 기준으로 접기 시작 18,000토큰, 계획 여유 16,000토큰이고, 소스 주석은 이를 호환용 값이며 두 번째 용량 제한이 아니라고 설명한다. 릴리스 v2026.10.27이 ‘용량 검증’을 따로 다듬었다고 적은 것은 이 값이 틀린 창을 앱이 믿지 않게 하려는 방향으로 읽힌다. 또 v2026.5.8에는 외부 제공자의 최대 출력 토큰을 8192로 일괄 제한하지 않고 모델 ID 단계별로 나누는 수정이 올라와 있다.
작은 창의 끝은 또 다른 규칙이 만든다. 여유가 요약 목표 1,200토큰의 8배인 9,600토큰보다 작으면 층층이 쌓는 접기가 의미 있는 일을 하지 못한다고 보아 비상 층 하나로만 돌아가고, 요약 호출을 헛돌리지 않는다. 같은 파일에 입력을 바꿔 돌리면(오버헤드 8,000토큰, 상주 상태 1,000토큰 가정) 창이 18,000토큰일 때 여유가 9,000토큰으로 이 규칙에 걸리고, 20,000토큰이면 여유 11,000토큰이라 접기 시작이 5,400토큰인 층 구조가 유지된다. 로컬 모델이 접근하는 창 크기가 이 근처라면 접는 방식 자체가 바뀐다.
출처
- Orkas GitHub 저장소 README github.com
- GitHub 릴리스 목록 github.com
- Orkas 소스 locks.ts github.com
- Orkas 소스 actor-budgets.ts github.com
- Orkas 소스 context-budget.ts github.com
- Orkas 소스 runner.ts github.com
- Orkas 소스 reflection-orchestrator.ts github.com
- Orkas 공식 사이트 orkas.ai