AI 에이전트가 앱 속을 뜯어 본다, 별 39만 개 REA에 역공학을 어디까지 맡길까
별 39만 개를 넘긴 REA는 코딩 에이전트에 역공학 도구를 붙입니다. 100MB짜리 실제 Electron 앱을 넣어 맞힌 것과 놓친 것, 설치 전 확인과 지켜야 할 선을 따라가 봤습니다.
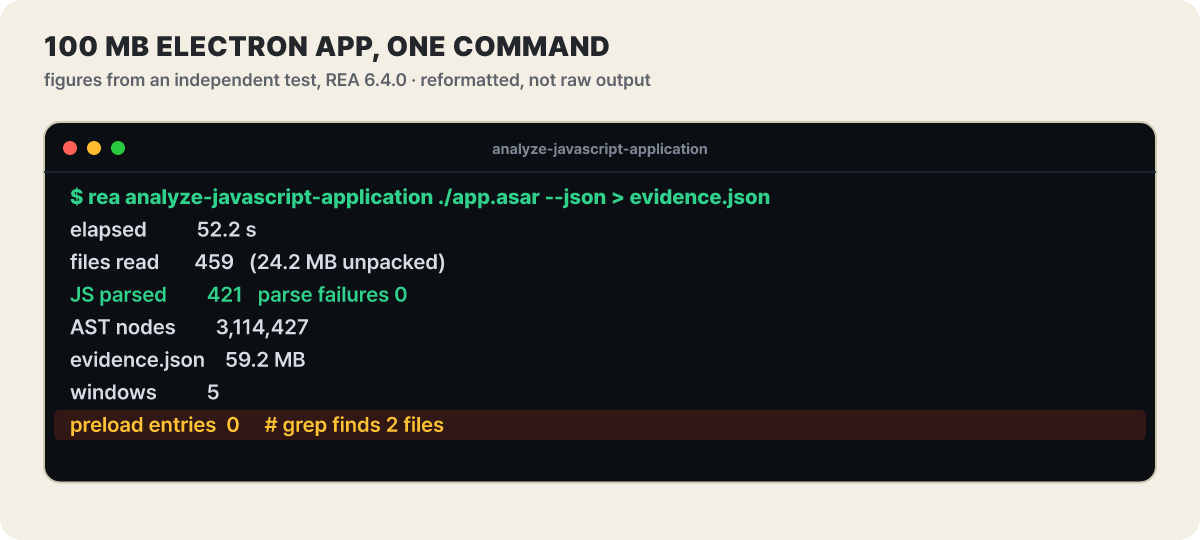 그림 1. 한 개발자의 독립 시험(REA 6.4.0)의 수치를 터미널 모양으로 정리한 것. 원문 출력이 아님
100MB짜리 앱의 파일 459개를 52초 만에 읽고 자바스크립트 421개를 파싱 실패 없이 소화했는데, 마지막 줄에서 일이 틀어집니다. 앱의 preload 진입점이 0개라고 나왔지만 같은 앱을 grep으로 훑으면 파일이 2개 나옵니다. REA(Reverse Engineer Anything)는 소스 코드가 없는 프로그램을 AI 에이전트가 분석하게 해 주는 MCP 서버 겸 CLI이고, 이 글은 그 시험을 길잡이로 삼아 실제 앱 하나를 분석시키는 순서와 그 결과를 어디까지 믿을지를 따라갑니다. 저장소는 4월 14일에 만들어졌고 한 분석에 따르면 10월 7일까지 별이 1만 개에도 못 미쳤는데, 27일(UTC)에 GitHub API로 확인한 값은 별 389,435개, 포크 97,557개입니다. 같은 기간 릴리스도 빨라서 10월 9일의 6.1.0부터 25일의 6.8.0까지 17일 동안 여덟 번 나왔습니다.
접수 창구일 뿐 디컴파일러는 아니다
새로운 역공학 기술이 나온 것은 아닙니다. 기계어를 사람이 읽는 코드로 되돌리는 디컴파일러는 Ghidra, IDA, Hopper가 이미 하던 일이고, REA는 그 앞에서 에이전트의 요청을 받아 엔진에 전달하고 결과를 정리해 돌려주는 창구입니다. 에이전트는 MCP(AI 에이전트가 외부 도구를 부를 때 쓰는 공통 규격)로 “이 함수의 의사 코드를 달라” 같은 호출을 하고, 돌려받은 근거를 읽어 설명하거나 비슷한 기능을 구현합니다. 구현이 맞지 않으면 다시 조사를 시키는 식으로 고리가 돕니다.
이 도구가 다른 점은 결과에 붙는 꼬리표입니다. 문서에 따르면 근거 기록에는 대상의 신원, 소스 위치, 관찰한 것과 추정한 것, 풀리지 않은 항목, 신뢰도, 한계, 그리고 대상을 얼마나 살폈는지를 뜻하는 범위(coverage)가 담깁니다. 두 결과를 비교할 때 한쪽에만 있는 항목은 “없다”고 단정하지 않고 미해결로 남깁니다. 분석 결과를 스냅샷으로 저장해 두면 대상 바이트·작업·설정이 모두 같을 때만 재사용하고, 스냅샷 파일은 로컬에 소유자 전용으로 보관됩니다. 뒤에서 보겠지만 이 꼬리표를 읽지 않으면 앞의 0개 같은 결과에 속습니다.
대상에 따라 엔진을 내가 깔기도, REA가 직접 읽기도 한다
분석 대상이 무엇이냐에 따라 필요한 준비물이 크게 갈립니다. 아래 그림은 README의 대상 표를 파일만 읽는 것과 엔진이 필요한 것으로 나눈 것입니다. 위쪽 초록 영역은 Node.js만 있으면 되거나 REA가 형식을 직접 해석하는 대상이고, 아래쪽 호박색 영역은 내가 엔진을 마련해야 하는 대상입니다.
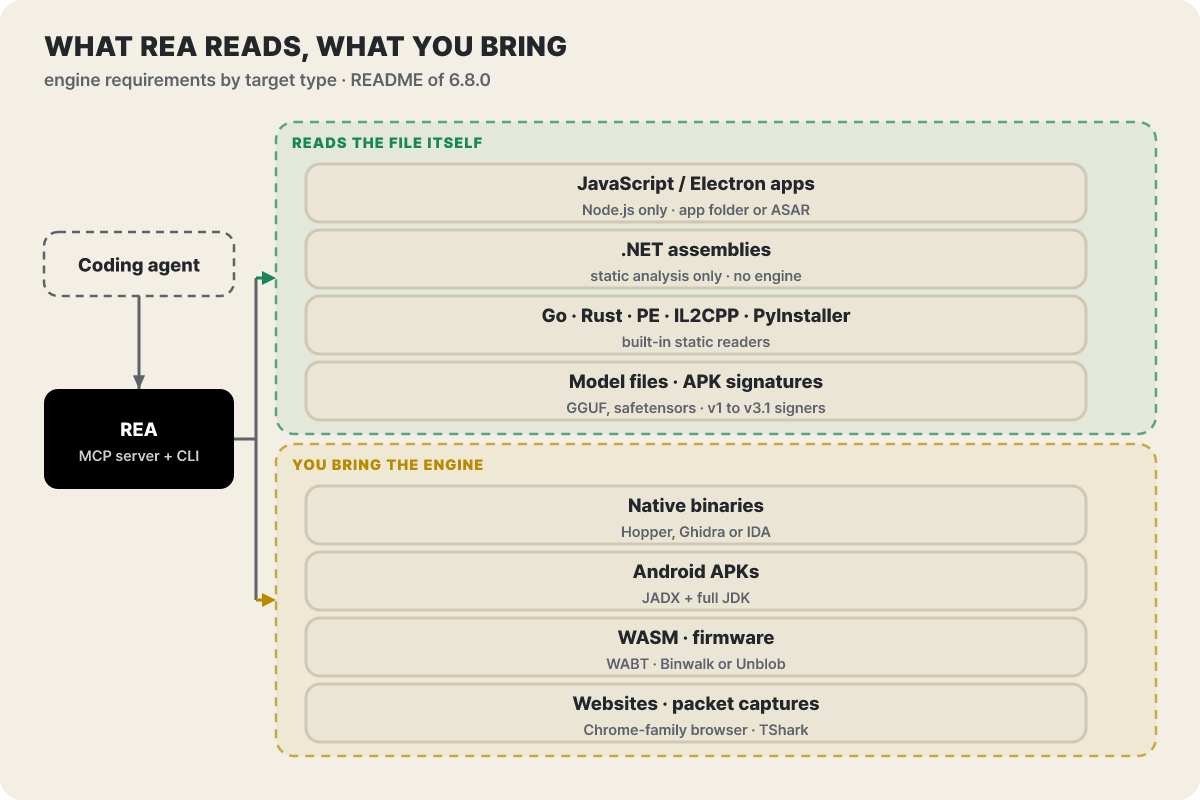 그림 2. 위는 REA가 파일을 직접 읽는 대상, 아래는 엔진을 따로 준비하는 대상
README의 표는 6.8.0에서 훨씬 길어졌습니다. 지금은 GPU 코드 객체, Erlang BEAM, Unity IL2CPP 메타데이터, Godot PCK, SQLite, 리눅스 크래시 기록, 논리 신호 기록 같은 형식까지 올라 있습니다. 준비물이 까다로운 쪽만 추리면 아래와 같습니다.
| 대상 | 얻는 것 | 내가 준비할 것 |
|---|---|---|
| 네이티브 실행 파일 | 함수, 문자열, 참조, 호출 관계 | Hopper, Ghidra, IDA 중 하나. Hopper는 setup이 승인을 받고 설치할 수 있고 Ghidra·IDA는 기존 설치를 사용 |
| 안드로이드 APK | 매니페스트, 클래스, 디컴파일한 메서드 | 헤드리스 JADX와 전체 JDK |
| WASM | 구간, 가져오기·내보내기, WAT | WABT 1.0.42 |
| 펌웨어 | 영역, 추출 결과 | Binwalk 또는 Unblob(리눅스) |
| 웹사이트 | 페이지 구조, 스크립트, 요청 관찰 | 크롬 계열 브라우저 |
| 네트워크 기록 | 요청, 응답, 노출된 페이로드 | HAR 또는 Fiddler SAZ 파일 |
| JavaScript·Electron 앱 | 모듈, 가져오기, 라우트, IPC, 네이티브 애드온 관계 | Node.js와 앱 폴더 또는 ASAR(리눅스는 procps 호환 ps) |
| .NET 어셈블리 | 메타데이터, CIL 명령어, 빌드 간 비교 | 없음(정적 분석만) |
엔진이 필요 없는 쪽은 실행 위험도도 낮습니다. 정적 JavaScript와 .NET 분석은 대상을 실행하지 않고 파일만 읽습니다. 반대로 프로세스·브라우저 캡처와 안드로이드 기기 조작은 대상을 내 사용자 권한으로 실제로 돌리거나 연결된 기기를 바꿉니다. 같은 대상에 맞는 엔진이 여럿이면 --provider로 하나를 고르고, 어떤 엔진이 잡혔는지는 rea providers --json으로 봅니다.
설정 파일에 무엇을 쓰는지 읽고 나서 설치한다
도구를 깔기 전에 “내 설정 파일에 무엇을 쓰는가”를 아는 것이 안전합니다. 프로젝트는 공식 출처가 morluto/rea 저장소, rea.tools, rea-agents npm 패키지 세 곳뿐이고 비슷한 이름의 저장소나 복사된 README는 공식이 아니라고 안내합니다. 제일 먼저 Node.js를 확인합니다. 지원 범위는 22.x(22.23.4 이상), 24.x(24.22.1 이상), 26.12.1 이상이고 6.8.0 릴리스 노트는 Node 23과 25가 지원 대상이 아니라고 못박았으며 설치기가 Node를 올려 주지는 않습니다.
- 읽기 전용으로 계획부터 봅니다. 아무것도 바꾸지 않고 어떤 파일이 어떻게 바뀔지만 출력합니다.
- 현재 환경이 준비됐는지 진단합니다. 이 명령도 읽기 전용입니다.
- 계획을 읽고 마음에 들면 실제 설정을 실행합니다. 쓰는 에이전트를 고르고, 설치 계획(바뀌는 파일 경로, 변경 내용, 필요한 외부 소프트웨어, 실행할 패키지 명령)을 확인해 승인합니다. Hopper 설치는 따로 한 번 더 묻고, Claude Desktop은 실행 중인 앱이 등록을 덮어쓸 수 있어 완전히 종료한 뒤 승인합니다.
- 에이전트를 재시작합니다.
rea setup --client codex --client cursor --skill=false --dry-run
rea doctor --json
npx rea-agents setup
문서에 따르면 setup은 선택한 에이전트의 설정에 MCP 서버 항목을 쓰고 다른 항목과 주석은 그대로 둡니다. Claude Code라면 ~/.claude.json의 mcpServers.rea에 등록되고 reverse-engineer-anything이라는 스킬이 ~/.claude/skills에 설치됩니다. 기존 설정은 .rea.backup으로 백업되고, 설정이 깨져 있으면 쓰기 전에 전체 작업을 멈춥니다. 손으로 등록하려면 한 프로젝트에만 거는 방법이 있고, 저장소에 .mcp.json이 생기는 --scope project는 피하라고 문서가 안내합니다.
claude mcp add --scope local rea -- npx -y rea-agents@6.8.0 mcp스킬만 받는 길(npx skills add morluto/rea --skill reverse-engineer-anything)도 있지만 이 경우 지침과 참고 자료만 설치되고 MCP 서버나 분석 엔진은 등록되지 않습니다. 갱신은 rea update(npm 또는 Bun으로 전역 설치한 경우만)이고, 끝나면 출력되는 설정 계획을 다시 승인하고 에이전트를 재시작합니다. npx로 쓴다면 npx rea-agents@latest setup입니다. 제거는 rea uninstall이고 --purge-data를 더하면 ~/.rea의 캐시와 상태까지 지웁니다. Hopper, Node.js, 모아 둔 근거 파일, 다른 MCP 서버는 그대로 남습니다.
엔진 쪽에서 막히기 쉬운 곳도 문서에 적혀 있습니다. Ghidra는 12.1.x(검증은 12.1.4)의 설치 경로를 GHIDRA_INSTALL_DIR에, 64비트 JDK 21 이상을 JAVA_HOME에 지정해야 하고 시작 제한 기본값은 330,000ms입니다. 큰 파일은 REA_GHIDRA_STARTUP_TIMEOUT_MS로 늘립니다. Hopper는 macOS 첫 실행 때 뜨는 데모·라이선스 대화상자를 같은 사용자 세션에서 먼저 처리해야 하고, 윈도의 Ghidra 지원은 실험적입니다.
100MB짜리 앱을 넣고 52초를 기다린다
이제 분석입니다. 대상이 내 소유의 Electron 앱이고 추출한 폴더나 ASAR 파일이 있다면 터미널에서 한 줄로 돌릴 수 있습니다. 앱을 실행하지 않고 파일만 읽으며, 결과는 파일로 남깁니다.
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json > app-evidence.json앞의 시험(Debian 13, Node 22.20, REA 6.4.0)은 약 100MB의 app.asar를 이 방식으로 분석했습니다. 459개 파일에서 JS 421개를 읽어 AST 노드 3,114,427개를 만들었고 파싱 실패는 0이었으며 52.2초가 걸렸습니다. 결과 JSON은 59.2MB였고 요약 호출 하나의 응답도 약 1.35MB였습니다. 에이전트에게 이 응답을 통째로 먹이면 대화 창이 금세 찹니다. 그래서 6.8.0 릴리스 노트는 큰 조사를 위한 보관 요약과 선택 조회를 내세웁니다. inspect_analysis_view로 이미 끝난 분석의 모듈 목록이나 선택한 사실만 쪽 단위(기본 64행)로 꺼내 보고, 전체 근거는 따로 내보내 둘 수 있습니다. 같은 릴리스에서 analyze_function은 기본이 요약만 돌려주도록 바뀌었고 예전 방식의 전체 보고서가 필요하면 detail: "complete"를 지정합니다.
문서에는 이 조회 방식에 붙은 경고가 있습니다. 쪽이 비었거나 끝까지 넘겨 읽었다는 사실이 분석을 덜 한 앱에서 “없다”는 증명은 못 된다는 것입니다. 시험에서도 연결 744개 가운데 365개가 결과 분량 제한으로 빠졌습니다. 결과를 읽을 때 개수만 보지 말고 범위와 한계 칸부터 보라는 뜻입니다.
grep으로 다시 세어 보니 한 줄이 비었다
같은 앱을 REA와 grep으로 각각 센 값을 나란히 놓으면 믿을 곳과 의심할 곳이 갈립니다. 아래 막대에서 두 막대 길이가 같으면 일치이고, 마지막 줄만 다릅니다.
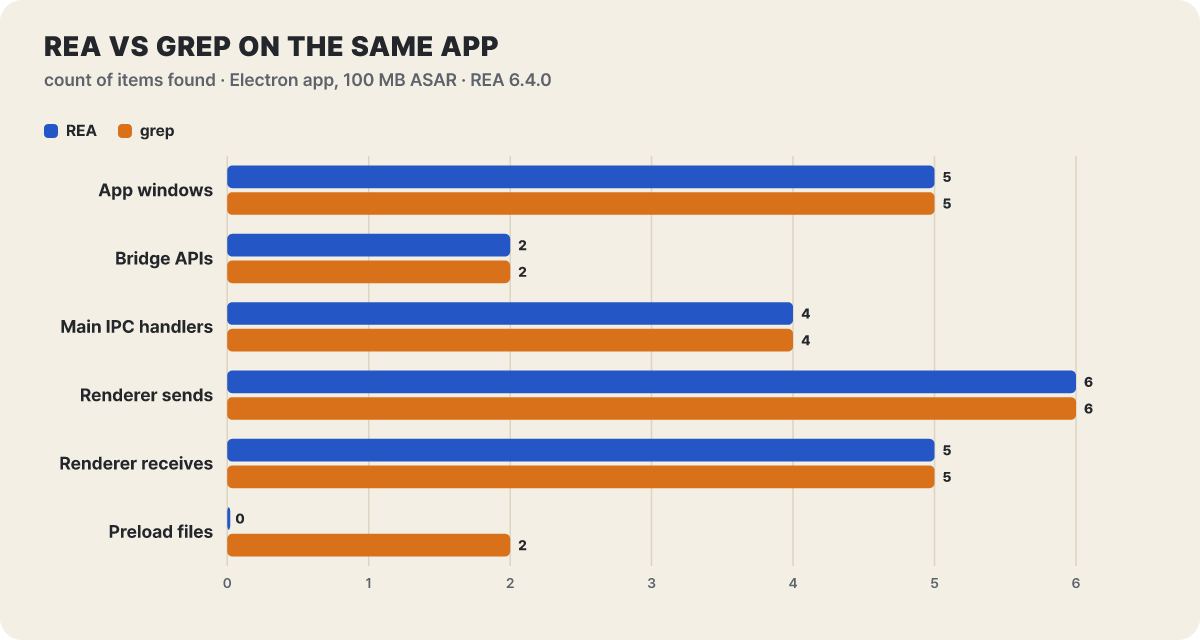 그림 3. 창·브리지·IPC는 일치, preload 파일은 어긋남. 출처: 개발자의 독립 시험, REA 6.4.0
앱 창 5개, 브리지 API 2개, 본체 IPC 처리기 4개, 화면 쪽 전송 6개와 수신 5개는 grep과 같았고, 압축·난독화한 코드를 담은 장난감 앱에서도 같은 결과가 나왔습니다. 틀린 곳은 두 군데입니다. preload 진입점을 0개로 잡은 탓에 노출 API 멤버가 0으로 나왔고, 채널 하나를 따라가는 추적은 소스에 그 문자열이 분명히 있는데도 빈 결과를 돌려줬습니다. 더 조심할 것은 장난감 앱의 헬퍼 함수 뒤에 숨은 발신자 검사 2건을 0건으로 보고한 일입니다. 발신자 검사는 Electron 앱 보안에서 핵심 점검 항목이라 이 항목은 결과만 믿으면 안 됩니다. REA는 “일치 없음”이 곧 “없음”은 아니라고 스스로 경고하지만, 그 경고를 지키는 것은 읽는 사람의 몫입니다. 이 수치는 6.4.0 기준이고 이후 릴리스에서 달라졌을 수 있으니 내 앱에서는 직접 다시 세어 봐야 합니다.
클립보드 복사 한 번이 본체까지 가는 길
그러면 REA가 제대로 찾을 때는 무엇을 보여 줄까요. 프로젝트가 공개한 Notion 데스크톱 사례(앱 7.6.1, REA 4.1.0)는 “복사 버튼이 눌리면 텍스트와 HTML이 시스템 클립보드까지 어떻게 가는가”를 묻습니다. Electron 앱은 화면 쪽 코드와 본체 쪽 코드가 분리돼 있고 둘 사이를 preload(화면에 노출하는 다리 코드)와 IPC(프로세스 간 통신)가 잇습니다. 아래 그림에서 초록 화살표는 REA가 위치를 찾은 구간이고 호박색은 사람이 코드를 읽어 이은 구간입니다.
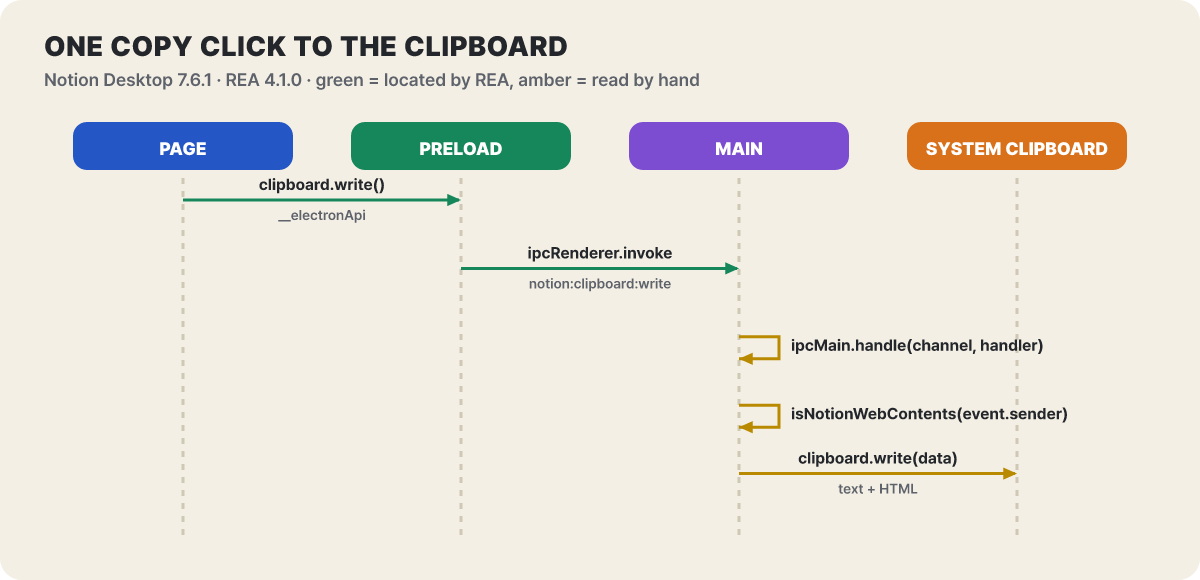 그림 4. REA는 노출 API와 호출 위치를 찾았고, 본체 수신부와의 연결은 손으로 읽었다
사례문은 확인 범위를 스스로 밝힙니다. REA가 찾은 것은 화면에 노출된 __electronApi와 ipcRenderer.invoke 호출 위치(채널 이름은 notion:clipboard:write)이고, 그것을 본체의 ipcMain.handle 수신부와 잇는 일은 포장 코드를 사람이 읽어 확인했습니다. 본체는 호출한 쪽이 Notion 화면인지 isNotionWebContents(event.sender)로 확인한 뒤에야 클립보드에 씁니다. 동작도 실제 데스크톱 화면이 아니라 저장해 둔 모듈과 작은 시험 코드로 확인했습니다. 복사된 HTML 안에 복사 ID가 들어 있고 붙여 넣을 때 앱이 그 ID로 자기 쪽 블록 데이터를 찾아 구조를 되살리며, ID에 맞는 기록이 없으면 일반 텍스트와 HTML로 붙는다는 점이 이 사례의 읽을거리입니다. 앞 절의 시험과 합치면 결론이 같습니다. REA는 길을 열어 주지만 마지막 이음매는 확인하는 사람이 이어야 합니다.
계산기 % 버튼과 공룡 속도, 같은 방식의 짧은 사례
프로젝트가 공개한 사례 가운데 숫자로 검증되는 것이 몇 가지 더 있습니다. 모두 REA 4.1.0 기준으로 소개된 것이고, 어디까지 확인했는지가 사례마다 적혀 있어 수치를 읽기 좋습니다.
- Windows 계산기의 % 버튼. “200 + 10%는 왜 220인가”가 질문이었고 11.2508.4.0(x64)의 처리기를 읽어 규칙을 찾았습니다. 덧셈 뒤의 %는 첫 번째 수의 비율이라 200의 10%인 20을 더하고, 곱셈·나눗셈 뒤의 %는 두 번째 수를 100으로 나눈 값이라 200 × 10%는 20입니다. 결과는 마이크로소프트가 공개한 소스·테스트와 대조했다고 합니다.
- 크롬 공룡 게임. 속도는 6에서 시작해 충돌 없이 갱신될 때마다 0.001씩 오르고 13에서 멈춥니다. 6에서 13까지는 7,000번 갱신이고, 대조 실험에서 원본 갱신 함수는 4,000번 뒤 10.0, 10,000번 뒤 13.0에 이르렀다고 합니다.
- 1996년 게임 DX-Ball의 소리 좌우 배분.
analyze_function으로 함수를 열자 의사 코드에는 입력이 보이지 않았고, 명령어를 읽자 입력이 스택([EBP+8])에서 실수로 변환돼 곱셈과 뺄셈을 거친다는 것이 드러났습니다. 호출하는 쪽에서는 벽돌 위치로20 + 30 × tile_x를 계산해 넘기고 있었고,read_bytes로 상수 1.5625와 500.0을 읽었습니다. 재구성한 C 코드는 스케일이 1일 때 왼쪽 끝(0)에서 -500, 가운데(320)에서 0, 오른쪽 끝(640)에서 500이 나옵니다.
DX-Ball의 검증은 두 갈래입니다. 원본 x86과 3,205가지 입력(정수 위치 0~640과 스케일 다섯 가지)을 나란히 돌려 비교했고, 같은 버전의 컴파일러로 다시 컴파일한 함수의 63바이트가 검토한 재배치를 반영한 뒤 원본과 일치했습니다. 의사 코드가 입력을 보여 주지 못하자 어셈블리로 내려간 대목이 중요합니다. 원본 소스를 복원해 주는 도구가 아니라 의사 코드·어셈블리·모듈 관계를 근거로 에이전트가 동작을 이해하고 구현하는 도구라는 뜻입니다. 이 밖에 안드로이드 인증 앱 Aegis의 APK에서 6자리 코드가 30초마다 바뀌는 이유를 시계로 보여 주는 사례와, 웹 앱 세션 기록(HAR)에서 에이전트 훈련용 환경을 만드는 rea environment-build 안내도 README에 있습니다.
도구 170개의 값: 에이전트가 짊어지는 컨텍스트
에이전트에 얹히는 비용도 숫자로 잴 수 있습니다. 앞의 시험에서 REA의 도구는 170개였고 tools/list 응답은 약 195만 바이트였으며 압축 스키마로는 약 177만 바이트였습니다. 에이전트의 컨텍스트에 이만큼이 실릴 수 있다는 뜻입니다. 6.8.0부터 입력 스키마는 기본이 압축형이고 전체 안내가 필요하면 REA_MCP_INPUT_SCHEMA_PROFILE=full로 켭니다. 클라이언트가 전체 tools/list 프레임의 크기를 제한한다면 출력 스키마를 REA_MCP_OUTPUT_SCHEMA_PROFILE=compact나 off로 줄일 수 있습니다.
돈은 세 갈래로 나뉩니다. REA 자체는 MIT 라이선스의 무료이고, IDA Pro·Hopper·JEB 같은 상용 엔진의 라이선스는 REA가 주지 않으니 내가 취득하고 업체 조건(체험판의 자동화·결과 공유 제한 포함)을 따라야 하며, 에이전트를 쓰는 비용은 모델 쪽 요금이 따로 듭니다. 응답이 큰 도구가 많아 토큰 사용량이 늘 수 있다는 점도 계산에 넣어 두세요.
“REA가 있으면 더 낫나”는 일화적 비교가 둘 있습니다. 한 AI 서비스 업체와 한 개발자의 영상 실험에서 REA를 쓴 에이전트와 쓰지 않은 에이전트가 각각 macOS 미리보기 앱과 비슷한 앱을 만들었는데, REA 쪽이 원본에 더 가깝다는 인상이었고 REA 없는 쪽이 먼저 끝났습니다. 둘 다 한 번 돌린 비공식 실험이고 걸린 시간 수치가 공개되지 않았습니다. 단순한 앱에서는 격차가 좁았고 복잡한 소프트웨어에서 도움이 될 수 있다는 평가입니다.
선택지는 더 있습니다. GhidraMCP(LaurieWired)는 Apache-2.0 라이선스에 별 11,578개이고, Ghidra 플러그인과 파이썬 브리지를 따로 설치해 함수 이름 바꾸기나 메서드·임포트 목록 추출 같은 Ghidra의 기능을 MCP로 열어 줍니다. 마지막 푸시는 10월 10일입니다. Ghidra 하나로 충분하고 에이전트 연결만 필요하다면 이쪽이 가볍고, REA는 여러 엔진과 형식을 한곳에 모은 만큼 설치할 것이 많고 결과가 큽니다. 화면이 단순한 앱의 겉모습만 비슷하게 만들려면 화면 캡처와 추론만 쓰는 일반 에이전트로도 되고, 가장 어려운 코드나 결과 책임이 걸린 작업은 사람이 Ghidra·IDA를 직접 다루는 편이 낫습니다.
분석해도 되는 앱과 안 되는 앱
프로젝트의 DISCLAIMER는 지원하는 쓰임과 지원하지 않는 쓰임을 직접 적어 두었습니다. 지원하는 쪽은 보안 연구, 악성코드·사고 분석, 조율된 공개를 따르는 취약점 연구, CTF와 교육, 상호운용성, 소프트웨어 보존, 자기 소유이거나 분석 권한이 있는 소프트웨어의 점검·디버깅입니다. 지원하지 않는 쪽은 DRM·라이선스 검사·치트 방지의 우회, 보호된 코드와 자산의 복제, 권한 없는 시스템의 인증·접근 통제 우회, 게임 치트 제작과 온라인 서비스 변조, AI 업체의 이용 정책 회피와 AI 계정·API의 재판매입니다. 지원하지 않는 용도의 요청은 이슈와 토론에서 답 없이 닫히고 커뮤니티에서 제외될 수 있다고도 적혀 있습니다.
이 선을 내 상황에 대 보면 아래와 같습니다.
| 대상 | 판단 |
|---|---|
| 내가 만든 앱, 내 회사 제품 | 출시 전 점검과 소스를 잃은 옛 도구의 이해에 맞는 용도 |
| 계약·서면 허가를 받은 고객의 소프트웨어 | 허가 범위 안에서만. 범위를 넘는 실행·수집은 권한 밖 |
| 남의 상용 앱의 화면·동작을 그대로 베끼는 일 | 프로젝트가 지원하지 않는 용도이고 지식재산권 문제가 생길 수 있음 |
| 출처를 모르는 실행 파일 | 격리된 가상 머신 안에서만. 분석과 실행은 다른 일 |
DISCLAIMER는 파일을 가지고 있거나 디버깅 창구에 접근할 수 있다는 사실만으로 모든 행동이 허용되지는 않는다고 못박습니다. 분석에서 나온 자격 증명·개인 정보·캡처한 통신은 보호해야 하고 모으거나 공유하기 전에 허락을 받아야 한다는 것도 사용자 책임으로 적혀 있습니다. 한 보도는 이 도구를 계기로 스마트 TV의 기본 소프트웨어를 갈아 끼우거나 기기 광고를 걷어 내는 시도가 늘었다고 전하면서, 허술하게 만든 대체 소프트웨어가 중요한 장비에 깔리면 기기와 네트워크가 위험해질 수 있다고 짚었습니다.
권한은 에이전트 쪽 승인에 달려 있습니다. REA는 개별 작업마다 확인을 따로 묻지 않고 그 몫을 MCP 클라이언트에 맡깁니다. 일부 도구는 분석 대상을 실제로 실행하거나 연결된 안드로이드 기기를 바꾸며, 이를 알리는 표시(파괴적 도구 힌트)는 클라이언트를 위한 힌트일 뿐 접근 통제가 아닙니다. 또 분석은 로컬에서 돌지만 도구 결과를 받는 쪽은 에이전트이므로, 의사 코드와 문자열은 그 에이전트가 쓰는 모델 업체의 데이터 정책 아래 들어갑니다.
내 앱에서 같은 점검을 돌리는 순서
위의 시험은 방어하는 쪽의 점검 비용을 낮추는 쓰임 그대로입니다. 출시 전에 내 Electron 앱의 노출 범위를 훑는 순서를 시험의 교훈에 맞춰 적으면 이렇습니다.
- 분석 대상이 내 소유인지 먼저 확인하고, 출처가 불분명한 파일이 섞였다면 가상 머신이나 격리된 계정에서 돌립니다.
- 앞의
analyze-javascript-application한 줄을 돌려 결과를 파일로 남깁니다. 앱은 실행되지 않습니다. - 결과의 창·브리지 API·IPC 처리기 개수를 grep으로 한 번 더 셉니다. 값이 다르면 어긋난 쪽부터 코드를 읽습니다.
- preload 개수가 0이거나 노출 API가 비었다면 정말 없는 것인지, 분석이 놓친 것인지부터 확인합니다. 결과의 범위·한계 칸을 함께 읽습니다.
- 발신자 검사는 코드를 사람이 직접 읽어 확인합니다. 헬퍼 함수 뒤에 숨은 검사는 도구가 놓친 사례가 있습니다.
- 에이전트의 승인 설정에서 실행형 도구(프로세스·브라우저 캡처, 기기 조작)를 매번 묻도록 걸어 둡니다.
같은 도구는 공급망 점검에도 쓰입니다. 받은 Go·Rust 바이너리의 내장 정보를 엔진 없이 읽어 컴파일러 버전, 모듈, 의존 크레이트 목록을 뽑을 수 있고, Rust는 cargo-auditable로 빌드한 바이너리에 박힌 정보를 읽는 방식입니다. 서명 쪽으로는 PE 인증서와 가져오는 DLL 목록, APK의 v1~v3.1 서명자와 인증서 지문을 읽습니다. 보안 업데이트를 비교하는 일도 쉬워졌습니다. 두 버전 사이에서 바뀐 부분을 찾는 패치 비교를 에이전트가 맡을 수 있고, REA에도 앱 버전과 소스·번들을 비교하는 도구(compare_application_versions)가 있습니다. 한 분석은 이런 비교가 빨라지면 수정 공개와 악용 사이의 간격이 줄 수 있다고 짚었으니, 방어하는 쪽은 그 속도를 가정하고 보안 업데이트 적용을 미루지 않는 편이 낫습니다. 배포한 앱은 누군가가 읽는다고 가정하고 비밀 값, 함께 딸려 나가는 소스 맵, IPC로 열어 둔 범위를 출시 전에 지워 두어야 합니다.



