OpenAI가 공개한 수학 원고 722편, 진짜 확인된 건 몇 편일까
OpenAI 수학 원고는 722편에서 719편이 됐고 Lean이 붙은 건 300 / 719입니다. 묶음 372, 문제 4,000, 안내 문서 242는 각각 센 단위가 다릅니다.
기사에 나온 숫자는 이렇습니다. 원고 722편, 철회 뒤 719편, 결과 묶음 372개, Lean 형식 증명 약 42%, 모델에게 준 문제 약 4,000개, 결과당 3시간. 불편한 점은 이 숫자들이 한 문단에 나란히 놓이면서 각각 무엇으로 나눈 값인지가 지워진다는 것입니다. “722편 가운데 몇 편이 확인됐나”라는 질문에 누구도 숫자 하나로 답하지 못하는 이유가 여기에 있습니다.
ChatGPT를 만든 OpenAI는 10월 6일(UTC) GitHub 저장소 openai/math에 내부 모델이 쓴 수학 원고 722편을 한꺼번에 올렸고, 라이선스는 Apache-2.0입니다. 이 글은 저장소의 README, 결과 목록 CONTENTS.md, history.md, Lean 폴더를 10월 27일에 다시 열어 숫자마다 분모를 따져 본 기록입니다. 저장소 자체는 공개 후 3주가 지난 지금도 10월 7일의 갱신 기록 한 건이 전부이고, 마지막 커밋(10월 12일)은 새 풀 리퀘스트 대화를 자동으로 잠그는 설정 하나였습니다. 별은 15,525개, 포크는 1,821개로 관심은 큰데 원고와 Lean 코드는 10월 7일 이후 그대로입니다.
분모 719가 정해진 10월 7일
첫 번째 분모는 공개 다음 날 바뀌었습니다. 「분할 아벨 8중 다양체 위 바일 류의 대수성」 원고의 부호 오류 하나가 안정화 대각합 상쇄 논증을 무너뜨렸고, 그 구성을 가져다 쓰던 원고 두 편(K3 곡면의 쿠가-사타케 대응, K3 곡면 곱의 유리 호지 추측)도 함께 성립하지 않아 총 3편이 철회됐습니다. 철회된 원고에는 사유와 이전 판 링크가 남았습니다.
수정된 14편은 켈러 극소 모형 6편, 립시츠 높이 4편, 길들임 변형 2편, 상자 수송 1편, BSD 공식 1편입니다. BSD 공식 원고의 수정은 이미 제거된 보조 원고를 인용한 낡은 문장을 고친 것이었습니다. 이 사건이 숫자 읽기에 주는 교훈은 둘입니다. 하나는 이제부터 모든 비율의 분모가 722가 아니라 719라는 점이고, 다른 하나는 같은 묶음 안의 원고들이 서로를 인용하므로 오류가 연쇄로 번진다는 점입니다. 어느 원고를 읽든 그 원고가 기대는 앞 결과가 무엇인지부터 봐야 합니다.
OpenAI 대변인은 내부 점검에서 오류를 찾았다고 밝혔습니다. MIT의 앤드루 서덜랜드 교수는 철회를 책임 있는 행동으로 평가하면서도 신뢰를 되찾기에는 충분하지 않다고 했고, 코넬의 알렉스 타운센드는 이런 연쇄 오류가 놀랍지 않으며 더 나올 것으로 본다고 말했습니다.
372는 주제 수이고 719는 논문 수다
두 번째 숫자 372는 원고 수가 아닙니다. README는 관련 원고를 묶은 단위를 “패밀리(family)“라고 부르고, 한 묶음에 주된 결과 하나와 보조 논증, 따름 결과, 다른 증명이 함께 들어갈 수 있다고 설명합니다. CONTENTS.md에서 묶음마다 원고를 세어 보면 평균은 묶음당 1.9편이지만 분포는 한쪽으로 크게 쏠려 있습니다.
아래 그림은 같은 데이터를 두 가지 분모로 센 것입니다. 위 막대는 묶음 372개를 묶음 크기로 나눈 비중이고, 아래 막대는 그 묶음 안의 원고 719편을 같은 크기 기준으로 나눈 비중입니다.
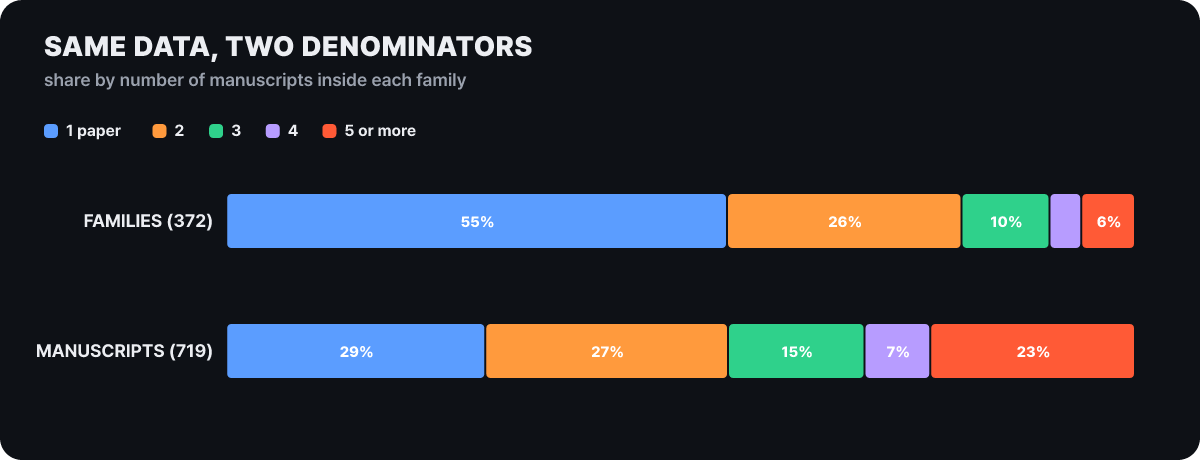 그림 1. 묶음의 55%는 원고 한 편짜리이지만, 원고 기준으로는 그 묶음이 29%뿐이다. 5편 이상 묶음은 6%인데 원고로는 23%
원고가 한 편뿐인 묶음이 205개로 가장 많고, 5편 이상 묶인 묶음은 22개인데 그 안에 원고 162편이 들어 있습니다. 가장 큰 묶음은 콤팩트 켈러 공간의 로그 아분던스(034번)를 다루는 14편짜리이고, 벌집 격자 자기회피 보행(237번)과 시공간 펜로즈 부등식(260번)이 13편으로 뒤따릅니다. “722편의 성과”보다 “372개 주제에 대한 결과 묶음”이라는 읽기가 실제에 가깝고, 큰 묶음 몇 개가 원고 수를 크게 부풀린다는 점도 함께 기억해 둘 만합니다.
폴더 이름 끝에는 판 날짜가 붙어 있습니다. 읽히는 717개의 날짜는 9월 10일부터 10월 7일까지 퍼져 있고 9월 23~27일에 547개(약 76%)가 몰려 있습니다. 폴더 날짜가 곧 작성일이라고 단정할 수는 없지만, 한꺼번에 올라온 722편이 같은 날 만들어진 것이 아니라 몇 주에 걸쳐 쌓였다는 점은 보여 줍니다.
42%의 분자와 분모, 그리고 Lean 숫자 네 가지
Lean은 증명의 모든 단계를 컴퓨터가 검사하는 증명 도구이고, 형식 증명이 붙었다는 것이 이번 공개에서 “확인됐다”는 말의 가장 강한 근거입니다. history.md는 이 비율을 “최상위 결과 300 / 719, 약 42%“라고 적습니다. 분자는 최상위 결과이고 분모는 원고 수입니다. README도 이 모음에는 검증 단계가 서로 다른 결과가 섞여 있고, 형식화되지 않은 결과에는 문제가 있을 수 있다고 직접 적고 있습니다.
그림 2는 공개 당시 722칸을 원고 한 편당 한 칸으로 그린 것입니다. 초록이 Lean이 붙은 300, 회색이 붙지 않은 419, 빨간색이 철회된 3입니다.
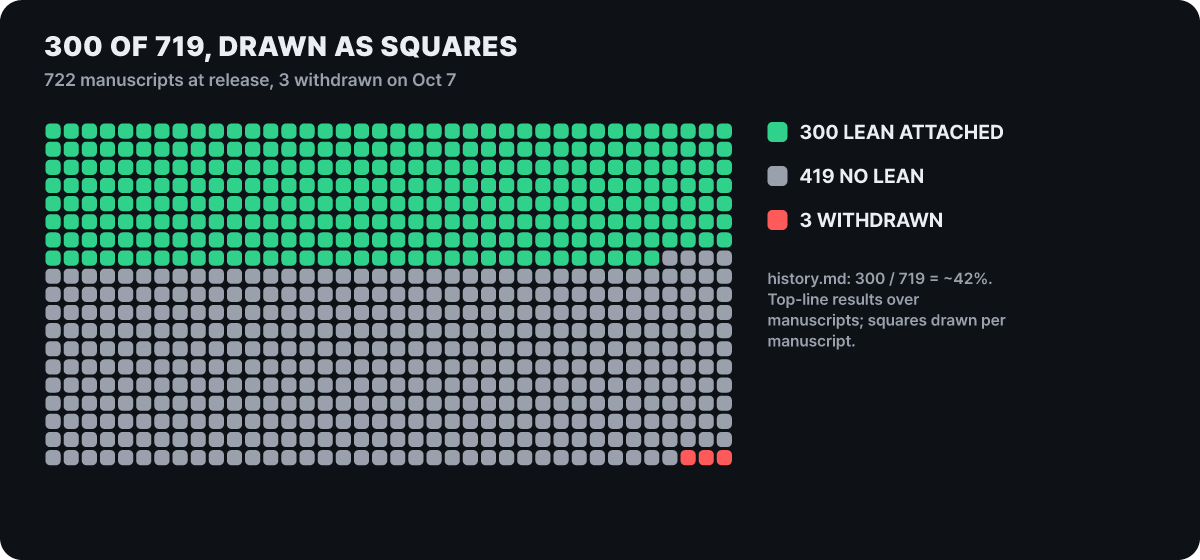 그림 2. 분모 719 가운데 Lean이 붙은 300과 붙지 않은 419. 분자 300은 갱신 기록이 적은 값을 그대로 옮긴 것
회색이 절반을 훌쩍 넘습니다. 숫자 42%는 틀린 것이 아니지만 “42%가 확인됐다”와 “58%는 확인되지 않았다”는 같은 사실을 반대 방향에서 말한 것이고, 헤드라인은 대개 앞쪽만 씁니다.
같은 저장소 안에서 Lean과 관련된 숫자는 하나가 아닙니다. 파일마다 센 대상이 다르고, 이 글에서 직접 세어 본 값은 아래와 같습니다.
| 숫자 | 어디서 세었나 | 센 대상 |
|---|---|---|
| 300 / 719 | history.md의 마지막 문장 |
최상위 결과 중 형식화된 것, 분모는 원고 수 |
| 242 | CONTENTS.md에서 Lean 안내 문서 링크가 있는 줄 |
묶음 372개 중 안내 문서가 있는 묶음 |
| 200 | lean/formalization.yaml의 comparator_config 항목 |
주요 결과로 등록된 검사 설정(중복 제외 189) |
| 173 | 같은 파일의 sources 항목 |
카탈로그에 올라온 원고 |
어느 숫자를 인용하든 파일과 줄을 함께 적어야 독자가 같은 값을 다시 셀 수 있습니다. 카탈로그 파일 자체도 상태 범위를 “부분 진행”으로, 형식화 방법을 에이전트로, 검수 상태를 “미확인(unchecked)“으로 표시합니다. 아래 명령으로 위 숫자를 모두 직접 셀 수 있고, 파일을 내려받아 화면으로 읽을 뿐 아무것도 설치하거나 바꾸지 않습니다.
U=https://raw.githubusercontent.com/openai/math/main
curl -s $U/CONTENTS.md | grep -c '^\*\*[0-9][0-9][0-9]\.'      # 372 묶음
curl -s $U/CONTENTS.md | grep -c '^ \['                     # 719 원고
curl -s $U/CONTENTS.md | grep -c 'lean/docs/'                    # 242 안내 문서가 있는 묶음
curl -s $U/history.md | grep -o '[0-9]* / [0-9]* = ~[0-9]*%'     # 300 / 719 = ~42%
curl -s $U/lean/formalization.yaml | grep -c 'comparator_config' # 200
curl -s $U/lean/formalization.yaml | grep -c '^  - title'        # 173
안내 문서가 있는 묶음 242개는 Lean 형식화가 일부라도 있다는 표시이지 묶음 전체가 기계 검사를 통과했다는 뜻이 아닙니다. 문서는 형식화된 문장이 어디까지인지 범위를 적어 둔 것이고, 그 범위가 원고의 제목보다 좁은 경우가 많습니다.
증명이 맞아도 문장이 다르면
Lean이 통과했다고 해서 원고의 주장이 확인된 것은 아닙니다. 기계는 증명이 맞는지는 보지만, 증명하려던 문장이 원고의 주장과 같은 뜻인지는 모릅니다. 그래서 저장소는 Lean 진영의 오픈소스 검증 도구 Comparator를 씁니다. 사람이나 모델이 풀이를 내기 전에 검증하는 쪽이 문장(출제 파일)을 먼저 정해 두고, 풀이 파일이 같은 문장을 증명하는지 샌드박스에서 확인하는 방식입니다. 확인은 여러 단계로 이어집니다. 두 파일을 격리된 환경에서 컴파일하고, 모듈을 꺼내 출제 문장과 풀이 문장을 대조하고, 허용 목록 밖의 공리를 썼는지 보고, 마지막으로 Lean 커널이 증명을 다시 승인해야 합니다.
출제 파일이 어떻게 생겼는지는 직접 볼 수 있습니다. 리만 제타 함수의 7/8 결과가 대표적입니다.
import Mathlib

namespace OAI

theorem riemannZeta_ne_zero_of_seven_eighths_lt_re
    {s : ℂ} (hs : (7 / 8 : ℝ) < s.re) : riemannZeta s ≠ 0 := by
  sorry

end OAIhs는 복소수 s의 실수부가 7/8보다 크다는 가정이고, 결론은 제타 함수 값이 0이 아니라는 것입니다. sorry는 증명이 풀이 쪽 파일에 있다는 빈칸입니다. 짝이 되는 설정 JSON에는 풀이가 들어 있는 모듈 이름과 허용 공리 세 개(propext, Quot.sound, Classical.choice)만 적혀 있습니다. 사람이 판단할 것은 이 세 줄이 원고의 주장과 같은 뜻인가 하나입니다.
이제 헤드라인과 이 문장의 거리를 봅니다. 원고의 제목은 “준 리만 가설”이고 묶음 설명도 그것을 해결했다고 합니다. 하지만 형식화된 문장이 확인하는 것은 리만 제타 함수와 모든 디리클레 L-함수가 실수부 7/8보다 큰 영역에서 0을 갖지 않는다는 점입니다. 리만 가설은 영점이 모두 실수부 1/2인 선 위에 있다는 주장이어서, 0이 없는 영역이 1/2 바로 오른쪽까지 와야 합니다.
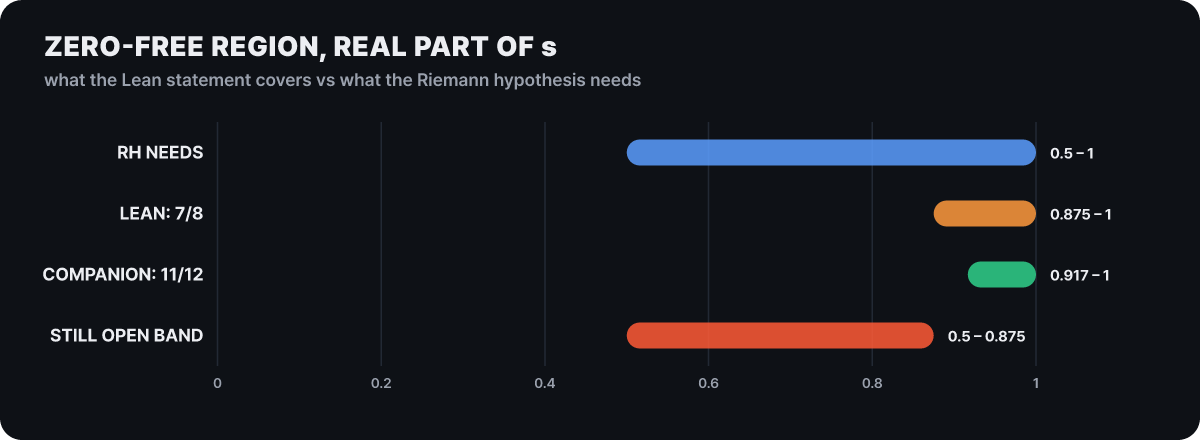 그림 3. 형식화된 영점 없는 영역(7/8 초과)과 리만 가설이 요구하는 영역(1/2 초과) 사이에 0.5~0.875 띠가 비어 있다
빨간 띠가 이번 결과가 다루지 않는 영역입니다. 같은 묶음의 보조 원고는 11/12 영역에 대한 다른 증명을 제공하는데, 그쪽이 더 좁은 영역이라 7/8보다 약합니다. 안내 문서 003.md는 범위를 더 좁게 적습니다. 원고의 이후 응용은 형식화에 포함되지 않았고, 란다우-지겔 영점에 대한 상수 c는 값이 주어지지 않으며, 실근을 1 − c/log q 안쪽으로만 몰아낼 뿐 구간 (0, 1) 전체의 실근을 배제하는 것은 아닙니다.
다른 안내 문서에서도 같은 구분이 보입니다. 세 문서를 나란히 놓으면 헤드라인보다 형식화된 문장에 조건이 더 많이 붙어 있습니다.
| 묶음 | 헤드라인 | 안내 문서가 적은 형식화 범위 |
|---|---|---|
| 130번 푸리에 변환 | n log n보다 빠른 정확한 변환 | 무한히 많은 길이에서 계수당 비용이 원하는 만큼 작아지는 부분열 결과와, 모든 길이에 대한 별도의 균일 결과를 따로 형식화. 부분열 결과에는 모든 길이·계수 크기·조건수·비트 복잡도 주장이 없다고 명시 |
| 107번 행렬 곱셈 | 지수 9/4 이하 | 복소수에서 ω ≤ 9/4, 모든 체에서 ω < 2.371054886006746. 덧셈·뺄셈·곱셈 횟수를 세는 산술 복잡도이며 비트 복잡도나 실용적인 교차 크기와는 무관 |
| 102번 유니크 게임스 | 추측 증명 | 이진 3SAT에서 유니크 게임스 인스턴스로 가는 결정적 다항 시간 환원(만족 가능이면 값 1 − ε 이상, 불가능이면 δ 이하)을 형식화 |
이런 간극은 이번 저장소 바깥에서도 확인됐습니다. 알렉산더 바스투니스(킹스칼리지)와 파브리안 치르첼리·안더스 한센(케임브리지)은 10월 6일 arXiv에 올린 논문(2610.08144)에서, AI가 옮긴 Lean 코드가 원래의 자연어 증명과 맞지 않는 사례로 OpenAI가 9월에 발표한 Navier-Stokes 폭발 증명을 들었습니다. 보도는 두 곳이 어긋나고 그중 한 곳은 코드가 논문보다 약한 추정을 증명한다고 전합니다. 저자들은 원래 증명이 맞는지 틀린지는 주장하지 않았고, 기계 검증을 거쳤어도 사람의 심사는 여전히 필요하다는 점을 말합니다. 이 사례는 openai/math의 원고가 아니라 별개의 발표에 대한 것이지만, 문장과 코드의 일치를 사람이 따져야 하는 이유를 같은 방향에서 보여 줍니다.
검사를 직접 돌리려면 리눅스에서 comparator, landrun, lean4export를 PATH에 두고 lean/ 폴더에서 lake update, lake exe cache get, lake env comparator ComparatorChallenges/QuasiRiemannHypothesis.json 순으로 실행합니다. 라이브러리가 하나로 크게 묶여 있어서 전체를 한 번에 컴파일하지 말고 작은 부분씩 빌드하라고 README가 권하고, 리눅스에서는 vm.max_map_count가 낮으면 빌드가 실패할 수 있습니다. 저장소의 Lean 도구 버전은 4.34.1이고, Comparator는 4.35.0부터 Lean 코어에 병합되었습니다.
4,000문제에서 372묶음까지, 거른 비율은 성공률이 아니다
README가 밝힌 생산 과정은 한 줄입니다. 대부분의 결과를 같은 절차로 만들었고, 같은 내부 모델에 열린 연구 문제를 주어 결과당 평균 약 세 시간의 ChatGPT Pro 수준 사고 계산을 쓰게 했으며, 모델에게 낸 문제는 약 4,000개입니다. 출력을 묶음과 원고로 정리하고 “적절한 수준의 중요성”을 요구해 걸러낸 결과가 지금의 372묶음 719편입니다.
여기서 372를 4,000으로 나누면 약 9%(편집부 계산)가 나오는데, 이것을 성공률로 읽을 수 없습니다. 분모는 모델에게 낸 문제 수이고 분자는 OpenAI가 스스로 정한 중요성 기준을 통과해 남은 묶음 수라서, 풀이에 실패한 문제와 풀었지만 기준에 못 미쳐 버린 문제가 섞여 있습니다. 평균 3시간도 README가 결과당 평균이라고 적은 값이므로, 여기에 4,000을 곱해 전체 계산량으로 쓰는 것은 맞지 않습니다.
고정 절차에서 벗어난 예외도 README에 적혀 있습니다. 리만 제타 함수의 영점이 없는 영역에 관한 작업과 CM 아벨 다양체에 대한 호지 추측 증명은 이 절차로 만들지 않았고, 제타 영점 없는 영역 Re(s) > 11/12 결과의 원고는 읽기 쉽게 사람이 손봤습니다. 모델의 추론을 줄여 정리한 요약은 열 개 묶음에만 붙어 있고, 모델 이름과 프롬프트는 저장소에 없습니다. 그래서 외부 연구자가 같은 결과를 다시 만들어 볼 수 없고, 서덜랜드 교수는 모델이 공개되어 다른 사람이 재현하기 전까지 한 번에 풀었다는 주장을 확정하지 않는 편이 낫다는 취지로 말했습니다.
밀레니엄 문제 다섯 개와 목록의 거리
372개 묶음에는 이름 있는 난제가 많이 나옵니다. 앞에서 본 묶음 설명을 따라 몇 개를 옮기면 003번 영점 없는 영역 7/8, 102번 유니크 게임스 추측, 157번 하드비거 추측 반례(분수 색칠까지 포함), 004번 유리수 위 힐베르트 10번째 문제의 부정적 해결, 032번 CM 아벨 다양체의 호지 추측이 있고, 109번은 n비트 정수 곱셈을 n log n보다 빠르게 한다는 주장입니다. 모두 OpenAI 원고의 주장이고, 이 가운데 003번과 102번과 157번에는 Lean 안내 문서가 있고, 109번과 004번과 032번에는 없습니다.
“리만 가설이나 나비에-스토크스 방정식이 풀렸느냐”는 질문에는 목록이 직접 답합니다.
| 밀레니엄 문제 | 목록에서 가장 가까운 결과 | 주장 범위 |
|---|---|---|
| 리만 가설 | 003 | 영점이 없는 영역이 실수부 7/8 초과(가설은 1/2 선) |
| 버치-스위너턴다이어 추측 | 002 | 셀머 군의 코랭크가 0 또는 1인 타원곡선(006번과 합치면 이차 꼬임의 밀도 1 집합) |
| 호지 추측 | 032 | CM 아벨 다양체에 한정 |
| 나비에-스토크스 | 376 | 외력이 있는 흐름이 보편 계산을 수행하도록 만드는 구성 |
| P 대 NP | 해당 없음 | 목록에 없음(스콧 에런슨도 글에서 짚음) |
376번은 매끄러운 해의 존재를 따지는 문제가 아니라, 정지한 상태에서 출발해 외력을 가하면 흐름 속 입자가 튜링 기계의 정지 여부를 알려 주도록 만들 수 있다는 구성입니다. 이름이 같을 뿐 밀레니엄 문제와 다른 질문입니다.
선언에서 보충 글까지 6주
분모를 둘러싼 논쟁은 공개 직전부터 시작됐습니다. 9월 11일에는 필즈상 수상자 등이 서명했다고 보도된 「수학에서 AI의 심각한 어긋남」이 테런스 타오의 블로그에 올라왔습니다. 풀이를 서둘러 발표하면 설명과 새 방법과 인용이 빠져 수학이 그것을 흡수하지 못한다는 취지입니다. 9월 21일에는 고등연구소(IAS)가 호스팅하는 수학·AI 자문 그룹(AGMAI)이 출범했고, 위원 9명은 무급이며 AI 회사에 대한 의사결정 권한이 없다고 밝혔습니다. 9월 29일에는 600여 건의 설문을 반영해 AI 연구소가 수학 결과를 낼 때의 지침을 발표했습니다.
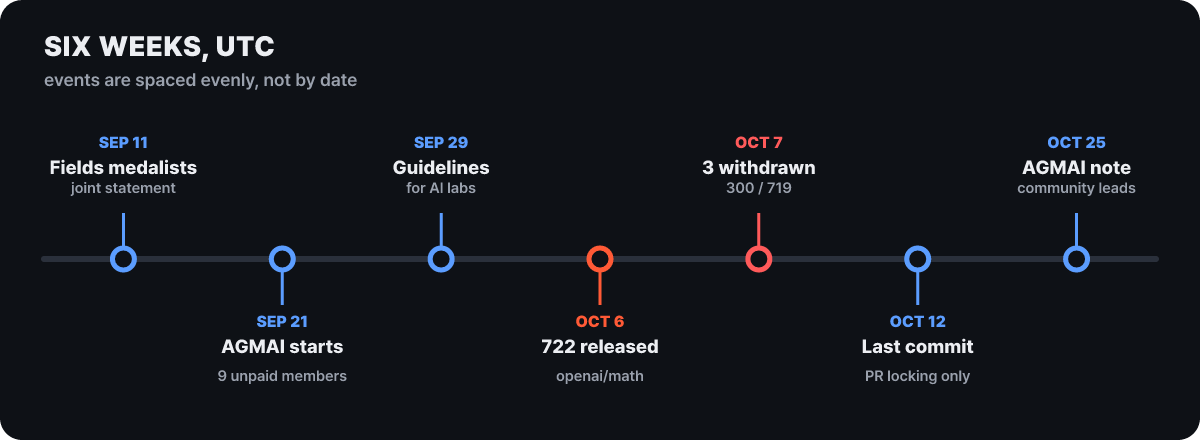 그림 4. 공개 앞뒤의 경과. 점 간격은 날짜 간격과 무관하게 같다
공개 당일인 10월 6일 AGMAI는 자신의 역할이 결과의 영향에 대한 판단이 아니라는 성명을 냈고, 10월 25일에는 공개 뒤의 이해 작업은 공동체가 주도해야 하며 연구소가 특정 수학자에게 미리 결과를 넘기지 말라고 조언하는 보충 글을 올렸습니다.
반응은 환영, 신중, 반대로 갈렸습니다. 스콧 에런슨은 10월 7일 글에서 수학사에서 손꼽히는 날이라고 하면서도 이해한 사람이 거의 없다고 짚었고 직접적인 실용 응용은 알지 못한다고 밝혔습니다. 레번트 알푀게는 수학사에서 가장 의미 있는 순간이라고 평가하되 프로젝트를 선점당한 연구자가 피해를 볼 수 있다는 점도 인정했습니다. 하버드의 멜라니 우드는 공개 시점에 그 결과에 대한 인간의 이해가 없다는 점을 짚었고, 마이클 해리스는 이 원고들을 읽지 않겠다고 밝혔습니다. 인간수학협회는 700여 파일을 한꺼번에 올린 것을 학술이 아니라 힘의 과시라고 규정하고 수학자들에게 협업 중단을 촉구했습니다. 이 가운데 증명이 맞느냐보다 증명이 이해되고 있느냐를 문제 삼은 쪽이 많다는 점이 눈에 띕니다.
AGMAI의 9월 29일 지침은 이번 공개를 재는 잣대로 자주 쓰입니다. 지침을 지켰는지는 그룹이 공동체가 판단할 일이라고 했으므로, 아래 표는 판정이 아니라 지침 항목과 저장소·보도로 확인되는 사실의 대조입니다.
| 지침 항목 | 저장소·보도로 확인되는 사실 |
|---|---|
| 인용과 설명 개선 노력 | 원고 폴더마다 인용 BibTeX와 빌드 안내가 있음. 선행 연구 인용의 충분성은 비판이 제기된 사안 |
| 연구소가 통제하지 않는 저장소에 게시 | 현재는 OpenAI 조직의 저장소. 커뮤니티 호스팅 저장소를 알아보는 중이라고 README가 밝힘 |
| 모델·프롬프트·추론 기록·시도 횟수·계산량 공개 | 모델 이름과 프롬프트는 없음. 평균 3시간, 약 4,000문제, 추론 요약 열 묶음은 공개 |
| 가능하면 Lean 형식화 | 300 / 719(약 42%), 계속 추가한다고 README가 밝힘 |
| 문제 선정 방식과 시도 수 | 약 4,000문제와 중요성 기준 선별을 README에 서술 |
| 이해를 돕는 자금 지원 | OpenAI가 워크숍·학회·프로그램을 지원하겠다고 밝혔다고 보도됨 |
10월 27일 저장소가 말하는 것
지금 저장소에서 읽을 수 있는 사실을 분모 순서대로 다시 모으면 이렇습니다. 공개된 722편 가운데 719편이 남았고, 그 안의 묶음은 372개이며 묶음의 55%는 원고가 한 편입니다. Lean 형식 증명이 붙은 비율은 갱신 기록의 300 / 719이고, 카탈로그는 형식화가 부분 진행이며 사람의 검수가 아직 표시되지 않았다고 적습니다. 안내 문서가 달린 242개 묶음에서도 형식화된 문장은 원고 제목보다 조건이 많이 붙은 부분이었습니다.
README는 형식화를 얻는 대로 저장소에 계속 더하겠다고 하고, 철회·수정은 새 판으로 기록하고 이전 판도 계속 열어 두겠다고 약속합니다. 그래서 인용할 때는 원고 폴더의 BibTeX를 쓰면서 판 날짜를 함께 적어야 합니다. 같은 제목의 원고라도 날짜가 다르면 다른 판이고, 철회된 원고는 폴더의 README에 사유와 보관본 링크가 있습니다. 이 저장소에서 어느 결과가 “확인됐다”는 말을 들었다면, 가장 빠른 확인 순서는 CONTENTS.md에서 번호를 찾고, 같은 번호의 lean/docs 문서가 있는지 보고, 있다면 Scope 절의 문장이 헤드라인과 같은 뜻인지 읽고, history.md에서 그 원고와 앞 결과의 철회·수정 날짜를 확인하는 것입니다.



