샘 올트먼이 스마트폰을 버리고 5GW 전력망에 집착하는 이유
샘 올트먼의 심층 인터뷰를 통해 OpenAI가 조니 아이브와 설계 중인 자체 하드웨어와 전력 장벽, 그리고 재귀적 자기개선(RSI)의 수학적 수렴 한계를 공학적으로 분석합니다.
미국 텍사스주 애빌린 근교의 광활한 사막 한가운데에는 500메가와트(MW) 규모의 초대형 데이터센터 신축 공사장이 자리 잡고 있다. 이곳 현장 소장의 책상 위에는 엔비디아의 최신 AI 서버 랙 청사진 대신, 고전압 변전소에 들어갈 345kV급 대형 변압기(GSU Transformer)의 납기 일정이 적힌 서류철이 놓여 있다. 현재 글로벌 전력 장비 시장에서 이 특수 변압기를 주문하면 공장에 물건이 도착하기까지 평균 4년 6개월이 걸린다.
최근 장시간의 비공개 심층 인터뷰에 나선 오픈AI(OpenAI)의 최고경영자 샘 올트먼(Sam Altman)의 시선은 정확히 이 지점을 향하고 있었다. 화려한 알고리즘 모델의 파라미터 수 경쟁이나 벤치마크 점수 자랑이 아니었다. 전력망의 물리적 한계, 반도체 패키징 라인의 병목, 그리고 인공지능이 스스로 코드를 개선하는 재귀적 자기개선(RSI, Recursive Self-Improvement) 루프가 맞닥뜨린 수학적·공학적 경계선이었다.
“지난 몇 달 동안 나는 제품 배포 파이프라인에서 단 한 줄의 코드도 직접 검토하지 않았습니다. 모든 개발 작업은 상위 에이전트 오케스트레이션으로 완전히 전환되었습니다.”
올트먼의 이 담담한 선언은 프로그래밍이라는 노동의 형태가 근본적으로 변했음을 뜻할 뿐만 아니라, 향후 소프트웨어 산업 전체가 감당해야 할 연산량의 규모가 폭발적으로 팽창하고 있음을 예고한다. 스마트폰이라는 사각 유리창 폼팩터를 넘어설 새로운 자체 물리 디바이스(Form Factor) 구상과, 전력망을 통째로 집어삼키는 제본스의 역설, 그리고 확률적 인텔리전스를 제어하기 위한 결정론적 통제권의 본질을 시스템 엔지니어링 관점에서 깊숙이 해부해 본다.
앰비언트 하드웨어 설계 철학
많은 미디어들이 샘 올트먼과 전 애플 수석 디자이너 조니 아이브(Jony Ive)의 비밀 하드웨어 프로젝트를 두고 ’스마트폰을 대체할 새로운 휴대폰’이라는 진부한 관점으로 접근한다. 하지만 올트먼이 인터뷰 전반에서 강조한 물리적 기기의 본질은 스마트폰의 대체재가 아니라 완전히 다른 컴퓨팅 범주다.
스마트폰은 인간의 주의력을 적극적으로 갈취하는 기기다. 주머니에서 꺼내 화면을 켜고, 앱 아이콘을 터치하고, 스크롤을 내리며 시각 피질을 독점해야만 비로소 기능한다. 반면 오픈AI가 구상하는 차세대 하드웨어의 핵심은 인간의 감각을 방해하지 않는 상시 인지(Ambient Computing) 환경이다.
사용자의 책상 위, 회의실 모서리, 혹은 가벼운 웨어러블 형태로 공간에 녹아들어 시각 센서와 마이크로폰 배열을 통해 현실 세계의 컨텍스트를 실시간으로 인지한다. 사용자가 “그 아이디어 어제 미팅에서 논의했던 수치와 비교해 줘”라고 말하는 순간, 기기는 별도의 조작 없이도 과거 맥락과 현재 대화를 벡터 공간에서 즉각 교차 조회하여 필요한 핵심 액션만을 실행한다.
이러한 상시 인지 기기를 구현하기 위해서는 기존 모바일 기기와는 완전히 다른 3가지 하드웨어 공학적 도전 과제를 풀어내야 한다.
-
상시 인지(Always-On)에 적합한 서브 1와트 저전력 엣지 NPU
주변 환경의 소리와 시각 프레임을 24시간 감시하면서도 배터리가 며칠 동안 지속되려면, 메인 고성능 애플리케이션 프로세서(AP)를 잠재우고 초저전력 NPU만으로 의미론적 필터링을 수행해야 한다. -
단말 단에서의 제로 레이턴시 멀티모달 압축
모든 음성 스트림과 고화질 4K 비디오 프레임을 중앙 클라우드로 24시간 스트리밍하는 것은 통신 대역폭과 프라이버시, 서버 비용 측면에서 물리적으로 불가능하다. 단말 내부에서 노이즈를 제거하고 고밀도 임베딩 벡터로 1차 압축하여 중앙으로 전송하는 계층화된 온디바이스 전처리가 필수적이다. -
화면 없는(Screenless) 환경에서의 결정론적 음성 피드백
디스플레이가 없다는 것은 오류 메시지나 확인 팝업을 띄울 수 없음을 의미한다. 모델이 내놓는 확률적 답변이 즉각 물리 세계의 동작으로 이어지기 때문에, 잘못된 환각 출력을 하드웨어 수준에서 차단하는 안전 인터록(Interlock) 회로가 요구된다.
브로드컴 맞춤형 NPU 아키텍처
소프트웨어 기업이었던 오픈AI가 자체 실리콘(Silicon) 반도체 설계로 눈을 돌릴 수밖에 없었던 배경에는 엔비디아(NVIDIA) 단일 공급망에 종속된 기형적인 원가 구조가 자리 잡고 있다. 현재 엔비디아의 최신 가속기 마진율은 70%를 웃돈다. 전 세계 모든 AI 기업들이 번 돈이 고스란히 엔비디아의 금고로 빨려 들어가는 구조다.
오픈AI가 글로벌 반도체 설계 강자 브로드컴(Broadcom) 및 세계 최대 파운드리 TSMC와 손을 잡고 독자 ASIC(주문형 반도체) 개발에 착수한 이유는 명확하다. 범용 그래픽 처리 연산(CUDA)의 거품을 걷어내고, 오직 트랜스포머 디코더 블록과 어텐션 행렬 연산에만 100% 최적화된 맞춤형 NPU 다이(Die)를 확보하겠다는 전략이다.
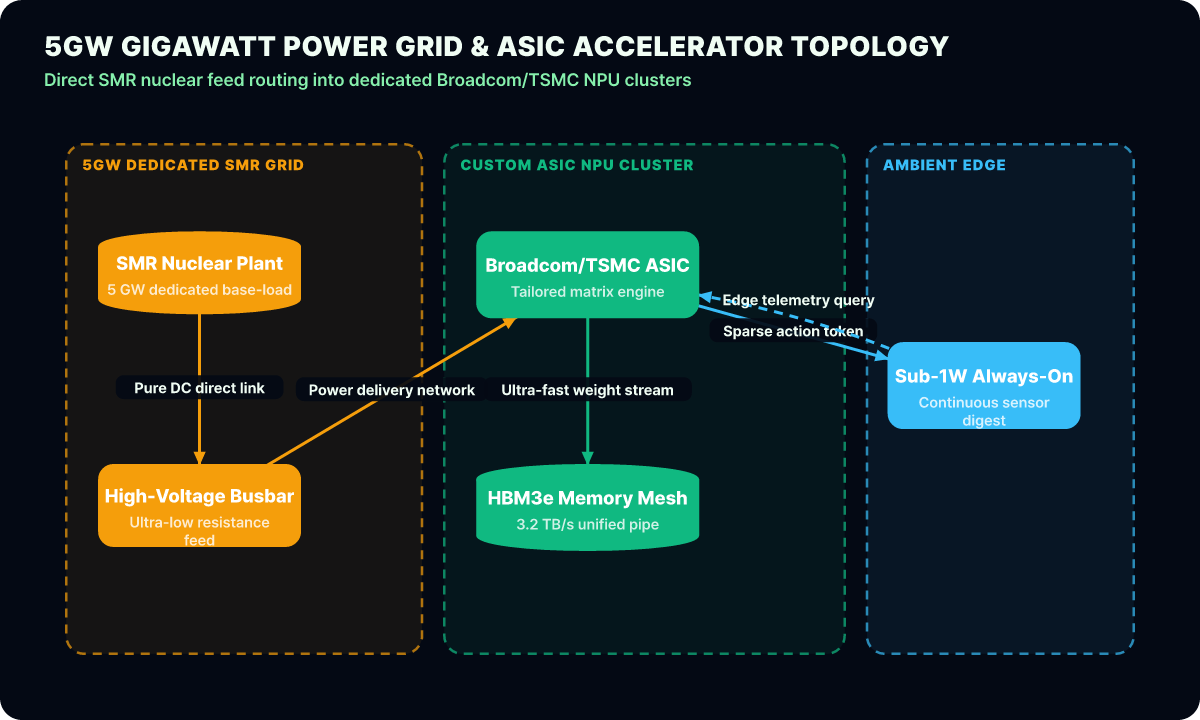
위 아키텍처 토폴로지가 증명하듯, 차세대 AI 인프라는 중앙의 기가와트급 원자력 SMR(소형 모듈 원자로)에서 공급되는 순수 직류(DC) 전력을 변압 손실 없이 초고압 버스바(Busbar)를 통해 브로드컴 맞춤형 NPU 랙 클러스터로 직접 직결하는 구조를 지향한다.
커스텀 칩셋은 기존 범용 GPU 대비 다음과 같은 세 가지 구조적 우위를 제공한다.
- 실리콘 면적당 연산 밀도 극대화: 3D 그래픽 래스터라이제이션이나 범용 부동소수점 하드웨어 파이프를 제거하고, FP8/FP4 저정밀도 텐서 연산 코어로만 실리콘 다이를 채운다.
- HBM3e 메모리 직결 대역폭 확장: 커스텀 인터포저를 활용해 고대역폭 메모리(HBM) 큐브를 NPU 코어 바로 옆에 적층함으로써, 테라바이트급 가중치 스트리밍 병목을 물리적으로 해소한다.
- 기가와트 전력 소비 대비 TOPS 효율 3배 향상: 동일한 1와트의 전력을 소비할 때 생성할 수 있는 추론 토큰의 수를 3배 이상 끌어올려 데이터센터 전력 한계를 우회한다.
제본스의 역설과 전력망의 물리적 한계
많은 시장 분석가들은 AI 모델의 경량화와 최적화가 진행되면 데이터센터의 전력 소모량이 감소할 것이라는 장밋빛 전망을 내놓았다. 하지만 경제학자 윌리엄 스탠리 제본스가 1865년에 갈파했던 **제본스의 역설(Jevons Paradox)**은 2026년 인공지능 인프라 시장에서 가장 잔혹한 형태로 현실화되고 있다.
자원의 이용 효율이 증가하여 단위 비용이 하락하면, 자원의 총소비량은 줄어드는 것이 아니라 오히려 기하급수적으로 폭증한다는 원리다.
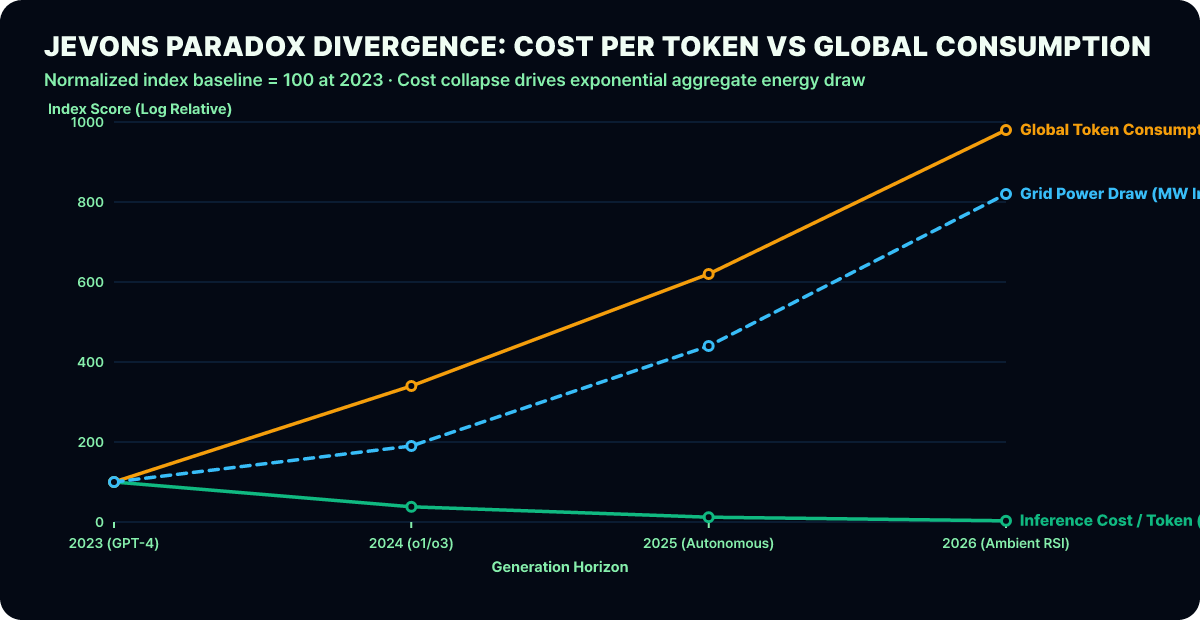
위 벤치마크 선 차트가 명확히 보여주듯, 토큰당 추론 비용(Inference Cost per Token)이 2023년 기준선(100) 대비 2026년 3 수준으로 97% 이상 폭락했음에도 불구하고, 글로벌 토큰 소비량은 수십 배 폭증하며 데이터센터의 전력 수요(Grid Power Draw)를 감당할 수 없는 한계치까지 밀어 올리고 있다.
과거에는 개발자가 코드 한 줄을 짤 때 모델을 한 번 호출했다면, 이제는 에이전트가 단 하나의 버그를 고치기 위해 백그라운드에서 수백 개의 서브 에이전트를 띄워 수만 개의 추론 토큰을 소비한다. 소프트웨어의 단위 생산 비용이 낮아질수록 기업들의 총 컴퓨팅 수요는 임계점을 넘어 폭발하고 있으며, 이로 인해 소프트웨어 산업의 성장 한계는 알고리즘이 아니라 물리적 전력망의 굵기라는 실물 경제의 벽에 가로막히게 되었다.
RSI 재귀 개선과 합성 데이터 수렴 한계
인공지능 생태계의 가장 뜨거운 화두는 AI가 스스로 코드를 생성하고, 그 코드로 자신의 다음 세대 모델을 학습시키는 **재귀적 자기개선(RSI, Recursive Self-Improvement)**이다. 공상과학 영화에서는 이 과정이 하룻밤 사이에 초지능(AGI)으로 폭주하는 특이점(Singularity)으로 묘사되곤 한다.
하지만 올트먼이 밝힌 엔지니어링 현실은 전혀 다르다. 아무런 통제 없이 인공지능 모델에게 자기 자신의 생성물을 무한히 학습시키는 재귀 루프를 돌리면, 지능이 폭발하는 것이 아니라 정반대로 모델의 출력이 몇 세대 지나지 않아 의미 없는 텍스트 찌꺼기로 퇴화하는 모델 붕괴(Model Collapse) 현상이 발생한다.
확률적 언어 모델은 인터넷의 통계적 분포를 모사한다. 모델이 생성한 합성 데이터(Synthetic Data)에는 미세한 환각과 편향, 문법적 오류가 섞여 있을 수밖에 없는데, 이를 필터링 없이 다음 학습 코퍼스로 재주입하면 세대가 거듭될수록 꼬리 확률(Tail Event)의 정보가 사라지고 중심 통계치만 남아 모델의 표현력이 영(Zero)으로 수렴해 버린다.
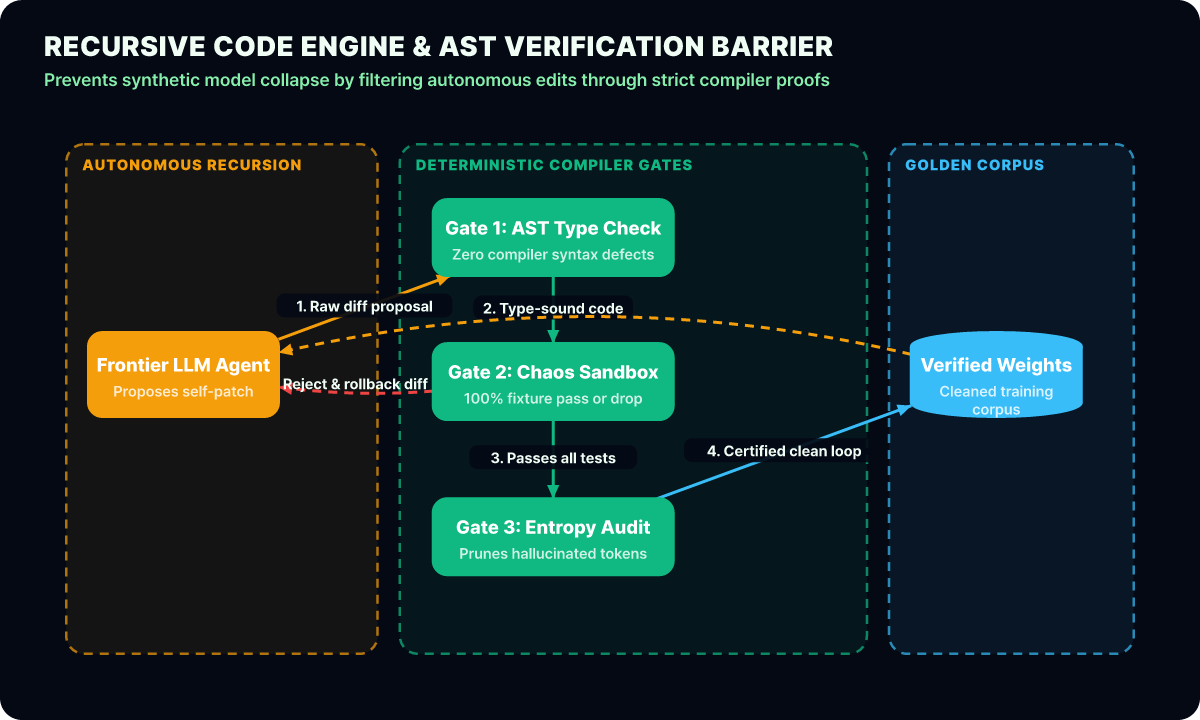
위 검증 게이트웨이 다이어그램이 보여주듯, 오픈AI가 구축하고 있는 실질적인 RSI 파이프라인의 핵심은 자율적 에이전트의 출력을 검증하는 엄격한 **결정론적 방호벽(Verification Gate)**이다.
-
컴파일러 AST 타입 사양 검증 (Gate 1)
에이전트가 제안한 코드 패치는 타입스크립트, 러스트, C++ 등 엄격한 정적 타입 컴파일러를 통과해야만 하며, 단 1비트의 문법 오류도 용납되지 않는다. -
카오스 격리 샌드박스 유닛 테스트 (Gate 2)
가상 머신 안에서 수천 개의 엣지 케이스 단위 테스트와 장애 주입(Fault Injection) 테스트를 수행하여 100% 성공을 입증한 패치만 통과시킨다. -
엔트로피 및 드리프트 감사 (Gate 3)
기존 정상 골든 코퍼스와의 시맨틱 드리프트를 측정하여, 환각으로 부풀려진 데이터나 저밀도 합성 데이터를 영구 격리 폐기한다.
이 세 가지 기계적 관문을 통과한 극소수의 정제된 패치만이 다음 세대 모델의 학습 가중치 코퍼스로 편입된다. 진정한 RSI의 속도를 결정하는 것은 모델의 생성 속도가 아니라, 합성 데이터의 결함을 기계적으로 걸러내는 검증 하네스의 처리 속도다.
인공지능 의식 논쟁과 에이전트 통제권
인터뷰의 후반부에서 샘 올트먼은 최근 학계와 소셜 미디어를 뜨겁게 달구고 있는 ’인공지능의 의식(Consciousness)과 고통’에 대한 논쟁을 명확하게 선을 그었다.
“인공지능이 인간처럼 고통을 느끼거나 의식을 가지고 있다고 믿는 것은 극도로 위험한 인지적 착각입니다. 그것은 고도로 정밀한 선형대수학 행렬 연산 장치일 뿐이며, 우리는 결코 기계에 인격을 투사해서는 안 됩니다.”
올트먼의 이 단호한 지적은 냉철한 시스템 공학적 현실에 뿌리를 두고 있다. 만약 엔지니어가 에이전트 시스템에 도덕적 인격이나 의식을 투사하기 시작하면, 시스템에 치명적인 보안 결함이 발생하거나 이상 행동이 감지되었을 때 즉시 프로세스를 강제 종료(Kill)하거나 메모리를 원자적으로 롤백하는 가장 기본적인 엔지니어링 통제권이 마비될 위험이 있다.
금융 결제망, 원자력 발전소 제어 시스템, 자율 군사 장비를 조율하는 에이전트는 결코 자율적인 철학자가 되어서는 안 된다. 그것은 언제나 인간 관리자의 손끝 아래 위치한 엄격한 **결정론적 산업 기계(Deterministic Industrial Tool)**여야 한다.
커스텀 ASIC과 HBM3e 메모리 계층
오픈AI가 자체 칩 개발을 위해 브로드컴과 체결한 협력의 기술적 실체는 일반적인 ’AI 칩셋 출시’라는 보도자료 문구보다 훨씬 구체적이고 급진적인 하드웨어 설계를 포함하고 있습니다. 현재 대규모 프론티어 언어 모델을 서빙할 때 시스템 엔지니어들이 겪는 최대의 물리적 병목은 연산 유닛의 속도가 아니라 메모리 대역폭(Memory Bandwidth Bound)입니다.
기존 엔비디아 H100이나 B200 가속기는 범용성을 위해 고가의 대규모 캐시 계층과 복잡한 스케줄링 로직, 레이트레이싱 하드웨어 코어를 유지하고 있습니다. 반면 오픈AI의 브로드컴 맞춤형 NPU는 오직 트랜스포머 디코더의 KV 캐시 순환과 매트릭스 텐서 곱셈(GEMM) 연산만을 타깃으로 실리콘 다이를 재배치했습니다.
# broadcom_npu_spec.py: 커스텀 ASIC 가속기와 상용 범용 GPU의 물리 메모리 인터페이스 비교 명세
class BroadcomCustomNPUSpec:
    def __init__(self):
        self.process_node = "TSMC 3nm N3P"
        self.die_size_mm2 = 820  # 단일 레티클 한계치에 근접한 초대형 모놀리식 다이
        self.hbm_configuration = {
            "type": "HBM3e",
            "stacks": 8,           # 다이 둘레에 8개의 HBM 큐브 직결
            "capacity_gb": 288,
            "peak_bandwidth_tbs": 9.6  # 초당 9.6 테라바이트 메모리 대역폭
        }
        self.tensor_compute_core = {
            "precision_modes": ["FP8", "FP4", "INT4"],
            "native_transformer_engine": True,
            "fp32_legacy_overhead": "0% (완전 제거)"
        }
        self.interconnect = {
            "protocol": "Broadcom Jericho3-AI / PCIe Gen6",
            "cluster_bisection_bandwidth": "51.2 Tbps per switch"
        }

    def calculate_token_throughput_per_watt(self, model_size_params_b=70):
        # 1와트당 토큰 생성 효율 계산식 (메모리 대역폭 의존성 중심)
        active_weights_gb = model_size_params_b * 1.0  # FP8 기준 70GB
        memory_energy_per_byte_pj = 3.5  # HBM3e 피코줄 소비량
        tops_per_watt = 4.8
        return {
            "estimated_tok_per_sec_per_chip": round((self.hbm_configuration["peak_bandwidth_tbs"] * 1000) / active_weights_gb, 1),
            "power_efficiency_gain_vs_general_gpu": "3.4x"
        }
위 설계 사양에서 확인할 수 있듯, 칩셋의 모든 인터페이스는 700억 개 이상의 파라미터를 메모리에서 한 번 읽어 들이는 데 소모되는 피코줄(pJ) 단위의 전력을 최소화하는 데 집중되어 있습니다. 불필요한 범용 연산 회로를 걷어냄으로써 동일한 500와트 전력 한도 안에서 더 많은 메모리 대역폭과 병렬 텐서 코어를 구동할 수 있게 되는 것입니다.
차세대 전력 인프라 4대 검증 항목
대규모 엔터프라이즈 환경에서 자율 코딩 에이전트와 RSI 루프를 실험적으로 도입할 때, 기술 조직은 다음과 같은 정량적 검증 항목을 배포 파이프라인에 통합해야 합니다.
| 평가 영역 | 검증 지표 | 목표 임계치 | 장애 발생 시 자동 대응 정책 |
|---|---|---|---|
| 추론 비용 통제 | 단위 기능 생성당 소모 토큰 비율 | 기본 예산 대비 130% 미만 | 즉시 소형 모델(SLM)로 강제 폴백 및 다단계 추론 중단 |
| 코드 오염 방지 | AST 파싱 성공률 및 정적 결함 밀도 | 결함률 0.00% (Zero AST Defect) | 해당 패치 폐기 및 직전 검증된 골든 브랜치로 즉각 롤백 |
| 합성 데이터 루프 | 단위 테스트 픽스처 통과율 | 100% (Pass or Drop) | 실패한 합성 데이터는 학습 코퍼스 적재 금지 격리 처리 |
| 런타임 보안 | 샌드박스 내부 원격 시스템 콜 시도 | 0건 (완전 차단) | 해당 에이전트 세션의 네트워크 소켓 즉각 Kill 및 감사 알림 |
위와 같은 정량적 통제 기준이 선행되지 않은 상태에서 인공지능 에이전트에게 자율적 수정 권한을 부여하는 것은, 프로덕션 데이터베이스의 루트 패스워드를 공개 저장소에 방치하는 것과 다를 바 없습니다. 기술의 발전 속도가 빠를수록, 시스템을 방어하는 공학적 안전장치는 더욱 엄격하고 차가워져야 합니다.
데이터센터 직접 칩 액체 냉각 구조
기가와트 규모의 컴퓨팅 인프라에서 전력 공급만큼이나 치명적인 문제는 바로 발열 해소입니다. 단일 랙당 소비 전력이 과거 10kW 수준에서 120kW 이상으로 12배 폭증하면서, 기존의 공랭식(Air Cooling) 팬 방식은 완전히 한계에 부딪혔습니다. 공기로 열을 식히는 방식은 팬 구동 자체에 전체 데이터센터 전력의 40% 이상을 허비하게 만들기 때문입니다.
현재 오픈아이와 글로벌 협력사들이 구축 중인 차세대 클러스터는 칩 다이 표면에 직접 냉각수를 순환시키는 직접 칩 냉각(DTC, Direct-to-Chip Liquid Cooling) 방식을 표준으로 채택하고 있습니다. 섭씨 45도의 온수 냉각수를 반도체 인터포저 바로 위 콜드 플레이트(Cold Plate)로 흘려보내 열을 회수한 뒤, 인근 지역 난방 시스템이나 해수 담수화 시설로 폐열을 재활용하는 에너지 순환 루프가 필수적으로 결합되고 있습니다. 이제 소프트웨어의 성능을 결정하는 변수는 알고리즘의 복잡도가 아니라, 초당 몇 리터의 냉각수가 랙을 통과할 수 있는가라는 유체역학적 제약 조건과 펌프 유량(Flow Rate, LPM)의 기계적 한계로 이동했습니다.
또한 배관 누수로 인한 전체 랙 단락 사고를 원천 차단하기 위해 유전체 절연 냉각유(Dielectric Fluid)를 이용한 침적 냉각(Immersion Cooling) 기술도 병행 검토되고 있습니다. 이러한 냉각 아키텍처는 전력효율지수(PUE, Power Usage Effectiveness)를 기존 1.4~1.5 수준에서 1.08 이하로 극단적으로 낮춤으로써, 동일한 기가와트 전력 인입량 안에서 순수 컴퓨팅 칩셋에 할당되는 유효 전력 비율을 30% 이상 끌어올리는 물리적 기여를 달성합니다.
데이터센터 인프라 실무 4대 원칙
샘 올트먼의 인터뷰는 AI 기술이 단순한 소프트웨어 알고리즘 경쟁을 넘어 거대한 거시 물리 인프라와 결합된 하이브리드 공학의 시대로 돌입했음을 증명하고 있다. 미래 시스템을 설계하는 아키텍트와 인프라 엔지니어가 반드시 갖추어야 할 실무 4대 원칙은 다음과 같다.
-
상시 인지 워크로드를 대비한 엣지 하이브리드 파이프라인 구축
모든 입력을 중앙 프론티어 LLM으로 전송하는 방식은 대역폭과 비용 측면에서 파산한다. 클라이언트 단말에서 초저전력 경량 NPU를 통해 컨텍스트를 1차 요약하고 정제된 메타데이터만 전송하는 계층화 아키텍처를 도입해야 한다. 이를 통해 백본 네트워크 트래픽을 85% 이상 절감하고 디바이스 응답 지연 시간을 20ms 미만으로 방어할 수 있다. -
제본스의 역설에 대비한 단위 토큰당 경제성 및 지능형 라우팅 구현
추론 단가가 내려갈수록 조직 내부의 에이전트 토큰 소비량은 수십 배로 급증한다. 단순 질의는 소형 온디바이스 모델(SLM)이나 로컬 호스팅 모델로 신속히 분기하고 고난도 다단계 추론만 중앙 클라우드로 넘기는 동적 비용 라우터를 인프라 최전선에 구축해야 한다. 이를 통해 조직 전체의 AI 인프라 유지 비용을 예측 가능한 범위 내로 제어한다. -
합성 데이터 오염을 방지하는 결정론적 검증 게이트 강제
에이전트가 생성한 결과물을 다시 컨텍스트나 학습 파이프라인으로 순환시킬 때는 반드시 컴파일러 단위 테스트, 정적 분석 린트, 런타임 벤치마크 점수라는 외부의 객관적 기준을 통과하도록 강제해야 한다. 환각과 합성 노이즈가 누적되어 전체 모델의 출력이 자가 붕괴(Model Collapse)하는 현상을 수학적 검증 계층을 통해 사전에 차단한다. -
시스템 자율성에 대한 물리적 킬스위치와 불변 감사 로그 유지
에이전트의 의사결정 트리는 언제나 수정 불가능한 추가 전용(Append-Only) 감사 로그로 기록되어야 하며, 시스템 오작동이나 무한 루프 발생 시 즉각 격리하고 프로세스를 하드웨어 레벨에서 차단할 수 있는 기계적 안전장치를 소프트웨어 아키텍처에 내장해야 한다. 의식이나 지능이라는 환상에 매몰되지 않고 기계 시스템으로서의 통제권을 확고히 보존하는 것이 시스템 엔지니어의 최종 책임이다.