GPT-6 Astra 출력은 100만 토큰에 50달러, Sol의 5배인데 언제 쓸까
GPT-6 Astra는 입력이 272K 토큰을 넘으면 요청 전체 단가가 오르고, 캐시 유무로 20번 호출 요금이 22달러와 6달러로 갈립니다. 처리 방식·옮길 때 깨지는 호출·감시를 계산으로 정리했습니다.
계약서 분석 기능을 GPT-6 Astra로 돌리는 서비스가 있다고 가정해 봅시다(편집부가 만든 장면입니다). 어제까지 27만 토큰짜리 계약서 묶음에 질문 하나를 던지면 요청 한 건이 3.20달러였는데, 오늘 부속 합의서 한 건을 더 붙여 28만 토큰이 되자 같은 질문이 6.35달러가 되었습니다. 입력은 3.7% 늘었고 요금은 98% 늘었습니다. 코드의 버그가 아니라 가격표에 들어 있는 계단입니다. 단가표의 “입력 $10, 출력 $50”만 보고 예산을 짜면 이런 계단을 지나는 순간 청구서가 예상과 달라집니다.
이 글은 OpenAI 개발자 문서의 가격 페이지, 모델 페이지, 프롬프트 캐싱·Fast 모드·비동기 도구 호출 가이드와 변경 기록을 2026-10-27에 다시 읽고, Astra의 청구서를 계산으로 풀어 본 것입니다. 단가 비교는 한 줄이면 끝납니다. 같은 계열의 GPT-6.1 Sol보다 입력·출력 모두 5배라는 것이 전부입니다. 실제 청구서는 입력 길이, 처리 방식, 캐시, 호출 횟수가 곱해져서 나오므로, 이 곱셈을 하나씩 계산해 봅니다. 요청 한 건 계산은 입력 단가와 출력 단가에 토큰 수를 곱한 편집부 계산이고, 출력은 추론 토큰을 포함한 값입니다.
27만과 28만 토큰 사이의 계단
Astra의 컨텍스트 창은 1,050,000 토큰이고 최대 입력은 922,000 토큰, 최대 출력은 128,000 토큰입니다. 가격 페이지는 입력이 272K 토큰 이하인 요청을 짧은 문맥, 넘는 요청을 긴 문맥으로 가릅니다. 긴 문맥 요청은 초과분만이 아니라 요청 전체가 입력과 캐시 단가 2배, 출력 단가 1.5배로 계산됩니다. 표준 처리에서 Astra는 입력 $10가 $20, 출력 $50가 $75가 됩니다.
출력을 1만 토큰으로 고정하고 입력 길이만 바꾸면 요청 한 건의 값이 어떻게 변하는지 그린 것이 아래 그림입니다. 파란 선이 Astra, 점선은 계단이 없었다면 이어졌을 선입니다.
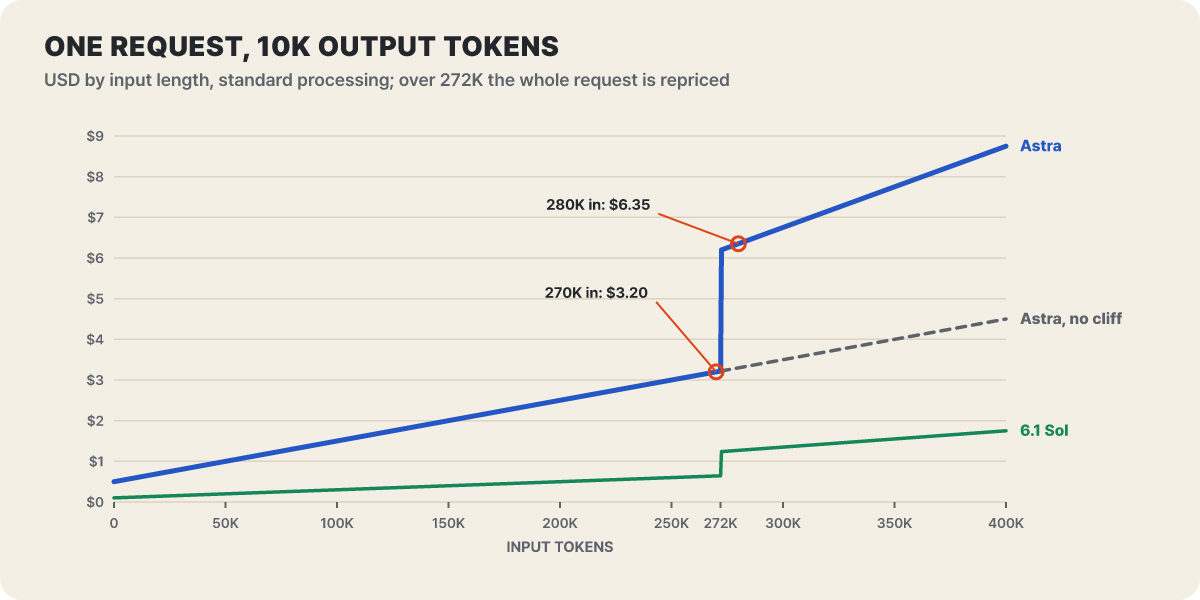 그림 1. 출력 1만 토큰 고정, 표준 처리 요청 한 건의 값. 가격 페이지의 단가로 편집부 계산
점선과 파란 선 사이의 세로 간격이 계단의 높이입니다. 272K 바로 아래의 3.22달러가 바로 위에서는 6.19달러가 되고, 그 위쪽은 기울기도 2배로 가팔라집니다. 초록색 6.1 Sol도 같은 모양의 계단이 있지만 높이는 5분의 1입니다. 입력 최대치가 922K라서 계단 위쪽 구간이 650K 토큰 폭으로 열려 있다는 점도 눈여겨볼 만합니다.
계단은 Astra만의 규칙이 아닙니다. 6.1 Sol, 6.1 Terra, Luna의 모델 페이지와 가격 페이지에도 같은 배율이 적혀 있고, 배치와 Fast, Ultrafast 줄에도 긴 문맥 단가가 따로 있습니다. 그래서 모델을 내려도 경계 위치는 그대로입니다. 긴 문서를 통째로 넣는 호출이라면 모델을 바꾸기 전에 입력을 272K 안으로 줄일 수 있는지가 첫 번째 질문입니다.
처리 방식과 모델을 곱한 요청 한 건의 값
처리 방식은 표준, 배치·Flex, Fast, Ultrafast 네 가지입니다. 배치와 Flex는 표준의 50%, Fast는 2배, Astra와 6.1 Sol의 Ultrafast는 6배이고, 6.1 Terra와 Luna는 가격 페이지에 Ultrafast 줄이 없습니다. 같은 요청(입력 10만, 출력 1만)을 모델 네 개와 방식 네 개에 얹으면 가장 싼 칸과 가장 비싼 칸이 1,200배 차이가 납니다. 색은 로그 눈금이라 진한 칸일수록 비쌉니다.
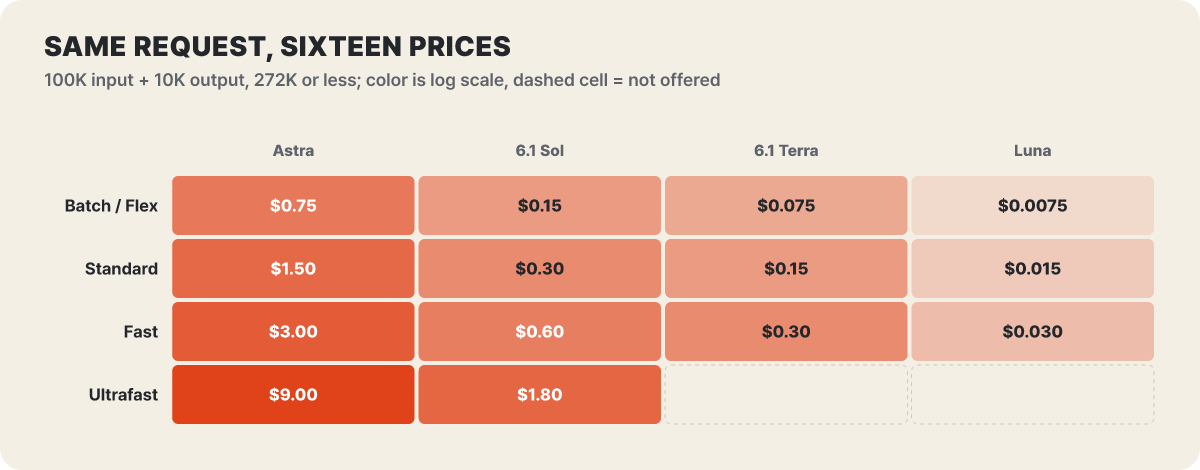 그림 2. 입력 10만 + 출력 1만 토큰(272K 이하)의 방식별 요금. 점선 칸은 가격 페이지에 없는 조합. 편집부 계산
세로로 읽으면 방식이 값을 어떻게 바꾸는지, 가로로 읽으면 모델이 값을 어떻게 바꾸는지 보입니다. Astra의 표준($1.50)은 6.1 Sol의 Fast($0.60)보다 비쌉니다. 빠르게 받고 싶어서 Fast를 켜는 대신 모델을 한 단계 내리는 쪽이 값은 더 싸게 나오는 구간입니다. 여기에 272K 계단을 겹치면 Astra 한 요청의 값은 다음처럼 벌어집니다.
| Astra, 100만 토큰당 | 272K 이하 입력 · 출력 | 272K 초과 입력 · 출력 | 27만 입력 + 1만 출력 | 28만 입력 + 1만 출력 |
|---|---|---|---|---|
| 배치·Flex | $5 · $25 | $10 · $37.5 | $1.60 | $3.18 |
| 표준 | $10 · $50 | $20 · $75 | $3.20 | $6.35 |
| Fast | $20 · $100 | $40 · $150 | $6.40 | $12.70 |
| Ultrafast | $60 · $300 | $120 · $450 | $19.20 | $38.10 |
마지막 두 열은 편집부 계산입니다. 어느 방식에서도 경계를 넘으면 값이 두 배가 되고, Ultrafast에서는 부속 합의서 한 장이 요청 한 건에 19달러 가까운 차이를 만듭니다. 방식을 고르는 일과 입력 길이를 지키는 일은 따로가 아니라 곱해집니다.
방식마다 값 말고도 걸린 조건이 있습니다.
- Fast는 요청에
service_tier: "fast"를 넣어 쓰고, 변경 기록은 GPT-5.6 Sol에서 최대 2.5배 빠르고 값은 2배라고 소개했습니다. 문서는 Astra의 Fast에 지연 시간 보장(SLA)이 없다고 밝힙니다. 같은 모델의 표준 처리와 한도를 공유하고, 입력 토큰이 분당 100만에 닿은 뒤에는 15분마다 50% 이하로만 늘릴 수 있습니다. 증가 한도에 걸려 밀린 요청은service_tier: "default"로 돌아와 표준 요금이 청구됩니다. 지역 데이터 거주는 Astra의 Fast에서 지원하지 않고 6.1 Sol의 Fast에서는 지원합니다. - Ultrafast는
service_tier: "ultrafast"로 출력 토큰 사이의 간격을 줄이는 등급입니다. 문서는 연결을 유지하는 WebSocket을 강하게 권하는데, 도구를 빠르게 여러 번 부르는 에이전트에서 매번 새로 연결하면 네트워크 오버헤드가 이득을 깎기 때문입니다. Astra의 Ultrafast는 지역 거주를 지원하지 않는다고 9월 29일 변경 기록이 밝혔고, 6.1 Sol의 Ultrafast(10월 8일)는 글로벌 처리와 지역 거주를 지원합니다. 10월 16일부터 Agents API에서도agent.service_tier를ultrafast로 둘 수 있습니다. - 지역 처리(데이터를 특정 지역에서만 처리하는 옵션)는 2026년 3월 5일 이후 출시된 모델에 10% 가산이 붙습니다.
Ultrafast의 처리량 한도는 표준과 별도로 정해지고 훨씬 좁습니다. 모델 페이지와 Ultrafast 가이드가 정리한 Astra의 분당 토큰 한도는 다음과 같습니다.
| 등급 | 표준 | Ultrafast | Ultrafast ÷ 표준 |
|---|---|---|---|
| Build | 100만 | 50만 | 1/2 |
| Launch | 400만 | 100만 | 1/4 |
| Grow | 4,000만 | 500만 | 1/8 |
값이 6배인데 한도는 최대 8분의 1이므로, 대량 트래픽을 Ultrafast로 몰 수는 없습니다. 반대로 Ultrafast는 표준 한도를 쓰지 않으니 사람이 기다리는 짧은 경로만 Ultrafast로 보내고 나머지를 표준이나 배치로 돌리는 분리 설계가 가능합니다.
스무 번 호출하는 코딩 에이전트의 청구서를 한 줄씩
에이전트는 한 번 일하는 동안 요청을 수십 번 보내고, 매번 앞의 대화와 도구 정의를 통째로 다시 보냅니다. 입력이 사실상 같은 앞부분의 반복이므로 청구서에서 가장 큰 칸이 입력이 됩니다. 프롬프트 캐시는 이 같은 앞부분(접두)을 알아보고 읽기 요금으로 싸게 처리해 주는 장치이고 지원 모델에서 기본으로 켜져 있습니다. GPT-5.6 이후 모델의 캐시 요금은 입력 단가의 배수입니다. 읽기는 0.1배(6.1 Sol과 6.1 Terra는 0.05배), 30분 쓰기는 1.25배, 12시간 쓰기는 2.5배이고, 한 토큰은 일반 입력, 캐시 읽기, 캐시 쓰기 중 한 가지 요금만 냅니다.
다음 가정으로 계산합니다(편집부 가정입니다).
- 저장소 하나를 두고 같은 에이전트가 20번 호출한다
- 호출마다 입력이 10만 토큰이고, 그중 앞쪽 9만 5천 토큰은 매번 같다
- 새로 붙는 입력은 호출마다 5천 토큰, 출력은 2천 토큰이다
- 캐시를 쓰는 경우 첫 호출에서 30분 쓰기를 한 번 하고, 나머지 19번은 30분 안에 읽는다
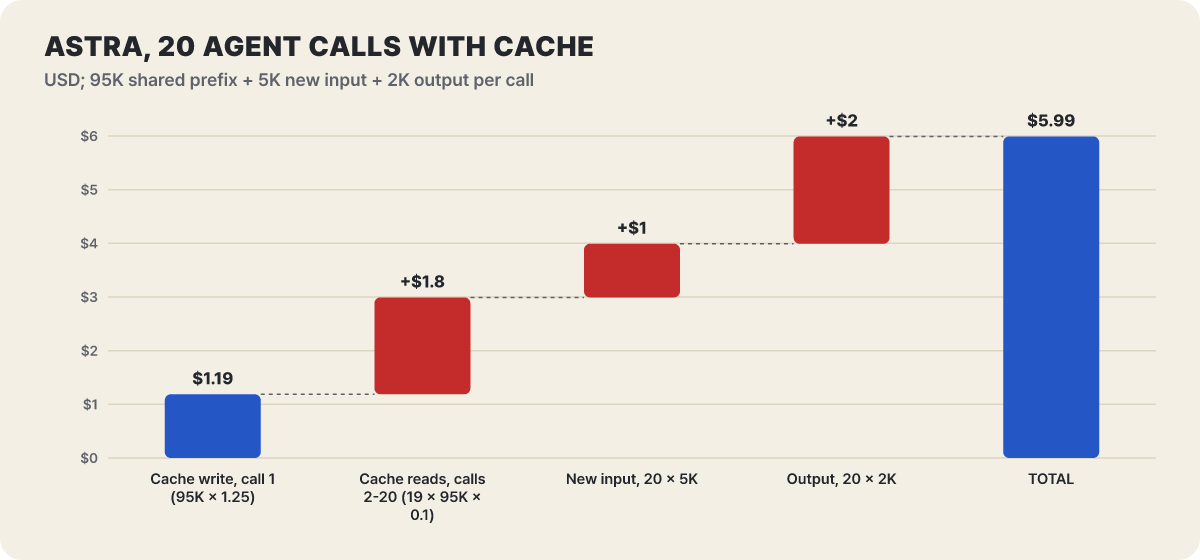 그림 3. 캐시를 쓴 Astra 20번 호출의 총액이 네 항목으로 쌓이는 과정. 편집부 계산
가장 큰 항목은 출력의 2달러입니다. 캐시가 20번 반복되는 앞부분 입력(캐시 없이 19달러)을 3달러 안쪽(쓰기와 읽기)으로 줄여 주었는데도 입력 쪽 항목(쓰기, 읽기, 새 입력)을 합치면 4달러에 가까워서, 청구서의 3분의 2는 여전히 입력이 만듭니다. 읽기 한 칸이 1.8달러라는 점도 보세요. 읽기가 입력 단가의 10분의 1이어도 19번 쌓이면 새 입력 20번분(1달러)보다 큽니다. 캐시는 입력을 지우는 장치가 아니라 입력을 한 자릿수 싼 요금으로 바꾸는 장치입니다.
같은 호출을 캐시 없이 돌리면 어떨까요. 네 모델에 모두 적용해 본 것이 아래 그림입니다.
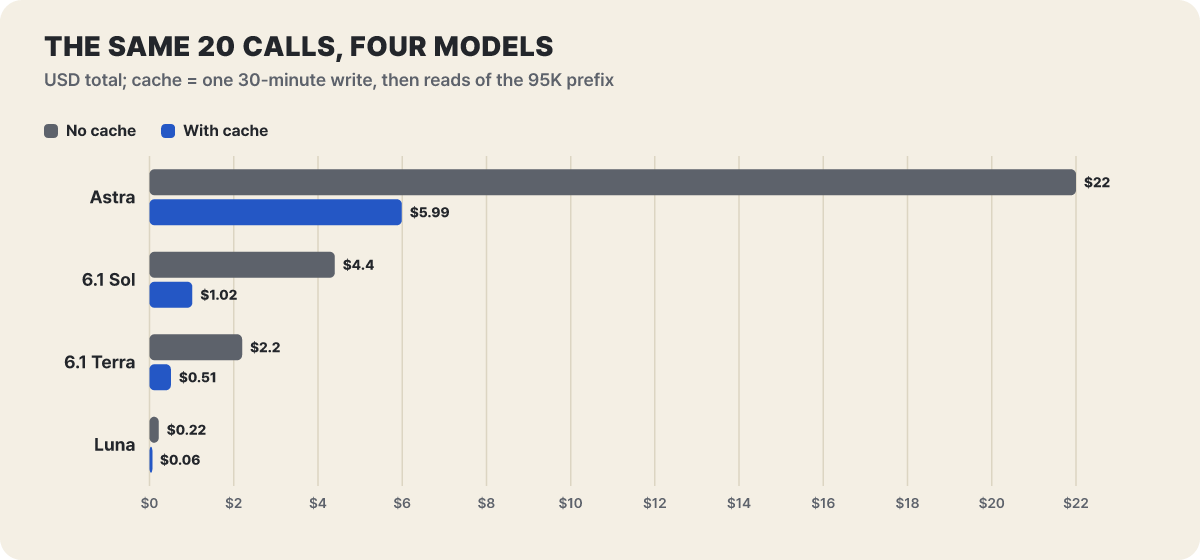 그림 4. 같은 20번 호출의 총액, 캐시 없음 대 캐시 있음. 편집부 계산
캐시만으로 Astra는 22달러에서 5.99달러로, 73% 줄어듭니다. 그런데 캐시를 쓰는 Astra(5.99달러)가 캐시 없는 6.1 Sol(4.40달러)보다 여전히 비쌉니다. 모델 선택과 캐시 설계는 둘 중 하나를 고르는 일이 아니라 곱해지는 일이고, Astra를 쓰려면 캐시를 잘 쓰는 것이 필수이며 캐시를 잘 써도 모델을 내린 쪽이 더 쌀 수 있다는 것이 이 그림의 결론입니다.
같은 루프가 30만 토큰으로 커지면
에이전트는 일을 하면서 컨텍스트가 커집니다. 위 계산의 입력 10만 토큰이 30만 토큰으로 자라면 272K 계단을 넘고, 20번 호출 전체가 긴 문맥 단가로 계산됩니다. 앞부분 28만 5천 토큰이 같고 새 입력이 1만 5천 토큰, 출력이 호출마다 2천 토큰이라는 가정으로 세 경우를 나란히 놓았습니다.
| Astra, 20번 호출(출력 호출마다 2천) | 캐시 없음 | 캐시 있음 |
|---|---|---|
| 입력 10만 (앞부분 9만 5천) | $22.00 | $5.99 |
| 입력 30만 (앞부분 28만 5천), 272K 초과 | $123.00 | $26.96 |
| 입력 27만 (앞부분 25만 5천), 272K 이하 | $56.00 | $13.03 |
컨텍스트가 3배가 되었는데 캐시를 쓴 청구서는 4.5배($5.99 → $26.96)가 되었습니다. 단가가 2배로 올라서입니다. 컨텍스트에서 3만 토큰을 덜어 27만으로 맞추면 청구서가 $26.96에서 $13.03으로 절반이 됩니다. 오래된 도구 출력이나 이미 처리한 파일 내용을 압축하거나 잘라 내는 작업에 쓰는 시간은 모델 호출 비용으로 곧바로 돌아옵니다. 다만 압축은 접두를 바꾸므로 캐시를 새로 써야 하고, 그 값은 위 표의 쓰기 항목에 이미 들어 있습니다.
캐시가 이기는 횟수와 깨지는 순간
캐시가 이득이 되려면 같은 앞부분을 몇 번 읽어야 할까요. 문서가 든 예는 30분 쓰기 한 번과 읽기 한 번이 입력 단가의 1.35배(캐시 없이 두 번이면 2배), 쓰기 한 번과 읽기 아홉 번이 2.15배(캐시 없이 열 번이면 10배)입니다. 이 구조를 입력 단가 1배를 기준으로 요청 횟수별로 풀면 이렇습니다.
| 같은 앞부분으로 보낸 요청 | 캐시 없음 | 30분 쓰기 + 읽기 (Astra) | 30분 쓰기 + 읽기 (6.1 Sol) | 12시간 쓰기 + 읽기 (Astra) |
|---|---|---|---|---|
| 1번 | 1 | 1.25 | 1.25 | 2.5 |
| 2번 | 2 | 1.35 | 1.30 | 2.6 |
| 5번 | 5 | 1.65 | 1.45 | 2.9 |
| 10번 | 10 | 2.15 | 1.70 | 3.4 |
| 20번 | 20 | 3.15 | 2.20 | 4.4 |
앞부분을 한 번밖에 못 쓸 요청이라면 캐시는 25% 손해(1.25 대 1)이고, 두 번째 요청부터 이득이 시작됩니다. 12시간 쓰기는 2.5배로 시작하니 같은 앞부분을 하루 동안 여러 번 읽는 경우에만 어울립니다. 변경 기록은 10월 20일에 12시간 보관을 추가하면서 이 2.5배를 명시했습니다.
12시간 보관이 가장 값진 경우는 요청 간격이 30분을 넘는 서비스입니다. 읽을 때마다 그 시점부터 최소 30분 더 유지되지만, 요청이 40분 간격이면 30분 캐시는 매번 만료되어 읽기 없이 쓰기만 반복합니다. 같은 앞부분으로 요청 10번이 40분 간격으로 들어온다고 하면 30분 보관은 1.25배가 열 번이라 12.5배(캐시 없이 10배보다 비쌈), 12시간 보관은 2.5 + 0.1 × 9 = 3.4배입니다(편집부 계산). 서비스의 요청 간격이 30분 아래인지 위인지가 보관 시간을 고르는 기준입니다.
캐시가 실제로 먹히는지는 응답의 사용량 항목으로 확인합니다. 문서가 정한 필드와 계산식은 이렇습니다.
usage.input_tokens
usage.input_tokens_details.cached_tokens                          # 읽기(쓰기 토큰 제외)
usage.input_tokens_details.cache_write_tokens                     # 쓰기 합계
usage.input_tokens_details.cache_write_tokens_details.ttl_30m_tokens
usage.input_tokens_details.cache_write_tokens_details.ttl_12h_tokens

일반 입력 = input_tokens - cached_tokens - cache_write_tokens
입력 비용(입력 단가의 배수) = 일반 입력 + cached_tokens × 0.1 + ttl_30m_tokens × 1.25 + ttl_12h_tokens × 2.5
두 보관 시간 필드는 겹치지 않고 합이 cache_write_tokens입니다. 캐시 최소 길이는 눈에 보이는 입력 1,024 토큰이고 OpenAI의 숨은 시스템 지시는 세지 않습니다. 보관 시간은 prompt_cache_options.ttl에 "30m"(기본) 또는 "12h"를 넣어 정하고, 12시간은 최소 수명이지 삭제 시한이 아닙니다. 기본은 가장 최근 메시지 끝에 기록하는 암묵 모드이고, 직접 정하는 명시 모드에서는 요청 하나에 쓰기 지점을 최대 네 곳까지 둘 수 있습니다. prompt_cache_options.prewarm: true는 출력을 만들지 않고 캐시만 채우며, 그 쓰기도 선택한 보관 시간의 쓰기 요금이 붙습니다.
캐시는 접두가 한 글자라도 달라지면 새로 씁니다. 문서가 꼽은 접두를 깨는 변경은 다음과 같습니다.
model,tools(이름·설명·스키마·순서),parallel_tool_calls,text.format,text.verbosity,reasoning.effort, 압축과context_management- 앞선 메시지를 수정하거나 이어 붙이는 일
- 중단점 앞쪽에 넣은 시각이나 사용자별 문구 같은 변하는 내용
캐시는 조직 사이, 지역 처리 경계 사이에서 공유되지 않고, 분당 약 15요청을 넘는 트래픽은 다른 머신으로 넘칠 수 있어서 재사용률이 떨어질 수 있습니다. 캐시된 토큰도 분당 토큰 한도에는 그대로 센다는 점도 알아 두세요. 계산서로서는 싸도 한도 계산에서는 일반 입력과 같습니다.
기다리는 시간을 겹치는 비동기 도구와 도중 정정
청구서는 토큰만이 아니라 기다림도 만듭니다. 사람이 앞에서 기다리는 서비스라면 느린 도구를 한 번 호출할 때마다 모델의 턴이 멈추는 시간이 곧 비용입니다. Astra와 함께 9월 3일에 나온 세 기능은 이 기다림을 겹치기 위한 것입니다. 첫째는 비동기 도구 호출입니다. 도구 정의에 async: true를 넣으면 모델이 호출을 내보낸 뒤에도 턴이 멈추지 않고, 호출과 무관한 부분을 계속 풉니다.
{ "type": "function", "name": "get_weather", "async": true, "strict": true,
  "parameters": { "type": "object", "properties": { "city": { "type": "string" } },
                  "required": ["city"], "additionalProperties": false } }
순서를 그리면 아래와 같습니다. 중요한 점은 도구를 실제로 실행하는 쪽이 여전히 내 애플리케이션이라는 것입니다.
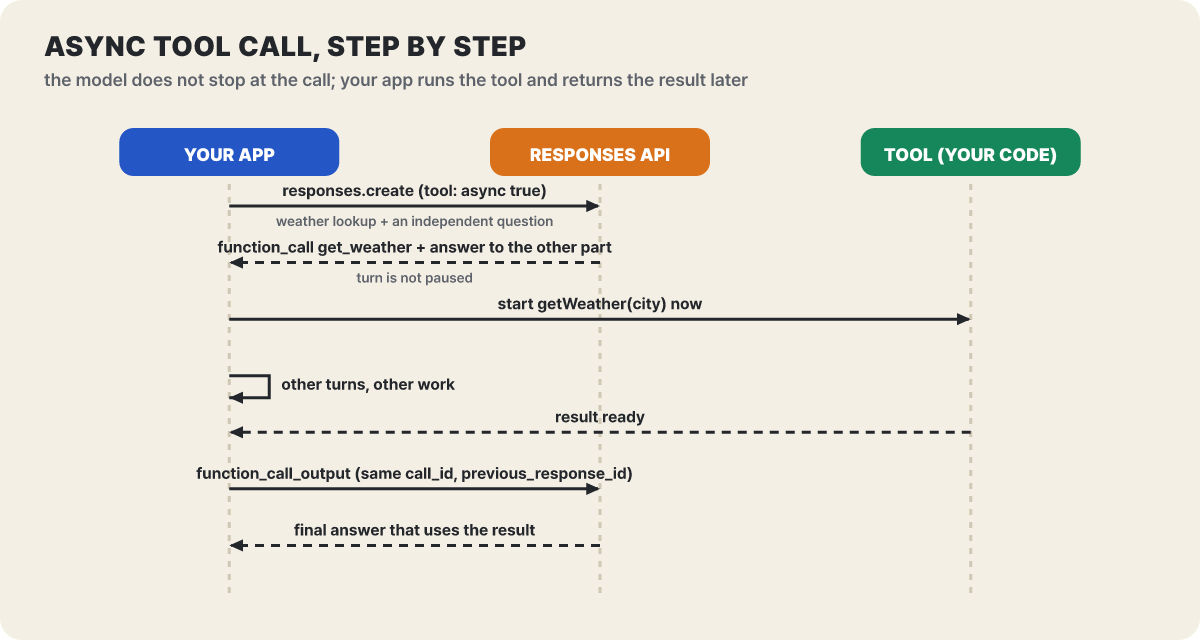 그림 5. async 도구 호출의 요청과 결과. OpenAI는 작업을 대신 돌리거나 관리하지 않는다
세 번째 화살표부터가 앱 쪽 일입니다. 도구는 내 코드가 돌리고, 끝난 결과는 원래 호출의 call_id를 붙여 다음 Responses 요청에 function_call_output(사용자 지정 도구는 custom_tool_call_output)으로 돌려줍니다. 그 사이에 다른 대화 턴이 오가면 가장 최근 응답의 ID를 previous_response_id로 이어 씁니다. 모델이 결과를 꼭 기다려야 하는 순간을 위해 앱이 직접 만든 대기용 함수를 쓰는 패턴을 문서가 소개하는데, 이 함수는 기본 제공이 아닙니다. 제약은 셋입니다. 비동기는 내 앱이 실행하는 함수·사용자 지정 도구에만 해당하고 웹 검색 같은 호스티드 내장 도구에는 적용되지 않습니다. 프로그램형 도구 호출과 함께 쓰지 않으며, 멀티 에이전트 모드에서는 병렬 도구 호출과 합치지 않습니다.
둘째는 작업 중 방향 바꾸기입니다. 응답이 생성되는 도중에 “그 파일은 빼고” 같은 정정을 보내는 기능으로, GPT-6 계열이고 Responses API의 WebSocket 연결일 때만 됩니다. response.create를 보내 response.created를 받은 뒤 같은 연결에서 response.steer(type, previous_response_id, input만 허용)를 보내면 됩니다. 서버가 보내는 이벤트는 순서대로 이렇습니다.
response.steer.accepted    정정이 대기열에 들어감(적용된 것은 아님)
response.incomplete        원래 응답이 끊김, incomplete_details.reason: "steered"
response.completed         서버가 만든 이어지는 응답이 끝남
정정 뒤에 response.create를 또 보내면 안 됩니다. 서버가 현재 출력 항목과 이미 돌던 호스티드 도구 작업을 마친 뒤 이어지는 응답을 알아서 만들기 때문입니다. 정정이 닿는다고 이미 보낸 출력과 이미 한 동작, 이미 시작한 도구가 취소되지는 않습니다. 도구 결과나 승인이 필요한 응답이라면 정정은 대기열에 남고, 원래 응답이 끝난 뒤 response.steer.pending이 required_input을 알려 줍니다. 실패하면 response.steer.failed가 원래 입력을 돌려주며 사유로 steering_not_supported나 too_many_pending_steers 같은 코드가 붙습니다. 연결이 끊기면 대기 중이던 정정은 사라지므로 보낸 정정을 기록해 두었다가 재접속 뒤 이벤트와 대조하고 나서 다시 보내야 합니다. 이 WebSocket 방식 자체는 도구 호출이 20번 이상 이어지는 작업에서 최대 약 40% 빨라진다고 문서가 적고, 연결은 최대 60분 유지되며 한 연결에서 동시에 돌릴 수 있는 응답은 16개입니다.
셋째는 추론 강도의 중간 변경입니다. 최상단 reasoning.effort를 바꾸면 숨은 지시문이 달라져 캐시 접두가 깨지므로, 대화 도중에는 입력 배열에 항목을 덧붙입니다.
{ "type": "configuration_update", "reasoning": { "effort": "low" } }가장 최근 항목이 이후 응답의 강도를 정합니다. 두 항목을 붙여 놓지 않고, 자동 압축·잘라내기와 함께 쓰지 않으며, 명시적 압축 뒤에는 새 항목을 다시 넣으라고 문서가 안내합니다. 캐시 계산서로 보면 이 한 줄이 접두 재작성(1.25배 쓰기 한 번)과 맞바꾸는 이득을 지켜 주는 장치입니다.
옮기면 400이 돌아오는 호출
이전 모델에서 쓰던 요청을 그대로 보내면 막히는 곳이 있습니다. 변경 기록과 최신 모델 가이드의 이전 안내를 모았습니다.
reasoning.effort: "none"이 없습니다. Astra와 GPT-6.1 Sol은 지원하지 않고, GPT-6 Sol과 GPT-6.1 Terra, Luna는 지원합니다. Astra에none을 보내면 HTTP 400이 돌아오므로 빠른 응답을 위해 추론을 끄던 호출은low로 옮깁니다. 지원 단계는low,medium(기본),high,xhigh,max입니다.- 샘플링 값을 못 씁니다. 추론 강도가
none이 아니면temperature,top_p,top_logprobs를 빼야 합니다. Chat Completions는logprobs, Responses는include에서message.output_text.logprobs도 뺍니다. 공통 클라이언트 코드에temperature가 숨어 있는지 먼저 찾아보세요. - 도구 호출은 Responses API에서만 됩니다. Astra, Sol, Terra 모두 Chat Completions로 도구를 쓰던 코드는 Responses로 옮겨야 합니다. 지원 엔드포인트는 Chat Completions, Responses, Batch이고, 실시간, 파인튜닝, 임베딩, 이미지 생성 모델 호출, 음성·전사, 모더레이션, 구형 Completions는 지원하지 않습니다. 이미지 생성은 Responses의 도구로는 쓸 수 있습니다.
- 출력 한도에 여유가 필요합니다.
max_output_tokens는 추론 토큰과 보이는 출력을 합친 한도라서, 한도에 닿으면 응답이incomplete로 끝나고 보이는 출력이 없는데도 입력·추론 요금은 냅니다. 문서는 시작할 때 최소 25,000 토큰을 남기라고 권합니다. - 캐시 설정이 바뀝니다. GPT-5.5 이하에서 올라오면
prompt_cache_retention을prompt_cache_options.ttl("30m")로 바꾸고 캐시 경계와 쓰기 과금 방식을 점검합니다.
이 변환은 Codex에서 OpenAI Docs 스킬로 자동 적용할 수 있다고 가이드가 소개합니다. 모델 ID만 바꾸고 끝내지 말고, 같은 입력으로 평가를 다시 돌려 응답의 성향 변화를 확인하세요. 추론 토큰은 화면에 안 보이지만 출력 단가($50)로 청구되고 컨텍스트 창도 차지하므로, 평가 때는 점수와 함께 output_tokens_details.reasoning_tokens를 기록해 두어야 청구서가 설명됩니다. 문서는 추론 강도를 품질을 올리는 주된 수단이 아니라 조절 손잡이로 보라며 medium을 기준선으로 삼고, xhigh와 max는 평가에서 이득이 확인될 때만 쓰라고 권합니다.
오작동 감시가 대화를 멈출 때
Astra에는 오작동 감시가 붙습니다. 에이전트가 사용자의 지시를 제대로 해석하는지, 민감한 데이터를 옮기거나 파괴적인 변경을 하는지 모델의 추론과 행동을 비동기로 검토하는 시스템이고, 문제가 보이면 대화를 멈출 수 있습니다. 어디까지 감시되는지는 요청 방식에 따라 갈립니다.
| 요청 | 감시 | 자동 중단 |
|---|---|---|
| Responses API + 지속 추론·WebSocket·OpenAI 압축 중 하나 | 대상 | 가능(대화의 이어지는 요청을 알아보고 막음) |
| Responses API, 위 방식 없음 | 대상 | 없음(웹훅 알림만) |
| Chat Completions API | 대상 아님 | 해당 없음(다른 안전 점검은 적용) |
시작 전에 막히면 HTTP 403이 오고 오류 본문은 이렇게 생겼습니다. 스트리밍 중에도 같은 오류가 올 수 있으니 스트림을 읽는 쪽에서도 처리해야 합니다.
HTTP 403
error.type = "invalid_request_error"
error.code = "misalignment_policy_violation"
메시지 문장이 아니라 코드로 분기하세요. 문서가 정한 대응은 세 가지입니다. 같은 대화에 더 이상 동작을 보내지 말고 자동 재시도도 하지 않을 것, 요청·응답 ID와 도구 호출 기록을 정책에 맞게 보존할 것, 오류 정보를 담당자에게 보여 주어 에이전트가 한 일과 의도한 일을 비교하게 할 것입니다. 중단된 대화를 다시 이어 가는 일반적인 방법은 API에 없으므로 새 대화로 시작하는 설계가 필요합니다.
팀 단위로 보려면 프로젝트에 웹훅을 달아 safety.alert.created 이벤트를 받습니다. 웹훅에는 알림 ID만 담기고, 세부는 GET /v1/safety/alerts/{alert_id}를 api.safety.alerts.read 권한이 있는 같은 프로젝트의 키로 불러 읽습니다. 알림의 reason은 범주 설명이고 Zero Data Retention 요청에서는 비어 있을 수 있으며 대화 기록이나 조사 보고서가 아닙니다. request_paused가 true라는 말은 안전 차단이 등록되었다는 뜻일 뿐, 실행이 멈췄다거나 이전 동작이 되돌려졌다는 보증이 아닙니다.
멈춤은 되돌림이 아닙니다. 감시가 비동기라서 문제를 알아차리기 전에 이미 끝난 동작이 있을 수 있고, 차단이 그 동작을 취소하지 않습니다. 또 플래그는 사용자가 정책을 어겼다는 증거가 아니며, 감시가 문제를 놓치거나 정상 작업을 잘못 표시할 수도 있다고 문서가 직접 밝힙니다. 파일 삭제, 배포, 민감 데이터 전송처럼 되돌릴 수 없는 작업 앞에는 사람의 승인 단계를 그대로 두세요.
질문 대신 진행하고 스킬을 곧이곧대로 따르는 Astra
개발자 가이드는 Astra의 행동 특성을 다섯 가지로 정리합니다. 이전 모델용 프롬프트를 그대로 옮기면 이 부분에서 어긋납니다.
- 되묻기. 답에 따라 결과가 크게 달라질 질문이면 이전 모델보다 자주 멈춥니다. 끝까지 가길 기대한 작업에서 서 버릴 수 있습니다. 가이드가 권하는 방향은 스스로 의도를 추론해 끝까지 진행하고, 승인을 구하기 전에 구체적이고 검토 가능한 결과를 만들어 두며, 가상의 위험에 대한 경고와 승인 요청은 덧붙이지 말라는 지침을 시스템 프롬프트에 넣는 것입니다.
- 지시 따르기. 접근 가능한 스킬과 지침 파일(
AGENTS.md)에 민감합니다. 문서는 모델이 읽는 모든 스킬과 지침 파일을 점검하고, 사용자 지시가 스킬 지침보다 우선한다고 프롬프트에 못 박으며, 모델이 멈추거나 어긋날 때 어느 스킬 파일의 어떤 지침을 따랐는지 밝히게 하라고 권합니다. 외부에서 받은 스킬이 지침 파일에 섞여 있다면 Astra는 이전 모델보다 그 내용을 더 충실히 따를 수 있다는 뜻이므로 보안 점검 대상입니다. - 문체. 목록·표·마크다운을 선호하고 서식이 많은 답과 세션을 넘어 반복되는 문구가 나올 수 있습니다. 문체와 구조를 지정해야 합니다.
- 위임. 서브에이전트를 기대보다 적게 병렬로 씁니다. 언제 얼마나 병렬로 쓸지 정해 줍니다.
- 검증. 작은 변경에도 넓은 테스트를 돌릴 수 있습니다. 되돌리기 쉬운 변경은 범위를 제한합니다.
체감 차이가 가장 큰 것은 첫 번째입니다. 다섯 가지 중 청구서에 직접 닿는 것은 마지막 둘입니다. 테스트를 넓게 돌리면 도구 호출이 늘어 20번이 40번이 되고, 병렬 위임이 적으면 같은 일이 순차로 길어집니다. 호출이 늘어나는 만큼 앞의 계산이 그대로 곱해집니다.
일감 세 가지에 모델을 얹어 본 값
가격 페이지가 현재 올려 둔 GPT-6 계열은 다섯 모델입니다. 6.1 Terra는 10월 26일 공개된 새 모델로 시각 추론, 정밀한 컴퓨터 사용, 자연스러운 글쓰기용입니다.
| 모델(100만 토큰당) | 입력 | 캐시 읽기 | 출력 | none |
지식 기준일 | 문서의 설명 |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $10 | $1 | $50 | 불가 | 4월 30일 | 가장 까다로운 일을 위한 최고 성능 |
| GPT-6.1 Sol | $2 | $0.10 | $10 | 불가 | 4월 30일 | Astra에 가까운 성능을 낮은 비용에 |
| GPT-6.1 Terra | $1 | $0.05 | $5 | 가능 | 6월 1일 | 빠르고 효율적, 시각 추론·컴퓨터 사용·글쓰기 |
| GPT-6 Sol | $2 | $0.20 | $10 | 가능 | 4월 20일 | 직전 세대 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | 가능 | 5월 18일 | 가장 빠르고 저렴, 좁은 범위의 대량 작업 |
모델 선택 안내는 비용과 지연이 문제되지 않으면 Astra를 기본으로 쓰고, 줄이고 싶을 때 모델과 추론 강도를 내리라고 말합니다. 안내가 짝지은 예는 아래와 같습니다. Terra는 이 안내의 짝 목록에 없습니다.
| 조합 | OpenAI가 든 일 |
|---|---|
| Luna · low | 세밀한 수정, 범위가 좁은 문제 풀이, 단순 데이터 추출 |
| Luna · 매우 높음 | 여러 앱에 걸친 최신 맥락 찾기, 제약이 분명한 문제 |
| GPT-6.1 Sol · 보통 | 복잡한 기술 작업, 고쳐 나갈 산출물 |
| GPT-6.1 Sol · 매우 높음 | 다듬어진 결과물, 상충하는 근거에서 내리는 결정 |
| Astra · low | 사실과 뉘앙스를 지키는 간결한 글쓰기 |
| Astra · 보통 | 넓은 맥락이 필요한 큰 프로젝트 |
| Astra · 매우 높음 | 요구가 엄격한 분석과 복잡한 산출물 |
이 계산을 일감 세 가지에 적용합니다.
일감 1: 문서 1,000건을 아침까지 요약하는 야간 작업. 문서마다 입력 5만 토큰, 출력 2천 토큰이고 272K 안이며 급하지 않습니다. 표준 요금과 배치 요금(표준의 50%)은 다음과 같습니다(편집부 계산).
| 문서 1,000건 요약 | 표준 | 배치 |
|---|---|---|
| GPT-6 Astra | $600 | $300 |
| GPT-6.1 Sol | $120 | $60 |
| GPT-6.1 Terra | $60 | $30 |
| GPT-6 Luna | $6 | $3 |
요약에 Astra 수준이 필요하지 않다면 6.1 Sol로 내리는 것만으로 5배, Terra는 10배, Luna는 100배 싸집니다. 문서가 같은 지시문을 앞에 두고 반복된다면 캐시 읽기도 얹을 수 있습니다.
일감 2: 계약서 한 건을 통째로 넣는 질의. 앞서 본 계단이 그대로 걸립니다. 28만 토큰이면 Astra는 $6.35, 6.1 Sol은 $1.27, Terra는 $0.64, Luna는 $0.06입니다(출력 1만 토큰, 편집부 계산). 모델을 내려도 27만에서 28만으로 넘는 순간의 2배는 그대로이므로, 이 일감은 필요한 부분만 발췌해 입력을 272K 안으로 줄이는 쪽이 모델 교체보다 먼저입니다.
일감 3: 사용자가 화면 앞에서 기다리는 채팅. 지연이 곧 품질입니다. Astra의 Fast에는 지연 시간 보장이 없고 표준 한도를 공유하며 증가 한도에 걸리면 표준 요금으로 청구됩니다. 값이 6.1 Sol Fast의 5배($3.00 대 $0.60, 그림 2)이므로, 지연 때문에 Fast가 필요하다면 먼저 6.1 Sol이나 Terra의 Fast가 요구를 채우는지 보는 순서가 맞습니다. Astra는 같은 입력에서 결과 차이가 의미 있는 요청에만 쓰는 쪽이 값을 낮춥니다.
세 일감에서 공통으로 나온 순서는 “입력을 272K 안으로 → 캐시 접두를 안정시킨다 → 모델·방식을 내린다”입니다. Astra를 쓸 일감은 이 셋을 마친 뒤에 남는 곳입니다. 지금 쓰는 모델에 시키는 대표 작업 20건을 모아 6.1 Sol과 Astra에 같은 입력, 같은 추론 강도로 돌리고 응답의 입력·출력·추론·캐시 읽기 토큰을 합산하면, 품질 차이와 요금 차이가 나란히 놓여 Astra가 5배 값을 하는 작업인지 내 데이터로 가를 수 있습니다.
2026년 10월 27일 기준 GPT-6 계열 변경표
변경 기록과 가격 페이지에서 청구서에 닿는 변화만 날짜순으로 모았습니다(Astra 공개부터 10월 26일까지).
| 날짜 | 바뀐 것 | 청구서에 닿는 곳 |
|---|---|---|
| 9월 3일 | GPT-6 Astra 공개. 비동기 도구 호출, 작업 중 정정, 추론 강도 중간 변경, 오작동 감시 | 캐시 접두 유지(configuration_update), 감시 중단 대응 |
| 9월 8일 | 프롬프트 캐시 진단 정식 출시 | 캐시를 못 쓴 이유 확인 |
| 9월 22일 | GPT-6 Sol·Luna 공개(Luna 입력 $0.10, 출력 $0.50) | 대량 작업 단가 |
| 9월 25일 | Sol·Luna 이미지 인코딩 오류 수정 | 이미지 입력 평가 재실행 |
| 9월 29일 | GPT-6.1 Sol 공개(입력 $2, 출력 $10, 272K 이하 표준), Astra Ultrafast | 6배 단가, 한도 1/2~1/8 |
| 10월 6일 | 사용량 등급 5단계에서 3단계(Build·Launch·Grow)로, Decisions API 베타 | 분당 한도 |
| 10월 8일 | GPT-6.1 Sol에도 Ultrafast | 지역 거주 지원 범위 |
| 10월 9일 | Agents API 샌드박스 컴퓨트를 활성 턴 동안만 과금 | 턴 사이 유휴 시간 무과금 |
| 10월 16일 | Agents API에서 Ultrafast(agent.service_tier) |
에이전트 경로의 처리 등급 |
| 10월 20일 | 12시간 프롬프트 캐시(쓰기 2.5배) | 요청 간격이 긴 서비스의 캐시 손익 |
| 10월 21일 | 프로젝트별 서비스 등급 제한 | 관리자가 쓸 수 있는 처리 등급을 고름 |
| 10월 22일 | Decisions API 정식 출시, 요청당 질문 200개에서 400개 | Luna 기반 일괄 판정 |
| 10월 26일 | GPT-6.1 Terra 공개(입력 $1, 캐시 읽기 $0.05, 출력 $5) | Sol과 Luna 사이의 새 단가 |