맥에서 올라마(Ollama)가 느린 이유와 대역폭 계산법
애플 실리콘 통합 메모리 환경에서 올라마(Ollama)로 대형 언어 모델 구동 시 발생하는 속도 저하 원인을 분석하고, 메탈 엔진 교체 배경과 Modelfile 대역폭 최적화 튜닝법을 정리합니다.
새벽 3시의 작업실, 책상 위에는 팬 소리 하나 없이 서늘한 냉기를 뿜어내는 맥북 프로가 놓여 있었다.
통합 메모리 36GB를 탑재한 M3 프로 칩셋. 긱벤치 멀티코어 점수가 데스크톱 워크스테이션을 가뿐히 넘어서고, 4K 고화질 영상 서너 트랙을 실시간으로 렌더링해도 버벅임이 없는 고성능 머신이었다.
개발자는 터미널 창을 열고 맥 사용자들이 로컬 LLM을 돌릴 때 가장 널리 사용하는 오픈소스 런처인 **올라마(Ollama)**를 실행했다. 그리고 다음 명령어를 입력했다.
ollama run llama3:70b파라미터 70B 체급의 대형 언어 모델을 4비트로 양자화한 가중치 파일이 메모리에 올라가기 시작했다. 파일 크기는 약 39GB 안팎, macOS 시스템 캐시와 여유 공간을 긁어모아 간신히 로드에 성공한 순간이었다. 터미널의 Ollama 프롬프트에 간결한 리팩토링 요청 한 줄을 적고 엔터 키를 눌렀다.
화면 한구석에 띄워둔 활성 상태 보기의 CPU 그래프는 40% 언저리를 맴돌았고, 18코어 GPU 점유율은 채 30%를 넘지 못했다. 그런데 이상했다. 커서는 마치 진흙탕을 걷는 것처럼 버벅거리며 깜빡였다.
첫 번째 단어가 출력되기까지 몇 초가 흘렀고, 이후 생성되는 토큰 속도는 처참했다. 터미널 하단에 찍힌 Ollama의 실시간 계측 숫자는 불과 초당 7.8토큰이었다. 인간의 독서 속도보다 느리고, 클라우드 API 응답 속도의 10분의 1에도 미치지 못하는 답답한 수치였다.
수백만 원을 호가하는 최신 애플 실리콘 랩톱에서 도대체 무슨 일이 벌어지고 있는 것일까? 흔히 개발자 커뮤니티에서는 “맥은 GPU 코어가 부족해서 Ollama에 맞지 않는다”라거나 “뉴럴 엔진이 제 역할을 못 한다”는 식의 피상적인 추측이 오간다.
하지만 하드웨어 프로파일러와 메탈(Metal) 성능 분석기를 깊숙이 들여다보면 전혀 다른 공학적 진실이 드러난다. 맥에서 대형 언어 모델이 거북이처럼 기어가는 진짜 원인은 연산 코어의 연산력 부족이 아니다. 바로 데이터가 지나다니는 물리적 통로, 즉 메모리 대역폭이라는 단 하나의 결정론적 병목이 만들어낸 수학적 결과다.
거대한 선반과 좁은 파이프라는 애플 실리콘의 딜레마
로컬 인공지능 환경에서 애플 실리콘을 바라보는 시선은 늘 극단으로 갈린다. 한쪽에서는 수십 기가바이트의 거대한 모델을 노트북 한 대에서 띄울 수 있는 기적의 기기라고 칭송하고, 다른 한쪽에서는 Ollama 토큰 출력 속도가 답답해서 실무에 쓸 수 없는 장난감이라고 혹평한다. 이 극단적인 평가 차이를 이해하기 위해서는 하드웨어 구조를 선반과 파이프라는 비유로 해부해 보아야 한다.
엔비디아의 플래그십 그래픽 카드인 지포스 RTX 4090을 떠올려보자. 이 카드는 초당 1,008GB라는 경이로운 메모리 대역폭을 자랑한다. 파이프의 직경이 어마어마하게 넓어서 초당 1테라바이트에 달하는 데이터를 GPU 코어로 퍼부을 수 있다.
하지만 치명적인 한계가 있다. VRAM 용량, 즉 데이터를 올려둘 수 있는 선반의 크기가 고작 24GB에 불과하다는 점이다. 24GB 선반에는 최신 70B 모델이나 30B 이상의 대형 모델을 온전히 올려둘 수 없다. 모델 가중치가 선반 크기를 1MB라도 초과하는 순간 Ollama는 구동 자체를 거부하거나 CPU 오프로드로 밀려나며 연산 자체가 사실상 마비된다.
반면 애플 실리콘은 정반대의 물리적 구조를 채택하고 있다. 애플은 CPU와 GPU, 뉴럴 엔진이 하나의 거대한 메모리 풀을 공유하는 통합 메모리 아키텍처(UMA)를 구축했다. 맥 스튜디오나 상위 맥북 프로를 선택하면 64GB, 128GB, 심지어 192GB나 512GB에 달하는 광활한 VRAM 선반을 손에 쥐게 된다. 웬만한 데이터센터용 가속기 부럽지 않은 크기다.
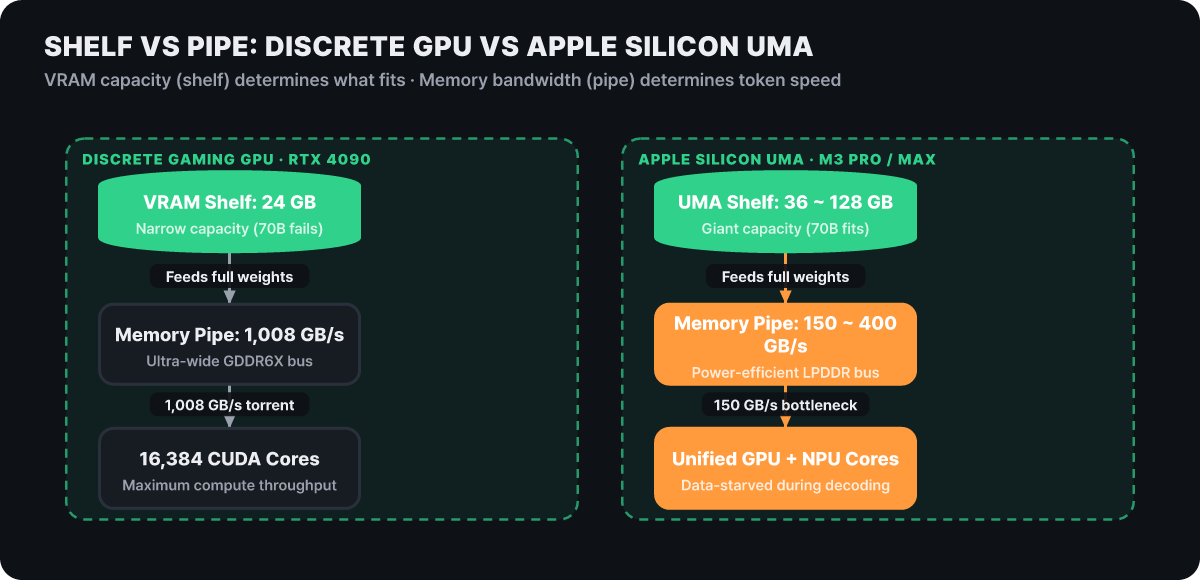 그림 1. 독립형 게이밍 GPU(RTX 4090)와 애플 실리콘 통합 메모리(UMA)의 VRAM 선반 용량 및 메모리 파이프 대역폭 비교
문제는 그 선반 아래에 연결된 파이프의 굵기다. 기본형 M2나 M3 칩셋의 메모리 대역폭은 초당 100GB 안팎이고, M3 프로는 초당 150GB, M3 맥스는 초당 300~400GB 수준이다.
선반은 체육관만큼 넓어서 책 수천 권 분량의 파라미터를 여유롭게 쌓아둘 수 있는데, 그 책을 집어 올려 연산 코어로 전달하는 엘리베이터의 속도가 RTX 4090의 10분의 1에서 7분의 1에 불과한 셈이다. 바로 이 불균형이 맥 로컬 인공지능과 Ollama의 모든 명암을 결정짓는 핵심 역설이다.
이러한 하드웨어 설계 차이는 제조사의 목표가 다르기 때문에 발생한다. 게이밍 그래픽 카드는 4K 해상도에서 120프레임 이상의 그래픽을 렌더링하기 위해 초고속 GDDR 메모리를 장착하고, 수백 와트의 전력을 소비하며 굉음을 내는 대형 쿨러를 장착한다.
반면 애플 실리콘은 노트북이라는 폼팩터 안에서 하루 종일 배터리로 작동할 수 있는 저전력 LPDDR 메모리를 메인 기판에 패키징하는 방식을 선택했다. 발열과 전력 효율을 잡는 대신, 버스 폭을 줄여 대역폭을 타협한 것이다. 이 타협점이 바로 Ollama 워크로드에서 결정적인 속도 차이로 표출된다.
단 1토큰을 만들 때마다 가중치 전체를 읽어야 하는 오토리그레시브의 저주
왜 메모리 대역폭이 토큰 생성 속도를 그토록 절대적으로 지배하는 것일까? GPU 연산력이 뛰어나다면 메모리 속도가 조금 느려도 코어가 힘을 내서 빠르게 처리할 수는 없을까? 안타깝게도 현대 트랜스포머 디코더 아키텍처와 Ollama의 구동 방식은 그러한 기대를 가차 없이 배반한다.
대형 언어 모델의 텍스트 생성은 오토리그레시브, 즉 자기회귀적 방식으로 동작한다. 모델은 다음에 올 단어를 한 번에 한 개씩 순차적으로 예측한다. 문장 전체를 한 번에 찍어내는 것이 아니라, 첫 번째 단어를 만들고, 그 단어를 다시 입력에 포함하여 두 번째 단어를 만들고, 이 과정을 끝없이 반복한다.
여기서 공학적인 연산 병목이 발생한다. 모델이 다음 토큰 딱 하나를 예측하기 위해서는, 모델을 구성하는 수백억 개의 파라미터 가중치 행렬 전체를 메모리에서 GPU 레지스터로 남김없이 불러와야 한다.
예를 들어 Ollama에서 ollama run llama3:8b로 실행하는 80억 파라미터 모델을 생각해보자. 4비트 양자화(Q4)를 적용하면 모델 파일의 크기는 약 5.5GB 수준으로 압축된다.
이 모델이 “데이터 처리가 완료되었습니다”라는 문장을 생성한다고 가정해보자. 토큰이 대략 5개 소모된다면, 컴퓨터는 5개의 토큰을 만들기 위해 5.5GB짜리 가중치 덩어리를 메모리에서 연산 유닛으로 총 다섯 번 완전히 처음부터 끝까지 읽어 들여야 한다. 즉 단 5개의 토큰을 생성하기 위해 총 27.5GB의 데이터를 메모리 버스 위로 왕복 이동시켜야 한다는 의미다.
- 토큰 1 생성5.5GB 가중치 전체 로드 ➔ 연산 코어 ➔ 1개 토큰 출력
- 토큰 2 생성5.5GB 가중치 전체 재로드 ➔ 연산 코어 ➔ 1개 토큰 출력
- 토큰 3 생성5.5GB 가중치 전체 재로드 ➔ 연산 코어 ➔ 1개 토큰 출력
- 토큰 100개 누적550GB 분량의 메모리 버스 순차 트래픽 발생
이 과정에서 연산 집약도(Arithmetic Intensity), 즉 데이터 1바이트당 수행되는 부동소수점 연산 횟수는 1 미만으로 곤두박질친다. 수천 개의 최신 셰이더 코어가 장착되어 있어도, 다음 연산을 시작하기 위한 행렬 데이터가 메모리 버스를 통과해 도착하지 않으면 코어는 일손을 멈추고 대기해야 한다.
이것이 바로 컴퓨터 구조학에서 정의하는 전형적인 메모리 바운드(Memory-Bound) 상태다. GPU 코어가 아무리 강력해도 파이프가 좁으면 데이터 공급이 중단되어 기아 상태에 빠진다. 따라서 Ollama의 토큰 생성 속도는 GPU 코어의 수나 클럭 속도가 아니라, 오직 파이프를 통해 1초 동안 얼마나 많은 가중치를 실어 나를 수 있는가에 의해 기계적으로 결정된다.
메모리 대역폭과 모델 크기로 결정되는 결정론적 속도 공식
이 원리를 이해하고 나면, 로컬 언어 모델의 생성 속도를 예측하는 공식은 놀라울 만큼 단순한 계산식으로 귀결된다. GPU 코어 클럭이나 드라이버 버전 따위의 복잡한 변수는 걷어내도 좋다. 오토리그레시브 디코딩 단계에서 Ollama가 이론상 달성 가능한 최대 토큰 생성 속도는 다음 단 하나의 수식으로 계산된다.
토큰 생성 속도(tokens/s) = 시스템 메모리 대역폭(GB/s) / 활성화된 모델 가중치 크기(GB)
실제 시스템에서는 운영체제 백그라운드 프로세스가 사용하는 대역폭 손실과 메모리 컨트롤러의 오버헤드가 발생하므로, 이론적 한계치의 약 70%에서 85% 사이가 실측 속도로 기록된다.
이 공식을 애플 실리콘 라인업의 실제 스펙에 대입해보면, 왜 특정 모델에서 Ollama 속도가 그토록 느려지는지 한눈에 드러난다.
| 애플 실리콘 칩셋 | 메모리 버스 폭 | 공칭 메모리 대역폭 | 8B Q4 모델 (5GB) 이론 속도 | 70B Q4 모델 (40GB) 이론 속도 |
|---|---|---|---|---|
| M2 / M3 / M4 기본형 | 128-bit | 100 ~ 120 GB/s | 20 ~ 24 tokens/s | (메모리 부족 구동 불가) |
| M2 Pro / M3 Pro | 192-bit | 150 ~ 200 GB/s | 30 ~ 40 tokens/s | 3.7 ~ 5.0 tokens/s |
| M2 Max / M3 Max | 512-bit | 300 ~ 400 GB/s | 60 ~ 80 tokens/s | 7.5 ~ 10.0 tokens/s |
| M2 Ultra | 1024-bit | 800 GB/s | 160 tokens/s | 20.0 tokens/s |
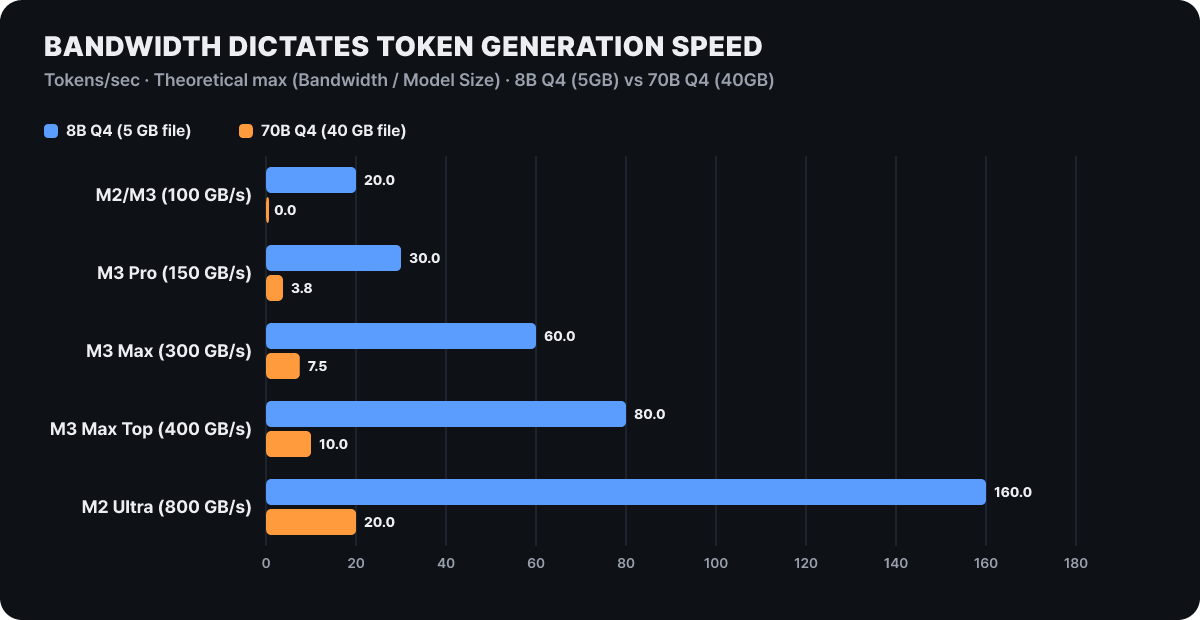 그림 2. 애플 실리콘 칩셋별 메모리 버스 대역폭과 8B 및 70B 모델 크기에 따른 이론상 최대 토큰 생성 속도(tokens/s)
이 표가 시사하는 바는 명확하다. 70B 규모의 거대 모델을 M3 프로(대역폭 초당 150GB)에서 구동할 경우, 메모리가 아무리 넉넉해서 모델이 통째로 올라간다 한들 물리적 한계 속도는 초당 3.75토큰에 불과하다. 실측 속도가 3토큰 내외로 떨어지는 것은 소프트웨어 버그나 설정 실수가 아니라, 150GB라는 물리적 파이프에 40GB짜리 가중치 덩어리를 통과시킬 때 발생하는 순수한 물리 법칙의 결과다.
반면 8B 모델의 경우 초당 400GB를 뿜어내는 M3 맥스에서 구동하면 초당 70토큰 이상의 쾌적한 속도를 보여준다.
여기서 한 가지 중요한 교훈을 얻을 수 있다. 맥의 칩셋을 고를 때 단순히 “M3 프로 18코어 GPU”와 “M3 맥스 30코어 GPU”라는 코어 수에 현혹되어서는 안 된다는 점이다. 로컬 LLM 환경에서는 GPU 코어의 개수보다, 칩셋이 지원하는 메모리 버스 폭(192비트인가, 512비트인가)이 속도를 2배에서 3배까지 갈라놓는 핵심 열쇠다. Ollama 사용자가 체감 성능을 극대화하기 위해 취해야 할 첫 번째 전략은 명확하다. 자신의 칩셋 대역폭이 감당할 수 있는 크기 이하로 모델의 물리적 파일 용량을 엄격히 억제하는 것이다.
프롬프트 인제스천과 토큰 생성이 요구하는 전혀 다른 실리콘 자원
로컬 인공지능을 다루다 보면 또 다른 흥미로운 현상을 목격하게 된다. 수천 줄에 달하는 방대한 코드베이스나 긴 문서를 Ollama 창에 붙여넣었을 때의 반응이다.
어떤 컴퓨터는 질문을 던진 뒤 첫 번째 글자가 출력될 때까지 1분이 넘도록 묵묵부동이다가 일단 출력이 시작되면 시원하게 글을 써 내려가고, 어떤 컴퓨터는 엔터를 치자마자 1초 만에 반응하면서도 정작 답변을 출력하는 속도는 답답하게 늘어진다.
이 현상을 이해하려면 언어 모델의 실행 과정을 두 개의 완전히 분리된 단계로 나누어 관찰해야 한다. 바로 프롬프트 평가 단계(Prefill 또는 Time to First Token)와 앞서 살펴본 토큰 생성 단계(Token Generation 또는 Decoding)다.
1단계: 프롬프트 평가 (Prefill / TTFT)
- 동작: 수천 개 입력 토큰을 한꺼번에 병렬 행렬 연산
- 연산 성격: 연산 집약적 (Compute-Bound)
- 결정 요인: GPU 코어 수, NPU 연산력, 병렬 FLOPS 처리량
- 체감 효과: 첫 단어가 튀어나올 때까지의 초기 반응 시간 단축
2단계: 토큰 생성 (Generation / Decoding)
- 동작: 1개 토큰을 만들 때마다 모델 가중치 전체를 순차 로드
- 연산 성격: 메모리 대역폭 집약적 (Memory-Bound)
- 결정 요인: 통합 메모리 버스 대역폭 (GB/s), 양자화 비트 수
- 체감 효과: 실시간 문장 출력 속도(초당 토큰 수) 결정
첫 번째 단계인 프롬프트 평가 단계는 사용자가 입력한 모든 텍스트를 모델이 한꺼번에 소화하는 과정이다. 입력된 토큰이 1,000개라면, 모델은 이 1,000개의 토큰을 동시에 병렬로 계산한다.
이때는 메모리에서 가중치를 한 번만 읽어 들인 뒤 수많은 연산 코어들이 병렬 행렬 곱셈을 맹렬하게 수행한다. 즉 이 단계는 메모리 대역폭이 아니라 연산 코어의 절대적 계산 능력에 의해 속도가 결정된다.
최신 뉴럴 엔진 코어가 탑재된 칩셋이나 GPU 코어가 40개씩 박힌 상위 칩셋이 진가를 발휘하는 순간이 바로 여기다. 긴 문서를 던졌을 때 첫 반응 시간을 획기적으로 줄여주는 것은 순수 연산 코어의 몫이다.
실제로 동일한 긴 문서를 입력했을 때, 연산 코어가 개선된 최신 세대 칩셋은 첫 글자를 띄우는 데 18초가 걸린 반면, 이전 세대 기본형 칩셋은 81초 동안 멈춰 서 있기도 했다.
하지만 일단 첫 단어가 튀어나오고 나면 규칙이 180도 바뀐다. 두 번째 단어부터는 방금 설명한 오토리그레시브의 지배를 받는다. 수십 개의 GPU 코어는 일손을 멈추고 메모리 파이프에서 한 방울씩 떨어지는 가중치 데이터를 기다리는 신세로 전락한다.
따라서 대량의 소스코드를 한 번에 밀어 넣고 분석하는 코드 리뷰 도구를 구축할 때는 연산 코어가 많은 상위 칩셋이 필수적이지만, 일상적인 대화나 실시간 코딩 어시스턴트를 Ollama로 활용할 때는 오직 메모리 대역폭 수치만을 주시해야 한다.
거대한 선반에 최적화된 MoE 아키텍처와 맥의 공학적 결합
이처럼 “선반은 광활하지만 파이프는 좁다”는 애플 실리콘의 태생적 한계를 완벽하게 역이용할 수 있는 아키텍처가 존재한다. 바로 최근 오픈소스 생태계에서 주류로 자리 잡은 MoE(Mixture of Experts, 전문가 혼합) 구조다.
일반적인 고밀도 모델은 모든 파라미터가 하나의 거대한 덩어리로 묶여 있다. 70B 모델이라면 700억 개의 매개변수 전체가 매 토큰마다 활성화된다.
하지만 MoE 모델은 내부를 수많은 작은 전문 신경망으로 쪼개어 놓았다. 예를 들어 Ollama에서도 손쉽게 구동할 수 있는 대표적인 MoE 아키텍처인 mixtral:8x7b 모델의 경우, 총 파라미터 수는 약 470억 개에 달하지만, 특정 토큰을 계산할 때는 라우터가 가장 적합하다고 판단한 단 2개의 전문가 네트워크(약 130억 개 파라미터)만을 동적으로 선택해 활성화한다.
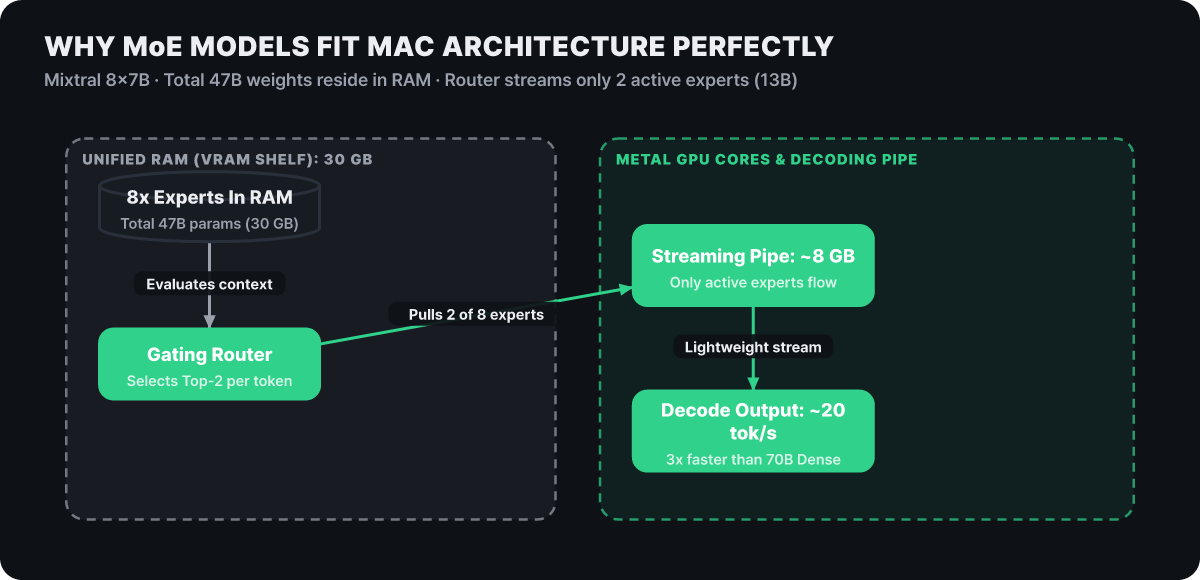 그림 3. 총 47B 가중치가 RAM에 상주하지만 매 토큰마다 활성화된 2개 전문가(8GB)만 파이프로 통과시키는 MoE 희소 라우팅 구조
거대한 선반과 좁은 파이프 환경을 위한 모델 선택 가이드
단일 고밀도(Dense) 70B 모델은 150 GB/s 대역폭에서 초당 4토큰을 넘기 어렵습니다. 동일한 지능 수준을 유지하면서도 체감 속도를 3배 이상 끌어올리려면 활성화 파라미터가 13B 내외로 제한되는 MoE 계열 모델(Mixtral 8x7B, Qwen 2.5 MoE)을 Ollama에 우선적으로 배치하는 것이 공학적으로 가장 현명한 선택입니다.
이 구조는 맥의 특성과 환상적인 궁합을 보여준다. 선반 측면에서 살펴보면, 8x7B 모델을 4비트로 올리려면 약 30GB의 VRAM이 필요하다. 24GB짜리 지포스 그래픽 카드 단일 장착 환경에서는 메모리 부족으로 아예 로드조차 불가능하지만, 36GB나 64GB를 장착한 맥북에서는 아무런 문제 없이 선반 위에 전체 가중치를 올려둘 수 있다.
파이프 측면에서는 진정한 혁신이 일어난다. 토큰을 생성할 때 실제로 메모리 버스를 통과해야 하는 데이터는 전체 30GB가 아니라, 활성화된 2개 전문가의 분량인 약 8GB에 불과하다.
결과적으로 파이프에 가해지는 통과 부하가 3분의 1 이하로 급감한다. 70B 체급에 필적하는 지능과 추론 능력을 누리면서도, 메모리 버스에서 병목을 일으키는 가중치 크기는 13B 수준으로 낮추는 것이다.
동일한 M3 프로 환경에서 고밀도 70B 모델이 초당 4토큰으로 헐떡일 때, Ollama에서 ollama run mixtral:8x7b를 실행하면 초당 18~20토큰의 쾌적한 속도를 뽑아내는 비결이 여기에 있다. 맥을 위한 최고의 로컬 모델은 단일 고밀도 거대 모델이 아니라, 활성화 파라미터가 작게 설계된 MoE 모델이라는 점을 기억해야 한다.
컨텍스트가 늘어날 때 찾아오는 KV 캐시 폭탄과 SSD 스왑 참사
메모리 대역폭 수식에 따라 안정적인 속도를 유지하던 시스템도, 대화가 길어지거나 수십 장의 기술 문서를 Ollama 프롬프트에 쏟아붓는 순간 갑자기 붕괴하는 현상이 발생한다. 초당 25토큰을 유지하던 출력이 어느 순간 초당 1토큰, 심지어 0.5토큰 수준으로 곤두박질치는 비극이다.
이 참사의 주범은 바로 KV 캐시(Key-Value Cache)의 증식과 운영체제의 가상 메모리 스왑이다.
언어 모델이 이전 대화 내용을 기억하고 문맥을 유지하기 위해서는, 지나간 모든 토큰에 대해 계산된 Key와 Value 벡터 값을 메모리에 차곡차곡 보관해 두어야 한다. 이를 KV 캐시라고 부른다. 문제는 이 캐시의 크기가 컨텍스트 길이와 배치 크기에 비례하여 기하급수적으로 불어난다는 사실이다.
최신 언어 모델에서 3만 2천 토큰 이상의 컨텍스트를 유지할 경우, KV 캐시 하나가 차지하는 메모리 용량만 8GB에서 12GB를 가볍게 넘어선다.
만약 36GB 통합 메모리를 탑재한 맥북에서 30GB짜리 모델 가중치를 로드해 둔 상태였다면 어떻게 될까? 사용 가능한 시스템 여유 메모리는 6GB에 불과하다. 운영체제와 웹 브라우저가 사용하는 기본 메모리를 제외하면 남는 공간은 거의 없다.
이 상태에서 대화가 길어져 KV 캐시가 8GB를 요구하기 시작하면, macOS 가상 메모리 관리자는 시스템 충돌을 막기 위해 물리 메모리에 있던 데이터의 일부를 SSD의 스왑 영역으로 강제 방출하기 시작한다.
정상 구동 (Unified RAM)
- 데이터 경로: 통합 메모리(UMA) ➔ GPU 연산 코어
- 물리 대역폭: 초당 150GB ~ 400GB
- 실측 속도: 초당 25~40토큰 정상 출력
- 시스템 상태: 메모리 점유율 80% 이내 안정권
스왑 발생 (NVMe SSD Paging)
- 데이터 경로: SSD 가상 메모리 스왑 영역 ➔ GPU 연산 코어
- 물리 대역폭: 초당 3GB ~ 6GB (50배 폭락)
- 실측 속도: 초당 0.5~0.8토큰으로 추락
- 시스템 상태: SSD 컨트롤러 과열 및 커서 멈춤
통합 메모리의 대역폭은 초당 150GB에서 400GB에 달하지만, 맥북에 탑재된 초고속 NVMe SSD라 할지라도 순차 읽기 대역폭은 기껏해야 초당 3GB에서 6GB 수준이다. 파이프의 폭이 단숨에 50분의 1로 쪼그라드는 셈이다.
SSD 스왑 방지를 위한 메모리 여유율 20% 규칙
통합 메모리에서 모델 가중치, KV 캐시, 시스템 기본 점유율의 합이 80%를 초과하는 순간 macOS 가상 메모리 관리자는 SSD 페이징을 시작합니다. 메모리 대역폭이 150 GB/s에서 SSD 순차 읽기 속도인 3~5 GB/s로 50분의 1 토막 나므로, 36GB 기기라면 Ollama 모델 파일 용량을 20GB 이내로 제한해야 안전합니다.
이 스왑 지옥에 빠지는 순간, 사용자는 모니터 앞에서 커서가 멈춘 채 SSD 컨트롤러가 과열되는 참상을 지켜보아야 한다.
Ollama 환경에서 컨텍스트 길이를 무작정 늘려 잡지 말고, 모델 가중치와 KV 캐시, 시스템 기본 점유율의 합이 물리 메모리의 80%를 넘지 않도록 제한해야 하는 이유가 바로 여기에 있다. 메모리가 36GB라면 모델 가중치는 20GB 이내로 잡고, 최소 16GB의 완충 공간을 운영체제와 KV 캐시를 위해 남겨두는 것이 황금률이다.
올라마 엔진 교체와 Modelfile로 뽑아내는 실전 극대화 프로파일링
물리적 하드웨어의 대역폭 한계가 고정되어 있다면, 개발자가 소프트웨어 레벨에서 Ollama의 속도를 끌어올릴 수 있는 현실적인 튜닝 카드는 무엇일까?
실제로 2026년 봄, 전 세계 로컬 LLM 생태계에 흥미로운 사건이 일어났다. 하드웨어 스펙은 단 1도 바뀌지 않았는데, 동일한 애플 실리콘 맥에서 Ollama의 토큰 생성 속도가 초당 58토큰에서 112토큰으로 두 배 가까이 수직 상승한 것이다. 비결은 하드웨어 교체가 아니라 Ollama 내부의 추론 엔진 교체에 있었다.
- 런타임 백엔드 엔진 최적화 점검 수년간 Ollama의 기반이었던 llama.cpp의 범용 CPU/GPU 포팅 계층 대신 애플 실리콘 전용 메탈 셰이더 커널(MPS) 및 MLX 기반 직결 백엔드를 적용하여 메모리 역양자화 복사 루프 병목을 해소합니다.
- 정밀 양자화 비트(Q4_K_M) 다이어트 FP16이나 Q8 대신 언어 혼란도 손실이 1% 미만인 Q4_K_M 양자화를 적용해 가중치 크기를 줄이고 대역폭 병목을 3배 이상 완화합니다.
- Modelfile 컨텍스트 상한선(num_ctx) 사전 예약 제한 기본 32k 자동 예약 대신 실무에 필요한 4,096~8,192 토큰으로 상한을 명시하여 불필요한 KV 캐시 메모리 낭비와 SSD 스왑을 원천 차단합니다.
첫 번째는 실행 런타임 엔진의 메탈 커널 최적화다. 과거 Ollama는 x86 CPU와 엔비디아 CUDA 환경에 맞춰 범용으로 설계된 llama.cpp 백엔드를 내부 구동 엔진으로 사용해 왔다.
하지만 애플 실리콘은 CPU와 GPU가 물리 메모리를 통째로 공유하는 특수한 구조를 갖고 있다. 범용 런타임에서는 4비트로 양자화된 정수를 연산 유닛 직전에서 16비트 부동소수점으로 풀어내는(Dequantization) 과정에서 불필요한 메모리 복사 루프가 발생했다.
Ollama가 애플 실리콘 전용 메탈 셰이더 커널과 MLX 아키텍처에 맞춘 전용 런타임 엔진을 도입하면서, 동일한 하드웨어에서 초당 58토큰이던 출력이 112토큰으로 두 배 가까이 치솟았다. 맥 사용자라면 반드시 최신 버전의 Ollama를 유지하고, 메탈 커널 가속이 정상적으로 바인딩되어 있는지 점검해야 한다.
두 번째는 양자화 프로파일의 정밀한 다이어트다. 많은 사용자가 무조건 높은 정확도를 원한다는 이유로 8비트(Q8)나 16비트(FP16) 가중치를 고집한다.
하지만 14B 체급의 모델을 16비트로 띄우면 28GB의 용량을 차지하며 대역폭을 질식시키지만, 정밀하게 튜닝된 4비트 양자화(Q4_K_M)를 적용하면 모델 크기가 8.5GB로 줄어든다. 수식에 대입하면 속도는 정확히 3.3배 빨라진다.
벤치마크 연구에 따르면 현대의 최신 양자화 기법은 원본 16비트 모델 대비 언어 혼란도 손실이 1% 미만에 불과하다. 미세한 지능 차이를 위해 속도를 3분의 1로 희생시키는 것은 로컬 환경에서 가장 비효율적인 선택이다.
Ollama에서는 사용자가 직접 Modelfile을 작성하여 이러한 매개변수와 컨텍스트 메모리를 정밀하게 통제할 수 있다.
# Ollama 커스텀 설정을 위한 Modelfile 작성 예시
# llama3.1 8B 모델 기반으로 맥 환경 최적화 파라미터 적용
FROM llama3.1:8b-instruct-q4_K_M

# KV 캐시 폭탄 방지를 위한 컨텍스트 윈도우 상한선 고정 (기본 32k -> 4k)
PARAMETER num_ctx 4096

# 모든 레이어를 메탈 통합 메모리 GPU로 완전 오프로딩
PARAMETER num_gpu 999

# 추론 시 스레드 수를 애플 실리콘 성능 코어 수에 맞춤
PARAMETER num_thread 8

# 온도 및 생성 제어
PARAMETER temperature 0.7
PARAMETER top_p 0.9

SYSTEM """당신은 애플 실리콘 아키텍처에 최적화된 시니어 소프트웨어 엔지니어 어시스턴트입니다."""
위의 Modelfile을 작성한 뒤 터미널에서 다음 명령어를 입력하면 최적화된 커스텀 모델이 즉시 생성된다.
ollama create my-mac-llama -f Modelfile
ollama run my-mac-llama
세 번째는 컨텍스트 윈도우 크기의 엄격한 상한선 통제다. Ollama의 기본 설정에 맡겨두거나 긴 프롬프트를 전송하면, 모델이 지원하는 최대 길이에 맞춰 사전에 방대한 KV 캐시 메모리를 예약해 버리는 경우가 허다하다.
단순 코드 완성이나 일상적인 질의응답 용도라면 앞선 Modelfile의 PARAMETER num_ctx 4096처럼 컨텍스트 크기를 4,096이나 8,192 토큰 수준으로 명시적 제한을 걸어두어야 한다. 이 조치 하나만으로 수 기가바이트의 통합 메모리가 즉시 회수되어 SSD 스왑의 위험을 원천 차단할 수 있다.
REST API를 통해 Ollama를 연동할 때도 동일한 옵션을 JSON 페이로드로 직접 전달하여 대역폭과 메모리를 방어할 수 있다.
# Ollama REST API를 통한 실전 메모리 제어 호출 예시
curl http://localhost:11434/api/generate -d '{
  "model": "qwen2.5-coder:14b",
  "prompt": "간단한 트라이 구조 파이썬 클래스 구현",
  "options": {
    "num_ctx": 4096,
    "num_gpu": 999,
    "temperature": 0.2
  }
}'
맥 환경 로컬 AI 성능 극대화를 위한 핵심 아키텍처 원칙
애플 실리콘 통합 메모리 환경에서 대형 언어 모델의 추론 속도를 결정짓는 것은 화려한 마케팅 문구나 GPU 연산 코어의 개수가 아니다. 오토리그레시브 디코딩 메커니즘 아래에서 모든 성능은 **“시스템 메모리 대역폭(GB/s) ÷ 활성화된 모델 가중치 크기(GB)”**라는 컴퓨터 구조학의 물리 법칙에 의해 지배된다.
로컬 환경에서 안정적이고 빠른 추론 파이프라인을 구축하기 위해 엔지니어가 반드시 지켜야 할 핵심 원칙은 다음 네 가지로 요약된다.
-
메모리 버스 대역폭 기준의 모델 체급 선택
자신이 사용하는 맥의 칩셋 대역폭(M3 Pro 150 GB/s, M3 Max 300400 GB/s)을 먼저 확인하고, 실무에서 쾌적하게 활용할 수 있는 최소 속도(초당 2535토큰)를 역산하여 모델 가중치 상한선을 엄격히 설정해야 한다. 대역폭이 150 GB/s인 기기에서 고밀도 70B 모델을 올리는 것은 물리적으로 4토큰 미만의 병목을 자초하는 일이다. -
광활한 선반을 활용하는 MoE 모델 우선 배치
맥의 최대 강점인 대용량 통합 메모리를 온전히 활용하면서도 좁은 대역폭 파이프의 한계를 극복하는 가장 효과적인 대안은 MoE(전문가 혼합) 아키텍처다. 47GB 이상의 가중치를 VRAM에 상주시키면서도 매 토큰마다 활성화되는 파라미터를 13B(약 8GB) 수준으로 억제하면 70B급 추론 품질과 초당 20토큰 이상의 속도를 동시에 확보할 수 있다. -
SSD 스왑을 원천 차단하는 메모리 여유율 20% 확보
모델 가중치, KV 캐시, 시스템 기본 점유율의 합이 물리 메모리의 80%를 초과하는 순간 macOS는 가상 메모리 페이징을 시작한다. NVMe SSD로 스왑이 일어나는 순간 대역폭은 초당 150GB에서 3GB 안팎으로 50분의 1 토막 나며 추론 파이프라인이 붕괴한다. 36GB 기기라면 모델 크기를 20GB 이내로 묶고 최소 16GB의 완충 여유 공간을 남겨두어야 한다. -
올라마 엔진 최적화와 Modelfile 컨텍스트 제어
애플 실리콘 전용 메탈(Metal/MLX) 커널이 적용된 최신 런타임을 유지하여 역양자화 복사 루프 병목을 제거하고,Modelfile의PARAMETER num_ctx 4096설정을 통해 컨텍스트 윈도우 상한을 명시적으로 제한해야 한다. 기본값에 맡겨두어 수 기가바이트의 KV 캐시가 사전 예약되는 낭비를 차단하는 것만으로도 시스템 안정성을 비약적으로 높일 수 있다.
감이나 막연한 기대에 의존하는 대신 하드웨어 버스의 물리적 한계와 소프트웨어 런타임의 특성을 공학적으로 이해하고 통제할 때, 애플 실리콘은 개발자에게 가장 조용하면서도 강력한 개인용 AI 워크스테이션으로 거듭날 수 있다.