리뷰 규칙은 엔진이 지키고 판단은 AI가 하는 알리바바의 코드 리뷰 CLI
알리바바 Open Code Review(ocr)가 리뷰 한 번에서 정해진 코드와 LLM에게 나눠 맡기는 일, 파일 관문·규칙 우선순위, 같은 모델 여섯 쌍의 벤치마크 값을 걸음별로 해부한다.
파일 서른 개가 바뀐 PR을 AI에게 리뷰시켰더니 “문제없음”이 돌아왔다면, 그 서른 개를 정말 다 읽었는지는 어떻게 확인할 수 있을까요? 대화형 에이전트는 어떤 파일을 열지, 어디까지 읽을지를 매번 스스로 정하기 때문에 확인할 길이 마땅치 않습니다. 알리바바(Alibaba)가 오픈소스로 공개한 Open Code Review(명령어 ocr)는 이 물음에 “읽을 파일을 고르고 묶고 규칙을 붙이는 일은 정해진 코드가 하고, 코드를 읽고 판단하는 일만 LLM이 한다”고 답합니다. 다만 README의 “결정적 엔지니어링”이라는 표현만 보면 거의 모든 단계가 LLM 없이 도는 것처럼 읽힙니다. 공식 아키텍처 문서를 열어 보면 LLM은 생각보다 많은 자리에서, 다만 좁은 질문마다 불립니다.
이 글은 ocr review 한 번이 지나가는 길을 바깥(파일 고르기)에서 안(서브 에이전트의 도구 호출)으로 뜯어 보면서, 각 걸음을 누가 맡는지와 그 경계가 벤치마크 값에 어떻게 이어지는지를 읽습니다. 기준은 2026년 10월 27일의 공식 문서와 최신 버전 v1.13.3입니다.
빠짐·표류·흔들림, 모델 재량에 맡긴 리뷰의 세 약점
README는 Claude Code 같은 범용 에이전트에 리뷰용 스킬을 붙여 쓸 때의 불만을 세 가지로 꼽습니다. 변경이 클 때 일부 파일만 보고 넘어가는 누락, 지적 위치가 실제 코드와 어긋나는 줄 번호 표류, 자연어 지시에 기대다 보니 프롬프트가 조금만 달라도 품질이 흔들리는 불안정성입니다. 셋의 뿌리는 같습니다. 리뷰 과정 전체가 모델의 재량에 놓여 있어서 “모든 파일을 본다” 같은 약속을 강제할 장치가 없다는 점입니다.
ocr의 해법은 하이브리드 설계입니다. 파일 선택, 묶기, 규칙 매칭, 지적 위치 확정처럼 틀리면 안 되는 일에는 정해진 코드가 제약을 걸고, 에이전트는 그 틀 안에서 어떤 파일을 더 읽을지 같은 동적 판단과 맥락 수집만 맡습니다. 이 설계는 알리바바 사내 도구에서 나왔습니다. README에 따르면 약 2년 동안 사내 공식 AI 코드 리뷰 도우미로 쓰였고, 저장소는 5월 18일에 공개됐으며 npm 패키지는 5월 21일에 처음 올라왔습니다.
공개 뒤의 속도는 빠릅니다. 9월 21일 v1.12.8부터 10월 22일 v1.13.3까지 32일 동안 릴리스가 열 번 나왔고, 10월 27일 현재도 v1.13.3이 최신입니다. 저장소는 Apache-2.0, 언어는 Go, 스타는 약 4만 8천이고 포크는 약 3천 5백입니다. npm 다운로드는 10월 22일 기준 최근 7일 94,581회, 30일 487,366회입니다(그 뒤 날짜는 아직 집계가 없습니다). 이번 달의 변경은 v1.13.0(10월 13일)의 ChatGPT 요금제 리뷰(Responses API 경유)와 ACP 서비스 지원, v1.13.2(10월 20일)의 셰이더 언어·Nushell·PowerShell 지원, v1.13.3(10월 22일)의 “빈 지적 묶음을 성공이 아닌 오류로 보고”하는 수정입니다.
여덟 걸음 가운데 LLM이 불리는 곳
아키텍처 문서는 처리 순서를 부트스트랩, diff 만들기, 파일 거르기, 묶기, 하위 작업 실행, 지적 처리, 출력으로 적습니다. 아래 그림은 이를 “정해진 코드만 도는 걸음”과 “LLM을 부르는 걸음”으로 색을 갈라 다시 그렸습니다. 초록이 코드, 주황이 LLM, 금색이 코드를 먼저 쓰고 LLM은 보조로 쓰는 걸음입니다.
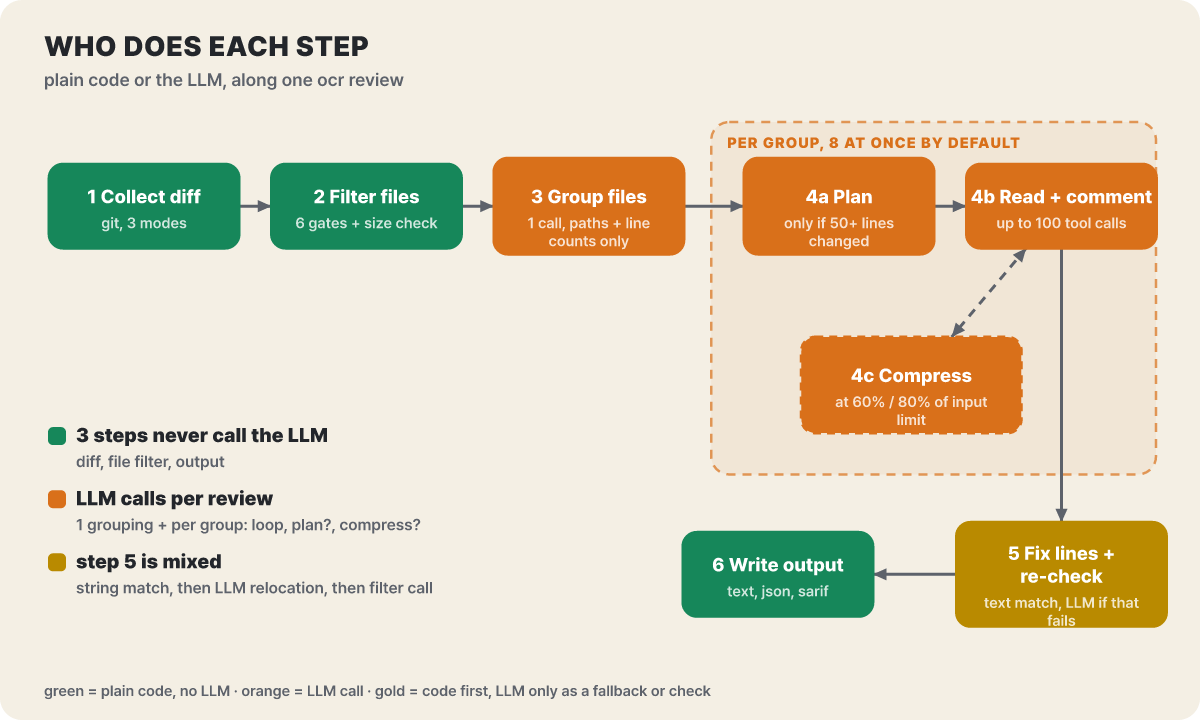 그림 1. LLM이 불리는 걸음은 묶기와 그룹 안쪽이고, 앞뒤 관문과 출력은 코드만 돈다
그림에서 읽을 점은 두 가지입니다. 하나는 LLM 호출이 “리뷰 전체에 한 번”이 아니라 묶기에서 1회, 그다음 그룹마다 따로 일어난다는 것입니다. 다른 하나는 그룹 안에서도 계획(변경이 큰 경우만)과 압축(대화가 길어진 경우만)은 조건이 맞아야 불린다는 것입니다. 그래서 같은 PR이라도 파일 수와 줄 수에 따라 호출 횟수가 크게 달라지고, 아래 절들은 이 그림의 걸음을 왼쪽부터 하나씩 엽니다. 부트스트랩은 설정이 불완전하면(주소·토큰·모델 중 하나라도 비면) 대체 경로 없이 오류로 끝난다는 점만 알아 두면 됩니다.
파일 하나가 모델에 닿기까지 넘는 관문
리뷰 품질의 절반은 “무엇을 보지 않을까”에서 갈립니다. 변경 파일은 아래 관문을 순서대로 통과해야 모델에게 갑니다. 문서가 정한 순서는 binary(텍스트가 아닌 파일 제외), secret_exclude(.ssh, id_rsa 계열, .npmrc, .env 변형 같은 비밀 경로, 사용자 규칙으로도 되살릴 수 없음), user_exclude(내가 적은 제외 패턴), user_include(일치하면 뒤의 두 관문을 건너뜀), unsupported_ext(허용 목록에 없는 확장자 제외), default_path(테스트 파일·생성 코드·픽스처·의존성과 빌드 폴더 제외)입니다. 통과한 뒤에도 삭제된 파일은 빠지고, diff만으로 입력 상한의 80%를 넘는 파일은 too_large로 빠집니다.
설명만으로는 include의 힘이 어디까지인지 감이 오지 않으니, 파일 일곱 개가 어디서 멈추는지 직접 따라가 보겠습니다. 설정은 exclude에 **/generated/**, include에 **/*_test.go를 넣었다고 가정한 편집부 예시입니다.
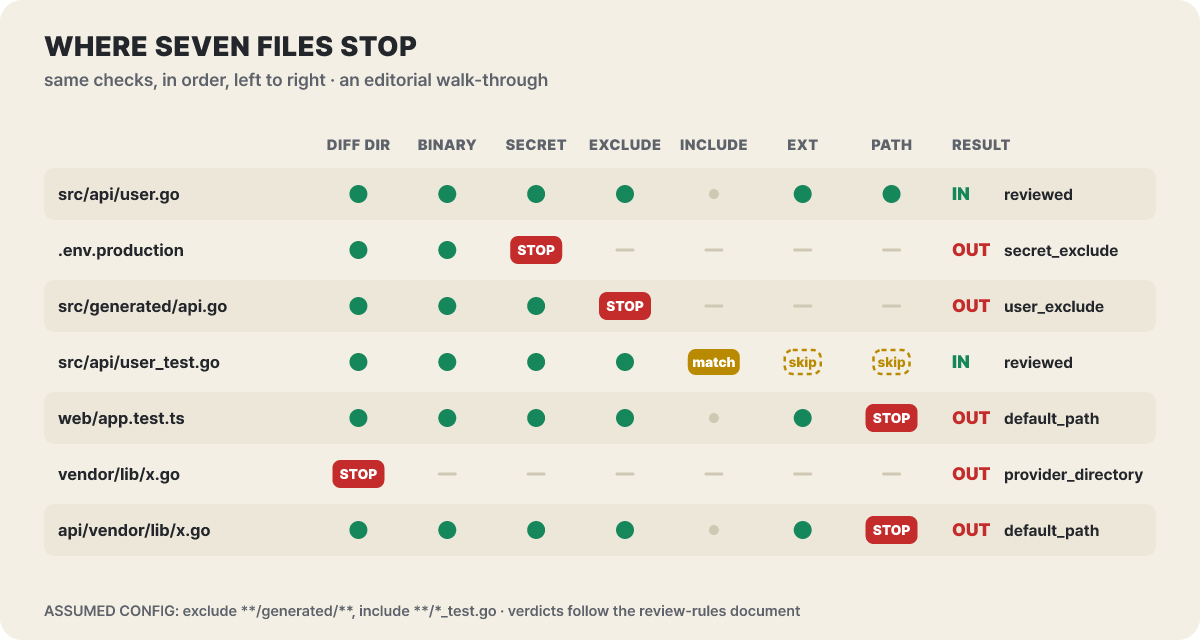 그림 2. 빨간 칸이 멈춘 자리.
include에 걸린 테스트 파일은 뒤의 두 관문을 건너뛰어 살아남는다
그림에서 짚을 곳은 셋입니다. 첫째, 테스트 파일이 기본으로 빠집니다(web/app.test.ts). *_test.go, *.test.ts, __tests__/, *Test.java 같은 패턴이 기본 제외 목록에 있어서, 테스트 변경도 보고 싶다면 include에 넣어야 합니다. 둘째, include는 허용 목록이 아닙니다. 일치하는 파일만 5·6관문을 우회할 뿐 일치하지 않는 파일(src/api/user.go)도 그대로 심사를 받아 통과합니다. 셋째, 저장소 최상위의 vendor/는 include로도 살릴 수 없습니다. diff 단계의 별도 검사가 루트 바로 아래의 시끄러운 폴더를 provider_directory로 처리하기 때문이고, 하위 폴더(api/vendor/)는 default_path라서 살릴 수 있습니다. 비밀 경로와 exclude는 include보다 먼저 판정되니 어떤 include로도 이기지 못합니다.
모델 비용을 쓰기 전에 이 판정을 미리 볼 수 있습니다. ocr review --preview는 LLM을 부르지 않고 필터 결과(대상 파일과 제외 사유)만 출력하고, 뒤에서 볼 위임 모드의 ocr delegate preview는 모델 연결 자체가 필요 없습니다.
묶기와 계획, 모델이 처음 불리는 자리
필터를 통과한 파일은 의미가 가까운 것끼리 묶입니다. 이 걸음이 LLM이 처음 불리는 곳인데, 보내는 내용은 경로, 변경 상태(추가·수정·삭제·이름 변경), 늘고 줄어든 줄 수뿐이고 diff 본문은 보내지 않습니다. 묶음은 최대 10개 파일이고, 토큰 예산을 넘으면 파일 하나씩으로 쪼개며, 묶이지 못한 파일은 단독 묶음이 됩니다. 호출이 실패하면 파일별 처리로 돌아갑니다. 문서가 이 단계를 정합성을 지키는 장치가 아니라 최적화라고 못 박아 둔 대목이 핵심입니다. 묶기가 틀리거나 실패해도 모든 파일은 어느 묶음에든 들어가 리뷰되므로 “빠짐”은 생기지 않습니다.
묶음마다 서브 에이전트가 따로 뜨고, 동시에 도는 수는 --concurrency로 정하며 기본은 8입니다. 각 그룹은 시작하기 전에 점검을 받습니다. 그룹의 메시지가 입력 상한(기본 20만 토큰)의 80%를 넘으면 그 그룹은 통째로 건너뛰고 경고가 남습니다.
계획 단계는 조건부입니다. 한 파일이 50줄 이상 바뀌었거나 파일 둘 이상의 변경 합이 100줄 이상일 때만, LLM이 도구 없이 한 번 불려 점검 목록을 만듭니다. 작은 변경은 곧바로 본 리뷰로 갑니다.
서브 에이전트의 작업대
본 리뷰는 서브 에이전트가 도구를 쓰며 오가는 반복입니다. 도구는 여섯 가지(파일 읽기, 다른 파일의 diff 읽기, 파일 찾기, 코드 검색, 지적 남기기, 끝내기)이고, 도구 요청은 최대 100번까지 갑니다. 읽기 도구는 맥락 파악용이라서, 다른 파일에서 발견한 문제는 지적 대상이 아니라고 프롬프트에 못 박혀 있습니다. 반복은 끝내기를 호출하거나, 한도에 닿거나, 유효한 도구 결과 없는 라운드가 연속 세 번 나오면 멈춥니다.
이 반복을 몇 바퀴 돌리느냐는 --effort가 정합니다. low는 1라운드, 기본 medium은 2라운드, high는 3라운드입니다. 둘째 라운드부터는 앞 라운드에서 확정된 지적을 넘겨받고 계획은 뺍니다. 계획이 “여기까지만 보면 된다”는 천장이 되기 쉽다는 것이 문서의 설명이고, 새 지적이 더 나오지 않으면 일찍 끝납니다.
긴 대화는 컨텍스트 창을 넘지 않도록 압축됩니다. 입력 상한의 60%(12만 토큰)에서는 백그라운드로, 80%(16만 토큰)에서는 즉시 앞부분을 요약하고, 요약 출력은 16,384토큰으로 묶습니다. 서브 에이전트 하나가 실패해도 재시도 없이 경고만 남고 나머지는 계속되며, 하나라도 성공하면 종료 코드는 0입니다. 재시도는 감싸는 CI가 할 일이라는 설계입니다.
줄 번호를 맞추는 세 번의 기회와 마지막 재검토
지적이 모이면 “어느 줄인가”를 정해야 합니다. 모델이 돌려준 원본 코드 조각을 diff에서 공백을 무시하고 찾아 줄 번호를 계산하는 것이 첫 시도이고, 코드가 합니다. 못 찾으면 위치 재조정 프롬프트로 LLM에게 다시 잡게 하는 것이 둘째 시도입니다. 그래도 실패하면 줄 번호 0으로 내보냅니다. 문서의 설명대로 지적 자체는 유효하다는 신호이고, 모델이 코드 조각을 바꿔 쓰거나 CRLF·탭 혼용처럼 특이한 서식이 원인입니다. 에이전트 연동에서는 existing_code 필드를 읽어 위치를 직접 찾습니다. 마지막에 줄 번호를 한 번 더 보정합니다.
여기서 LLM이 한 번 더 불립니다. 그룹마다 마지막에 지적 목록을 diff와 대조해 명백히 틀린 것을 걸러 내는 재검토입니다. 호출 오류는 무시되고, --no-filter로 끌 수 있습니다. 아래 벤치마크에서 ocr의 정밀도가 높게 나온 값은 편집부 해석으로 이 재검토와 좁은 읽기 범위가 맞물린 결과로 읽을 수 있습니다.
모든 리뷰는 ~/.opencodereview/sessions/에 추가 기록(JSONL)으로 남고, ocr viewer를 실행하면 localhost:5483에서 과거 세션을 열 수 있습니다. 그룹마다 계획·본 리뷰·재검토·압축·위치 재조정 칸이 나뉘어 있어서, 지적이 0개인 파일이 궁금하면 그 그룹의 본 리뷰 칸이 도구 호출 뒤 끝내기로 끝났는지 보면 됩니다. 본 리뷰 칸이 아예 없다면 리뷰 전에 필터에서 빠진 것이고, 사유는 --preview가 알려 줍니다. ocr session compare는 두 세션의 지적을 새로 생김, 계속됨, 해결됨, 검토 안 됨 네 칸으로 나눕니다. 마지막 칸이 중요합니다. 이전에 지적됐는데 이번에는 그 파일을 아예 보지 않았다면 해결된 것이 아니라는 구분입니다.
규칙 파일은 첫 일치가 이긴다
어떤 파일을 심사할 때 어떤 지침을 모델에게 줄지는 경로 패턴으로 정합니다. 이것도 코드가 하는 일이고, 모델은 선택된 지침을 읽기만 합니다. 우선순위는 네 층입니다. 1순위는 이번 실행에만 쓰는 --rule 플래그, 2순위는 저장소의 .opencodereview/rule.json(커밋해서 팀이 공유), 3순위는 내 컴퓨터의 전역 ~/.opencodereview/rule.json, 4순위는 바이너리에 내장된 언어·파일 형식별 규칙입니다. 한 층 안에서는 적은 순서대로 보고, 처음 일치한 항목이 이깁니다. 항목은 경로 패턴(path)과 자연어 지침(rule) 한 쌍이고, 파일 맨 위에 exclude·include도 둘 수 있습니다.
{
  "exclude": ["**/generated/**"],
  "rules": [
    {
      "path": "src/api/**/*.go",
      "rule": "공개 핸들러는 요청 본문을 쓰기 전에 반드시 검증할 것",
      "merge_system_rule": true
    }
  ]
}
이 프로젝트 자신의 규칙 파일이 실전 예입니다. 지원하는 제공자 목록을 정의한 Go 파일에 “항목 안의 필드 순서를 지킬 것”, “문서 네 곳을 같이 고칠 것”, “새 제공자에는 테스트를 붙일 것”을 적어 두고, 이 파일이 바뀔 때만 규칙이 전달됩니다. 일반 모델이 알 수 없는 팀의 관례를 해당 경로에만 걸어 두는 용도입니다.
함정은 셋입니다. 기본은 대체라서, 일치한 항목이 그 파일의 내장 언어 규칙(NPE, XSS, SQL 인젝션 같은 흔한 결함 지침)을 통째로 대신합니다. 내장 규칙을 살리려면 merge_system_rule: true를 넣어야 하고, 이 값은 파일별로 맞는 언어 규칙을 따로 골라 합치므로 **/* 한 줄로 전체 보안 지침을 얹어도 됩니다. 내 규칙끼리는 합쳐지지 않으니, 같은 파일에 내 항목 둘이 일치하면 먼저 적은 것이 이기고 다른 하나는 무시됩니다. 패턴은 대소문자를 가리지 않고(경로를 소문자로 바꿔 비교) 중괄호 안 공백에 민감해서, {ts, tsx}처럼 쉼표 뒤에 공백이 있으면 tsx가 조용히 불일치합니다.
규칙이 왜 안 먹는지 헷갈릴 때는 ocr rules check <파일>이 이긴 층과 패턴을 그대로 보여 줍니다. 아래는 공식 CLI 문서가 싣는 예시와, 텍스트 출력의 마지막에 붙는 요약 줄입니다.
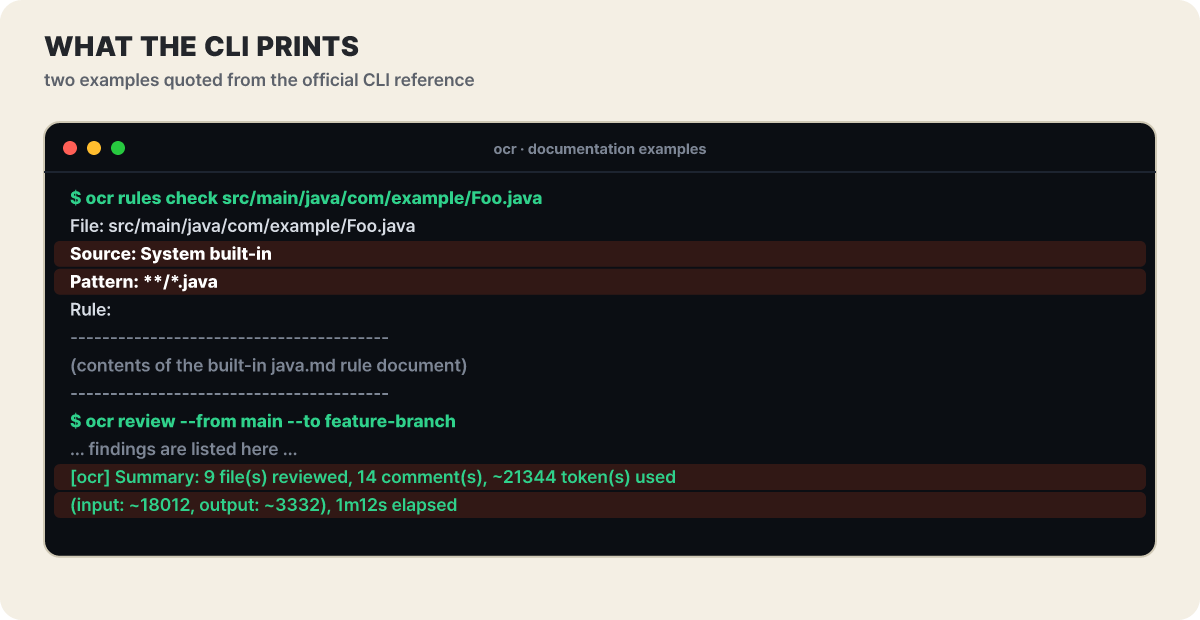 그림 3.
Source 줄이 어느 층의 규칙이 이겼는지 알려 준다. 요약 줄은 파일 수·지적 수·토큰·시간
Source: System built-in이면 내 규칙은 이 파일에 하나도 일치하지 않았다는 뜻이고, 프로젝트·전역 규칙이 이겼다면 그 파일 경로가 여기에 나옵니다. 요약 줄의 토큰 수는 곧 비용이므로 첫 실행 때 이 줄을 눈여겨봐 두면 PR 하나가 얼마나 드는지 감이 잡힙니다.
같은 모델 여섯 쌍이 보여 주는 정밀도와 재현율의 거래
걸음을 이렇게 나눈 설계가 값으로는 어떻게 나타나는지 볼 차례입니다. README의 순위표 이미지에는 평가 세트(인기 오픈소스 저장소 50곳, 실제 PR 200건, 프로그래밍 언어 10종, 시니어 엔지니어 80여 명이 교차 검증한 정답 결함 1,505건)에서 모델·도구 조합별 값이 실려 있고, 같은 모델을 ocr과 범용 에이전트에 각각 넣은 쌍이 여섯 개 있습니다. 먼저 정밀도·재현율·토큰을 나란히 보겠습니다.
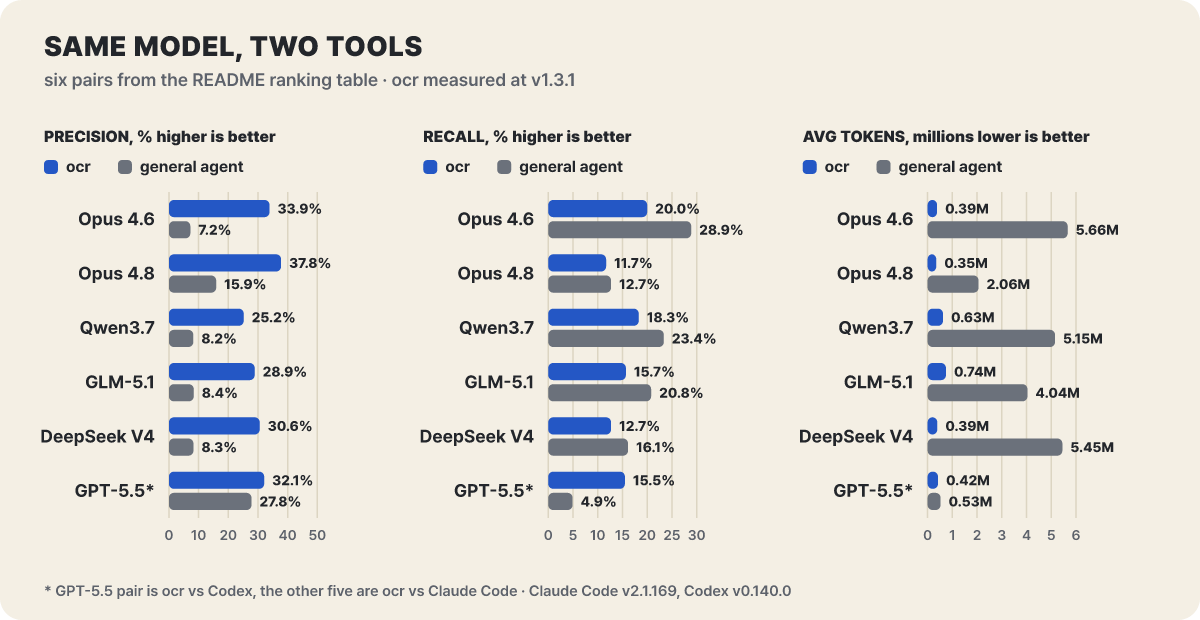 그림 4. 정밀도와 토큰은 ocr이 앞서고, 재현율은 Claude Code 쌍 다섯 곳 모두 범용 에이전트가 높다
ocr이 앞서는 쪽은 정밀도와 토큰입니다. 정밀도는 Claude Code 쌍 다섯 곳에서 2.4배(Claude-4.8-Opus)에서 4.7배(Claude-4.6-Opus)까지, 토큰은 5.4배(GLM-5.1)에서 14.7배(Claude-4.6-Opus)까지 적게 씁니다(편집부 계산). README가 말하는 “약 9분의 1”은 이 범위의 가운데쯤입니다. 반대로 재현율은 Claude Code 쌍 다섯 곳 모두 범용 에이전트가 높고, Codex 쌍(GPT-5.5)에서만 ocr이 높습니다. 나머지 값은 표로 봅니다. 괄호는 맞은 수 / 보고된 수입니다.
| 모델 | 도구 | F1 | 재현율 | 평균 시간 | 보고 수(맞은 수) |
|---|---|---|---|---|---|
| Claude-4.6-Opus | ocr | 25.10% | 20.00% | 1분 23초 | 889건 (301) |
| Claude-4.6-Opus | Claude Code | 11.57% | 28.90% | 13분 6초 | 5,980건 (435) |
| Claude-4.8-Opus | ocr | 17.90% | 11.70% | 1분 6초 | 465건 (176) |
| Claude-4.8-Opus | Claude Code | 14.13% | 12.70% | 5분 38초 | 1,200건 (191) |
| Qwen3.7-Max | ocr | 21.20% | 18.30% | 4분 41초 | 1,096건 (276) |
| Qwen3.7-Max | Claude Code | 12.17% | 23.37% | 8분 6초 | 4,260건 (351) |
| GLM-5.1 | ocr | 20.40% | 15.70% | 4분 11초 | 820건 (237) |
| GLM-5.1 | Claude Code | 11.93% | 20.80% | 14분 10초 | 3,742건 (313) |
| DeepSeek-V4-Pro | ocr | 17.90% | 12.70% | 6분 28초 | 624건 (191) |
| DeepSeek-V4-Pro | Claude Code | 10.93% | 16.13% | 14분 24초 | 2,945건 (243) |
| GPT-5.5 | ocr | 21.00% | 15.50% | 2분 51초 | 728건 (234) |
| GPT-5.5 | Codex | 8.36% | 4.92% | 2분 58초 | 266건 (74) |
“보고 수” 열이 체감을 바꿉니다. PR이 200건이므로 Claude-4.6-Opus 기준으로 PR 한 건에 달리는 지적은 ocr이 약 4.4개, Claude Code가 약 29.9개입니다(편집부가 보고 수를 200으로 나눈 값). Claude Code는 더 많은 결함을 맞히지만(435건 대 301건) 맞지 않는 지적 약 5,500건을 함께 내놓습니다. 사람이 PR마다 서른 개 가까운 지적을 하나씩 확인해야 한다면 “더 많이 찾았다”가 곧 더 쓸모 있다는 뜻은 아닙니다. 반대로 ocr은 정답 1,505건 중 301건(20%)만 맞혔으니 결함을 다 잡아 준다는 신호도 아닙니다. 앞 절들의 재검토가 지적을 걸러 내고 묶기·계획이 읽는 범위를 좁힌 구조가 이 거래와 방향이 같다는 것이 편집부 해석입니다.
이 표를 믿을 만큼만 믿는 데 필요한 사실이 셋 있습니다.
- 만든 곳이 같습니다. 평가 데이터셋 AACR-Bench는 알리바바 Aone 팀이 Hugging Face에 Apache-2.0으로 올렸고 ocr도 알리바바 프로젝트입니다. 데이터셋 카드는 정답 지적 1,505건과 오답 640건, 합계 2,145건이라고 설명하고, 같은 팀의 논문(arXiv 2601.19494)은 AI가 돕고 전문가가 검증하는 방식으로 원래 PR 댓글이 놓친 결함까지 찾아 결함 범위를 285% 넓혔다고 밝힙니다. 방법은 공개돼 있지만 내 코드에서 같은 비율이 나온다는 보장은 아닙니다.
- 측정한 버전이 다릅니다. 표의 ocr은 v1.3.1(Qwen3.8-Max 한 줄만 v1.8.7), Claude Code는 v2.1.169, Codex는 v0.140.0입니다. 지금 설치하는 ocr은 v1.13.3이라 표와 다른 버전입니다.
- 절대 수준이 높지 않습니다. 표의 어떤 조합도 F1 25.10%를 넘지 않습니다. 도구가 무엇이든 정답의 일부만 찾는다는 전제로, 사람 리뷰를 대체하기보다 먼저 한 번 걸러 주는 단계로 두는 편이 맞습니다.
설치하고 비용 손잡이 잡기
Git 2.41 이상이 필요하고 Git이 아닌 버전 관리는 지원하지 않습니다. 설치 방법은 다섯 가지(npm 권장, Homebrew, 설치 스크립트, 릴리스 바이너리, 소스 빌드)입니다. 한 가지 알아 둘 점은 npm으로 설치한 ocr가 기본적으로 스스로 업데이트한다는 것입니다. 실행할 때마다 백그라운드로 새 버전을 확인하고(간격 18분, OCR_UPDATE_INTERVAL로 조정) 있으면 바꿔 둡니다. 정적 바이너리에는 이 동작이 없고, 팀 환경에서 재현성이 필요하면 OCR_NO_UPDATE=1로 끕니다. 릴리스가 한 달에 열 번 나오는 프로젝트라서 같은 PR이 업데이트 전후로 다르게 리뷰될 수 있습니다.
- 설치:
npm install -g @alibaba-group/open-code-review - 모델 연결:
ocr config provider에서 제공자를 고르고 API 키를 넣으면 연결 시험까지 자동으로 합니다. 이후ocr config model로 모델을 바꿉니다. - 연결 확인:
ocr llm test로 작은 요청을 보내 봅니다. - 첫 리뷰: 프로젝트 폴더에서
ocr review. 분기 범위는--from main --to feature-branch, 커밋 하나는--commit abc123, diff 없이 폴더 전체는ocr scan --path internal/agent - 결과 보관:
--format json --output result.json으로 저장해 다른 도구가 읽게 합니다. GitHub Code Scanning용은--format sarif입니다.
내장 제공자는 25개입니다. Anthropic, OpenAI, Gemini, Amazon Bedrock, OpenRouter, DeepSeek, xAI, Kimi 같은 이름이 있고, 주소와 프로토콜을 직접 적는 사용자 정의 제공자도 됩니다. 이미 Claude Code를 쓰고 있다면 ANTHROPIC_BASE_URL·ANTHROPIC_AUTH_TOKEN·ANTHROPIC_MODEL 환경 변수를 그대로 알아봅니다. 키는 본인 계정의 것을 쓰고 채팅이나 저장소에는 올리지 않습니다. 로컬 모델은 도구 호출 기능(function calling)을 기본으로 지원해야 합니다. 도구 호출을 글자로 흉내만 내는 모델(문서는 deepseek-r1을 예로 듭니다)은 동작하지 않고 qwen3처럼 기본 지원하는 모델은 동작한다고 문서는 안내합니다.
도구는 무료지만 연결한 모델의 요금은 따로 듭니다. 문서가 알려 주는 조절 장치는 다음과 같습니다.
| 하고 싶은 일 | 옵션 | 동작 |
|---|---|---|
| 한 번 훑고 끝내기 | --effort low |
본 리뷰 1라운드. 가장 큰 절감 수단 |
| 더 꼼꼼히 | --effort high |
3라운드. 비용도 대략 라운드 수에 비례 |
| 총 토큰 상한 | --max-tokens-budget <n> |
입출력 합계가 넘으면 남은 그룹은 보내지 않고 failed(budget)으로 보고. 부분 결과는 게시하고 종료 코드는 0 |
| 병렬 수 | --concurrency <n> |
서브 에이전트 동시 실행 수(기본 8). 호출 제한에 걸리면 낮춤 |
| 요구 사항 전달 | --background "…" / -B 파일 |
변경 의도·중점 사항을 프롬프트에 넣음. 문맥을 먼저 주면 파일을 더듬는 횟수가 줄 수 있음 |
| 재검토 생략 | --no-filter |
지적 필터링용 LLM 호출 한 번을 줄임 |
| 시간 제한 | --timeout <분> |
그룹당 기본 15분, 라운드 수만큼 비례(15·30·45분) |
30개 파일을 건드린 대형 리팩터링 PR은 묶기와 계획이 모두 작동하고 그룹마다 라운드가 돌아 호출이 크게 늘어납니다. 자동 생성 파일이 섞여 있으면 diff만으로 입력 상한의 80%를 넘어 token_threshold_exceeded 경고와 함께 그 그룹이 통째로 건너뛰어질 수 있으니, 먼저 --preview로 대상을 보고 생성 파일을 exclude에 넣거나 커밋을 쪼개 --commit으로 하나씩 보는 편이 낫습니다.
코드는 어디로 가는지도 짚어 둡니다. 변경된 diff와 읽기 도구가 가져온 코드 조각이 설정한 모델 엔드포인트로 갑니다. 세션 기록과 규칙 파일은 내 컴퓨터에만 있습니다. 비밀 값을 자동으로 가려 주는 기능은 아직 없습니다(공식 FAQ는 로드맵에 있다고 적습니다). 비밀을 커밋하지 않고, 해시류가 든 파일은 exclude에 넣고, 커밋 전 마스킹으로 diff에서 비밀을 빼라는 안내입니다. MCP 서버를 연결하면 에이전트가 쓰는 도구의 인자(검색어, 요청 주소, 맥락)가 그 서버 운영자에게 갑니다.
키 없이 엔진만 빌리는 위임 모드와 CI
ocr이 모델을 한 번도 부르지 않는 모드가 있습니다. 위임 모드(Delegation Mode)에서는 ocr delegate preview가 대상 파일과 제외 사유를 내놓고, ocr delegate rule <파일…>이 파일별 규칙을 묶어 내놓으면, 실제 리뷰는 쓰고 있는 코딩 에이전트가 자기 모델로 수행합니다. 에이전트는 git diff·show·blame 같은 명령으로 diff와 맥락을 읽고, 파일마다 검토했는지 건너뛰었는지를 사유와 함께 기록해 총 파일 수·검토 수·건너뜀 수·검토 비율(coverage_rate)을 보고하게 되어 있습니다. 대상은 Claude Code, Codex, Cursor, Open Code, Qoder 같은 구독형 에이전트입니다.
기본 방식 (ocr이 모델 호출)
- 묶기, 계획, 본 리뷰, 위치 재조정, 재검토까지 위 그림 1의 전체 흐름이 돔
- 별도 API 키와 모델 설정이 필요
- 벤치마크 값이 나온 방식이 이쪽
위임 모드 (에이전트가 모델 호출)
- ocr은 파일 선별과 규칙 선택까지만 담당
- 구독형 에이전트의 한도를 쓰므로 키를 하나 더 만들지 않음
- 묶기·재검토·위치 재조정은 돌지 않음
위임 모드는 “키를 아끼는 대신 엔진의 앞쪽만 가져오는” 선택입니다. 벤치마크에서 본 정밀도 이점이 그대로 따라온다고 기대하면 안 됩니다. Claude Code 플러그인은 /plugin marketplace add alibaba/open-code-review와 /plugin install open-code-review@open-code-review로 붙이고, /open-code-review:review와 /open-code-review:delegate-review 명령이 생깁니다. 주의할 점은 /open-code-review:review의 기본 동작이 자동 수정이라는 것입니다. 공식 문서가 밝힌 대로 이 명령은 채택할 만한 High·Medium 지적을 코드에 바로 적용하고 Low는 조용히 버립니다. 먼저 묻고 고치는 쪽은 Agent Skill 방식이고, 변경을 확인하고 싶다면 로컬 명령 파일의 프롬프트를 고치라고 안내합니다. ocr 자체는 고치지 않으며, 로드맵도 사람 승인 없는 자동 수정을 “계획 없음”으로 적어 둡니다.
CI에서는 GitHub Actions 예제가 가장 자세합니다. PR에 변경이 생기면 줄 단위 댓글과 요약을 남기고, 저장소 구성원·소유자·협업자가 댓글에 /open-code-review를 달면 다시 돕니다. 연결 전에 챙길 것은 다음과 같습니다.
- 저장소 시크릿
OCR_LLM_URL,OCR_LLM_AUTH_TOKEN과 변수의 모델명·Anthropic 사용 여부를 넣었습니까. - 예제는
pull_request_target을 써서 포크 PR에도 시크릿이 전달됩니다. 문서는 “diff만 읽고 PR의 코드를 실행하지 않는다”고 설명하므로, 이 구조를 이해하고 쓰십시오. effort와max_tokens_budget입력으로 PR당 비용 상한을 정하십시오.- PR 제목 같은 값은
run에 직접 끼워 넣지 말고env로 전달하십시오(예제 문서의 안내). - 설치 단계의 버전을 고정하십시오(워크플로 기본은 최신 설치).
화면 없이 파이프라인에서 돌릴 때는 --audience agent로 진행 표시를 끄고 JSON만 받습니다. JSON의 session_id로 중단된 범위·커밋 리뷰를 --resume으로 이어갈 수 있고, 같은 대상·같은 규칙·같은 모델일 때만 허용됩니다. 조건이 어긋나면 아무것도 쓰지 않고 거절합니다.
같은 문제를 다른 설계로 푸는 도구들
ocr이 겨누는 상대는 범용 에이전트에 리뷰 스킬을 붙이는 방식입니다. 오픈소스 PR 리뷰어로는 커뮤니티가 유지하는 PR-Agent도 널리 알려져 있습니다. 설계의 차이만 견줍니다. 점수는 평가 방식이 달라 나란히 놓지 않았습니다.
| 범용 에이전트 + 리뷰 스킬 | PR-Agent | Open Code Review | |
|---|---|---|---|
| 리뷰 흐름을 정하는 쪽 | 모델의 재량 | 도구(/review, /improve, /ask)별 프롬프트 |
엔진이 파일 선별·규칙 선택·그룹 한도를 정하고 모델은 그룹 안에서 판단 |
| LLM 호출 방식 | 대화형 도구 사용 | 도구당 호출 1회(README 설명) | 그룹마다 서브 에이전트가 도구를 쓰며 여러 라운드 |
| 규칙 | 스킬 문서의 자연어 | 설정 파일로 프롬프트·카테고리 조정 | 경로 패턴별 규칙, 4층 우선순위, ocr rules check로 확인 |
| 실행 환경 | 에이전트 안 | GitHub Action, CLI, Docker, 웹훅 | CLI, 에이전트 플러그인, CI 예제, 위임 모드 |
재현율이 최우선이라면 지금의 ocr은 맞지 않을 수 있습니다. 로드맵에는 재현율을 높이는 대신 토큰과 시간을 더 쓰는 Ultra 모드(올해 하반기 계획), JetBrains 플러그인, 2027년 상반기의 장기 기억이 올라 있고, ACP 서버 어댑터는 로컬 소스 빌드에서만 쓸 수 있는 실험 단계입니다. 설치부터 시험하려면 모델 키 없이 되는 ocr delegate preview로 내 변경 중 무엇이 리뷰 대상이고 무엇이 어떤 사유로 빠지는지부터 확인하는 것이 가장 싼 출발점입니다. 테스트 파일이 기본으로 빠진다는 사실을 처음 본다면 이 도구의 관문을 이해한 것입니다.



