매개변수는 커졌는데 메모리는 4분의 1, DeepSeek V4.1 Flash의 KV 캐시 다이어트
DeepSeek V4.1 Flash의 4분의 1, 8분의 1, 890바이트는 각각 다른 것을 센 값입니다. 40개 층 중 네 층이 890을 만들고, 가중치 511GB는 이 숫자 밖에 있습니다.
DeepSeek V4.1 Flash의 “메모리 4분의 1”은 한 숫자가 아니라, 서로 다른 세 곳에 붙은 세 숫자입니다. GPU 메모리(HBM)에 항상 올라가는 전역 KV 캐시는 토큰당 890바이트로 V4 Flash의 약 4분의 1이고, SSD나 호스트 메모리에 남기는 영구 캐시는 약 8분의 1이며, 첫 세대인 DeepSeek-V1과 견주면 약 437분의 1입니다. 890바이트는 40개 층이 나눠 낸 값이 아니라 새 KV를 만드는 네 개 층만의 합이고, 이 합은 매개변수가 2,840억에서 5,520억 개로 거의 두 배가 된 것과 상관없이 줄었습니다. DeepSeek이 9월 10일 공개하고 9월 17일 기술 보고서(arXiv 2609.19969, 제목 “Pushing the Limits of KV Cache Compression”)로 설명한 구조입니다. 이 글에서 날짜는 모두 UTC 기준입니다.
그사이 바뀐 것은 모델과 엔진 쪽입니다. 10월 17일 모델이 1017 버전으로 교체됐는데, 1017 저장소의 설정 파일에서 KV와 관련된 값(층 수 40, KV를 만드는 층 번호, 인덱서 후보 크기, 최근 창 128)을 9월 체크포인트와 대조하면 모두 같습니다. 그래서 아래 숫자는 지금 내려받는 1017에도 그대로 맞습니다. vLLM은 출시 첫날부터 이 모델을 지원했고 10월 7일 블로그에서 처리량을 크게 끌어올린 과정을 공개했으며, 10월 25일에 갱신된 vLLM 레시피는 1017을 권장 체크포인트로 안내합니다. 이 글은 숫자를 하나씩 집어, 무엇을 센 값인지와 비교 기준이 무엇인지를 읽는 순서로 진행합니다.
숫자 여섯 개와 각자의 분모
같은 “줄었다”라도 분모가 다르면 다른 이야기입니다. 아래 표는 보고서와 모델 카드에 나오는 숫자 여섯 줄을, 무엇을 센 값인지와 비교 대상으로 나눈 것입니다.
| 숫자 | 센 것 | 비교 기준 |
|---|---|---|
| 890바이트 | 토큰 하나가 HBM에 남기는 전역 KV(주 KV와 인덱서 키) | 절댓값, 비교 대상 없음 |
| 약 4배 작음, 약 437배 작음 | 같은 전역 KV의 토큰당 크기 | 각각 V4 Flash, DeepSeek-V1 |
| 약 8분의 1 | 같은 작업 부하에서 SSD·호스트 메모리에 남기는 영구 캐시 | V4 Flash |
| 8B, 16B | 토큰 하나에 켜지는 매개변수(프리필, 생성) | 총 5,520억 개 중 |
| 72시간 이상, 분 단위 | 전역 KV와 SWA KV가 캐시에 머무는 시간 | 서로를 비교 |
| 256배에 1/4 증가 | 문맥 4천에서 100만 토큰으로 늘렸을 때 토큰 하나 디코드 연산량 | 4천 토큰일 때의 값 |
여섯 줄에 공통으로 빠진 것이 있습니다. 모든 층에 붙은 최근 128토큰 창(SWA) 캐시, 모델 가중치, 계산 중간값은 890바이트에 들어 있지 않습니다. 이 글의 뒷부분이 이 바깥 숫자까지 가져와 읽습니다.
문맥 1M까지 쌓이는 높이
먼저 890바이트가 문맥 길이에 따라 얼마가 되는지 봅니다. 아래 그림은 세 세대의 토큰당 크기에 토큰 수를 곱해 GB로 바꾼 선이고, 세로축이 로그라서 한 칸이 10배입니다. 점선 가로선은 H200 한 장의 메모리 141GB입니다.
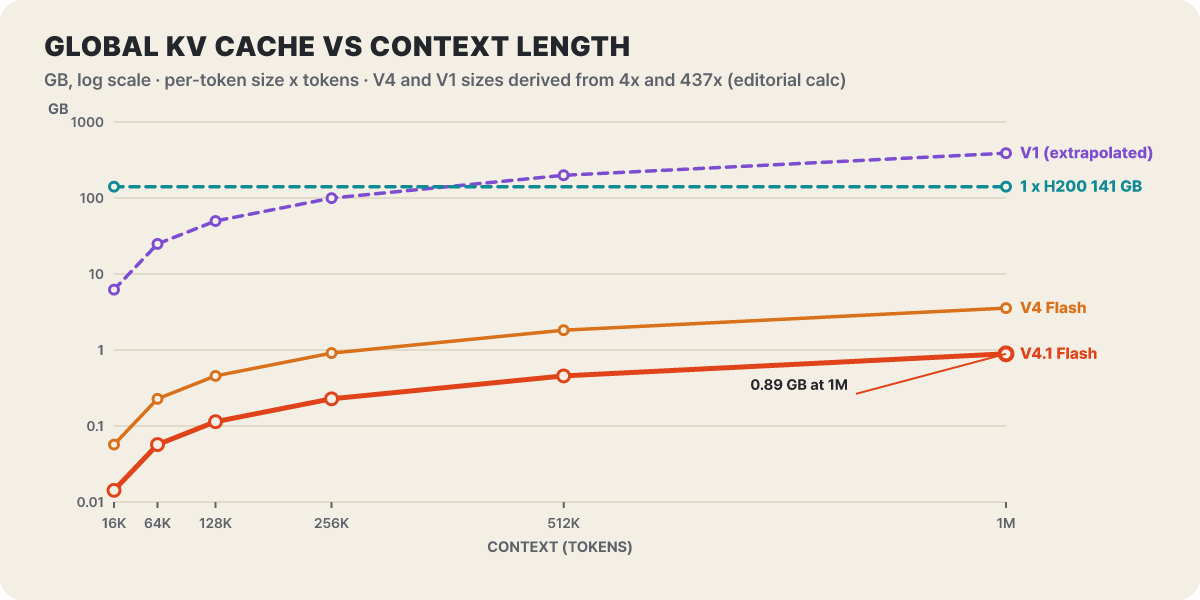 그림 1. 문맥 길이별 전역 KV 총량. V4 Flash와 V1 선은 보고서가 밝힌 “약 4배”, “약 437배”를 890에 곱한 편집부 계산이며, V1은 이 길이를 실제로 지원하지 않으므로 환산선입니다
V4.1 Flash의 선은 100만 토큰에서 0.89GB입니다. 같은 길이에서 V4 Flash는 약 3.6GB, V1 구조를 그대로 늘렸다면 약 389GB가 되어, 약 36만 토큰에서 H200 한 장을 이미 넘습니다. 세 선이 평행한 것도 눈여겨볼 만합니다. 문맥이 두 배면 캐시도 두 배로 정직하게 늘어서, 구조가 바꾼 것은 기울기가 아니라 시작 높이입니다. 100만 토큰 세션 하나가 1GB를 넘지 않는다는 것이 이 그림의 요점이고, 그래서 세션 수십 개를 한 서버에 쌓는 계산이 처음으로 가능해집니다.
40개 층 중 바이트를 쓰는 곳은 넷
890바이트는 40개 층에 고르게 나뉜 값이 아닙니다. 그림 2는 40개 층을 한 칸씩 놓고, 새 KV를 쓰는 층만 주황으로 칠했습니다.
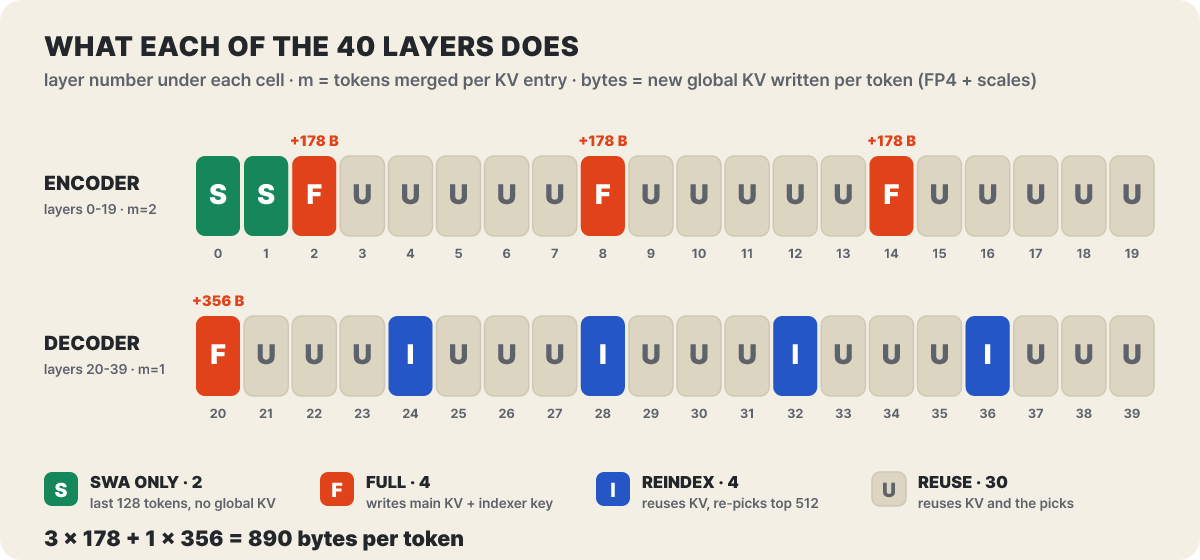 그림 2. 40개 층의 역할(층 번호는 0부터). 층 번호는 공개 설정 파일의 값이고 바이트는 편집부 계산
주황 칸은 인코더의 2·8·14번과 디코더의 20번, 모두 네 개입니다. 칸마다 하는 일이 다릅니다.
- Full: 자기 주 KV와 인덱서 키를 새로 만들고, 읽을 위치 512곳도 직접 고릅니다.
- Reindex: 앞 층의 주 KV와 인덱서 키를 그대로 쓰되, 자기 질의로 읽을 위치만 다시 고릅니다. 디코더의 24·28·32·36번입니다.
- Reuse: KV도 읽을 위치도 앞 층의 것을 씁니다. 인덱서 질의를 만들지도 점수를 매기지도 않아, 보고서 기준 프리필 커널 15개, 디코드 커널 11개로 돕니다. 30개 층입니다.
- SWA 전용: 맨 앞 두 층(0, 1번)은 전역 어텐션 없이 최근 128토큰만 봅니다.
회의록으로 바꿔 보면
Full은 회의에 직접 들어가 회의록을 쓰는 사람, Reuse는 앞 사람의 회의록을 그대로 읽는 사람, Reindex는 같은 회의록을 읽되 자기 일과 관계있는 대목에 새로 형광펜을 긋는 사람입니다. 회의록은 네 부만 쓰이고, 나머지는 그 네 부를 돌려 봅니다. 읽는 일은 모두 하므로 계산이 공짜인 것은 아니고, 줄어드는 것은 보관해 둘 회의록의 두께입니다.
Reindex가 읽을 곳을 고르는 방식도 두 단계입니다. 디코더의 첫 Full 층(20번)이 보이는 모든 위치를 훑어 후보 풀 16,384곳(블록 2,048개에 블록당 위치 8개)을 만들면, 뒤의 Reindex 층들은 그 풀 안에서만 점수를 매겨 상위 512곳을 고릅니다. 문맥이 100만 토큰이어도 뒤 층의 탐색 범위는 16,384로 고정이고, 비싼 전체 훑기는 한 번뿐입니다.
890이 맞아떨어지는 계산, 모두 새로 만들면 10,324
보고서는 890이라는 총합만 적고 항목별 표는 싣지 않았습니다. 그러나 공개된 저장 형식으로 직접 더하면 890이 정확히 나옵니다. 주 KV는 FP4(E2M1, 값 하나에 0.5바이트)로 저장하고 16채널마다 8비트 스케일을 붙이며, 인덱서 키는 MXFP4를 씁니다. 항목 하나의 크기는 다음과 같습니다(편집부 계산).
- 주 KV 한 항목: 512값 × 0.5바이트 + 스케일 32바이트 = 288바이트
- 인덱서 키 한 항목: 128값 × 0.5바이트 + 스케일 4바이트 = 68바이트
- 인코더는 토큰 2개를 KV 한 항목으로 묶으므로 토큰당 절반(144 + 34 = 178), 디코더는 묶지 않아 356
인코더 Full 3층은 178 × 3 = 534, 디코더 Full 1층은 356이라 합이 890입니다. 같은 형식에서 “38개 CSA 층이 모두 Full이라면”을 계산하면 인코더 18층 × 178 = 3,204에 디코더 20층 × 356 = 7,120을 더한 10,324바이트로, 층 간 재사용 하나만으로 11.6배 차이가 납니다.
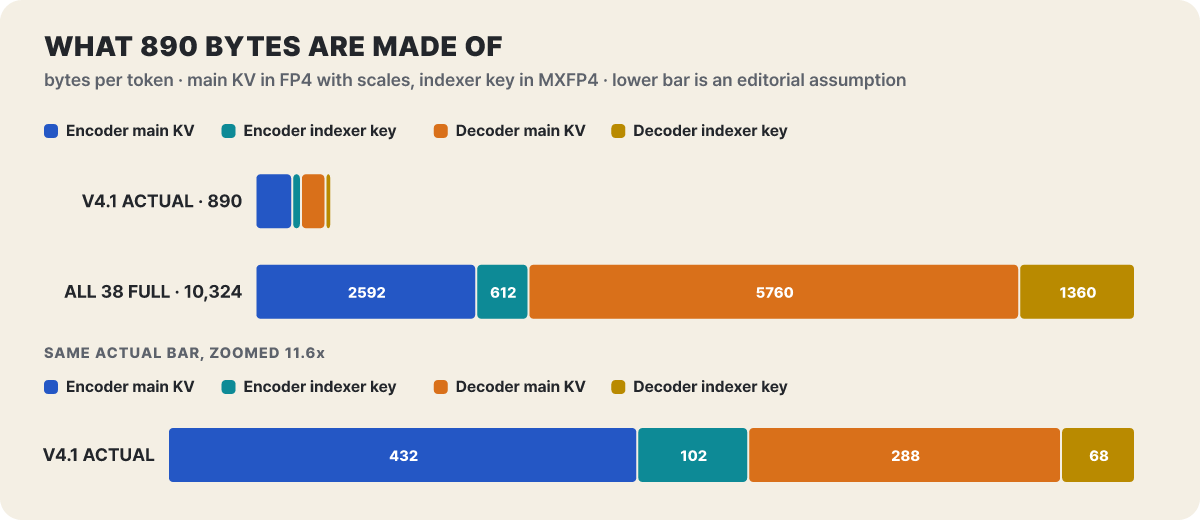 그림 3. 같은 눈금 위의 890 대 10,324(위쪽 두 줄)와 실제 890을 11.6배 확대한 구성(아래 줄). 아래쪽 10,324는 모든 층이 Full이라는 편집부의 가정값
실제 값은 인코더 주 KV(432)가 절반 가까이를 차지하고, 인덱서 키 둘을 합쳐도 170바이트입니다. 읽을 곳을 고르는 장치 자체는 싸다는 뜻입니다. 다만 10,324는 V4 Flash의 실제 크기(약 3,560)와는 다른 구조의 가정이니, 두 숫자를 같은 눈금에 놓고 우열을 읽으면 안 됩니다.
4비트로 내린 정밀도에 대한 숫자도 있습니다. FP4는 표현 범위가 좁지만, 보고서는 16채널마다 스케일을 붙이는 방식이라 표현할 수 있는 최댓값이 2,688(448 × 6)에 이르고, 회전 위치 인코딩(RoPE)을 거친 뒤의 KV 값은 그보다 한참 아래인 약 22.6 안에 머문다고 설명합니다. 양자화는 RoPE 뒤에 적용하고 학습 때부터 양자화를 고려했습니다. 결과로 V4의 FP8 주 KV보다 저장 공간이 대략 절반입니다. SWA KV는 압축 없이 FP8로 두고 문맥 길이와 무관하게 고정 크기라서 890에는 들어 있지 않습니다.
프리필은 인코더에서 멈춘다
890바이트가 어디서 만들어지는지는 모델을 지나가는 경로를 따라가면 보입니다. 아래 그림에서 왼쪽 상자는 긴 프롬프트를 읽는 프리필이 지나가는 곳, 오른쪽은 답을 생성할 때 더해지는 곳입니다.
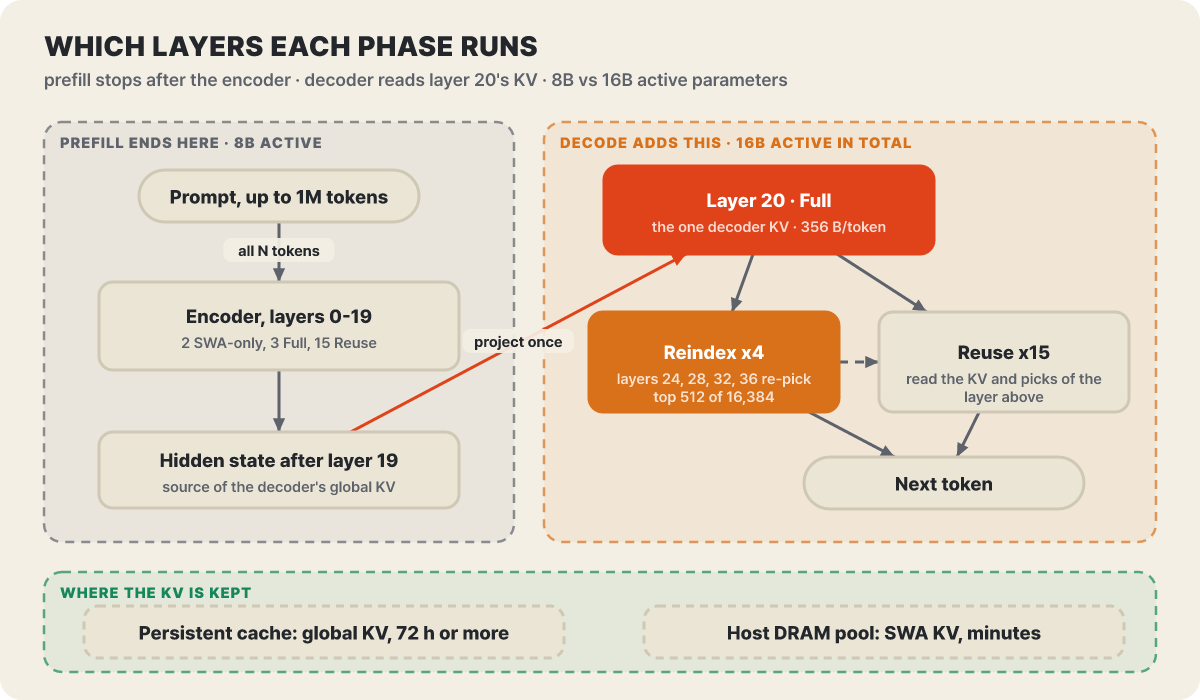 그림 4. 프리필과 생성이 지나는 층. 활성 매개변수 8B와 16B는 모델 카드 값, 보관 시간은 보고서 값
프롬프트는 인코더 20개 층만 지나면 프리필이 끝나서, 켜지는 매개변수가 약 80억 개입니다. 디코더의 전역 KV는 디코더 층이 자기 상태에서 만들지 않고 인코더 마지막 은닉 상태에서 20번 층이 한 번 투영해 얻으며, 나머지 디코더 층은 그것을 이어 씁니다. 생성 단계에서는 인코더와 디코더를 모두 거치니 약 160억 개가 켜집니다. 보고서는 프리필 복잡도가 층 수 L, 토큰 수 N에서 N·L이던 것이 N·L/2에 최근 창 몫(n_win·L/2)을 더한 값으로 줄어 연산이 대략 절반이 된다고 설명합니다. 에이전트가 도구를 한 번 호출할 때마다 긴 이력을 다시 읽는 장면이라면 이 절반이 곧 대기 시간입니다.
문맥이 길어져도 토큰 하나를 만드는 연산이 거의 늘지 않는다는 숫자는 조건을 알고 읽어야 합니다. 보고서의 그림 2는 문맥을 4천에서 100만 토큰으로 256배 늘렸을 때 토큰 하나의 디코드 연산량이 1/4만 늘어난다고 보여 주는데, 이때 연산량은 정밀도로 가중해 셉니다(BF16 ×1, FP8 ×0.5, FP4 ×0.25). FP4로 처리하는 연산이 많을수록 같은 연산도 숫자가 작게 잡히므로, 이것은 칩의 실제 소요 시간이 아니라 구조의 연산량 비교입니다.
이 발상의 뿌리는 2024년 5월의 연구들입니다. 5월 7일 DeepSeek-V2의 MLA가 KV를 잠재 벡터로 줄였고(논문 초록 기준 67B 모델 대비 93.3% 감소), 5월 8일 YOCO가 아래쪽 디코더에서 전역 KV를 한 번만 만들어 위쪽이 쓰게 했으며, 5월 21일 CLA가 인접 층끼리 키·값 헤드를 공유했습니다. V4.1은 이 가운데 층 간 공유 쪽을 이어받아 희소 인덱서, FP4 저장, 최근 창 복원을 한 모델에 겹쳤습니다.
8분의 1은 4분의 1과 다른 곳에서 왔다
영구 캐시의 8분의 1은 890바이트의 4분의 1과 같은 이야기가 아닙니다. V4는 전역 KV의 전체 접두사에 더해 SWA KV도 프롬프트 끝과 출력 끝에서 따로 보관했고, 보고서에 따르면 SWA KV가 영구 캐시 용량의 거의 절반을 차지했습니다. V4.1은 SWA KV를 영구 캐시에서 빼서 절반을 덜고, 남은 전역 KV가 4분의 1로 줄어 합쳐서 8분의 1이 됩니다.
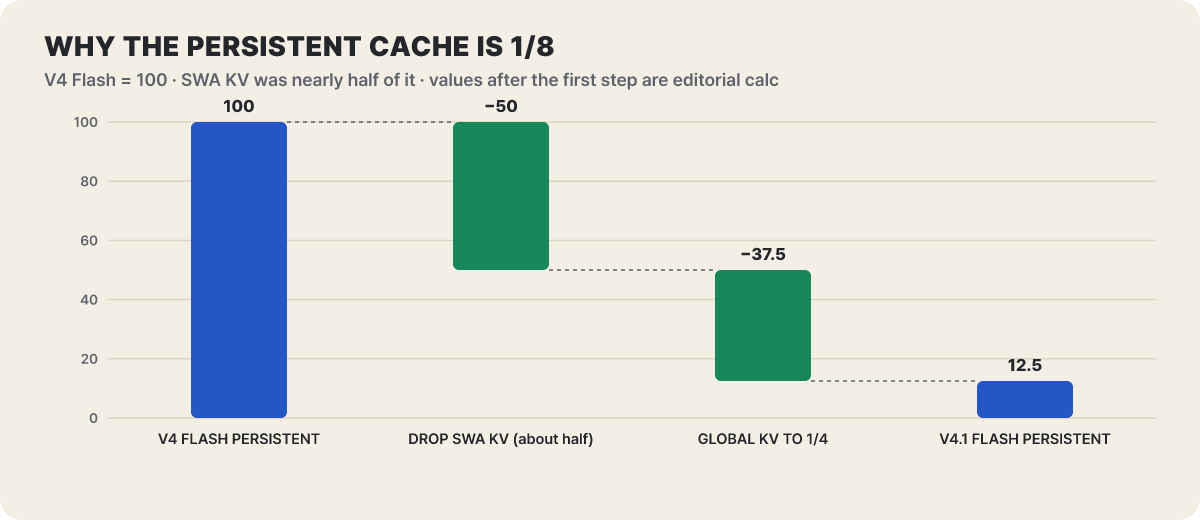 그림 5. 영구 캐시 100이 12.5(8분의 1)가 되는 과정. 첫 단계는 “거의 절반”이라는 보고서 설명을 50으로 놓은 편집부 계산이고, 둘째 단계는 남은 50의 4분의 1입니다
두 캐시는 수명도 다릅니다. 전역 KV는 같은 긴 접두사가 다시 올 때 재사용하도록 영구 캐시에 최소 72시간 보장해 두고, SWA KV는 각 머신 호스트 메모리(DRAM)의 10%로 만든 분산 풀에 분 단위 수명으로만 둡니다. 풀에서 SWA 상태가 사라진 뒤 같은 접두사가 다시 오면 SWA 경계 재실행으로 접두사 끝 128토큰을 다시 읽어 인코더 쪽 상태를 복원합니다. 정확히 복원하려면 층 수 L에 128을 곱한 만큼의 토큰을 다시 통과시켜야 하지만 마지막 128토큰만 읽는 근사로 줄인 것입니다. 디코더 쪽은 매번 프리필에서 프롬프트 마지막 128토큰을 인코더 출력으로 디코더 층에 통과시켜 첫 디코드 단계에만 쓰고, 이 상태는 접두사 캐시에 저장하지 않습니다.
그러면 저장은 아끼고 계산이 조금 늘어나는 거래입니다. 보고서는 평가한 설정에서 체계적인 성능 저하는 보지 못했다고 밝히고, vLLM도 이 재실행을 구현한 뒤 GSM8K와 GPQA에서 의미 있는 차이를 보지 못했다고 보고했습니다(표준오차 약 1.5 이내).
설정 파일로 890을 다시 세기
가중치를 받지 않아도 3KB짜리 설정 파일 하나로 위의 층 배치와 890을 직접 확인할 수 있습니다. 아래 스크립트는 1017 저장소의 config.json을 읽어, 층마다 압축 비율과 두 가지 층 번호 목록으로 역할을 가르고 Full 층의 바이트를 더합니다. 288과 68은 앞 절에서 계산한 항목 크기입니다.
curl -sL https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017/raw/main/config.json -o config.json
python3 - <<'PY'
import json
c = json.load(open("config.json"))["text_config"]
kv, ix = set(c["kv_source_layer_ids"]), set(c["index_source_layer_ids"])
cr = c["compress_ratios"]
kinds, total = {}, 0
for i in range(c["num_hidden_layers"]):
    k = "swa-only" if cr[i] == 0 else "full" if i in kv else "reindex" if i in ix else "reuse"
    kinds.setdefault(k, []).append(i)
    if k == "full":
        total += (512 * 0.5 + 32 + 128 * 0.5 + 4) / cr[i]
print("compress_ratios entries:", len(cr))
for k, v in kinds.items():
    print(f"{k:9s}{len(v):3d}", v if len(v) < 9 else v[:3] + ["..."])
print("global KV bytes per token:", total)
PY
compress_ratios entries: 43
swa-only 2 [0, 1]
full 4 [2, 8, 14, 20]
reuse 30 [3, 4, 5, '...']
reindex 4 [24, 28, 32, 36]
global KV bytes per token: 890.0kv_source_layer_ids가 2, 8, 14, 20이라는 것이 “새 KV를 만드는 층은 넷”의 근거이고, index_source_layer_ids에 24·28·32·36이 더해져 Reindex가 됩니다. 압축 비율 목록은 앞 두 층이 0(전역 어텐션 없음), 그다음 18개 층이 2, 디코더 20개 층이 1인데, 목록 길이가 43이라 뒤에 0이 세 개 더 붙어 있습니다. 스크립트는 앞 40개만 층으로 읽었고, 그 결과 합이 890.0으로 나옵니다. candidate_topk_blocks 2,048, candidate_block_size 8, index_topk 512도 같은 파일에서 읽을 수 있어 앞의 16,384와 512가 여기서 나왔습니다.
890 바깥의 숫자들
이 숫자들을 서버 한 대의 용량 계산에 쓰려면 890 바깥 숫자가 필요합니다. 100만 토큰 세션의 전역 KV 0.89GB가 작은 이유는 캐시가 작아서이기도 하지만, 옆에 놓인 가중치가 너무 커서이기도 합니다. vLLM 레시피가 적은 값은 다음과 같습니다.
- 체크포인트 크기
- 약 511GB(476GiB). 이 중 Engram 표 183.1GiB, 라우팅 전문가 259.5GiB
- 최소 VRAM
- 614GB(여유 계수 1.2 포함)
- H200 8장 노드
- 1,128GB에 올라가고, TP4와 Engram 오프로드에서는 GPU당 가중치 81.2GiB에 KV 38.5GiB
- 전역 KV 1M 토큰
- 0.89GB, 체크포인트의 약 0.17%(편집부 계산)
- 고정 몫
- 층마다 최근 128토큰의 SWA KV(압축 없이 FP8), 문맥 길이와 무관
레시피는 같은 자리에서, 용량을 정하는 것은 대개 가중치와 배치 크기이지 캐시가 아니므로 문맥과 배치가 들어가는지는 먼저 재 보라고 적어 둡니다. 가중치가 511GB이고 캐시가 1GB 안쪽이면 캐시를 4분의 1로 줄이는 일의 이득은 “더 많은 세션”과 “더 긴 문맥”에서 나오지 “더 작은 서버”에서 나오지 않는다는 뜻입니다. 문맥이 짧을수록 고정 몫(SWA KV)이 890 쪽을 압도하는 비율도 커집니다.
vLLM의 5.3배는 무엇 대비인가
엔진이 만든 숫자는 모델 숫자와 분모가 또 다릅니다. vLLM은 V4.1 Flash를 출시 첫날(9월 10일)부터 지원했고 이 아키텍처가 처음 들어간 버전은 0.30.0이며, 10월 25일 갱신된 레시피는 0.31.0 이상을 요구합니다. 10월 7일 블로그가 내건 처리량 개선 폭은 다음 조건에서 나온 값입니다.
| 지표 | 값 | 조건과 비교 기준 |
|---|---|---|
| 저지연 처리량 | 1.9배 | SemiAnalysis AgentX, TP4 + FlashInfer, vLLM의 출시 첫날 구현 대비 |
| 고처리량 | 약 5.3배 | 같은 AgentX, DEP2, 150 TPS 제약, 같은 기준 |
| 첫 토큰 시간(TTFT) | 약 70% 감소 | 처리량 약 100K 부근, 세 가지 최적화 결합 |
| 디코더 재실행 + CUDA 그래프 | 프리필 계산 시간 30~40% 감소 | 단일 요청, GB200, 접두사 캐시 끔, 중앙값 3회 |
기준선이 모델의 이전 버전이 아니라 vLLM 자신의 첫날 구현이라는 점이 핵심입니다. 5.3배는 DeepSeek이 모델에서 만든 개선이 아니라, 엔진이 이 구조를 제대로 쓰도록 다듬은 개선입니다. 같은 블로그에서 구조를 구현한 방식도 읽힙니다. 디코더 층 20은 모든 토큰에 실행하지만 층 21~39는 요청마다 마지막 128토큰에만 실행하고, 접두사 캐시 적중 시 SWA 경계 재실행은 기본으로 켜져 있어 --no-swa-bounded-replay로 끌 수 있습니다. CUDA 그래프가 없으면 짧은 프롬프트에서 재실행이 기준선보다 느려서, DEP2·1K 토큰에서 최대 12% 느렸다고 합니다.
저장 형식도 엔진과 하드웨어에 따라 갈립니다. 블로그는 NVFP4로 압축한 KV가 이전 FP8 KV 캐시보다 45% 작다고 적었고, 레시피의 Blackwell 설정에는 --kv-cache-dtype fp8과 인덱서 mxfp4가 함께 들어 있습니다. 890바이트는 DeepSeek이 정의한 구조에서 센 값이고, 올린 엔진이 같은 형식으로 저장하는지는 엔진의 문서와 실제 GPU 메모리 사용량으로 확인하는 것이 맞습니다. KV 오프로딩은 블로그의 벤치마크 전반에서 필요하지 않았고, 동시 사용자가 많거나 프리필과 디코드를 서버로 나누는 환경에서 도움이 될 것으로 기대한다고만 적혀 있습니다.



