에이전트가 파일을 다 읽지 않아도 되게 코드 구조를 기억하는 MCP 서버
codebase-memory-mcp의 토큰 10분의 1은 31개 언어·12개 질문 시험에서 점수 0.92를 0.83으로 내리고 얻은 값입니다. 120배가 10배로 바뀐 사연과 설치, 내 저장소에서 재측정하는 법을 읽습니다.
codebase-memory-mcp를 소개하는 글마다 따라붙는 “토큰 10분의 1”은 답변 품질 점수를 0.92에서 0.83으로 낮춘 값과 한 쌍입니다. 이 도구는 저장소를 한 번 색인해 함수·클래스·호출 관계를 로컬 SQLite 그래프로 저장하고, 코딩 에이전트가 파일을 열어 보는 대신 MCP(AI에게 도구를 붙이는 표준 규약)로 그 그래프를 질의하게 합니다. 구문 분석(tree-sitter)과 타입 해석으로 그래프를 만들 뿐 코드를 읽는 데 AI 모델을 쓰지 않고, 질문을 도구 호출로 바꾸는 일은 쓰는 에이전트가 맡습니다. MIT 라이선스이고, 2026년 10월 27일(UTC) GitHub 기준 별 47,549개·포크 3,911개·이슈와 풀 리퀘스트 합쳐 627건이며 최신 릴리스는 10월 16일의 v0.12.1입니다. 논문에 따르면 첫 공개 4주 뒤 별이 900여 개였는데, 지금은 4만 7천 개를 넘었습니다.
이 글은 그 인기를 떠받치는 숫자들을 하나씩 읽습니다. 숫자마다 누가, 어떤 버전으로, 무엇을 상대로 쟀는지를 따라가고, 마지막에는 같은 표를 내 저장소에서 다시 채우는 순서까지 갑니다.
같은 도구, 120배와 10배 두 가지 숫자
이 프로젝트의 옛 README는 머리말에 “토큰 120배 절감”을 내걸었습니다. 구조 질문 다섯 개를 던졌을 때 그래프로는 약 3,400토큰이 들었고, 파일을 하나씩 검색하고 읽는 방식으로는 약 412,000토큰이 들었다는 것입니다. 나눠 보면 121배이고, 옛 README는 이를 99.2% 절감이라고도 적었습니다. 지금의 README는 그 문구를 머리말에서 내리고 논문의 값을 앞에 둡니다. 31개 저장소를 대상으로 한 사전 공개 논문이 보고한 “토큰 10배 감소, 도구 호출 2.1배 감소”를 “2026년 3월의 측정”이라 못 박고, 옛 다섯 질의 비교는 “이전의 비교”라는 한 줄로만 남깁니다.
두 숫자는 같은 잣대가 아닙니다. 옛 README의 값은 구조 질의 다섯 개에서, 논문의 값은 12개 질문 유형을 31개 언어의 저장소 각각에 던진 시험에서 나왔습니다. 논문의 질문에는 소스 줄을 그대로 읽어야 하는 것과 모든 호출 지점을 빠짐없이 찾는 것도 섞여 있습니다.
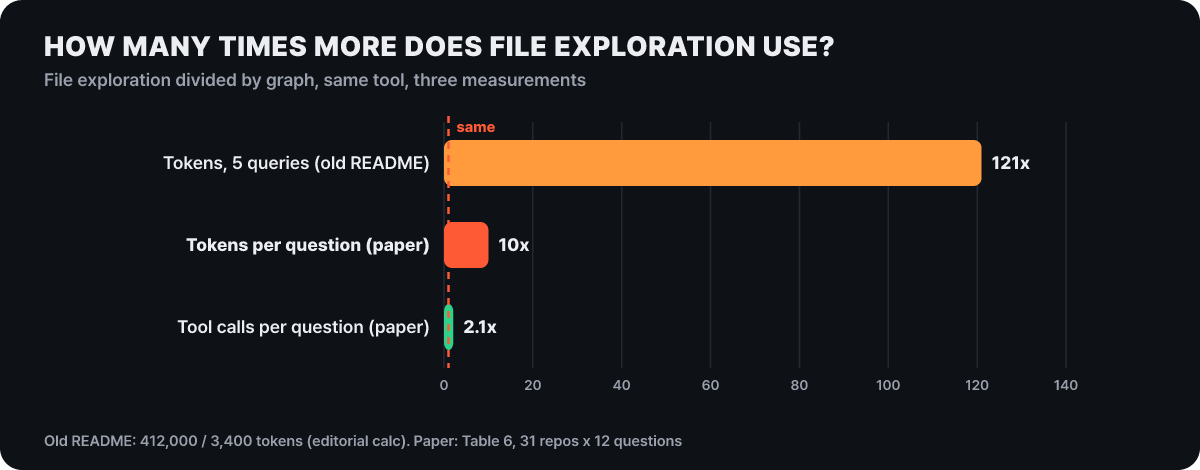 그림 1. 같은 도구에 붙은 세 배율. 121배는 옛 README의 412,000과 3,400토큰을 편집부가 나눈 값이다
배율은 시험이 넓어지면서 121배에서 10배로 내려왔고, 도구 호출은 2.1배입니다. 내 저장소에서 나올 값은 내가 던지는 질문의 구성이 정합니다. 그래서 아래에서는 논문의 10배가 만들어진 조건부터 열어 봅니다.
10배가 나온 시험대의 구조
논문은 arXiv 2603.27277(2026년 3월 28일 제출, 현재 v1만 있음)이고, 평가 대상은 릴리스 v0.5.5입니다. 당시 도구는 14개, 해석 가능한 언어는 66개였고, 지금(v0.12.1)은 도구 17개와 파서 문법 162개입니다. 시험은 31개 프로그래밍 언어마다 실제 오픈소스 저장소를 하나씩 골랐습니다. 가장 작은 쪽은 Terraform(HCL)의 노드 78개, 가장 큰 쪽은 Django(Python)의 노드 49,398개입니다. 같은 질문 12개를 그래프 도구를 쓰는 에이전트와 파일 읽기·grep으로 탐색하는 에이전트에게 던졌고, 두 에이전트 모두 Claude Opus 4.6을 썼습니다.
아래 그림은 숫자 하나하나가 이 흐름의 어디에서 나오는지 보여 줍니다. 색인은 저장소마다 한 번이고, 질문은 저장소마다 열두 번이며, 토큰과 호출 수는 에이전트 쪽에서 세어지고, 점수는 마지막 채점자에게서 나옵니다.
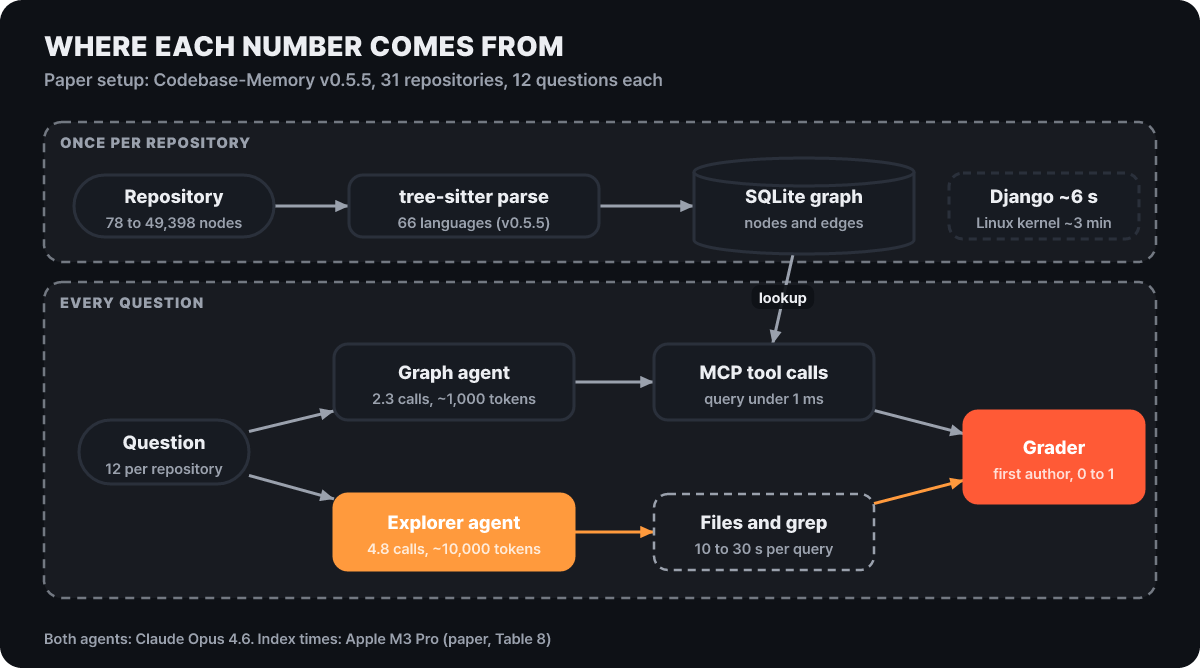 그림 2. 논문 시험의 구조. 색인 시간, 질의 지연, 토큰·호출 수, 점수는 서로 다른 지점에서 나온 값이다
12개 질문은 아홉 범주에 걸쳐 있고, 범주마다 그래프 쪽이 주로 부르는 도구가 정해져 있습니다.
| 범주(문항 수) | 그래프 쪽 주 도구 |
|---|---|
| 색인 확인(1) | get_graph_schema |
| 함수·클래스 찾기(2), 이름 패턴 찾기(1) | search_graph |
| 코드 읽기(1) | get_code_snippet |
| 코드 검색(1) | search_code |
| 호출 추적(2) | trace_call_path(현재 이름은 trace_path) |
| 그래프 질의(2), 상속·구현 관계(1) | query_graph |
| 파일 작업(1) | get_architecture |
이 표에서 읽을 것이 있습니다. 12개 중 5개(호출 추적 2, 그래프 질의 2, 상속·구현 1)가 구조 질문이고 3개가 이름으로 찾는 질문이라, 그래프의 본업과 겹치는 문제가 넓게 들어 있습니다. 점수는 첫 저자가 손으로 만든 기준 답안과 대조해 01점으로 매겼고, 0.80 이상 통과, 0.400.79 부분 정답, 0.40 미만 실패로 나눴으며 논문이 이 기준을 “실용적으로 정했다”고 적었습니다.
토큰은 90% 줄고 점수는 10% 내렸다
논문 표 6의 값은 간단합니다. 질문당 평균 토큰은 그래프 약 1,000 대 파일 탐색 약 10,000, 도구 호출은 2.3회 대 4.8회, 답변 품질은 0.83 대 0.92이고, 한 번의 질의가 걸린 시간은 1ms 미만 대 10~30초였습니다. 단위가 제각각이라 한눈에 견주기 어려우니 파일 탐색을 100으로 맞춰 다시 그렸습니다.
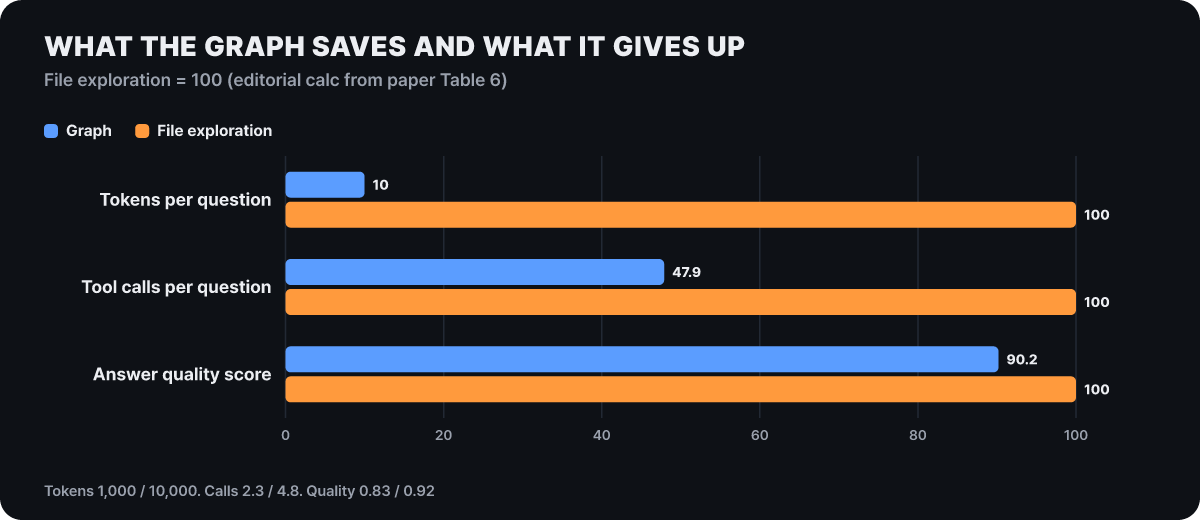 그림 3. 파일 탐색을 100으로 맞춘 편집부 계산. 점수는 0.83을 0.92로 나눈 90.2
세 막대의 길이가 이 거래의 모양입니다. 토큰은 10까지, 호출은 절반 가까이까지 내려가는 동안 점수는 90.2에 머뭅니다. 점수 한 단위를 얻는 데 든 토큰으로 바꿔 보면 그래프 쪽은 1,000÷0.83≈1,205, 파일 탐색은 10,000÷0.92≈10,870으로 약 9배 차이가 납니다. 이것은 평균끼리 나눈 편집부 계산입니다.
0.83은 논문이 정한 통과선 0.80을 넘는 평균이니, 평균적으로는 그래프 쪽도 “통과” 구간에 있습니다. 다만 평균 0.83 안에는 만점에 가까운 질문과 거의 실패한 질문이 같이 들어 있습니다. 아래 절이 바로 그 분포를 들여다봅니다.
파일을 직접 읽는 쪽이 이긴 질문들
논문은 언어별 점수표를 싣지 않고, 질문 유형별로 어느 쪽이 앞섰는지를 31개 언어 중 몇 개인지로 적었습니다. 허브 탐지와 호출자 순위처럼 그래프가 본업인 질문에서는 31개 중 19개 언어에서 그래프가 대등하거나 앞섰습니다. 반대로 전체 소스 맥락이 필요한 질문에서는 16개 언어, 모든 호출 지점을 빠짐없이 찾는 grep형 질문에서는 10개 언어에서 파일 탐색이 앞섰습니다.
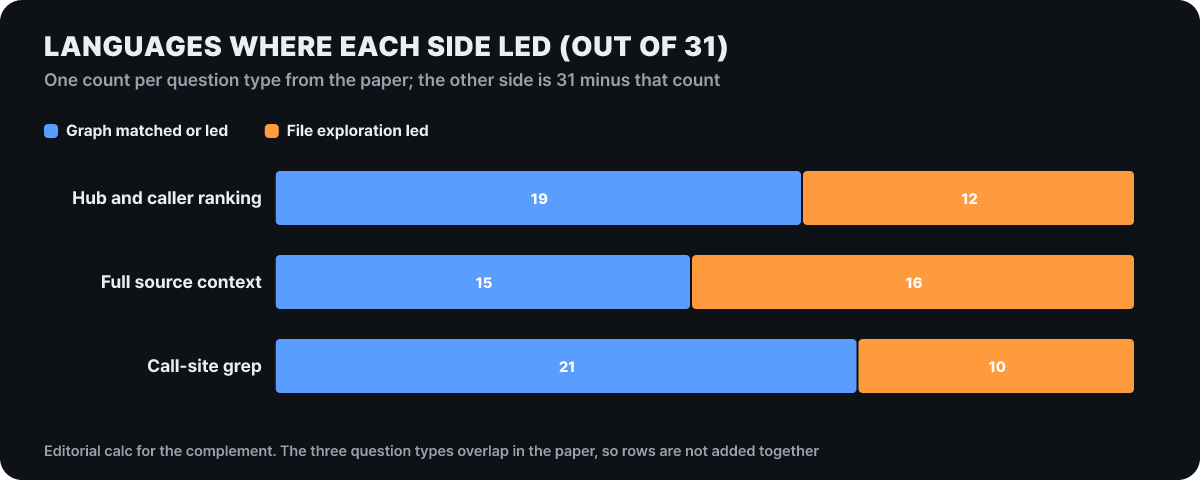 그림 4. 논문이 적은 숫자는 질문 유형마다 하나씩이고 반대편 몫은 31에서 뺀 편집부 계산이다. 세 유형은 겹칠 수 있어 가로 합산은 의미가 없다
소스 맥락 질문에서는 그래프 쪽이 한 발 뒤로 밀려 거의 반반입니다. 이유는 그래프가 의도적으로 소스 줄을 저장하지 않기 때문입니다. 관계(누가 누구를 부르나)는 저장하지만 함수 본문의 한 줄 한 줄은 저장하지 않으니, 줄 단위 답이 필요한 질문에서는 결국 파일을 열어야 합니다. 가장 큰 격차는 매크로가 많은 C에서 나왔고 그래프 0.58 대 파일 탐색 1.00입니다. 매크로는 구문 트리에 나타나지 않아 호출 관계가 그래프에 잡히지 않습니다. 반대로 Haskell·OCaml·Elixir 같은 함수형 언어에서는 두 방식의 품질 차이가 약 1%였습니다.
여기서 “C가 약하다”로 읽으면 틀립니다. 이 저장소의 언어 벤치마크 문서는 C를 jq 저장소에서 11문항 모두 통과로 채점했고, README의 언어 등급표도 C를 90% 이상 구간에 둡니다. 논문의 0.58은 “매크로가 많은 C 저장소”라는 조건이 붙은 값이고, 언어 이름 하나에 저장소 하나가 붙어 있는 시험이라 저장소가 바뀌면 값도 바뀝니다. 참고로 README의 등급표는 그래프 도구 단독의 통과율입니다. 목록에 오른 35개 언어 중 17개(Lua·Kotlin·C++·Perl·Bash 등)가 90% 이상, 16개(Python·TypeScript·Go·Rust·Java·PHP·C# 등)가 75~89%, OCaml과 Haskell이 75% 미만입니다. 앞의 비교 시험과는 다른 측정입니다.
속도 숫자는 M3 Pro 한 대의 값
속도 수치는 모두 Apple M3 Pro에서 잰 값입니다. 논문과 현재 README의 값을 나란히 놓으면, 같은 작업의 숫자가 버전을 건너며 어떻게 유지되고 어디서 달라졌는지 보입니다.
| 작업 | 논문(v0.5.5) | README(현재) |
|---|---|---|
| Django 전체 색인 | 약 6초(노드 49K·엣지 196K) | 약 6초(같음) |
| 리눅스 커널 전체 색인(2,800만 줄·7만 5천 파일) | 약 3분(노드 2.1M·엣지 4.9M) | 3분(노드 4.81M·엣지 7.72M) |
| 리눅스 커널 fast 색인 | 없음 | 1분 12초(노드 1.88M) |
| 증분 재색인 | 약 1.2초 | 없음 |
| 관계 순회(Cypher) | 1ms 미만 | 1ms 미만 |
| 정규식 이름 검색 | 10ms 미만 | 10ms 미만 |
| 호출 경로 추적(깊이 5) | 약 0.3ms | 10ms 미만 |
| 죽은 코드 후보 탐지 | 약 150ms | 약 150ms |
두 열의 “3분”은 서로 다른 크기의 그래프를 만든 시간입니다. 같은 커널인데 노드가 2.1M에서 4.81M으로, 엣지가 4.9M에서 7.72M으로 불었으니 현재 버전은 더 많은 것을 그래프에 넣고도 같은 시간에 끝냅니다. 호출 경로 추적도 0.3ms와 10ms 미만은 서로 모순이 아니라 하나는 실측, 하나는 상한 표기입니다.
가장 눈에 띄는 대비는 질의 지연입니다. 그래프 질의는 1ms 미만, 파일 탐색 에이전트는 질문 하나에 1030초라고 논문이 적었습니다. 다만 이 1030초에는 파일 읽기와 모델의 판단 시간이 함께 들어 있어서 그래프 도구 자체와 일대일로 견줄 값은 아닙니다. 그리고 이 숫자들은 프로젝트가 자기 컴퓨터에서 잰 값이지 내 컴퓨터의 약속이 아닙니다.
1,000토큰은 저장소 지도도 내는 값
“10배”는 파일 탐색과의 비교이고, 다른 구조화 방식과의 비교가 아닙니다. 논문은 표 7에서 방식별로 대략적인 질의당 토큰을 정성적으로 정리했습니다. 임베딩 기반 검색(RAG)은 약 2,000~5,000토큰, 저장소 지도(Aider 같은 방식)는 약 1,000토큰, 그래프에 LLM을 붙이는 방식(Neo4j 등)은 약 5,000토큰, 이 도구는 약 1,000토큰입니다.
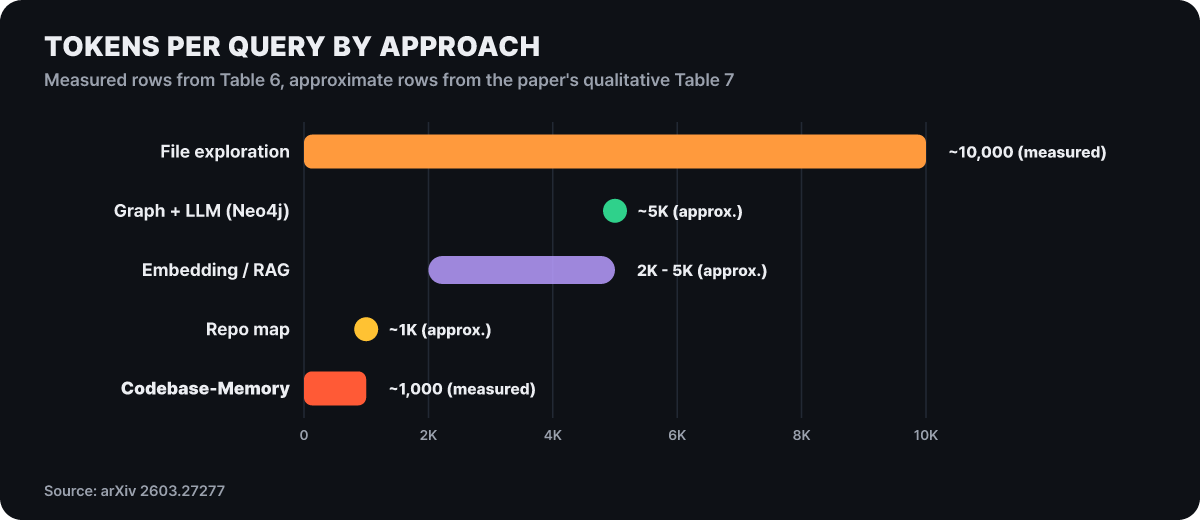 그림 5. 실측 두 줄(표 6)과 논문의 근사 세 줄(표 7)을 한 축에 놓았다. 근사 값은 점이나 범위로 그렸다
저장소 지도 방식이 같은 약 1K라는 점이 읽을 거리입니다. 저장소 지도는 핵심 심볼과 서명을 간추려 요청마다 모델에 보내 주는 방식이라, 토큰은 적지만 “누가 이 함수를 부르나”를 직접 질의하지는 못합니다. 논문 표에서 이 도구가 앞서는 칸은 토큰 수가 아니라 구조 질의가 가능하다는 칸입니다. 지도가 주는 요약과 그래프가 주는 질의 결과가 비슷한 분량이라, 쓸 때의 선택 기준은 토큰이 아니라 “관계를 물을 일이 있는가”가 됩니다.
점수를 매긴 사람과 표본의 한계
논문 스스로 한계를 적어 두었습니다. 평가에 쓴 LLM과 프롬프트 설정이 하나뿐이고, 언어마다 저장소가 하나뿐이며, 채점을 첫 저자 한 명이 했고, 통과·부분·실패의 경계값을 실용적으로 정했습니다. 그래프에는 정적 구조만 담겨 실행 중에 정해지는 호출(동적 디스패치, 리플렉션)은 없습니다. 성능 수치는 한 가지 하드웨어에서 쟀고, 임베딩 검색이나 ctags·LSP 같은 다른 방식과의 체계적 비교도 하지 않았습니다. query_graph는 기본으로 결과 행을 100,000개까지만 돌려줍니다.
읽는 쪽이 더해야 할 한계도 있습니다. 첫째는 시점입니다. 평가 대상 v0.5.5와 지금의 v0.12.1은 도구 수(14 대 17)도, 해석 방식도 다릅니다. v0.11.0 릴리스 노트는 도구 목록 응답을 약 35% 줄였다고 적었는데, 이런 변화는 에이전트의 입력에 들어가는 분량 자체를 바꿉니다. 둘째는 에이전트 설정입니다. 설치가 만들어 주는 에이전트 프로필은 Scout(호출 서너 번으로 빠른 잠정 탐색), Verify(기본값, 소스를 직접 확인하는 검증), Auditor(범위를 정하고 전부 훑는 점검) 세 단계인데, 어느 프로필로 돌리느냐에 따라 호출 수 2.3회 같은 값이 달라집니다. 셋째는 쓰는 모델입니다. 같은 도구라도 모델이 도구 결과를 해석하는 방식에 따라 토큰과 점수가 갈립니다.
재현을 위한 설치와 설정 파일
배포 방식은 사전 빌드 바이너리, npm, PyPI, Homebrew, Scoop, AUR, go install, Nix flake입니다. 공식 빠른 시작은 curl ... | bash 한 줄을 안내하지만, 이 글은 그 방식을 권하지 않습니다. 릴리스 페이지에서 운영체제에 맞는 압축 파일과 checksums.txt를 받아 해시를 대조한 뒤 푸는 수동 설치가 낫습니다. 압축 안의 설치 스크립트(install.sh, install.ps1)는 실행 전에 열어 읽어 볼 수 있고, 스크립트도 압축을 풀기 전에 체크섬을 검증한다고 README가 설명합니다.
# 해시 대조 예시(압축 파일 이름은 받은 것으로 바꿉니다)
shasum -a 256 codebase-memory-mcp-darwin-arm64.tar.gz
grep darwin-arm64 checksums.txt

# 압축을 풀고 바이너리만 설치(에이전트 설정은 건드리지 않음)
tar xzf codebase-memory-mcp-darwin-arm64.tar.gz
./install.sh --skip-config
설치 명령(install)은 감지된 클라이언트(README 기준 45개 연동 대상)의 MCP 설정, 안내문, 스킬, 일부 훅을 자동으로 써 넣습니다. 훅은 검색이나 파일 읽기 때 관련 그래프 정보를 문맥에 덧붙일 뿐 원래 도구 호출을 막거나 바꾸지 않으며, Codex에서는 설치된 훅을 /hooks에서 직접 검토하고 신뢰해야 합니다. 홈 디렉터리의 설정을 건드리기 싫다면 --skip-config로 바이너리만 설치하고 MCP 설정은 쓰는 에이전트에 직접 등록하세요. 되돌릴 때는 codebase-memory-mcp uninstall이 자기가 쓴 설정·스킬·훅·바이너리를 지우고, 색인 파일은 기본으로 남겨 둡니다(--delete-indexes로 삭제, --dry-run으로 미리 보기).
설정 파일을 건드리지 않았다면 MCP 서버를 직접 등록합니다. README의 수동 등록 예는 사용자 범위의 ~/.claude.json 또는 프로젝트의 .mcp.json에 적는 형태입니다.
{
  "mcpServers": {
    "codebase-memory-mcp": {
      "command": "/path/to/codebase-memory-mcp",
      "args": []
    }
  }
}
에이전트를 재시작해 /mcp에서 도구 17개가 보이면 연결된 것이고, “Index this project”라고 말하면 색인이 시작됩니다. 에이전트 없이 터미널에서 도구를 하나씩 돌려 볼 수도 있습니다. 이 CLI는 아래 재측정에서도 씁니다.
codebase-memory-mcp cli index_repository --repo-path /절대/경로
codebase-memory-mcp cli list_projects
codebase-memory-mcp cli search_graph --project my-project --name-pattern '.*Handler.*' --label Function
codebase-memory-mcp cli trace_path --project my-project --function-name Search --direction bothindex_repository는 절대 경로를 받고, 응답은 사람이 읽기 좋은 압축 트리가 기본이며 --format json을 붙이면 기계용 JSON이 됩니다. 색인 결과는 ~/.cache/codebase-memory-mcp/에 SQLite로 저장되어 재시작해도 남습니다.
공급망 확인. 릴리스마다 SHA-256 체크섬, Sigstore cosign 서명, GitHub Actions의 SLSA 3단계 출처 증명을 제공하고, CodeQL 경고가 남아 있으면 배포를 막는다고 README가 설명합니다. 받은 파일은 gh attestation verify <파일> --repo DeusData/codebase-memory-mcp로 증명을 직접 확인할 수 있습니다. 실행 파일은 VirusTotal로 검사하며 v0.11.0 릴리스 노트가 8종의 결과를 링크하고, Windows Defender가 오탐할 수 있다는 안내도 있습니다. 프로젝트는 통계 수집이 없고 바이너리가 스스로 네트워크 요청을 보내지 않는다고 밝힙니다.
같은 질문에 숫자를 흔드는 설정들
토큰과 점수는 모델만이 아니라 그래프를 어떻게 만들었는지에도 흔들립니다. 재측정 전에 아래를 고정해 두어야 합니다.
색인 모드. 기본은 의미 분석까지 하는 full이고, moderate는 걸러낸 색인에 의미 분석을 포함하며, fast는 걸러낸 색인에 의미 분석이 없습니다. 리눅스 커널에서 fast가 1분 12초인 이유입니다. fast에는 의미 분석이 빠지므로 어떤 모드로 색인했는지 기록해 둡니다. 무시 규칙은 내장 패턴(.git, node_modules 등) → .gitignore → .cbmignore 순으로 겹쳐 적용되고, 심볼릭 링크는 항상 건너뜁니다.
그래프의 신선도. 파일을 바꾸면 그래프도 갱신되어야 합니다. 감시(auto_watch)는 기본으로 켜져 있지만 기본으로는 git 저장소만 따라갑니다. git이 아닌 폴더는 마지막 색인에 머물러 있다가 index_repository를 다시 돌려야 갱신되고, watch_non_git을 켜면 그런 폴더도 감시합니다. 답이 이상하면 index_status로 최신 여부를 먼저 확인합니다. 자동 색인(auto_index)은 기본이 꺼짐이고 파일 수 상한은 auto_index_limit입니다.
상한과 메모리. 한 번에 색인할 파일 수나 용량의 상한은 index_max_files, index_max_source_mb로 정하며 둘 다 기본은 꺼짐입니다. 상한을 넘으면 일부만 색인한 그래프를 내놓지 않고 색인 시도 전체가 실패하며, 쓰고 있던 색인은 보존됩니다. 메모리는 CBM_MEM_BUDGET_MB로 상한을, 작업자 수는 CBM_WORKERS로 조절합니다. 큰 저장소는 index_repository에 async: true를 주면 데몬이 백그라운드에서 색인하고 status: true로 진행 상태를 확인합니다. 일부 IDE 클라이언트가 도구 호출 하나에 걸어 두는 제한 시간 안에 끝나지 않는 색인을 위한 방법입니다.
버전과 데몬. 릴리스는 빠르게 나옵니다. v0.11.0(9월 15일)과 v0.12.1(10월 16일)은 업그레이드 후 첫 색인이 일회성 전체 재구축이라고 릴리스 노트가 밝히므로, 측정 도중 버전을 올리면 안 됩니다. Claude Code, Codex, OpenCode 등 여러 에이전트를 같이 쓰면 계정당 데몬 하나를 함께 쓰는데, 모든 활성 프로세스가 같은 버전·같은 빌드·같은 캐시 경로여야 하고 어긋나면 일을 시작하기 전에 거절합니다. 로그는 ~/.cache/codebase-memory-mcp/logs에 있습니다.
경로 제한과 공유 스냅샷. CBM_ALLOWED_ROOT로 index_repository가 접근할 수 있는 디렉터리를 묶을 수 있습니다. 심볼릭 링크를 풀고 ..을 해석한 뒤에도 그 밖이면 거절합니다. persistence: true를 주면 .codebase-memory/graph.db.zst라는 압축 스냅샷을 저장소 옆에 쓰는데 기본은 꺼짐입니다. 이 파일은 갱신 때마다 통째로 다시 쓰여서 매번 커밋하면 저장소가 급격히 커집니다. README가 든 사례는 한 팀이 약 350번 커밋하는 동안 이 파일 하나가 약 6GB가 된 일입니다. 릴리스나 야간 작업 같은 주기를 정하거나 .codebase-memory/를 .gitignore에 넣어 각자 색인하는 쪽이 안전합니다.
codebase-memory-mcp config set auto_watch false       # 측정 중에는 백그라운드 감시를 끈다
codebase-memory-mcp config set index_max_files 250000 # 파일 수 상한(기본은 꺼짐)
내 저장소에서 표를 다시 채우는 순서
프로젝트는 위 논문 수치를 그대로 믿지 말고 자기 저장소에서 재 보라고 안내하는 측정 문서(docs/MEASURING_SAVINGS.md)를 둡니다. 핵심은 세 가지 질문을 섞지 않는 것입니다. 답이 더 나은가, 그래프 도구가 빠르고 안정적인가, 토큰과 도구 호출이 정말 줄어드는가는 각각 다른 측정입니다. CBM의 질의 카운터는 모델 토큰이나 에이전트의 전체 도구 호출을 알지 못하므로, 토큰과 호출 수는 쓰는 클라이언트나 평가 하네스가 직접 기록해야 합니다.
- 실험 고정. 저장소의 정확한 커밋 SHA, 질문 목록과 기준 답안, CBM 버전·색인 모드·기계, 에이전트 모델·시스템 프롬프트·질문당 예산을 적어 둡니다. 두 조건에 같은 값을 씁니다.
- 깨끗한 워크트리 두 개. 같은 SHA의 분리(detached) 워크트리를 그래프용과 파일 탐색용으로 따로 만들고, 둘 다 추적되지 않는 파일까지 변경이 없는지 확인합니다.
- 그래프 쪽 사전 점검. 측정 직전에
index_repository를 새로 돌려 성공을 확인하고,index_status --verbose로 루트 경로와 현재 HEAD를 대조한 뒤, 미리 소스에서 확인해 둔 심볼을search_graph로 찾아 봅니다. - 격리된 세션으로 질문. 조건별로 질문 하나당 세션 하나를 쓰고, 한 조건이 다른 조건의 답이나 도구 결과를 보지 못하게 합니다. 파일 탐색 쪽은 파일 목록·텍스트 검색·부분 읽기만 허용합니다.
- 창(window)별로 기록. 답변 구간의 토큰과 세션 전체의 토큰을 따로 적습니다. 어느 한쪽 클라이언트가 창을 직접 보고하지 못하면 그 창은 비교에서 뺍니다.
- 답을 소스에 대조해 채점. 그럴듯함이 아니라 고정한 SHA의 소스 기준으로 매기고, 가능하면 채점자가 어느 조건의 답인지 모르게 합니다. 품질은 효율 지표 옆에 따로 둡니다.
기록 행은 한 질문, 한 조건, 한 창당 하나이고 형식은 아래 한 줄 머리글을 따릅니다. tool_calls에는 CBM 호출만이 아니라 재시도·오류·0건 결과를 포함한 클라이언트의 모든 도구 호출을 셉니다.
run_id,condition,repo_sha,question_id,window,input_tokens,output_tokens,total_tokens,tool_calls,wall_time_ms,answer_artifact,quality_score같은 창끼리만 비교해 아래 네 식으로 계산합니다.
토큰 감소율(%)   = 100 × (파일 탐색 토큰 − 그래프 토큰) / 파일 탐색 토큰
호출 감소율(%)   = 100 × (파일 탐색 호출 − 그래프 호출) / 파일 탐색 호출
토큰 배율        = 파일 탐색 토큰 / 그래프 토큰
호출 배율        = 파일 탐색 호출 / 그래프 호출
파일 탐색 쪽 값이 0이면 감소율은 계산하지 않고, 그래프 쪽 값이 0이면 배율을 계산하지 않으며 값을 보정해 넣지 않습니다. 발표할 때는 원시 쌍과 함께 반복 횟수, 집계 방법, 실패한 실행, 통제한 조건, 질문별 품질 점수를 같이 적습니다. 위의 121배나 10배처럼 한 저장소·한 질문 세트·한 모델·한 기계에서 나온 값은 보편적인 절감 주장으로 바꿔 쓰지 않는다는 것이 문서의 마지막 원칙입니다. 이 표가 채워지면 그 값이 내 저장소의 “배율”이고, 그것이 논문의 10배와 옛 README의 121배 사이 어디에 놓이는지가 이 도구를 쓸지 정하는 숫자입니다.



