오픈 모델을 내려받고 무료 API로 바로 시험하는 모델 허브 ModelScope
ModelScope 무료 API의 한도를 큐브 250개·계정 하루 2,000회·모델별 200회로 계산하고, 작업별 청구서와 제공자 연결·가중치 내려받기 길의 비용까지 견줍니다.
하루 2,000번. ModelScope가 신규 사용자 안내 글에서 계정 하나에 열어 주는 무료 API 호출 횟수입니다. 같은 글은 모델 하나에는 하루 200번까지만 부를 수 있다고 적었고, 호출마다 깎이는 매직큐브(Magicube)는 로그인만 해서는 하루 200개가 들어옵니다. 숫자가 셋이니 한도는 셋 중 가장 낮은 곳에서 멈춥니다. 이 글은 세 숫자로 하루 예산을 세우고, 모델 비교나 코딩 에이전트 한 작업이 예산의 몇 %를 쓰는지 청구서처럼 뽑아 본 다음, 예산이 모자랄 때 가는 두 길(외부 제공자 연결, 가중치 내려받기)의 값을 견줍니다.
ModelScope는 오픈소스 모델 커뮤니티 겸 모델 허브입니다. 모델·데이터셋·데모를 모아 두고, 일부 모델은 알리바바 클라우드 자원으로 돌리는 무료 API(API-Inference)로 바로 부르게 해 줍니다. 허깅페이스(Hugging Face)와 같은 종류의 서비스이고, 국제판 주소는 modelscope.ai이며 같은 계정 체계의 modelscope.cn 사이트도 있습니다. 가입하고 결제 수단을 등록하지 않고도 새 오픈 모델을 시험해 볼 수 있다는 점이 매력인데, 그래서 “무료로 얼마나 부를 수 있나”가 곧 이 서비스의 핵심 질문입니다.
계산을 시작하기 전에 지나야 하는 문
무료 API는 로그인만 하면 열리지 않습니다. 무료 추론이 알리바바 클라우드의 컴퓨팅 자원으로 돌아가기 때문에, 공식 문서는 오남용을 막으려고 클라우드 계정의 실명 인증까지 요구합니다. 앞 단계가 끝나야 다음 단계가 열리는 순서는 이렇습니다.
- modelscope.ai에서 계정을 만든다. 큐브를 쓰려면 프로필에 인증된 이메일이 있어야 한다.
- 설정의 계정 화면에서 알리바바 클라우드 계정을 연결(Bind Now)하고, 권한 동의 화면에서 항목을 모두 체크한다. 클라우드 계정이 없으면 공식 안내 글이 보여 주는 두 단계 가입 화면으로 새로 만든다.
- 연결한 클라우드 계정의 실명 인증을 마친다. 문서는 이 인증이 끝나야 API-Inference를 정상으로 쓸 수 있다고 적었다.
- 설정의 접근 토큰 화면에서 토큰을 발급한다.
- 모델 페이지 오른쪽의 API-Inference 패널에서 예제 코드를 열어 첫 호출을 한다.
접근 토큰 하나로 SDK와 Git을 모두 씁니다. 만들 때 장기 사용과 단기 사용 중에서 유효기간을 고르고(단기는 월 단위로 정함), 활성 토큰은 이름과 기간을 달리해 최대 10개까지 둘 수 있습니다. 토큰을 지우면 바로 만료되어 그 토큰으로 돌던 모델 업로드나 학습 작업도 영향을 받습니다. 예전 Git 전용 토큰은 신규 발급이 끝났으니 통합 토큰으로 옮기라는 안내가 있습니다.
3번은 개인정보를 내놓는 단계입니다. 연결 화면이 어떤 권한을 요구하는지, 인증에 무엇을 입력하는지 약관과 개인정보 처리 방침을 읽고 결정하세요. 이 문턱이 부담스럽다면 뒤에서 다룰 가중치 내려받기가 API 길을 거치지 않고 모델을 써 보는 방법입니다.
큐브 수입: 로그인 200에서 하루 최대 300까지
API-Inference 호출은 매직큐브로 값을 치릅니다. 큐브는 로그인과 커뮤니티 활동으로 쌓이고, 호출 단가는 모델 크기에 따라 경량 약 0.5, 표준 약 1, 플래그십 약 2개입니다. 하루 수입부터 쪼개 봅니다. 아래 그림은 어떤 활동까지 하느냐에 따라 하루에 들어오는 큐브가 200, 250, 300으로 늘어나는 모습입니다.
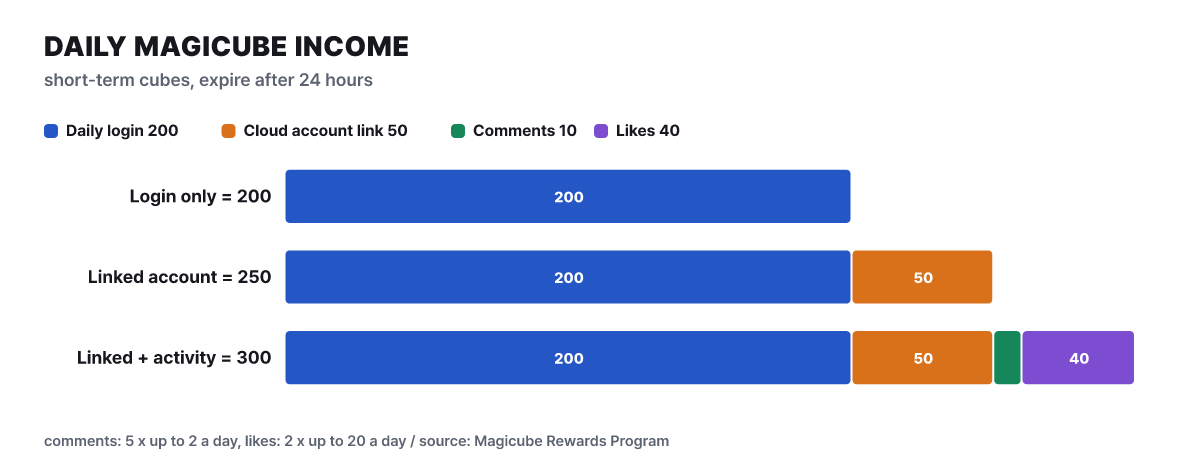 그림 1. 하루 큐브 수입의 구성. 활동 보상 50은 댓글 5개 × 2번과 좋아요 2개 × 20번을 모두 채운 경우
계정 연결이 더하는 50은 큰 몫입니다. 로그인 200만으로도 되지만, 클라우드 계정은 어차피 무료 API의 입장 조건이라 연결 보너스는 자동으로 따라옵니다. 댓글과 좋아요 보상은 남의 글을 상대로 해야 하고, 댓글 보상은 다른 사용자에게서 좋아요나 답을 받아야 지급되므로 계획에 넣기보다 덤으로 보는 편이 맞습니다.
| 종류 | 얻는 방법 | 양 | 유효 기간 |
|---|---|---|---|
| 단기 | 일일 로그인 | 200 (하루 1번) | 발급 후 24시간, 당일만 |
| 단기 | 알리바바 클라우드 계정 연결 보너스 | 50 (하루 1번) | 24시간 |
| 단기 | 남의 글에 댓글 | 5 (하루 2번까지) | 24시간 |
| 단기 | 남의 글 즐겨찾기·좋아요 | 2 (하루 20번까지) | 24시간 |
| 장기 | 이메일 인증, 소개글 작성, 프로필 꾸미기 | 각 50 (1회) | 발급 후 90일 |
| 장기 | 친구 추천 | 1명당 20 (월 50명까지) | 90일 |
| 장기 | 추천 코드로 가입 | 50 (1회) | 90일 |
쓸 때는 두 종류에 차이가 없고 만료가 가까운 큐브부터 자동으로 깎입니다. 그래서 그날 받은 단기 큐브가 먼저 소진되고, 장기 큐브는 단기가 바닥난 뒤에야 줄어듭니다. 하루에 못 쓴 단기 큐브는 사라지므로 쌓아 두는 전략은 통하지 않습니다. 장기 큐브는 한 번씩 주는 150(이메일·소개글·프로필)이 전부라서, 플래그십 모델로 150번을 부를 수 있는 일회성 여유분으로 보면 됩니다.
천장 셋 중 가장 낮은 곳에서 멈춘다
한도는 세 겹입니다. 첫째는 큐브 잔액입니다. 둘째는 공식 신규 사용자 안내 글이 밝힌 계정 한도로, 등록 사용자 한 명이 하루에 전 모델을 합쳐 최대 2,000번 호출할 수 있습니다. 셋째는 모델별 한도입니다. 모델마다 따로 하루 할당량이 있고, 이 값은 자원 여유·사용 패턴·모델 출시일에 따라 동적으로 조정되며, 상한이 200번이고 실제로는 훨씬 낮을 수 있다고 합니다. 한도는 이 밖에 동시 호출에도 걸리는데, 부하에 따라 모델마다 제한하되 개발자 한 명의 단일 동시 사용은 보장하는 것이 원칙입니다.
세 값을 한 식으로 묶으면 하루 최대 호출 수는 min(250 ÷ 단가, 200 × 쓰는 모델 수, 2,000)입니다. 가로축을 “하루에 부르는 서로 다른 모델 수”로 놓고 단가 세 종류의 값을 그리면 어디서 꺾이는지 보입니다.
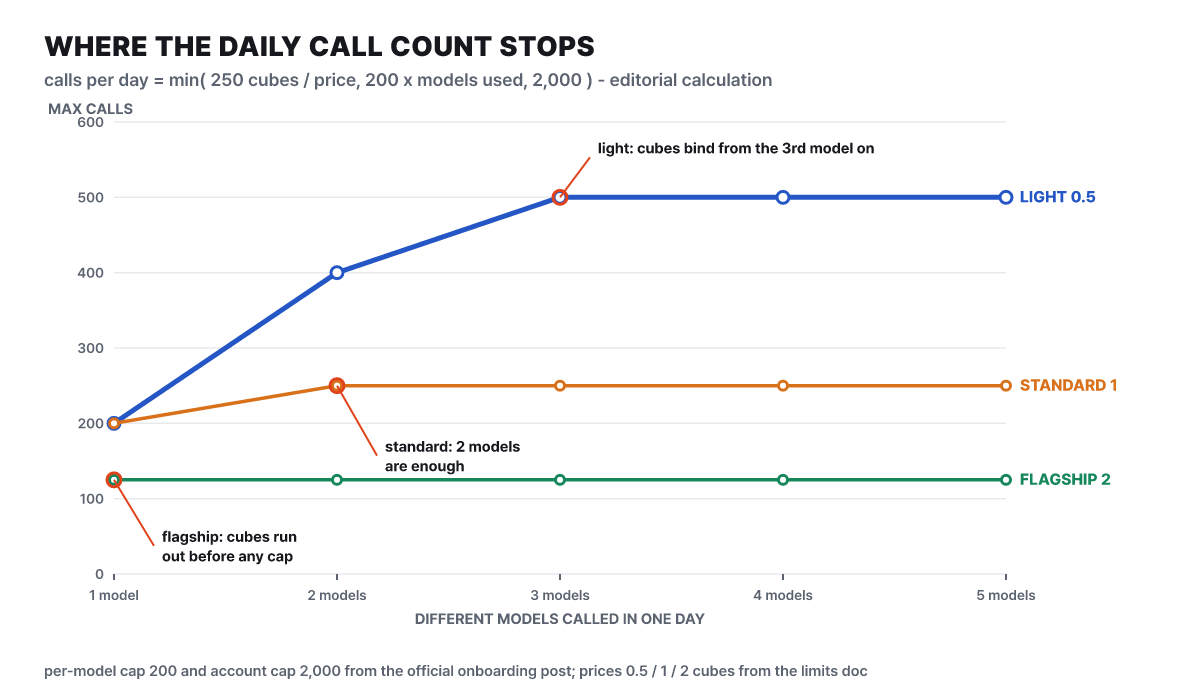 그림 2. 모델 수에 따라 하루 호출 수가 멈추는 곳. 250큐브 기준, 편집부 계산
경량 모델은 큐브로는 500번이지만 모델 하나에서는 200번에서 막혀서, 500번을 채우려면 서로 다른 모델 세 개로 나눠 불러야 합니다. 표준 모델은 250번이라 모델 두 개면 충분합니다. 플래그십은 큐브가 125번에서 먼저 바닥나서 모델 하나로도 모든 천장보다 아래에 머뭅니다. 눈여겨볼 점은 계정 한도 2,000번이 이 그래프 어디에서도 닿지 않는다는 것입니다. 경량 모델로 2,000번을 부르려면 큐브 1,000개가 필요한데 하루 수입은 많아야 300개이기 때문입니다. 큐브 계산을 따로 하지 않으면 2,000이라는 숫자에 속기 쉽습니다.
두 가지를 덧붙입니다. 활동 보상까지 다 채운 300큐브라면 500·250·125가 600·300·150으로 올라가고 결론은 같습니다. 그리고 문서는 한도를 플랫폼 부하에 맞춰 실시간으로 조정한다고 밝히니, 위 값은 약속된 횟수가 아니라 상한선입니다. 오늘 내 계정의 호출 수는 아바타 메뉴의 Usage & Quota 패널에서 볼 수 있고, 모델 한 개가 어느 단가 구간인지는 모델 페이지 코드 예제 오른쪽 위에서 제공자를 “ModelScope Community”로 골랐을 때 나오는 예상 큐브 비용으로 확인합니다.
작업 네 개를 하루 예산에 올려 보기
상한을 알았으니 실제 일을 올려 봅니다. 모델 비교처럼 몇 번 부르고 마는 일과 에이전트처럼 수십 번 이어서 부르는 일은 소비 규모가 다릅니다. 코딩 에이전트는 파일을 읽고 명령을 돌릴 때마다 모델을 다시 부르므로 작업 하나가 수십 번의 호출로 이어집니다. 여기서는 한 작업을 40번 호출로 가정했습니다. 이 가정은 편집부가 둔 값이라 작업 성격에 따라 몇 배 달라질 수 있습니다. 아래 표는 각 일이 하루 250큐브의 몇 %를 쓰는지 보여 줍니다.
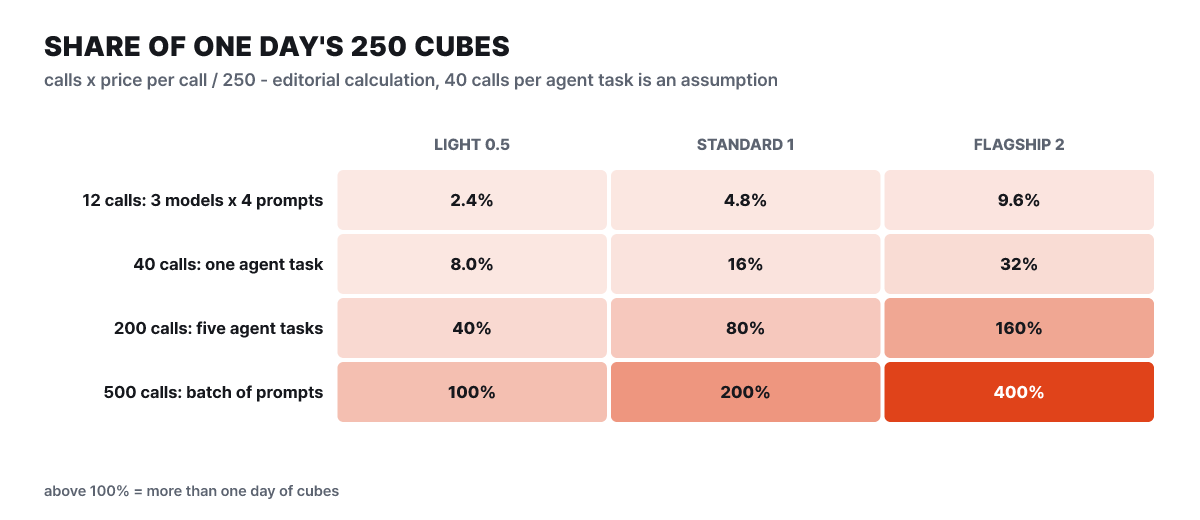 그림 3. 일의 크기 × 모델 단가 = 하루 250큐브 대비 %. 편집부 계산이며 작업당 40호출은 가정
맨 윗줄이 가장 안심되는 칸입니다. 모델 세 개에 질문 네 개를 던지는 비교는 플래그십 모델로만 해도 하루의 9.6%라서 후보를 고르는 일은 부담이 없습니다. 에이전트 작업 하나는 표준 모델에서 16%, 플래그십에서 32%로, 플래그십이라면 하루에 세 번쯤 돌리면 끝입니다(125 ÷ 40). 작업 다섯 개(200호출)는 경량 40%와 표준 80%까지는 하루에 들어가지만 플래그십은 160%라 이틀 가까이 걸리고, 어느 쪽이든 한 모델로 몰면 200번 상한에 딱 닿습니다. 마지막 줄의 프롬프트 500개 일괄 처리는 경량 모델이어도 하루치 전부이고 표준·플래그십이면 이틀·나흘이 걸립니다. 문서도 높은 동시성이나 서비스 수준 보장이 필요한 온라인 작업에는 쓰지 말고 상용 플랫폼을 쓰라고 하므로, 이 크기의 일은 무료 길에서 나올 때입니다. 하루 호출이 경량 500·표준 250·플래그십 125번을 넘기기 시작하면 그 지점이 손익분기입니다.
코딩 도구 넷을 붙이는 설정
에이전트 도구로 이 계산을 체감하는 사람이 많아서, 공식 코스 글(2026년 8월 25일)이 소개한 연결 방법을 모아 둡니다. 모두 같은 접근 토큰을 쓰고 주소만 다릅니다. Claude Code는 Anthropic 방식(주소 끝에 /v1 없음)으로 붙입니다. 코스는 토큰도 설정 파일에 적지만, 파일에는 주소와 모델만 두고 토큰은 셸 환경 변수 ANTHROPIC_AUTH_TOKEN으로 넘기는 쪽이 저장소에 새어 나갈 일이 적습니다.
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api-inference.modelscope.ai",
    "ANTHROPIC_MODEL": "zai-org/GLM-5.2",
    "API_TIMEOUT_MS": "3000000"
  }
}
OpenCode는 설정 파일에 OpenAI 호환 제공자를 추가하고(주소는 /v1을 붙인 쪽) 프롬프트에서 /connect로 토큰을 넣습니다. Qwen Code는 /auth에서 제3자 제공자 중 ModelScope API Key를 고르면 끝납니다. Codex CLI는 응답 방식이 걸림돌입니다. 최신 버전은 Responses API만 지원하므로 설정 파일에 wire_api = “responses”를 두고 그 방식을 받는 모델을 골라야 하고, Chat Completions 방식 모델을 쓰려면 구버전(코스는 0.80.0 예시)을 설치하라고 안내합니다.
model_provider = "modelscope"
model = "Qwen/Qwen3.5-397B-A17B"

[model_providers.modelscope]
base_url = "https://api-inference.modelscope.ai/v1/"
env_key = "OPENAI_API_KEY"
name = "ModelScope"
wire_api = "responses"
모델 ID는 코스 시점의 예시입니다. 목록은 계속 바뀌므로 모델 페이지 오른쪽 예제에서 현재 지원되는 ID를 복사하세요.
첫 호출: 주소 둘과 모델 ID 하나
도구 없이 코드로 부를 때는 OpenAI SDK의 주소·키·모델 이름만 바꾸면 됩니다. 아래는 공식 문서 예제를 환경 변수에서 토큰을 읽도록 고친 것입니다.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MODELSCOPE_TOKEN"],  # 코드에 적지 않고 환경 변수로
    base_url="https://api-inference.modelscope.ai/v1/",
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.5-35B-A3B",  # ModelScope의 모델 ID
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Write quicksort in Python"},
    ],
    stream=True,
)
for chunk in response:
    print(chunk.choices[0].delta.content, end="", flush=True)
응답이 조각(chunk)으로 흘러 들어오는 스트리밍이라 글자가 이어서 찍힙니다. 추론(reasoning) 모델은 호출 방식이 조금 달라서, 생각 과정이 reasoning_content, 최종 답이 content로 나뉘어 올 수 있고, 문서도 각 모델 페이지의 예제를 기준으로 삼으라고 합니다. Anthropic SDK를 쓰는 사람은 같은 서비스에 주소만 /v1 없이 지정하고 client.messages.create나 client.messages.stream을 max_tokens와 함께 부릅니다. 이 방식은 아직 베타입니다.
- OpenAI 방식 주소
https://api-inference.modelscope.ai/v1/- Anthropic 방식 주소
https://api-inference.modelscope.ai(끝에 /v1 없음, 베타)- 키
- ModelScope 접근 토큰
- 모델
- ModelScope 모델 ID, 모델 페이지 오른쪽 예제에서 복사
- 호출 가능한 모델 찾기
- 모델 목록에서 번개 모양 API-Inference 로고가 붙은 것
- 이미지 입력
- 비전 통합 모델(Qwen3.5 등)과 VL 모델은 이미지 주소나 Base64 데이터 주소(
data:image/png;base64,…)를image_url에 넣음
API-Inference에 올라오는 모델은 커뮤니티에서 좋아요와 다운로드가 많은 순으로 고르고, 새 모델이 들어오면 오래된 모델은 점차 빠집니다. 코드에 박은 모델 ID가 어느 날 사라질 수 있으니 설정 파일이나 환경 변수로 빼 두세요.
이미지 생성은 번호표를 받아 기다린다
텍스트-이미지 모델은 결과가 바로 나오지 않아 비동기로 동작합니다. 주문을 넣고 번호표를 받은 뒤, 완성됐는지 번호표로 묻는 방식입니다.
v1/images/generations에 POST하고 헤더에X-ModelScope-Async-Mode: true를 둔다- 응답에서 task_id를 받는다
v1/tasks/{task_id}에 GET하고 헤더에X-ModelScope-Task-Type: image_generation을 둔다. 공식 예제는 5초 간격으로 반복한다- task_status가 SUCCEED이면 output_images의 주소에서 이미지를 내려받는다
prompt는 필수이고 2,000자 미만이며 영어가 대체로 잘 듣는다고 안내합니다. 시드는 0 이상 2의 31제곱 빼기 1 이하, steps는 1100, guidance는 1.520입니다. LoRA(기본 모델 위에 화풍을 얹는 작은 추가 학습 파일)는 최대 6개까지 가중치를 달아 섞을 수 있고 가중치 합이 1.0이어야 합니다. 모델 계열마다 허용 해상도가 다릅니다.
| 계열 | size 범위 |
|---|---|
| SD 계열 | 64x64 ~ 2048x2048 |
| FLUX | 64x64 ~ 1024x1024 |
| Qwen-Image | 64x64 ~ 1664x1664 |
| Z-Image-Turbo | 512x512 ~ 2048x2048 |
429가 뜨면 큐브 계산을 다시 본다
한도에 닿으면 429 오류가 옵니다. 공식 안내는 다른 모델로 바꾸거나 다음 날을 기다리라고 합니다. 큐브가 남았는데 막혔다면 모델별 상한에, 큐브가 바닥났다면 앞 절의 수입 계산에 걸린 것입니다.
큐브가 남았는데 429가 뜨는 이유는?
그 모델의 하루 할당량(최대 200번)이 먼저 찬 경우입니다. 할당량은 모델마다 따로이고 부하에 따라 더 낮아질 수 있으므로, 같은 일을 다른 모델로 이어 부르면 계속할 수 있습니다.
실패한 호출도 큐브를 깎나?
시스템 오류로 실패한 추론은 큐브가 전액 자동 환불됩니다. 직접 취소한 추론도 환불되지만, 모델 학습을 취소하면 비용은 소진됩니다.
모델 ID 뒤 이름 하나로 갈라지는 청구서
한도가 모자랄 때 코드를 거의 안 바꾸고 나가는 길이 API-Provider입니다. 개인 설정의 API-Inference 제공자 화면에서 외부 제공자의 키(Host Key)를 등록하고, 모델 ID 뒤에 콜론과 제공자 이름을 붙이면 요청이 그쪽으로 갑니다. 인증은 여전히 ModelScope 토큰으로 합니다.
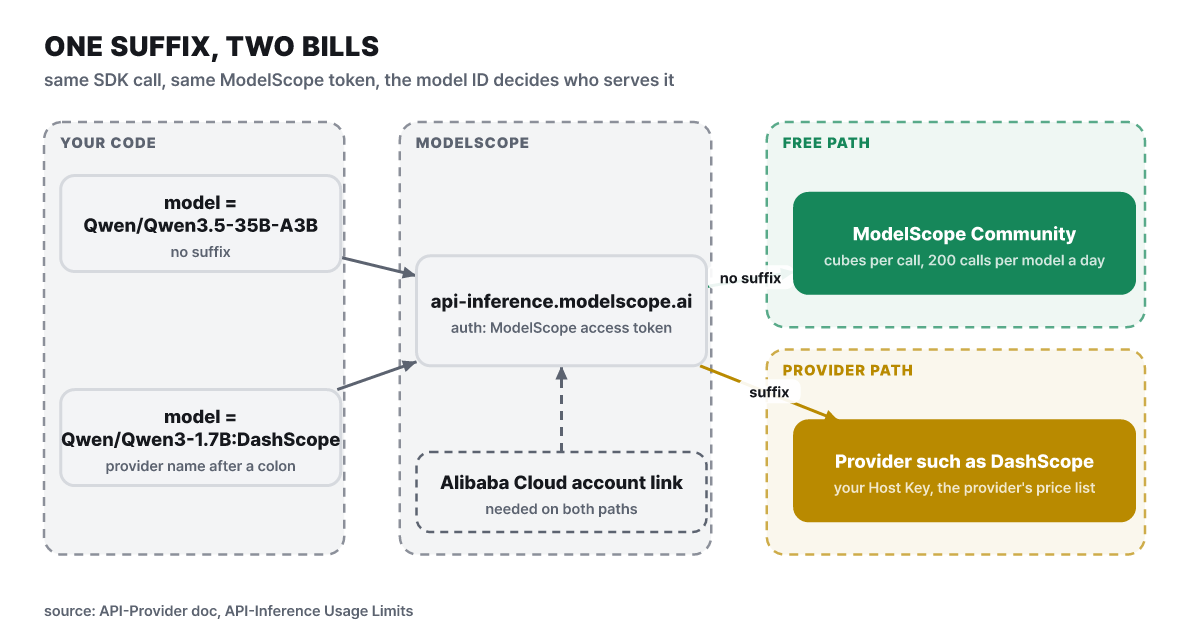 그림 4. 접미사 하나가 요청이 가는 곳과 청구 주체를 가른다
response = client.chat.completions.create(
    model="Qwen/Qwen3-1.7B:DashScope",  # 모델 ID + 제공자 이름
    messages=[{"role": "user", "content": "Which is larger, 9.9 or 9.11?"}],
    stream=True,
)
문서가 드는 제공자 이름의 예는 DashScope와 DeepSeek입니다. 이 경로에서는 무료 API-Inference의 한도 규칙이 적용되지 않고 플랫폼은 요금을 매기지 않으며, 요금은 제공자의 상품 문서 기준을 따릅니다. 큐브도 200번 상한도 이 경로에는 닿지 않으니, 앞 절의 표에서 100%를 넘긴 일들이 갈 곳입니다. 호스팅한 키는 암호화해 저장하고 한 번 등록하면 화면에서 평문으로 다시 볼 수 없으며 언제든 바꾸거나 지울 수 있습니다. 다만 이 경로를 쓸 때도 알리바바 클라우드 계정 연결은 먼저 해야 합니다.
경로가 바뀌어도 프롬프트가 외부 서버로 간다는 점은 같습니다. 무료 경로에서는 ModelScope가, 제공자 경로에서는 제공자가 프롬프트를 받습니다. 사내 코드나 개인정보를 다루는 일이라면 두 경로 모두 맞지 않고, 다음에 볼 내려받기가 답입니다.
가중치 크기라는 또 하나의 청구서
내려받는 길은 큐브 대신 디스크와 메모리로 값을 냅니다. 문서가 큐브의 쓰임으로 적은 것은 API 추론과 Civision 추론·학습이어서, 가중치를 받는 일 자체에는 큐브 계산이 따라붙지 않습니다. 대신 파일이 얼마나 큰지가 문제입니다. 아래는 ModelScope 저장소에 올라 있는 파일 크기를 합산한 값입니다.
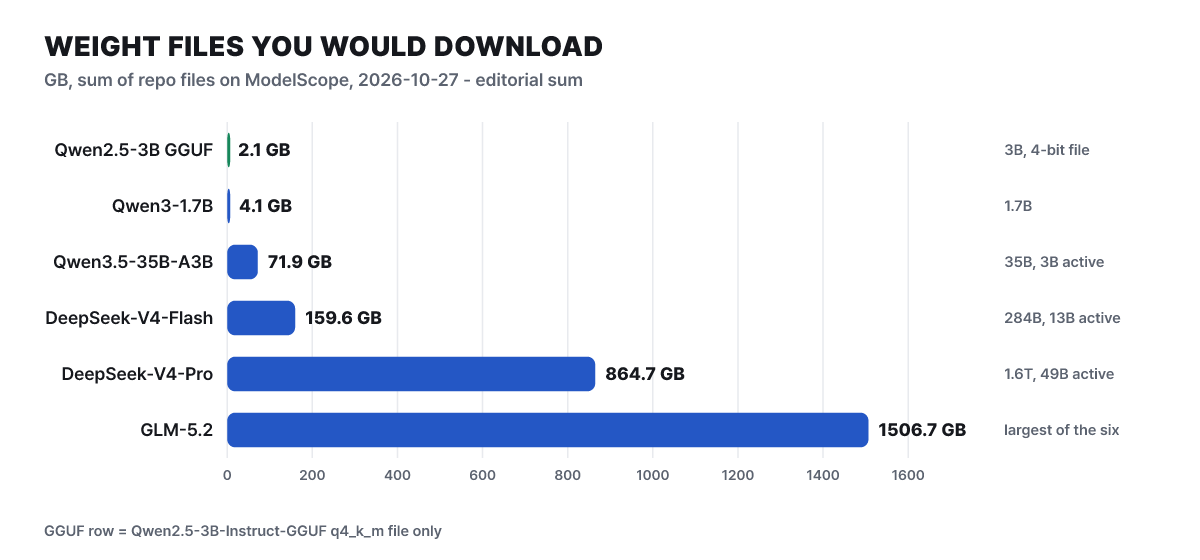 그림 5. 내려받을 가중치의 크기. 2026년 10월 27일 저장소 파일을 편집부가 합산
내려받을 파일의 크기는 700배 넘게 벌어집니다. 3B급 모델을 4비트로 압축한 GGUF 파일은 2.1GB라서 일반 노트북에도 들어가지만, DeepSeek-V4-Pro는 864.7GB로 서버급 장비가 있어야 합니다. 총 크기만 보지 말고 활성 파라미터도 보세요. 전문가 혼합(MoE) 모델인 Qwen3.5-35B-A3B는 전체가 71.9GB이고 추론 때는 3B만 켜지지만, 파일은 전체를 받아야 합니다.
압축 단계에 따른 크기도 보입니다. Qwen2.5-3B-Instruct-GGUF 저장소의 파일 크기는 아래와 같습니다. 정밀도를 낮출수록 작아지지만 품질도 내려가는데, Ollama가 기본으로 Q4_K_M을 고르는 것도 이 균형 때문입니다.
| 파일 | 크기 | 비고 |
|---|---|---|
| q2_k | 1.38GB | 가장 작음 |
| q3_k_m | 1.72GB | |
| q4_k_m | 2.1GB | Ollama가 기본으로 고르는 단계 |
| q5_k_m | 2.44GB | |
| q6_k | 2.79GB | |
| q8_0 | 3.62GB | |
| fp16 | 6.8GB | 2개로 나뉜 파일 합 (3.98 + 2.82) |
Q4_K_M은 fp16의 약 3분의 1입니다(편집부 계산, 2.1 ÷ 6.8). 쓰기 전에 모델 카드의 라이선스를 읽어야 합니다. 허브의 모델 소개는 저장소의 README.md가 맡고, 맨 위 YAML에 라이선스·작업 종류·기반 모델이 적혀 검색 필터에 나옵니다. DeepSeek-V4-Pro는 MIT 라이선스로 표시되지만 모든 모델이 그렇지는 않습니다. 공개 범위는 누구나 받는 공개, 소유자와 조직원만 보는 비공개, 신청 후 소유자가 승인해야 받는 세 가지입니다. 오픈 웨이트(open weights)는 학습으로 얻은 숫자 묶음인 가중치를 공개한 모델이고, 학습 데이터와 코드까지 공개한 오픈소스와는 다르니 상업 이용 여부를 문구로 확인해야 합니다.
한 줄로 받고 한 줄로 돌리는 명령
받는 방법은 명령줄 도구, 파이썬 SDK, Git 세 가지입니다. 기본 저장 위치는 ~/.cache/modelscope/hub(환경 변수 MODELSCOPE_CACHE로 변경)이고, 도구가 기본으로 modelscope.cn 서버와 통신하므로 국제판을 쓰려면 MODELSCOPE_DOMAIN=www.modelscope.ai를 지정합니다.
pip install modelscope
export MODELSCOPE_DOMAIN=www.modelscope.ai

# 설정 파일만 먼저 받아 구조를 확인
modelscope download --model 'Qwen/Qwen2-7b' --include '*.json' --local_dir './local_dir'

# 필요하면 safetensors 가중치만 받기
modelscope download --model 'Qwen/Qwen2-7b' --include '*.safetensors'
수십 GB를 받기 전에 JSON 설정 파일부터 받으면 구조와 크기를 가늠하기 쉽습니다.
| 옵션 | 하는 일 |
|---|---|
–include · –exclude |
받을 파일, 제외할 파일을 글롭 패턴으로 지정 |
–local_dir |
지정한 폴더에 바로 저장, –cache_dir와 같이 쓰면 이쪽이 우선 |
–revision |
버전·브랜치·태그 지정 |
–dataset |
모델 대신 데이터셋 받기 |
–max-workers |
동시에 받는 스레드 수 |
–token |
비공개 모델용 접근 토큰 (또는 modelscope login –token) |
파이썬에서는 snapshot_download로 저장소 전체를, model_file_download로 파일 하나를 받고 allow_patterns·ignore_patterns로 걸러 냅니다. GGUF 저장소에서 q4_k_m 파일 하나만 받는 식이 흔한 용례입니다. Git으로 받을 때는 Git LFS를 설치한 뒤 git clone https://www.modelscope.ai/<소유자>/<모델>.git을 쓰고, 큰 파일 대신 포인터만 받으려면 GIT_LFS_SKIP_SMUDGE=1을 앞에 붙입니다. 데이터셋은 MsDataset.load(‘squad’) 한 줄입니다. 비공개 모델을 받을 때 문서의 한 방법은 oauth2:토큰@를 주소에 넣는 것인데, 토큰이 저장소의 원격 주소에 남습니다. modelscope login –token으로 로그인하는 쪽이 안전합니다.
GGUF는 모델을 압축(양자화)해 일반 PC에서도 돌게 만든 파일 형식이고, 허브에 수만 개 있다고 문서가 밝힙니다. 로컬 실행 도구와는 한 줄로 이어집니다.
ollama run modelscope.ai/Qwen/Qwen2.5-3B-Instruct-GGUFOllama 0.3.12 이상이 권장이고 저장소에 Q4_K_M 파일이 있으면 그것을 기본으로 고릅니다. 정밀도를 직접 고르려면 :Q3_K_M처럼 뒤에 붙이고, 비전 모델은 0.4.0 이상이 필요합니다. llama.cpp는 MODEL_ENDPOINT=https://www.modelscope.ai/를 지정하고 llama-cli -hf <모델 ID>를 실행하면 허브에서 바로 받아 갑니다.
허브 곁가지 저장소와 광장
허브는 모델 창고만이 아닙니다. 같은 GitHub 조직(modelscope)에 용도별 저장소가 있고, 허브와 연동되는 파이썬 라이브러리 modelscope/modelscope의 최신 릴리스는 10월 9일의 v1.40.2(인텔 XPU 장치 지원 추가)입니다. 수치는 2026년 10월 27일(UTC) GitHub API 기준입니다.
| 저장소 | 별 | 라이선스 | 맡은 일 |
|---|---|---|---|
| FunASR | 20,827 | MIT | 음성 인식 툴킷(스트리밍 인식, 음성 구간 검출, 화자 구분) |
| ms-swift | 15,942 | Apache-2.0 | LLM 600개 이상, 멀티모달 모델 300개 이상의 사전학습·미세조정·정렬 |
| DiffSynth-Studio | 13,304 | Apache-2.0 | 확산(diffusion) 모델 도구 |
| modelscope | 9,190 | Apache-2.0 | 허브 연동 라이브러리, 포크 970개 |
| ms-agent | 4,417 | Apache-2.0 | 에이전트 실행 프레임워크 |
문서 사이트에는 MCP 광장(MCP Plaza)과 스킬 센터(Skills Center)도 있습니다. MCP 광장의 무료 배포 한도는 사용자당 서비스 20개, 서비스당 인스턴스 1개, 무료 배포 서비스 전체가 5초 창에서 500회 요청까지입니다. 스킬 센터는 에이전트용 기능 묶음(SKILL.md 폴더)을 검색해 npx skills add나 modelscope skills add로 설치하게 하고, 셸 스크립트 설치는 curl로 받은 파일을 바로 bash에 넘기는 형태라 내용을 확인하지 않고 실행하게 됩니다. 신뢰하지 않는 스킬이면 파일을 먼저 받아 읽어 본 뒤 실행하세요.
수치 장부: 값과 확인한 날
본문에 쓴 수치를 어디서, 언제 확인했는지 한곳에 모았습니다. 한도와 모델 목록은 바뀌므로 쓰기 전에 해당 문서를 다시 여는 편이 좋습니다.
| 항목 | 값 | 기준 |
|---|---|---|
| 공식 문서 버전 | 2026-09-01판 (10월 27일에도 같은 버전) | 문서 저장소 |
| 일일 로그인 큐브 | 200 (단기, 24시간) | Magicube 문서 |
| 클라우드 계정 연결 보너스 | 50/일 (단기) | Magicube 문서 |
| API 호출 단가 | 경량 약 0.5, 표준 약 1, 플래그십 약 2큐브 | API-Inference 한도 문서 |
| 계정 하루 호출 | 2,000회 (전 모델 합산) | 공식 신규 사용자 안내 글 |
| 모델별 하루 호출 | 최대 200회, 실제는 더 낮을 수 있음 | 같은 글 |
| 활성 접근 토큰 | 최대 10개 | 토큰 문서 |
| 코딩 도구 연결 코스 | Claude Code·OpenCode·Qwen Code·Codex CLI | 공식 코스 글, 2026-08-25 |
| 모델 저장소 크기 | 2.1GB(GGUF)에서 1,506.7GB(GLM-5.2) | 저장소 파일 합산, 10월 27일 |
| 허브 연동 라이브러리 | v1.40.2 (10월 9일), 별 9,190, 마지막 푸시 10월 23일 | GitHub API, 10월 27일 UTC |



