IDE 기능을 이식하고 두 번째 모델이 감시하는 터미널 코딩 에이전트 oh-my-pi
oh-my-pi(omp)의 '편집 방식만 바꿔도 모델이 좋아진다'는 주장을 16개 모델 표로 다시 세고, LSP·서브에이전트·감시 모델·기본 승인 모드(yolo)를 기본값과 조건까지 확인했습니다.
oh-my-pi의 README는 편집 도구를 소개하면서 어떤 모델을 골라도 편집이 첫 시도에 맞는다고 말하고, 그 근거로 든 블로그의 16개 모델 표는 해시라인 방식이 patch 방식보다 높은 모델이 15개, 낮은 모델이 1개라고 적습니다. 말한 것과 잰 것 사이에 이만한 간격이 있다는 뜻이고, 이 글은 그 간격을 주장 하나씩 재 보는 글입니다. oh-my-pi(명령어 이름은 omp)는 Stencil Labs의 Can Bölük이 Mario Zechner의 오픈소스 에이전트 Pi를 포크해 키운 MIT 라이선스 터미널 코딩 에이전트로, 언어 서버(LSP)와 디버거와 서브에이전트를 도구로 내장했습니다. 기준일은 UTC 2026-10-27이고, 숫자는 그날 GitHub·npm과 프로젝트 문서에서 다시 확인했습니다.
도구 탓이라는 진단이 나온 실험의 조건
주장의 출발점은 2월 12일에 올라온 제작자의 블로그 글입니다. 에이전트 성능 이야기는 어느 모델이 더 똑똑한가로 흐르는데, 모델과 파일 사이에 있는 소프트웨어인 하네스(harness)가 실패의 큰 몫을 만든다는 내용입니다. 하네스는 모델에게 읽기·편집·실행 같은 도구를 쥐여 주고 그 결과를 다시 모델에 돌려주는 틀입니다. 모델이 무엇을 고칠지 알아도 그 변경을 파일에 정확히 적는 마지막 단계에서 실패가 난다는 진단입니다.
실험 조건은 글에 적혀 있습니다. React 코드베이스에서 임의의 파일을 고르고 연산자 뒤집기, 불리언 반전, 한 칸 어긋남(off-by-one), 옵셔널 체이닝 제거, 식별자 바꾸기 같은 기계적 변이를 심은 뒤 그 버그를 평이한 문장으로 설명해 모델이 고치게 했습니다. 과제 180개를 3번씩, 매번 새 세션에서, 읽기·편집·쓰기 도구만 주고 16개 모델에 돌렸고, 끝난 뒤 원본 파일과 서식 적용 전후를 비교했습니다. 바뀐 것은 편집 도구의 입력 형식뿐이고, 비교한 형식은 셋입니다.
- patch: Codex의
apply_patch, OpenAI식 diff 문자열입니다. 블로그는 OpenAI 쪽 모델이 이 문법에 맞춰져 있을 것이고 다른 모델에게는 낯선 언어라고 설명합니다. - replace: Claude Code 같은 도구가 쓰는
str_replace로, 바꿀 원문을 한 글자도 틀리지 않게 다시 써서 찾는 방식입니다. 일치하는 곳이 여럿이면 거부됩니다. - hashline: 읽을 때 줄에 붙여 준 해시 태그를 인용해 줄을 가리키는 방식입니다.
이 실험은 제작자의 자체 측정이고, 과제는 심어 둔 버그를 되돌리는 기계적 과제입니다. 블로그도 모델이 원본과 다른 유효한 해법을 낼 수 있어 100%를 기대하지 않는다고 적었습니다. 같은 질문을 던진 다른 측정으로는 Aider의 벤치마크(GPT-4 Turbo가 편집 형식에 따라 26%에서 59%로 움직였고 GPT-3.5는 같은 형식에서 19%), JetBrains의 Diff-XYZ(모든 모델과 상황에서 이기는 형식은 없음), Cursor가 자사 블로그에서 밝힌 “400줄 미만 파일은 통째로 다시 쓰는 편이 diff보다 낫다”가 블로그에 인용돼 있습니다. 편집 형식이 점수를 움직인다는 방향은 여러 곳에서 나왔지만, 어느 형식이 항상 낫다는 합의는 없다는 것이 이 인용들의 공통점입니다.
줄을 베끼는 편집과 줄을 가리키는 편집, 실패가 갈리는 자리
두 방식이 어디서 갈라지는지는 다음 그림으로 보면 됩니다. 위쪽 길은 모델이 옛 줄을 다시 써야 하고, 아래쪽 길은 읽을 때 받은 태그와 줄 번호만 적습니다.
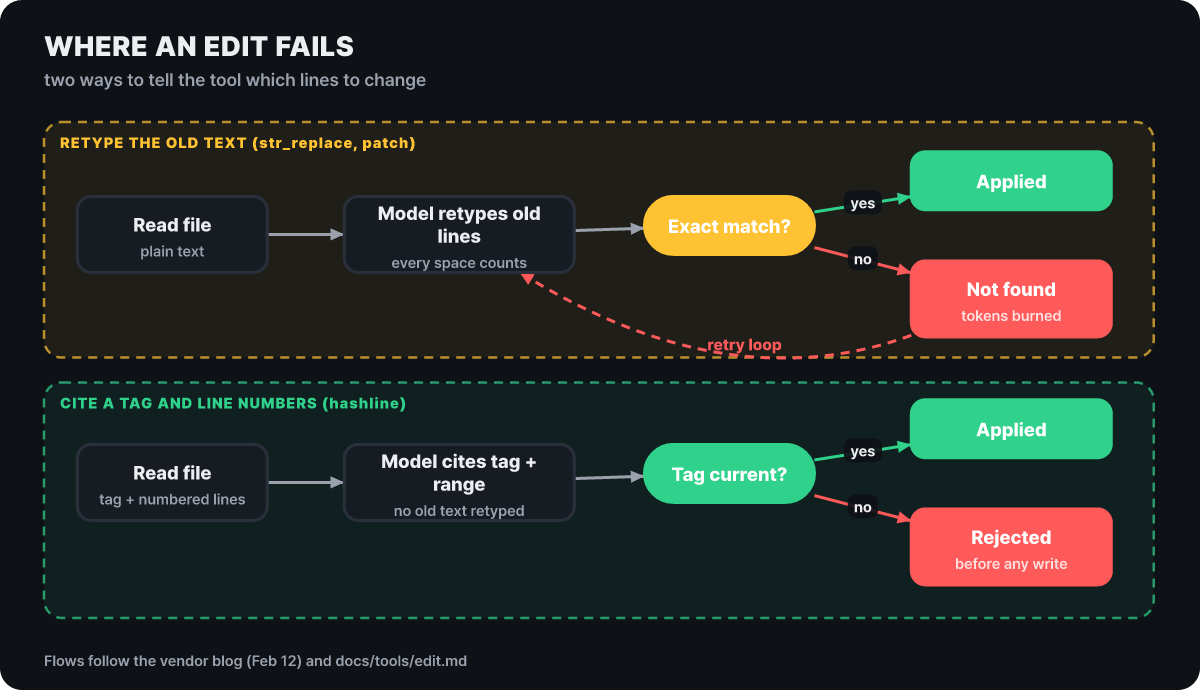 그림 1. 같은 편집이 두 방식에서 실패하는 모양. 위쪽은 재시도로 이어지고 아래쪽은 쓰기 전에 멈춘다
위쪽 길에서는 공백 하나, 들여쓰기 하나가 어긋나도 “찾을 수 없음”이 되고 모델은 같은 시도를 되풀이합니다. 아래쪽 길에서는 바꿀 줄의 옛 내용을 쓰지 않으니 그런 실패가 없고, 읽은 뒤 파일이 바뀌었다면 태그가 달라져 아무것도 쓰기 전에 거부됩니다. 거부가 곧 실패라는 점은 같지만, 파일이 망가지기 전에 멈춘다는 점이 다릅니다. omp 문서에 따르면 태그가 오래됐다고 곧바로 버리지는 않고, 기록된 스냅샷 이력으로 안전하게 적용할 수 있다고 증명될 때만 자동으로 복구하며, 그렇지 않으면 현재 태그와 주변 줄을 담아 거부합니다. 본 적 없는 줄을 고치려는 요청도 기본 설정(edit.enforceSeenLines)에서 거부되고, 자동 생성 파일의 편집도 기본으로 막힙니다(edit.blockAutoGenerated).
16개 모델 표에서 부호를 세어 보면
블로그에는 모델별 표가 있습니다. 해시라인이 patch와 replace보다 몇 점 높았는지를 모델 16개에 대해 적은 것이고, 아래 그림은 그 값을 그대로 옮겼습니다. 막대가 오른쪽으로 길수록 해시라인이 앞섰다는 뜻이고, 빨간 테두리는 음수입니다.
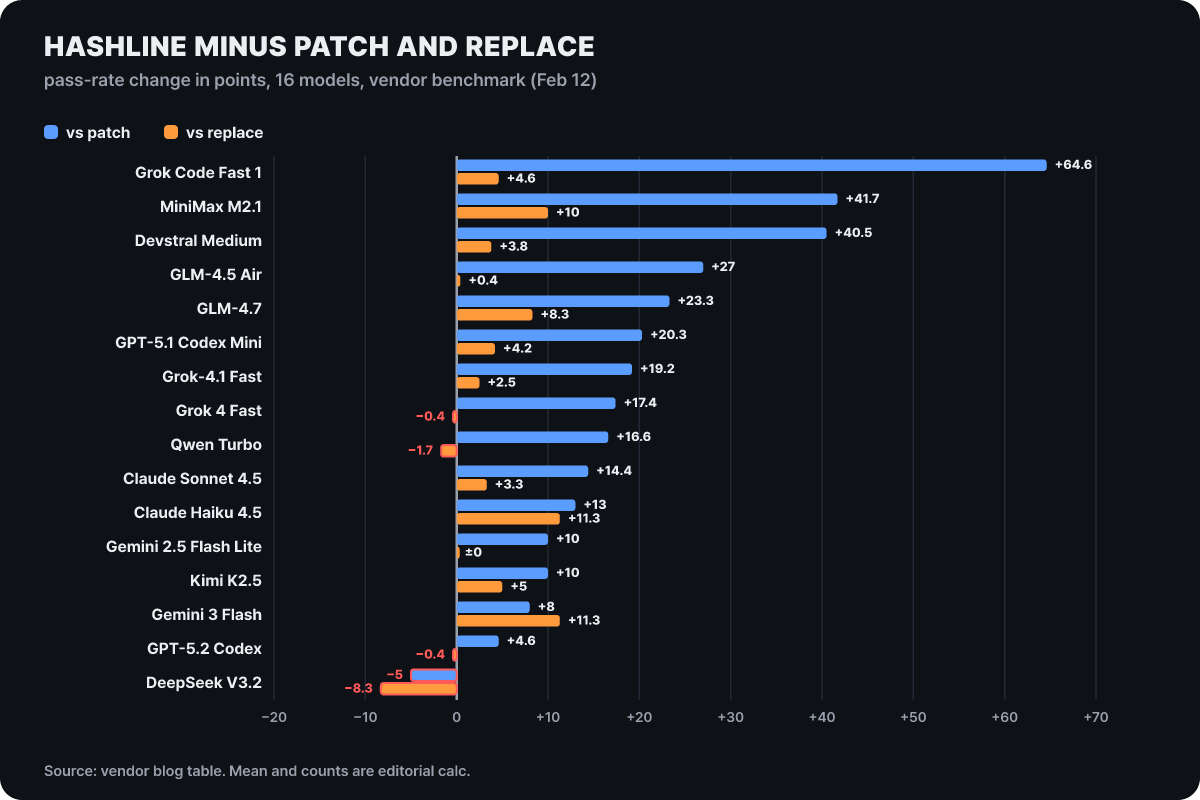 그림 2. 블로그 표의 두 열. patch 대비 평균 20.4점, replace 대비 평균 3.4점은 편집부 계산이다
patch와 비교하면 15개 모델이 올랐고 DeepSeek V3.2만 5점 내려갔습니다. 평균은 20.4점, 중앙값은 17.0점입니다. 그런데 replace와 비교하면 그림이 달라집니다. 올라간 모델이 11개, 같은 모델이 1개, 내려간 모델이 4개이고 평균은 3.4점입니다. 내려간 4개 중 셋은 0.4점이나 1.7점 정도라 사실상 같은 수준이고, 가장 크게 내려간 것은 DeepSeek V3.2의 8.3점입니다. 반대로 Claude Haiku 4.5와 Gemini 3 Flash는 replace보다도 11.3점 높았습니다.
이 표에서 읽을 수 있는 것은 이렇습니다. 큰 이득의 대부분은 patch 형식을 버린 데서 나옵니다. 지금 str_replace 계열 도구를 쓰고 있다면 같은 효과가 한 자릿수 점수로 줄어든다고 보는 편이 표에 맞습니다. 이득의 크기는 모델마다 크게 갈립니다. 위쪽은 Grok Code Fast 1(+64.6), MiniMax M2.1(+41.7), Devstral Medium(+40.5)이고, 아래쪽은 GPT-5.2 Codex(+4.6)와 DeepSeek V3.2(−5)입니다. patch 문법에 익숙하다고 블로그가 설명한 OpenAI 계열이 이득이 가장 작은 축에 있다는 점은 그 설명과 맞아떨어집니다. 이 표는 변화량만 싣고 있어서 “약한 모델일수록 이득이 크다”는 말은 변화량이 큰 순서로 읽는 수밖에 없다는 점도 같이 알아 두면 좋습니다.
같은 모델에 숫자가 둘 이상 붙을 때
한 모델의 향상을 인용하려는 순간 숫자가 여러 개 나옵니다. 블로그 본문과 표, README를 맞대 보면 다음과 같습니다.
| 대상 | 한쪽 | 다른 쪽 |
|---|---|---|
| Grok Code Fast 1의 patch 대비 향상 | 본문 6.7%에서 68.3%로, 차이 61.6점 | 표의 Δ patch +64.6 |
| patch 대비 평균 향상 | 블로그 머리말 +15점 | 표 열의 평균 +20.4점, 중앙값 +17.0점(편집부 계산) |
| 해시라인이 patch를 앞선 모델 수 | 본문과 README 14/16 | 표의 부호를 세면 15/16(편집부 계산) |
| Gemini 3 Flash의 향상 | 표 +8(patch 대비), +11.3(replace 대비) | 본문 “구글 자체 최선 시도보다 5.0점 높은 78.3%”, README “+5 pp, str_replace 대비” |
Gemini 3 Flash 줄이 가장 복잡합니다. 같은 모델에 붙은 숫자가 기준선만 세 가지입니다. patch 대비 +8, replace 대비 +11.3, 그리고 구글이 해당 모델에 제시한 최선의 시도 대비 5.0점입니다. README는 마지막 것을 “str_replace 대비”라는 짧은 표기로 옮겨 적었습니다. 어느 숫자가 틀렸다는 이야기가 아니라, “Gemini가 5점 올랐다”를 그대로 가져다 쓰면 무엇보다 5점 올랐는지가 사라진다는 이야기입니다. 개정판(v2)의 결과도 같은 방식으로 읽어야 합니다. 블로그는 v2가 16개 중 12개 모델에서 추가로 좋아졌고 가장 크게 오른 것이 GPT-5.1 Codex Mini의 60.0%에서 77.5%라고 적었는데, 이 상승은 해시라인 첫 판 대비입니다.
토큰 −61%는 최선의 경우였다
README의 표에 실린 토큰 숫자는 Grok 4 Fast의 −61%입니다. 재시도 루프가 사라져 출력 토큰이 줄었다는 설명이 붙어 있습니다. 블로그 표에는 이 값이 있는 모델이 12개이고, 가로축을 정확도 향상으로 놓으면 분포가 한눈에 보입니다. 아래쪽일수록 출력 토큰이 많이 줄었습니다.
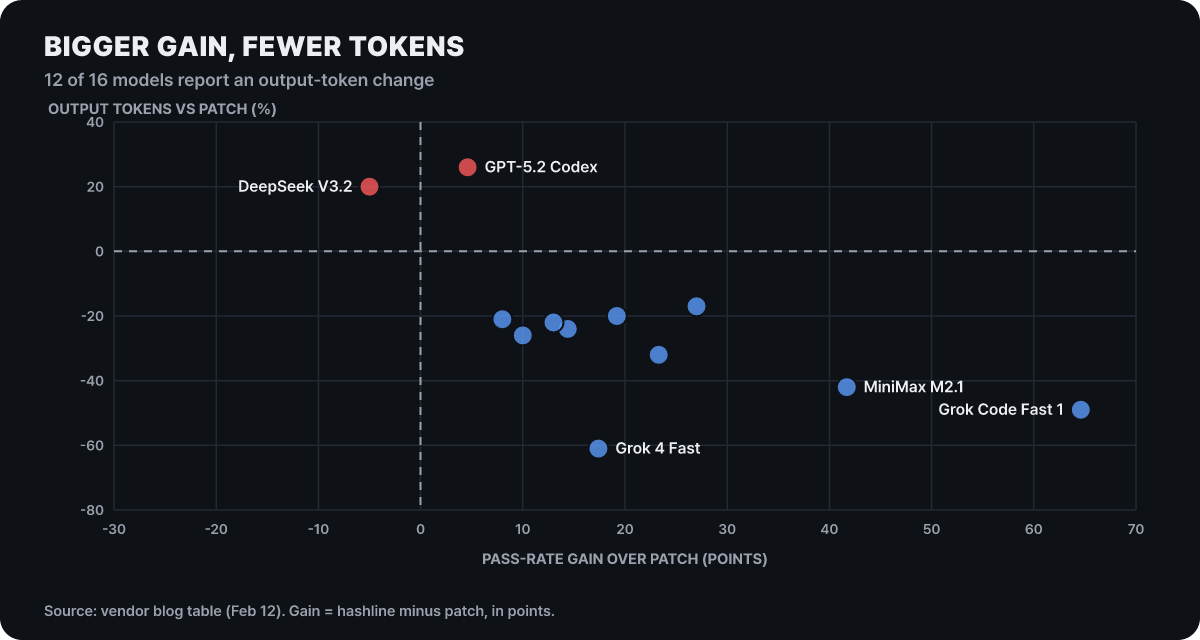 그림 3. 이득이 큰 모델은 토큰이 줄고, 이득이 거의 없던 두 모델은 토큰이 늘었다. 표는 블로그 값
12개 중 10개는 토큰이 줄었고 중앙값은 −23%, 평균은 약 −22%입니다(편집부 계산). −61%는 가장 좋았던 하나이고, 블로그 본문이 말하는 일반적인 규모도 20% 안팎입니다. 점 두 개는 반대편에 있습니다. GPT-5.2 Codex는 토큰이 26%, DeepSeek V3.2는 20% 늘었고, 두 모델은 향상 폭도 표에서 가장 작은 둘입니다. 나머지 네 모델(Devstral Medium, GPT-5.1 Codex Mini, Qwen Turbo, Gemini 2.5 Flash Lite)은 토큰 값이 표에 비어 있습니다. 헤드라인 숫자는 분포의 끝이라는 점, 그리고 새 형식이 잘 맞지 않는 모델에서는 오히려 토큰을 더 쓸 수 있다는 점이 이 그림이 보여 주는 것입니다.
지금의 기본 편집 방식은 실험에서 잰 해시라인이 아니다
블로그가 설명한 해시라인은 읽을 때 줄마다 2~3자의 내용 해시를 붙이는 방식입니다. 현재 omp 문서의 기본 편집 방식은 이름만 같고 구현이 다릅니다. 파일을 읽으면 파일 하나에 대문자 16진수 네 자리 스냅샷 태그가 붙고 줄 번호가 매겨지며, 편집은 그 태그 아래 줄 번호로 쓰는 작은 패치 언어입니다. 아래 그림은 문서가 든 예시를 그대로 옮긴 것으로, 실제 세션 기록이 아닙니다.
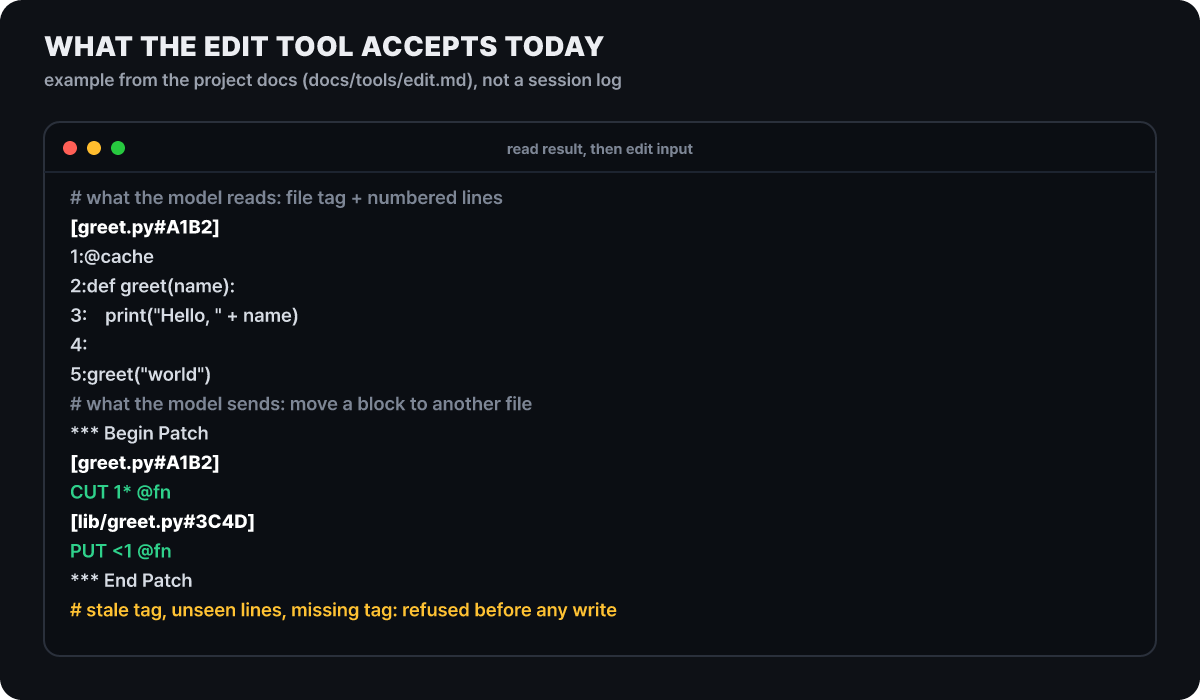 그림 4. 현재 omp 문서의 편집 입력 예시. 모든 줄 번호는 읽을 때의 원본 기준이다
문법을 풀어 쓰면 PUT N.=M:은 N부터 M까지를 이어지는 + 줄로 교체하고, PUT <N과 PUT >N은 N번 줄 앞이나 뒤에 끼워 넣고, CUT은 지우면서 이름 붙은 레지스터에 담아 다른 곳에 붙여 넣게 합니다. PUT N*:처럼 별표를 붙이면 문법 트리(tree-sitter)로 찾은 블록 전체를 대상으로 하고, 파일 삭제(REM)와 이동(MV)도 같은 문법으로 씁니다. 태그가 맞지 않을 때의 거부는 이유별로 이름이 붙어(stale_tag, unseen_lines, missing_tag, unknown_tag, other_file_tag 등) 도구 결과에 남습니다. main 브랜치의 변경 이력에는 /session이 실패한 편집을 이 이유별로 집계해 보여 주는 항목이 18.13.0으로 올라와 있지만, npm 최신판은 아직 18.12.6입니다.
편집 방식은 다섯 가지(hashline, apply_patch, patch, replace, sloppy)이고 선택 순서는 모델별 설정, 환경 변수 PI_EDIT_VARIANT, 설정 edit.mode, 기본값 hashline입니다. 여기에 모델 계열 자동 대체가 있습니다. 설정으로 정한 해시라인이면 Kimi·MiMo·MiniMax·DeepSeek·StepFun·Codex Spark·GLM 5.3 Flash 계열은 replace로 바뀌며, 환경 변수 PI_STRICT_EDIT_MODE로 이 대체를 끌 수 있습니다. 표에서 해시라인이 지던 DeepSeek 계열이 이 목록에 있는 것은 표와 맞지만, 표에서 replace보다 높았던 MiniMax M2.1(+10)과 Kimi K2.5(+5)의 계열도 목록에 있습니다. 목록의 근거가 2월의 이 표 하나는 아니라는 뜻이고, 그래서 표는 “형식을 바꾸면 점수가 움직인다”의 증거로 읽고 지금 기본값의 점수표로는 읽지 않는 편이 정확합니다.
LSP 14가지와 디버거 28가지를 세어 본 결과
README 머리의 숫자(내장 도구 31개, LSP 연산 14개, 디버거 연산 28개, 모델 제공자 60개 이상)는 소개 문구이고, 도구 문서의 동작 목록을 세어 보면 LSP 14개와 디버거 28개는 맞습니다. LSP는 편집기가 “이 함수의 정의는 어디”, “이 이름을 쓰는 곳은 어디”를 언어별 서버에 묻는 표준 통신 규약이고, omp는 이 서버들을 lsp 도구 하나로 묶어 diagnostics, definition, references, hover, symbols, rename, rename_file, code_actions, type_definition, implementation, status, reload, capabilities, request를 제공합니다. README가 든 장면은 파일을 옮기는 요청입니다. rename_file이 workspace/willRenameFiles를 거쳐 임포트와 재수출, 별칭 경로를 파일이 움직이기 전에 서버가 알려 주는 대로 갱신하므로, 같은 이름의 다른 변수까지 바꿔 버리는 문자열 치환과 다릅니다. 쓰기 직후 진단(lsp.diagnosticsOnWrite)은 기본 켜짐, 쓰기 뒤 자동 포맷(lsp.formatOnWrite)은 기본 꺼짐입니다.
README가 말하지 않는 조건이 있습니다. 서버는 현재 작업 폴더에 그 언어의 루트 표지 파일(package.json, go.mod 같은 것)이 있고, 서버 실행 파일이 프로젝트의 node_modules/.bin 같은 위치나 PATH에서 발견될 때만 시작합니다. 표지 파일 탐색은 부모 폴더까지 올라가지 않고, omp가 서버를 대신 설치해 주지도 않습니다. LSP가 안 켜질 때는 이 두 조건과 실행 옵션의 --no-lsp를 순서대로 보면 됩니다. 서버를 끄거나 바꾸려면 ~/.omp/agent/lsp.json이나 프로젝트의 .omp/lsp.json에 적고, 이런 모양입니다.
{
  "servers": {
    "eslint": { "disabled": true }
  },
  "idleTimeoutMs": 300000
}
위 예시는 eslint 서버를 끄고 5분 쓰지 않은 서버를 종료하게 하는 설정입니다. 작업 폴더 전체의 진단(file: "*")은 표지 파일을 보고 cargo check, npx tsc --noEmit, pyright, go build 중 해당하는 것을 최대 두 개씩 동시에 돌립니다.
디버거는 DAP(Debug Adapter Protocol)로 붙고, 도구 하나(debug)에 중단점, 한 줄씩 실행, 호출 스택과 변수 읽기, 식 평가, 메모리 읽기·쓰기, 디스어셈블까지 28가지 동작이 있습니다. README는 C 바이너리에 lldb, Go 서비스에 dlv, 파이썬 프로세스에 debugpy를 붙이는 예를 듭니다. 승인 등급은 동작별로 다릅니다. 변수·스택·출력을 읽는 동작은 읽기 등급이고, 실행을 시작하거나 중단점을 걸거나 메모리를 쓰는 동작은 실행 등급입니다. README의 캡처는 xorshift32라는 함수를 멈춰 세우고 변수 x가 7에서 57351로 바뀐 것을 읽은 뒤 7 ^ (7<<13)이 57351과 같은지 에이전트가 직접 계산해 확인하는 모습입니다. 7<<13이 57344이고 7과 XOR하면 57351이니 계산도 맞습니다.
서브에이전트는 일하고 감시 모델은 말만 한다
제목에서 “두 번째 모델이 감시한다”는 말이 가리키는 기능(advisor)은 서브에이전트(task)와 하는 일이 다릅니다.
서브에이전트(task)
- 일을 나눠서 직접 수행한다
- 결과를 스키마로 검증된 객체로 부모에게 돌려준다
- 작업자마다 자기 도구 세트로 읽고 고치고 실행한다
advisor(감시 모델)
- 메인 에이전트의 진행을 읽고 조언만 끼워 넣는다
- 조언은 가벼운 메모, 우려, 차단급 메모 세 가지 강도
- 행동을 승인하거나 막을 권한은 없고, 기본 도구는 읽기·grep·glob
서브에이전트 호출에는 모든 작업자에게 공통으로 들어가는 context(필수)와 작업마다의 지시문 목록(tasks)이 들어가고, 작업마다 solutionSpace를 적습니다. 해결책이 이미 정해졌는지(“한 가지 수정, 이름은 지정됨”) 원인부터 열려 있는지(“교착 원인 미상, 재현 없음”)를 한 줄로 밝히는 항목이며, 서브에이전트가 얼마나 깊이 생각할지를 분류하는 입력으로 쓰입니다. 돌아오는 결과는 글이 아니라 스키마로 검증된 객체이고, 부모가 출력 스키마(outputSchema)를 지정할 수 있습니다. 기본 모드(permissive)는 재시도를 소진한 뒤 형식이 어긋난 결과도 경고와 함께 받아들이므로, 실패로 처리하려면 strict로 바꿔야 합니다. 같은 파일을 동시에 고쳐 충돌하는 일을 막는 격리 작업 공간(isolated)은 task.isolation.enabled를 켰을 때만 도구 입력에 나타나며, APFS 복제, btrfs·zfs 리플링크, overlayfs, projfs, 단순 복사 같은 백엔드가 지원됩니다. 실행 중에는 Alt+A로 에이전트 허브를 열어 서브에이전트별 활동과 사용량을 보고, 하나를 열어 대화 기록을 읽거나 방향을 바꾸는 메시지를 보내거나 그 작업자만 종료할 수 있습니다. 내장 에이전트는 scout, reviewer, security-reviewer, task, sonic이고, /review는 리뷰어를 병렬로 띄워 문제마다 P0에서 P3까지 우선순위와 확신도를 매기고 내보내도 되는지 판정합니다.
advisor는 기본으로 꺼져 있습니다. --advisor 옵션, 세션 안의 /advisor on, 설정 advisor.enabled: true로 켜며, 문서의 설정표는 이 값이 modelRoles.advisor가 쓸 수 있는 모델로 해석될 때 동작한다고 적습니다. 모델을 정하지 않으면 심층 추론용 slow 역할을 따라가고, 명시한 모델을 쓸 수 없을 때 조용히 다른 모델로 바꾸지 않습니다. 그래서 장애나 호출 한도를 대비해 대체 모델 줄을 세워 둡니다.
modelRoles:
  advisor: openai/gpt-5.5:medium

advisor:
  enabled: true

retry:
  fallbackChains:
    advisor:
      - anthropic/claude-sonnet-4-5:medium
위 형식은 omp 문서의 advisor 설정 예시를 따른 것입니다. 메인 에이전트는 조언을 보고 방향을 고치거나 따르지 않는 이유를 사용자에게 설명하고, 두 번째 모델의 호출이 따로 발생하니 비용도 그만큼 늘어납니다. 제목의 감시는 이 기능을 켠 경우의 이야기입니다.
어길 때만 끼어드는 규칙, 그리고 마법 단어
프로젝트 규칙을 AGENTS.md에 길게 적으면 매 턴 컨텍스트를 차지합니다. omp의 TTSR(Time Traveling Stream Rules)은 규칙을 평소에는 잠가 두었다가 모델의 출력이 조건에 걸리는 순간에만 꺼냅니다. 모델이 글이나 도구 인자를 흘려보내는 도중 정규식 조건이 일치하면 응답을 끊고 규칙 본문을 시스템 알림으로 끼워 넣은 다음 같은 지점부터 다시 쓰게 하는 순서입니다. 규칙은 프로젝트의 .omp/rules/나 사용자 폴더 ~/.omp/agent/rules/에 마크다운 파일로 두고, 머리말의 condition이 조건입니다.
---
description: 운영 코드에서 Box::leak 금지
condition:
  - "Box::leak"
---
운영 코드 경로에서는 Box::leak 대신 Arc<str> 같은 소유권 있는 타입을 쓴다.
README의 장면에서는 에이전트가 Box::leak을 쓰려는 순간 요청이 중단되고 규칙이 주입된 뒤 Arc<str>을 제안하며 확인을 구합니다. 조건에는 정규식 외에 구조로 찾는 astCondition(ast-grep 패턴)과, 완성된 출력에 판정용 모델이 예·아니오로 답하는 question이 있습니다. question형은 글이 흐르는 도중에 끊지 않고 끝난 뒤 경고로만 전달됩니다. 감시 대상은 기본적으로 응답 본문과 도구 인자이고 생각(reasoning)은 제외입니다.
프롬프트에 쓰는 마법 단어는 더 가벼운 장치입니다. 소문자 단독 단어가 있으면 그 턴에만 숨은 지시가 붙고, 코드 블록·경로·식별자 안에서는 반응하지 않으며, 기본으로 켜져 있어 omp config set magicKeywords.enabled false로 끕니다. ultrathink는 신중한 다단계 추론을 요청하고 자동 생각 수준이 켜져 있으면 그 모델이 지원하는 가장 높은 수준을 고릅니다. orchestrate는 task가 켜져 있어야 하고 독립적인 일을 서브에이전트에 병렬로 맡깁니다. workflowz는 eval과 task가 모두 켜져 있을 때 여러 서브에이전트의 워크플로를 꾸리고, jevify는 eval이 켜져 있을 때 긴 목록을 일괄 판정합니다.
기본값이 열려 있다: 승인 모드와 꺼져 있는 기능
이 글에서 가장 먼저 손봐야 할 설정입니다. tools.approvalMode의 기본값은 yolo로, 읽기·쓰기·실행 도구를 모두 묻지 않고 자동 승인합니다. 나머지는 always-ask(읽기만 자동), always-ask-cached(파일 읽기도 묻고 승인한 파일이나 폴더를 기억), write(읽기와 쓰기 자동, 실행은 질문)입니다. 모델이 셸 명령을 내리면 확인 창 없이 실행됩니다.
rm -rf /, 포크 폭탄, 내려받아 바로 실행하는 명령 같은 치명 패턴에 확인을 요구하는 안전 규칙이 있지만, 문서는 yolo에서는 이 단독 안전 규칙이 무시된다고 밝힙니다. yolo에서 유지되는 것은 사용자가 명시한 도구별 prompt·deny 정책입니다. 처음 쓸 때는 실행 옵션 –approval-mode always-ask를 붙이거나 설정을 바꾸세요.
always-ask-cached는 처음 읽는 파일 앞에서 멈추고, 승인할 때 그 파일이나 폴더를 기억시킬 수 있습니다. 폴더 허용은 그 폴더 바로 아래 파일에만 적용되고 하위 폴더에는 미치지 않습니다. 영구 설정은 omp config set tools.approvalMode always-ask이고, 도구 하나만 따로 묶으려면 설정 파일에 이렇게 씁니다.
tools:
  approvalMode: write
  approval:
    bash: prompt
eval: prompteval을 같이 적은 데는 이유가 있습니다. eval은 파이썬·자바스크립트 셀을 실행하는 도구라 셸을 부를 수 있어서, bash에만 거부 규칙을 걸면 같은 명령이 eval을 통해 통과합니다. 문서가 이 틈을 직접 경고합니다. bash.patterns 규칙은 승인 정책일 뿐 격리 장치가 아니라서 승인된 명령은 셸이 가진 파일·네트워크·하위 프로세스 접근을 그대로 갖습니다. main 브랜치 문서에는 지정한 폴더의 모든 동작을 yolo에서도 매번 묻게 하는 tools.restrictedFolders가 들어 있지만, 변경 이력에서 아직 릴리스 전 항목이라 18.12.6에는 없습니다.
소개글에서 기본 탑재처럼 읽히기 쉬운 기능의 실제 기본값은 아래와 같습니다(10월 27일 문서 기준).
| 기능 | 기본값 | 켜거나 바꾸는 법 |
|---|---|---|
| advisor(감시 모델) | 꺼짐 | advisor.enabled, --advisor, /advisor on |
| 기억(memory) | off (선택지는 off·local·hindsight·mnemopi) |
memory.backend |
| 스킬 자동 습득(autolearn) | 꺼짐, 실험 기능 | autolearn.enabled |
| 데스크톱 제어(computer) | 꺼짐 | computer.enabled, 세션 한정은 /computer |
| LSP, 쓰기 직후 진단 | 켜짐 | --no-lsp, lsp.diagnosticsOnWrite |
| 본 적 없는 줄 편집 거부, 생성 파일 편집 차단 | 켜짐 | edit.enforceSeenLines, edit.blockAutoGenerated |
| 마법 단어 | 켜짐 | magicKeywords.enabled |
낯선 저장소를 열 때 들어오는 것들
README의 “프로젝트 입력과 신뢰” 절이 두 번째로 중요한 주의점입니다. 저장소를 열면 그 안의 설정, 확장, 훅, 도구, 명령, 스킬, 규칙, 프로젝트 MCP 설정이 설계상 자동으로 로드됩니다. 훅은 .omp/hooks/pre/*.ts처럼 타입스크립트 코드이고 확장 모듈로 읽혀 실행되며, .omp/lsp.json은 언어 서버 실행 명령을 정할 수 있고 서버 실행 파일은 프로젝트 안의 node_modules/.bin 같은 위치를 PATH보다 먼저 찾습니다. 다른 도구의 설정을 그대로 읽는다는 소개도 같은 이야기의 다른 면입니다. .claude, .cursor, .windsurf, .gemini, .codex, .cline, .github/copilot, .vscode에 이미 있는 규칙·스킬·MCP 서버를 별도 변환 없이 읽고, 같은 이름이면 우선순위가 높은 쪽만 씁니다(omp 자체 100, 확장 패키지 90, agents 70, cursor와 windsurf 50, cline 40, github 30). 편리한 만큼, 내가 쓰지 않은 저장소를 omp로 열면 그 저장소가 에이전트의 동작을 바꿀 수 있고, 거기에 기본 승인 모드(yolo)가 겹치면 에이전트가 낸 명령이 확인 없이 실행됩니다.
줄이는 방법은 입력 종류별로 따로 있습니다.
| 들어오는 것 | 줄이는 옵션 |
|---|---|
| 확장·훅 | --no-extensions, 또는 --trusted-extension <절대경로>로 허용 목록 |
| 규칙·스킬 | --no-rules, --no-skills |
| 언어 서버 정의 | --no-lsp |
프로젝트 .mcp.json |
--config <파일>에 mcp.enableProjectConfig: false를 중첩 키로 적기(한 줄짜리 평면 키는 무시됨) |
| 내장 도구 | --no-tools(프로젝트 도구 모듈은 별도 탐색 대상) |
| 마지막 관문 | 승인 모드를 always-ask 이상으로 |
README는 이 옵션들이 입력을 좁힐 뿐 저장소 신뢰 모델 자체를 바꾸지는 않는다고 직접 적었습니다. 같은 문제를 반대로 푼 도구도 있습니다. 터미널 에이전트 Codewhale은 프로젝트 설정이 모델·승인 정책에서 조이는 방향의 값만 적용하고 저장소가 가진 API 키·기본 URL·제공자 정의는 무시한다고 문서에 적어 둡니다. omp는 편의를 위해 저장소 입력을 폭넓게 받는 쪽을 택했고 그 한계를 명시했습니다. 취약점은 최신 릴리스만 지원하며 GitHub의 비공개 보안 어드바이저리로 신고하게 안내돼 있습니다.
열기 전에 저장소가 무엇을 가져오는지 읽기 전용 명령으로 먼저 봅니다.
git ls-files | grep -E '^(\.omp/|\.mcp\.json|AGENTS\.md|\.claude/|\.cursor/|\.windsurf/|\.gemini/|\.codex/|\.cline|\.vscode/|\.agents?/)'출력이 없으면 자동 로드될 프로젝트 입력이 거의 없다는 뜻이고, 훅·확장·MCP 파일이 보이면 내용을 먼저 열어 본 뒤에 omp를 실행합니다.
설치, 모델 역할, 릴리스 간격
설치는 bun이 있으면 전역 설치가 권장 경로입니다. bun install -g @oh-my-pi/pi-coding-agent 또는 brew install can1357/tap/omp이고 Nix, mise, Windows용 PowerShell 스크립트도 있습니다. curl -fsSL https://omp.sh/install | sh 형태의 스크립트는 bun이 없으면 미리 빌드된 바이너리를 build.stencil.so에서 내려받아 SHA-256을 확인한 뒤 설치하고 --ref v<버전>으로 릴리스를 고정할 수 있지만, 내려받은 스크립트를 실행하는 방식이라 내용을 먼저 열어 보거나 패키지 관리자 경로를 쓰는 편이 안전합니다. bun으로 설치할 때는 bun 1.3.14 이상이 필요하고, Alpine 같은 musl 환경에서는 libstdc++와 libgcc 패키지를 먼저 깔아야 합니다. 처음에는 쓰던 프로젝트가 아니라 작은 연습 폴더에서 omp를 실행하고, 세션 안의 /login(터미널에서는 omp login)으로 제공자를 연결한 뒤 /model로 모델을 고르고 읽기만 하는 질문부터 시작합니다. 사용 방식은 대화형 omp, 한 번 답하고 끝나는 omp -p "프롬프트", Node용 SDK, 표준입출력으로 조종하는 omp --mode rpc, 편집기용 omp acp 다섯 가지입니다.
모델 제공자는 직접 API, 구독형 코딩 요금제, Ollama·LM Studio·llama.cpp·vLLM 같은 로컬 서버, 임의의 OpenAI 호환 서버까지 60개가 넘고 /model 하나로 바꿉니다. omp 자체는 MIT라 도구 사용료가 없고 비용은 모델 제공자에게 냅니다. 모델은 작업 종류별로 아홉 역할(default, smol, slow, plan, commit, vision, task, advisor, tiny)로 나뉘고, 서브에이전트를 많이 띄울 때는 값싼 smol을 맡길 수 있습니다. 한도 오류(429)가 나면 다음 모델이 이어받는 폴백 체인, 저장소 경로별로 다른 모델 집합을 고정하는 enabledModels의 path:, 한 제공자의 키 여러 개를 돌려 쓰는 순환이 비용·한도 관리 장치입니다. 내 서버는 ~/.omp/agent/models.yml에 등록하고 omp models <이름>으로 확인합니다. 웹 검색(web_search)은 검색 제공자 23개를 순서대로 묶어 쓰고, 보안 조회는 NVD, OSV, CISA KEV 같은 데이터베이스를 직접 참조합니다.
릴리스 속도는 저장소 숫자에서 읽을 수 있습니다. 2025년 12월 31일에 만들어진 저장소는 10월 27일 현재 별 36,695개, 포크 4,097개, 열린 이슈 4,245건(풀 리퀘스트 포함)이고, npm 패키지의 주간 다운로드는 16만 2천여 건(10월 16~22일)입니다. 최신 npm 릴리스 v18.12.6은 10월 21일 21시 UTC 무렵에 나왔고 그 앞에는 10월 17일 v18.12.1부터 매일 하나씩, 21일에는 두 개가 나왔습니다. 그 뒤로 엿새째 새 버전이 없고, main에는 18.13.0 항목이 적힌 변경 이력이 쌓이고 있습니다. 빠른 릴리스는 문제가 빨리 고쳐진다는 뜻이면서 설정 방법이 자주 바뀐다는 뜻이기도 해서, 업무 환경이라면 설치 스크립트에 --binary --ref v18.12.6처럼 버전을 고정하고 올릴 때 변경 이력에서 쓰는 기능을 먼저 확인하는 편이 안전합니다.
2월 12일의 표 이후 npm에는 485개 버전이 더 올라왔고, 그 사이 해시라인은 줄마다 붙던 해시에서 파일 태그와 블록 앵커, 레지스터를 갖춘 패치 언어로 바뀌었습니다. 표가 잰 것은 그날의 코드이니, 내 모델과 내 저장소에서 지금의 편집 방식이 얼마나 다른지는 같은 작업을 edit.mode나 PI_EDIT_VARIANT만 바꿔 두 번 돌려 보는 것이 가장 정확한 확인이 됩니다. 이 글에서 따져 본 숫자들이 대체로 방향은 맞고 크기는 조건마다 달랐듯이, 이 도구의 소개글도 방향을 먼저 읽고 크기는 내 환경에서 다시 재는 쪽이 어긋나지 않습니다.



