내 노트북에서 어떤 모델이 돌까, 명령 하나로 점수를 매기는 llmfit
16GB 노트북을 가정해 llmfit을 설치부터 bench까지 따라갑니다. 판정이 나오는 계산, 속도 칸의 신뢰 단계, 사기 전에 묻는 법, 막히는 곳을 짚었습니다.
16GB 메모리 노트북 앞에서 코딩을 도와 줄 로컬 모델을 하나 받으려는 장면을 떠올려 봅니다(편집부가 만든 예시입니다). 목록에는 7B, 14B, 32B가 줄지어 있고, 어느 것이든 받는 데 몇 분에서 한 시간이 걸립니다. 14B를 받아 실행했더니 첫 문장이 나오기까지 한참 걸리거나, 32B는 아예 올라오지 않습니다. 시행착오가 한 번에 한 시간씩이라면 받기 전에 숫자로 걸러 두는 편이 낫습니다. Rust로 만든 오픈소스 터미널 도구 llmfit이 그 일을 합니다. 내 하드웨어를 읽고 수백 개 모델을 “이 양자화로 이만큼 여유를 두고 돌아간다”는 순위표로 바꿉니다. 확인 기준(2026-10-27 UTC) GitHub 별 약 3만 8,400개, 포크 약 2,500개, MIT 라이선스이고, 최신 릴리스는 10월 8일의 v1.1.17입니다. 이 글은 위의 노트북 한 대를 기준으로 설치, 첫 화면 읽기, 판정 계산, 속도 숫자의 출처, 직접 재기, 사기 전 시뮬레이션 순서로 따라갑니다.
16GB 노트북이 모델 앞에서 멈추는 이유
모델 카드에는 매개변수 수만 적혀 있어서 “7B면 16GB로 되겠지”라는 어림이 자주 틀립니다. 메모리는 세 군데에 나뉘어 쓰입니다. 첫째는 가중치로, 대략 매개변수 수 × 비트 수 ÷ 8입니다. 70억 개를 8비트로 저장하면 약 7GB, 4비트(양자화: 가중치를 더 적은 비트로 줄이는 방식)면 약 3.5GB입니다. 방식마다 가중치당 실제 비트 수가 달라 파일 크기는 이보다 크거나 작을 수 있지만, 같은 모델이 양자화 한 단계에 두 배씩 오르내린다는 점은 같습니다. 둘째는 KV 캐시, 곧 모델이 앞서 읽은 내용을 다시 계산하지 않으려고 쌓는 임시 기억입니다. 문맥이 길어질수록 커집니다. 셋째는 런타임이 쓰는 여유 공간과 메모리 조각화입니다.
KV 캐시의 크기는 llmfit 문서의 동시 세션 예에서 가늠할 수 있습니다. Qwen2.5-7B-Instruct를 Q4_K_M으로 24GB 메모리에 올리면 가중치가 5.1GB이고 KV 캐시 예산이 18.9GB입니다. 문맥 4,096토큰짜리 세션 하나가 0.22GB를 차지하니 최대 85개 세션이 함께 올라가는 계산입니다. 문맥을 늘리면 세션당 비용이 올라 같은 예산에서 올릴 수 있는 세션이 줄어듭니다. 노트북에서 하나의 세션만 쓰더라도, 긴 문서를 통째로 넣는 순간 같은 모델이 다른 크기가 된다는 뜻입니다.
그래서 “모델이 들어가나”는 모델 하나의 숫자가 아니라 모델, 양자화, 문맥 길이, 내 메모리를 함께 넣어야 나오는 답입니다. llmfit이 하는 일이 바로 그 계산입니다.
설치하면서 대시보드부터 끄기
공식 README의 설치 방법은 여러 가지입니다. 패키지 관리자를 쓰는 쪽이 출처를 확인하기 쉽습니다.
# macOS · Linux
brew install AlexsJones/llmfit/llmfit

# Windows
winget install --exact --id AlexsJones.llmfit     # 또는 scoop install llmfit

# 설치 없이 실행(파이썬 도구 uv가 있을 때)
uvx llmfit
README에는 curl ... | sh 빠른 설치, uv tool install -U llmfit, MacPorts, 소스 빌드(cargo build --release), Docker 이미지(ghcr.io/alexsjones/llmfit)도 있습니다. 내려받은 스크립트를 바로 실행하는 방식은 먼저 내용을 열어 보는 습관을 들이는 편이 좋습니다.
설치 직후 첫 실행에서 알아 둘 것이 하나 있습니다. 문서에 따르면 JSON 모드가 아닐 때 인자 없이 llmfit을 실행하면 웹 대시보드가 백그라운드에서 0.0.0.0:8787로 같이 시작됩니다. 같은 네트워크의 다른 컴퓨터에서도 열 수 있다는 뜻이고, 화면에는 내 하드웨어 정보와 설치된 모델이 보입니다. 카페나 사무실망에서 쓴다면 처음부터 끄고 시작하세요.
llmfit --no-dashboard로 실행합니다. 대시보드를 켜 두고 싶다면 환경 변수LLMFIT_DASHBOARD_HOST=127.0.0.1로 내 컴퓨터만 접근하게 할 수 있습니다(포트는LLMFIT_DASHBOARD_PORT)- 위쪽에 감지된 CPU·RAM·GPU·백엔드가 뜨는지 봅니다. 이 줄이 틀리면 아래 모든 숫자가 틀립니다
- 사양만 따로 보려면
llmfit system, 감지 원본 출력까지 보려면llmfit doctor를 씁니다. doctor는 버그 제보용으로 만든 명령입니다
별도로 llmfit serve로 REST 서버를 열 때의 기본 주소는 127.0.0.1이고, 밖으로 열려면 –host 0.0.0.0을 명시해야 합니다. 두 기본값이 서로 다르다는 점을 기억해 두면 됩니다.
첫 화면의 열은 이렇게 읽는다
llmfit은 하드웨어를 이렇게 읽습니다. 공식 문서가 정리한 감지 방법입니다.
| 하드웨어 | 감지 방법 | VRAM 보고 |
|---|---|---|
| NVIDIA | nvidia-smi(여러 장이면 VRAM 합산) |
정확한 전용 VRAM |
| AMD | rocm-smi |
감지되지만 VRAM을 모를 수 있음 |
| 인텔 Arc(외장) | sysfs | 정확한 전용 VRAM |
| 인텔 Arc(내장) | lspci |
공유 시스템 메모리 |
| 애플 실리콘 | system_profiler |
통합 메모리(VRAM = RAM) |
이 예의 노트북이 애플 실리콘이라면 통합 메모리라서 16GB가 곧 풀 전체입니다. 감지가 끝나면 모델 표가 나오고, 문서의 TUI 설명이 적은 열은 Inst, Model, Provider, Params, Score, tok/s, Mem%, Ctx, Date, Quant, Mode, Fit, Use Case입니다. 아래 그림은 이 열 중 판정과 직접 관련된 것만 골라 노트북 한 대의 모습을 가정해 그린 것입니다. 문서에 실제 출력 예가 없어 열 이름은 문서를, 숫자는 편집부가 판정 규칙대로 계산한 가정값을 썼습니다.
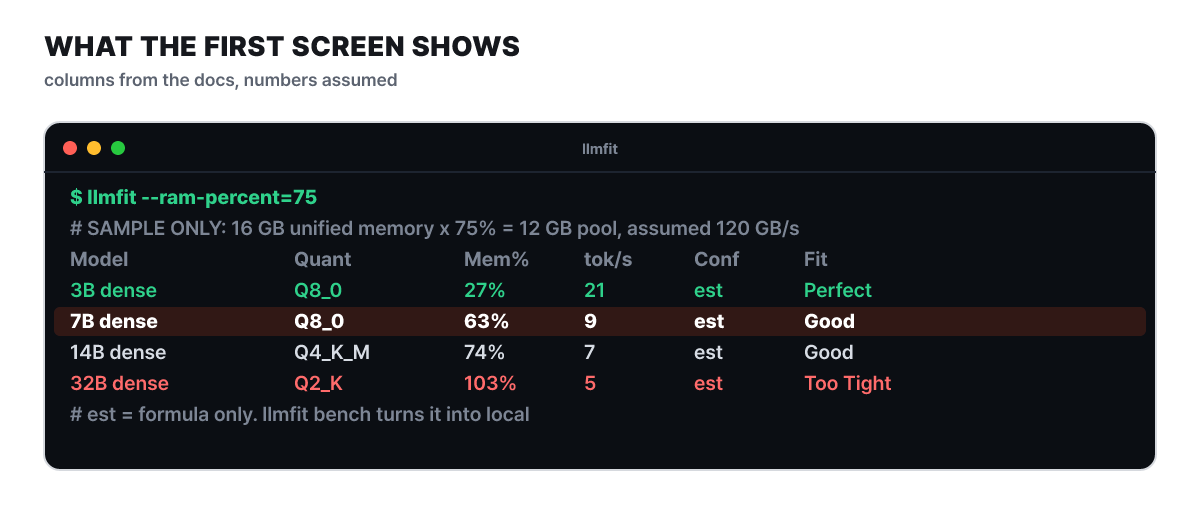 그림 1. 16GB 통합 메모리의 75%(12GB)를 풀로 둔 가정 화면(편집부 계산, 숫자는 모두 가정)
7B 줄은 Q8_0에서 63%를 채워 Good이고, 32B는 가장 작은 단계로 내려가도 103%라 Too Tight입니다. Conf 칸의 est는 속도가 공식만으로 계산된 값이라는 표시인데, 이 칸은 뒤에서 따로 다룹니다.
Score는 모델마다 매기는 0~100점 네 개의 합입니다.
| 항목 | 보는 것 |
|---|---|
| 품질 | 매개변수 수, 모델 계열의 평판, 양자화에 따른 감점, 용도와의 맞음 |
| 속도 | 백엔드·매개변수·양자화로 추정한 초당 토큰 |
| 적합도 | 메모리 이용 효율(가장 좋은 구간은 가용 메모리의 50~80%) |
| 문맥 | 용도에 필요한 문맥 길이를 감당하는지 |
네 점수는 용도(일반, 코딩, 추론, 채팅, 멀티모달, 임베딩)별 가중치로 합칩니다. 문서가 든 예로 채팅은 속도 가중치가 0.35이고, 추론은 품질 가중치가 0.55입니다. 코딩 용도에서는 공개 리더보드를 모은 계열별 벤치마크 표가 품질 점수에 반영되어, 매개변수가 작아도 코딩에 강한 모델이 큰 범용 모델보다 앞설 수 있습니다. 표에 없는 계열은 이름을 보고 추정합니다. 노트북에서 코딩 도우미를 찾는 장면이라면 U 키로 용도 필터를 코딩에 맞춰 두는 쪽이 순위를 읽기 쉽습니다.
쓸 수 있는 메모리를 75%로 줄여 다시 묻기
기본 계산은 노트북의 메모리를 전부 내 것으로 칩니다. 하지만 브라우저와 편집기를 켠 채로 모델을 돌릴 테니 운영체제와 앱이 쓸 몫을 빼고 물어봐야 현실에 가깝습니다. v1.1.17에 들어온 퍼센트 옵션이 그 용도입니다.
llmfit --ram-percent=75 recommend --json --use-case coding --limit 3문서에 따르면 --ram-percent는 통합 메모리 시스템에서 VRAM 상한도 같이 낮춥니다(--ram과는 함께 쓰지 못합니다). 16GB의 75%인 12GB가 새 풀이 되고, 적합도 판정은 “필요한 메모리 ÷ 쓸 수 있는 메모리” 한 숫자로 갈립니다. 60% 이하가 Perfect, 85% 이하가 Good, 98% 이하가 Marginal, 그 위는 Too Tight입니다. 12GB 풀이라면 Perfect는 7.2GB, Good은 10.2GB, Marginal은 약 11.8GB까지입니다. 경계가 비율이라서 풀이 클수록 같은 등급으로 받을 수 있는 모델도 함께 커집니다.
아래 그림은 풀 크기마다 세 등급이 필요 메모리 몇 GB까지 이어지는지 쌓은 것입니다. 막대 하나의 길이가 풀의 98%입니다.
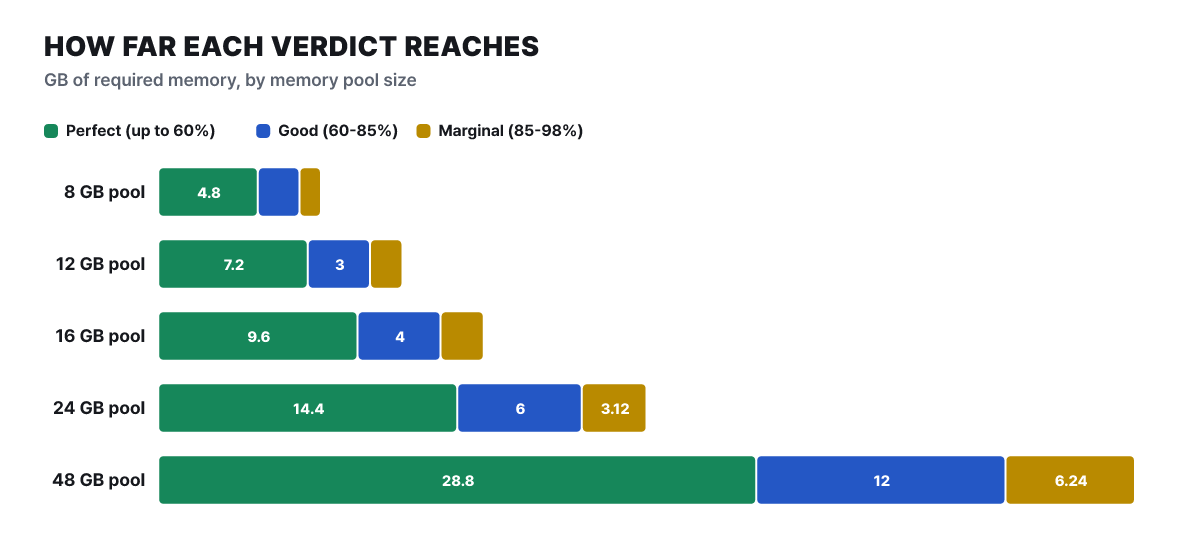 그림 2. 풀 크기별 판정 구간(편집부 계산, 경계 비율은 문서 기준)
12GB 풀의 Perfect는 7.2GB이므로 Q4 계열 14B(가정으로 약 9GB)는 노트북에서 Good에 머물고, Perfect를 받으려면 7B 이하로 내려가야 합니다. 같은 모델이 24GB 풀에서는 Perfect입니다.
98%에서 선을 긋는 데에는 이유가 있습니다. 메모리를 끝까지 채우면 할당 여유와 조각화 때문에 실제로는 올라오지 않기 때문입니다. 문서는 예전 방식의 결함도 적어 둡니다. 모델 크기의 두 배로 잡은 권장 RAM 값으로 판정하면 24GB 카드에 23GB 모델이 96%까지 차는데도 Perfect로 나왔고, 16GB 카드에서 56%만 쓰는 9GB 모델은 Good에 그쳤습니다. 지금은 채움 비율만으로 판정합니다.
실행 방식에 따라 받을 수 있는 최고 등급이 정해져 있다는 점도 표의 Mode 칸에서 읽습니다.
| Mode | 뜻 | 최고 등급 |
|---|---|---|
| GPU | 모델이 VRAM에 들어감 | 상한 없음(비율이 말하는 대로) |
| MoE 오프로딩 | 활성 전문가는 VRAM, 나머지는 RAM | Good |
| CPU+GPU | VRAM이 모자라 RAM으로 넘치고 일부만 GPU에서 계산 | Good |
| CPU | GPU 없이 RAM에서 돌림 | Good |
뒤의 세 방식은 “여유 있고 GPU에서 돈다”는 뜻의 Perfect를 받을 수 없어 Good이 상한입니다. 그렇다고 Marginal로 끌어내리지는 않습니다. RAM에 편하게 들어가는 모델은 실제로 돌릴 수 있기 때문입니다.
양자화도 고정하지 않습니다. 가장 품질이 좋은 Q8_0부터 시도해 내 메모리에 들어가는 첫 단계를 고르고, 전체 문맥으로 아무 단계도 안 들어가면 문맥을 절반으로 줄여 다시 시도합니다. 목록의 같은 모델이 내 컴퓨터와 친구 컴퓨터에서 다른 Quant로 보이는 이유입니다. 그림 1에서 32B가 Q2_K까지 내려간 것도 이 규칙의 결과입니다.
후보를 눌러 보며 가정 확인하기
순위가 나왔다면 위에서부터 읽지 말고 필터로 좁히는 편이 빠릅니다. TUI의 주요 키만 모으면 이렇습니다.
f로 적합도 필터를 돌립니다(전체, 실행 가능, Perfect, Good, Marginal). 일상용이라면 Perfect와 Good만 남깁니다/로 이름·제공자·매개변수·용도를 걸러 내고,s로 정렬 열(점수, 매개변수, 메모리 비율, 문맥, 날짜)을 바꿉니다- 관심 모델에서
Enter를 눌러 상세 화면을 엽니다. 어떤 가정 위에 있는 숫자인지 여기서 확인합니다 - 두 모델은
m으로 표시하고c로 나란히 비교합니다. 이미 받은 모델이 있다면i로 설치된 것을 앞에 둡니다 - 마음에 들면
d로 내려받습니다. 받을 수 있는 런타임이 둘 이상이면 고르는 창이 뜹니다. 단축키 전체는h
받기 전에 확인할 것을 점검 목록으로 모으면 다음과 같습니다.
- Mem%가 85% 아래인가(상세 화면에서 가정한 문맥 길이도 함께 확인)
- Quant가 Q4 아래로 내려가지 않았는가. 너무 내려가면 품질 점수에서 감점이 붙습니다
- tok/s 옆 Conf가 est라면 숫자를 어림값으로만 읽기
- 같은 용도의 다른 계열 모델과
m·c로 나란히 놓아 보았는가
전문가 혼합 모델은 같은 자로 재면 틀린다
목록에 Mixtral이나 DeepSeek 계열이 섞여 있다면 계산이 다르다는 점을 알아야 합니다. MoE(전문가 혼합) 모델은 토큰마다 전문가 블록 일부만 쓰므로, 전체 매개변수 수로 메모리를 잡으면 필요량을 과대평가합니다. llmfit은 이런 모델을 자동으로 알아봅니다. 문서의 예인 Mixtral 8x7B는 전체 매개변수가 46.7B인데 토큰당 활성은 약 12.9B이고, 전문가 오프로딩을 쓰면 VRAM 요구량이 23.9GB에서 약 6.6GB로 줄어드는 계산입니다. 전체를 GPU에 올린다고 가정하면 24GB 카드에서 99.6%를 채워 Too Tight인 모델이, 활성 전문가만 VRAM에 두고 나머지를 RAM에 두는 방식으로는 쓸 만한 후보로 바뀝니다. 다만 이 경우 Mode가 MoE 오프로딩이라 최고 등급이 Good입니다.
속도 쪽도 활성 매개변수를 기준으로 추정합니다. 구조 정보(은닉 크기, 층 수, 전문가 중간 크기, 어휘 크기)가 모두 있는 모델은 토큰마다 읽는 데이터를 “양자화에 따라 크기가 변하는 전문가 가중치”와 “변하지 않는 어텐션·라우터·임베딩 가중치”로 나눠 계산합니다. 정보가 모자라면 활성 매개변수에 구조별 보정 값을 곱합니다. 문서는 이 보정이 없던 시기에 전문가가 128개 이상인 최신 구조를 지나치게 느리게 잡아 gpt-oss-120b가 약 2.6배 낮게 나왔다고 적고, 그런 모델은 보정 항목을 따로 넣어 바로잡았다고 합니다. 구조가 새로운 모델일수록 속도 칸이 더 흔들릴 수 있다는 신호로 읽으면 됩니다.
tok/s 칸은 어떤 계산에서 나오나
토큰 생성은 메모리 대역폭이 병목이라는 전제로, 모델 크기만큼의 가중치를 토큰마다 한 번 읽는다고 보고 계산합니다. (GPU 메모리 대역폭 ÷ 모델 크기) × 효율 계수입니다. 효율 계수 기본값은 0.55이고 커널 오버헤드, KV 캐시 읽기, 메모리 컨트롤러 효과를 뭉뚱그린 값입니다. 문서에 따르면 이 방식은 llama.cpp 저장소에 올라온 애플 실리콘·NVIDIA T4 벤치마크와 대조해 검증했습니다. 공식에 넣는 대역폭은 GPU 이름으로 약 80개 항목의 표(NVIDIA·AMD·애플 실리콘)에서 찾고, 표에 없으면 백엔드별 상수로 넘어갑니다.
아래 그림은 이 공식에 대역폭 네 가지와 모델 파일 크기 네 가지를 넣어 본 것입니다. 점이 아래로 갈수록 느리고, 점선이 초당 10토큰입니다.
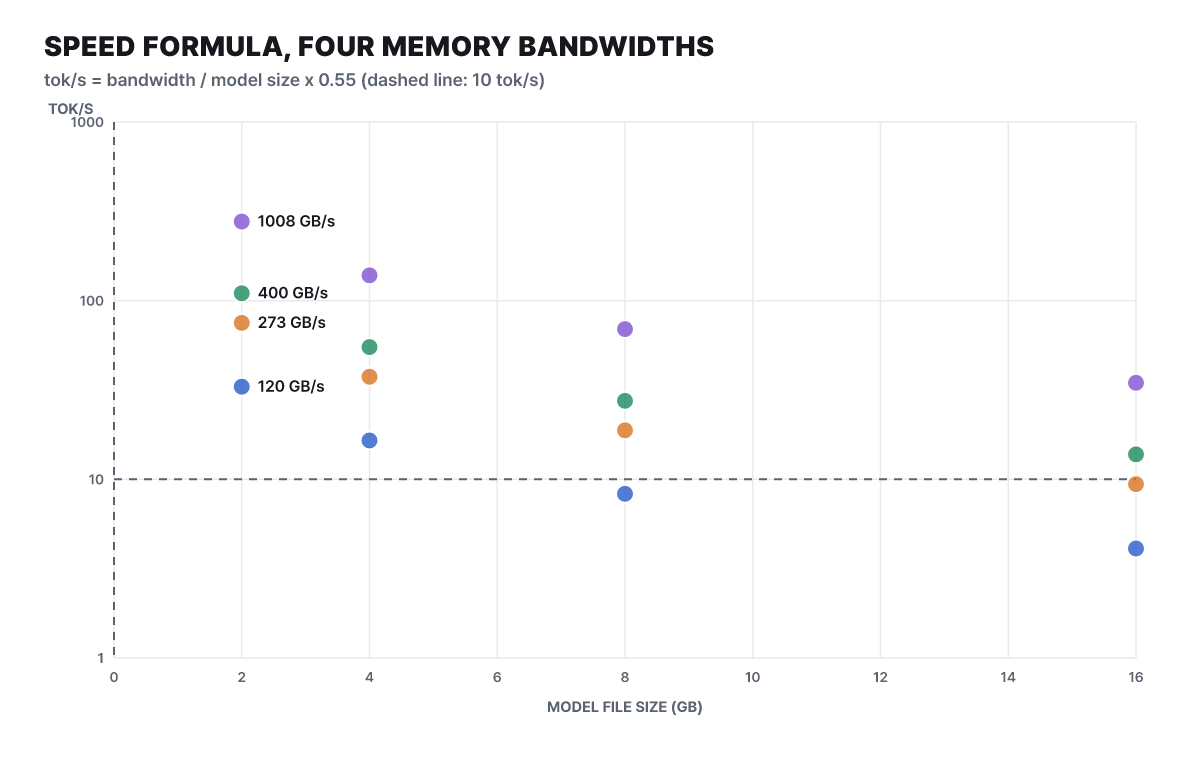 그림 3. 속도 공식 결과(편집부 계산, 대역폭 네 값은 가정, 효율 계수는 0.55)
같은 모델이 대역폭 120GB/s에서 4GB는 약 16토큰이지만 8GB는 약 8토큰, 16GB는 약 4토큰입니다. 모델 크기가 두 배가 되면 속도가 정확히 절반이 됩니다. 그림 1의 7B Q8_0(가정 7.5GB)이 120GB/s에서 9토큰 안팎으로 나온 것도 이 식에서 나온 값입니다. 반대로 1008GB/s 같은 높은 대역폭에서는 16GB 모델도 점선 위에 있습니다. 그래서 같은 순위의 모델이라도 노트북에서는 쓰기 불편하고 데스크톱 GPU에서는 편할 수 있고, 이것이 순위만 보지 말고 tok/s 칸을 같이 읽어야 하는 이유입니다.
표에 없는 GPU에는 백엔드 상수를 넣는 대체 공식 K ÷ 매개변수(B) × 양자화 배수를 씁니다. 상수는 CUDA 220, Metal 160, ROCm 180, SYCL 100, ARM CPU 90, x86 CPU 70, Ascend NPU 390입니다. 대역폭을 아는 카드라면 gpu_bandwidth_gbps_override로 직접 적어 넣을 수 있고, 어떤 값이 쓰였는지는 estimate_basis로 되돌려 확인합니다.
첫 토큰이 나오기까지의 시간(TTFT)과 프롬프트 처리 속도는 다른 계산입니다. 프롬프트를 읽는 단계는 대역폭이 아니라 연산량이 병목이라, GPU의 fp16 연산 성능을 알 때만 값을 내고 모르면 0이 아니라 비어 있는(null) 값으로 둡니다. 0으로 적으면 “측정할 수 없을 만큼 느리다”로 읽히기 때문입니다.
칸마다 붙은 Conf, 신뢰 사다리
llmfit은 속도 추정마다 신뢰 단계를 붙입니다. 문서가 “먼저 맞는 것이 채택된다”고 밝히는 우선순위는 다음과 같습니다.
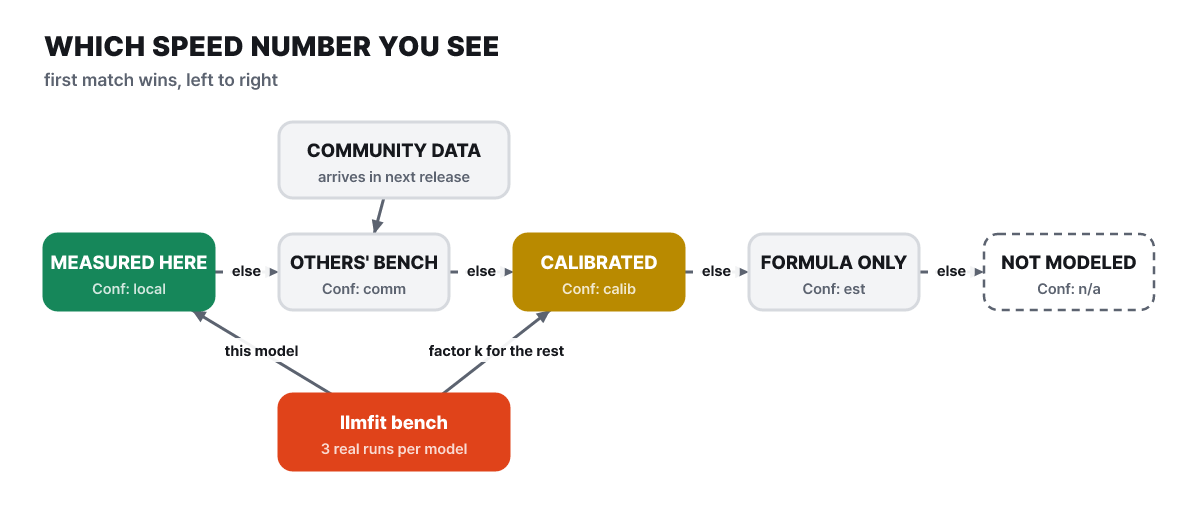 그림 4. 속도 칸의 숫자가 어느 단계에서 채택되는지
그림의 왼쪽일수록 믿을 만합니다. local은 내 컴퓨터에서 llmfit bench로 잰 값, comm은 같은 하드웨어의 다른 사용자가 잰 값, calib는 공식에 이 하드웨어의 측정에서 얻은 보정 계수를 곱한 값, est는 측정 없이 공식만 쓴 값입니다. n/a는 llmfit이 모델링하지 못하는 런타임이 필요해 추정 자체가 없는 경우입니다.
아래쪽의 화살표가 이 구조에서 가장 흥미로운 부분입니다. 문서에 따르면 1B 이상 밀집 모델의 측정값은 같은 하드웨어의 다른 모든 모델 추정을 보정하는 계수로 쓰이고, 상세 화면에 “Calibrated ×N” 형태로 표시됩니다. 다른 CPU·GPU 구성에서 잰 기록은 무시합니다. 한 모델만 재도 목록 전체의 est가 calib로 바뀌는 셈입니다. 같은 숫자가 여러 곳에 있을 때의 우선순위는 내가 직접 잰 값, 같은 하드웨어 커뮤니티 값, 공개 벤치 데이터베이스(localmaxxing)의 중앙값, 공식 추정 순입니다.
위쪽의 커뮤니티 값은 병합된 풀 리퀘스트가 다음 릴리스에 실려 오는 경로입니다. 저장소 기록을 보면 10월 26일 하루에만 Apple M5 Pro, GeForce RTX 5060 Ti, Radeon RX 7900 XT 같은 하드웨어의 커뮤니티 벤치 데이터가 여럿 병합되었습니다. 이 데이터는 v1.1.17 뒤의 변경이라 다음 릴리스에 들어갑니다. 내 하드웨어가 목록에 있다면 업그레이드 후 est가 comm으로 바뀌어 있을 수 있습니다.
직접 재서 est를 local로 바꾸기
속도 추정이 마음에 걸린다면 재 보면 됩니다. llmfit bench는 실행 중인 런타임(Ollama, vLLM, LM Studio, MLX, llama-server 등)에 실제 추론 요청을 세 번 보내 초당 토큰과 첫 토큰까지의 시간을 잽니다. 노트북 예라면 4단계에서 고른 모델을 받아 런타임으로 띄운 뒤 아래 순서로 진행합니다.
- TUI에서
d로 받은 모델을 런타임으로 띄우고r로 설치 목록을 새로 고칩니다. 설치된 모델은 Inst 칸에 표시됩니다 - 한 모델만 재려면
llmfit bench --provider ollama llama3.2처럼 공급자와 모델을 지정합니다. 찾아낸 모델 전부는--all, 역할별 품질 점수와 라우팅 표는--quality --routing입니다 - 결과는 먼저 내 컴퓨터(
~/.config/llmfit의 벤치 저장소)에 저장됩니다. 공유하지 않아도 사라지지 않고, 목록의 추정을 local 값으로 바꿔 줍니다 - 공유는 선택입니다.
llmfit bench --all --share를 쓰면 GitHub 저장소를 포크해llmfit-core/data/community/<하드웨어>/아래에 결과 파일을 올리고 풀 리퀘스트를 엽니다
공유 단계에는 GitHub 인증이 필요합니다. 문서에 따르면 gh 명령은 필요 없고, 브라우저에서 코드를 한 번 승인하는 장치 인증이나 GITHUB_TOKEN 환경 변수를 씁니다. 확인 창에서 동의하기 전에는 아무것도 올라가지 않고, --dry-run을 붙이면 네트워크를 쓰지 않고 올라갈 JSON만 미리 볼 수 있습니다. 병합된 결과는 다음 릴리스에 실려 같은 CPU·GPU 조합을 쓰는 사용자의 표에서 측정값(✓)으로 보입니다. 이 글에서는 CLI 기준으로 설명했고, TUI 안에서 쓰는 키는 h 도움말에서 확인할 수 있습니다.
사기 전에 물어보기: 프로필, plan, storage
노트북 예에서 한 걸음 더 나가면 “이 모델을 돌리려면 어떤 컴퓨터를 사야 하나”를 묻게 됩니다. llmfit은 내 컴퓨터가 아닌 컴퓨터를 가정해 같은 계산을 돌릴 수 있습니다. 용량만 바꾸는 방법은 --memory(VRAM), --ram, --cpu-cores, 앞서 본 퍼센트 옵션입니다. 대역폭까지 바꾸려면 하드웨어 프로필(--profile)을 씁니다. 문서가 소개하는 번들 프로필에는 nvidia-rtx-4090, apple-m3-max-128gb, ryzen-ai-max-plus-395가 있습니다.
llmfit hardware list                                    # 번들·사용자 프로필 목록
llmfit --profile nvidia-rtx-4090 recommend --json       # 이 카드를 가졌다면
llmfit --profile ryzen-ai-max-plus-395 plan "openai/gpt-oss-120b" --context 8192 --target-tps 25
프로필은 작은 JSON 파일입니다. 문서가 정한 필드는 schema_version(1), name(파일 이름과 같아야 함), match.gpu_name_contains, hardware.total_ram_gb, hardware.unified_memory, hardware.gpu_memory_bandwidth_gbps, hardware.ddr_bandwidth_gbps이고, hardware.gpu_compute_tflops_fp16은 선택입니다. 빼면 TTFT 쪽이 0이 아닌 null로 남습니다. 아래는 가정한 값으로 채운 예시입니다.
{
  "schema_version": 1,
  "name": "my-workstation",
  "hardware": {
    "total_ram_gb": 64,
    "unified_memory": false,
    "gpu_memory_bandwidth_gbps": 900,
    "ddr_bandwidth_gbps": 80
  }
}
저장한 뒤 llmfit hardware validate ./my-workstation.json으로 검사하면 키 오타를 걸러 줍니다. 문서가 보여 주는 실패 출력은 이렇습니다.
FAIL ./my-workstation.json: unknown key(s): hardware.gpu_bandwith_gbps대역폭을 적는 이유는 속도 추정이 그 값으로 계산되기 때문입니다. 용량만 바꾸는 --memory는 “어떤 모델이 들어가나”만 답하고 “얼마나 빠른가”는 호스트의 대역폭을 그대로 씁니다. --profile은 --memory·--ram·--cpu-cores와 함께 쓸 수 없고 --force-runtime과도 아직 같이 못 씁니다.
plan은 방향을 뒤집어 모델에서 출발합니다. llmfit plan "<모델>" --context N [--quant Q] [--target-tps N]으로 문맥 길이와 목표 속도를 주면 필요한 최소·권장 하드웨어와 GPU, CPU 오프로드, CPU 전용 경로별 가능 여부를 계산해 줍니다. 모델을 여러 개 받아 두고 갈아 쓰려면 SSD도 계산해야 합니다. llmfit storage의 기본값은 모델 3개, OS 여유 100GB, 임시 공간은 가장 큰 모델 하나분, 남길 여유 15%입니다. 문서의 식은 다음과 같습니다.
need_gb            = os_reserve_gb + library_gb + download_scratch_gb
target_capacity_gb = need_gb / (1 - headroom_percent / 100)
최소 SSD는 need_gb를, 권장 SSD는 target_capacity_gb를 구간 목록(십진 GB 기준 256, 512, 1000, 2000, 4000, 8000, 16000) 중 처음으로 넘는 값으로 올림한 것입니다. 모델 3개의 합이 60GB, 가장 큰 모델이 25GB라고 가정하면 필요 용량은 100 + 60 + 25 = 185GB, 권장 계산은 185 ÷ 0.85 ≈ 218GB여서 둘 다 256GB 구간입니다. 한계도 문서가 밝힙니다. 가중치만 계산하고(MoE는 모든 전문가 포함), 디스크 빈 공간을 스캔하지 않으며, 동시에 여러 모델을 돌리는 경우는 다루지 않고, 예약·여유 값은 측정값이 아니라 조절하는 계획 값입니다.
스크립트와 에이전트가 같은 계산을 부르는 길
화면을 거치지 않고 같은 판정을 받는 방법이 세 가지입니다. 첫째는 JSON 출력입니다.
llmfit recommend --json --use-case coding --limit 3   # 코딩용 상위 3개를 JSON으로
llmfit fit --perfect -n 5                              # Perfect 판정만 5개
llmfit info "Mistral-7B"                               # 한 모델의 적합도 분석과 추정 근거
둘째는 REST입니다. llmfit serve로 열고, 노드 하나가 지금 돌릴 수 있는 상위 모델을 묻는 /api/v1/models/top이 핵심 엔드포인트입니다. 이 밖에 /api/v1/system, 동시 세션 수용량을 묻는 /api/v1/concurrency, SSD 계산인 /api/v1/storage가 있고, 같은 컴퓨터만 쓸 때는 네트워크 포트 대신 유닉스 소켓(--unix-socket)으로도 열 수 있습니다. 동시 세션은 v1.1.16부터 llmfit concurrency <모델> --json으로도 계산됩니다. 4천에서 25만 6천 토큰 사이 문맥별로 세션이 몇 개 올라가는지와 KV 캐시 정밀도(fp16, fp8, q8_0, q4_0)별 차이를 보여 줍니다. 문서가 밝히듯 이것은 메모리에 몇 개가 올라가는지의 천장이지 부하를 받을 때의 처리량이 아닙니다.
셋째는 MCP입니다. llmfit serve --mcp가 표준 입출력으로 도구 여섯 개를 내놓습니다.
| MCP 도구 | 하는 일 |
|---|---|
get_system_specs |
RAM·GPU·CPU 정보 |
recommend_models |
용도·최소 적합도·런타임·라이선스로 걸러 상위 모델 |
search_models |
이름·제공자 텍스트 검색 |
plan_hardware |
모델·문맥·양자화·목표 속도에 필요한 하드웨어 |
get_runtimes |
설치된 추론 런타임 |
get_installed_models |
로컬 런타임에 있는 모델 |
저장소에는 OpenClaw 에이전트용 스킬(skills/llmfit-advisor)도 들어 있습니다. 설치하면 에이전트가 llmfit --json system으로 사양을 읽고 llmfit recommend --json으로 순위를 받은 뒤, Hugging Face 모델 이름을 Ollama·vLLM·LM Studio 태그에 대응시키고 openclaw.json의 Ollama 모델 목록을 맞춰 줄지 사용자에게 묻습니다.
런타임 연동은 감지된 쪽에서 자동으로 켜집니다. Ollama는 localhost:11434에 데몬이 떠 있으면 설치된 모델 목록(/api/tags)을 읽어 표의 Inst 칸에 체크 표시를 붙이고, d를 누르면 해당 모델을 내려받습니다. 다른 컴퓨터의 Ollama는 OLLAMA_HOST로 가리킵니다. 노트북에서 llmfit을 돌리고 GPU 서버의 Ollama를 읽는 구성도 가능합니다. llama.cpp는 PATH에서 실행 파일을 찾고(LLAMA_CPP_PATH로 위치 지정) GGUF 파일을 직접 받으며, Docker Model Runner는 localhost:12434, LM Studio는 127.0.0.1:1234를 기본으로 봅니다.
막히는 곳, 그리고 llm-checker와의 순서
따라 하다 막히는 곳은 대개 다음 다섯 가지입니다.
- 감지가 안 되는 환경: 문서에 따르면 Windows는 RAM·CPU와
nvidia-smi가 있는 NVIDIA GPU 기준으로 감지하고, 안드로이드(Termux 등)에서는 GPU를 감지하지 못합니다. 그럴 때는--memory=8G처럼 직접 적어 넣어 추천만 받을 수 있습니다 - 카탈로그가 내장되어 있음: 모델 목록이 바이너리에 들어 있어 새 모델은 업그레이드하면 들어옵니다. 기다리기 싫다면
llmfit update로 Hugging Face의 인기 모델을 받거나, 사용자 정의 모델 파일custom_models.json에 이름, 제공자, 매개변수 수, 최소·권장 메모리, 양자화, 문맥 길이, 용도를 직접 적습니다. 같은 이름이면 내 항목이 우선입니다 - 품질 점수는 단순화: 계열 평판과 공개 리더보드를 모은 표에 기대므로 내 작업에서의 성능을 보장하지 않습니다
- 속도는 공식 값: Conf가 est인 동안의 tok/s는 문맥 길이와 런타임에 따라 실제와 차이가 납니다
- Windows 설치 파일의 서명은 릴리스마다 다름: README에 따르면 서명 작업이 끝까지 성공한 릴리스만 서명되므로 필요하면 서명을 확인하세요
이 도구는 빠르게 움직입니다. v1.1.15(9월 10일)에서 v1.1.17(10월 8일)까지 한 달 사이에 동시 세션 추정, 디스크 계획, 1.58비트 모델 인식, 퍼센트 옵션, 마우스 지원, 순위 고정이 들어왔고, 릴리스 뒤인 10월 25~26일에도 여러 단어 검색 수정, F32 모델 점수 수정, 서브커맨드 뒤에 사이징 플래그를 허용하는 변경이 main에 올라갔습니다. 이 변경들은 아직 릴리스에 포함되지 않았습니다. 윈도우용 데스크톱 GUI인 llmfit-gui라는 자매 프로젝트도 README에 소개되어 있습니다.
README가 소개하는 대안은 llm-checker입니다. Node.js 도구로 Ollama를 통해 실제로 모델을 받아 돌려 본다는 점이 다르며, 문서는 이 도구가 MoE 구조를 구분하지 않고 모두 밀집(dense) 모델로 본다고 적었습니다. 두 도구는 경쟁이라기보다 순서가 다릅니다. 받기 전에 후보를 좁히려면 llmfit이, 이미 좁힌 뒤 직접 돌려 보며 확인하려면 llm-checker가 맞습니다. llmfit의 bench가 그 “돌려 본다”에 해당하는 단계를 맡기도 합니다.
노트북 앞의 장면으로 돌아가면, 이 도구가 주는 순위는 정답이 아니라 그날의 카탈로그와 공식이 내놓은 가설에 가깝습니다. 같은 노트북이 업그레이드 한 번에 다른 순위와 다른 Conf 칸을 보일 수 있다는 점이 오히려 쓸모를 말해 줍니다. 가설에는 반증 방법이 붙어 있고, 반증은 명령 하나(llmfit bench)이며, 한 번의 반증이 목록 전체의 숫자를 고칩니다. 순위표를 처음 열 때보다 bench를 한 번 돌린 뒤에 훨씬 믿을 만한 표를 갖게 되는 구조입니다.



