에이전트에게 스펙부터 배포까지 순서를 지키게 하는 스킬 25개, 별 11만 개
Addy Osmani의 agent-skills는 스킬 25개를 깔아도 켜지는 것은 설명 한 줄에 달렸다고 보고, 문장 하나로 호출을 27회 중 7회에서 21회로 올린 실측까지 저장소 안에 둡니다.
스킬 25개를 설치한 것과 에이전트가 그 스킬을 불러서 쓴 것은 서로 다른 일이고, addyosmani/agent-skills는 그 간격을 저장소 안에서 숫자로 재는 드문 스킬 모음입니다. README는 이 저장소를 “AI 코딩 에이전트를 위한 프로덕션급 엔지니어링 스킬”이라고 소개합니다. AI 코딩 에이전트가 가장 짧은 길로 가려다 스펙, 테스트, 보안 검토를 빼먹는 일을 시니어 엔지니어의 워크플로와 품질 관문으로 막겠다는 것입니다. 만든 사람은 Addy Osmani이고, 10월 27일에 확인한 값은 별 110,737개, 포크 11,571개, 열린 이슈 61건과 PR 116건, 라이선스 MIT입니다. 2월 15일에 만들어져 릴리스 15개를 냈고, 8월 28일 0.6.8을 낼 때 별 9만 개를 넘었다고 밝힌 뒤 두 달 만에 11만 개가 됐습니다. 가장 최근 릴리스는 10월 13일의 0.6.13이며 그 뒤로 새 릴리스와 커밋은 없습니다. 구성은 스킬 25개(생애주기 24개에 어떤 스킬을 쓸지 안내하는 메타 스킬 1개), 슬래시 명령 9개, 전문가 페르소나 4개, 참조 체크리스트 7개입니다.
이 글은 질문 하나를 따라갑니다. 스킬을 깔면 에이전트가 정말 스펙에서 배포까지 순서를 지키는가. 먼저 스킬이 켜지는가를 저장소의 실측으로 보고, 켜진 뒤 절차가 지켜지는가를 명령 하나씩 따라가며 확인한 다음, 그래서 어떻게 들여야 하는지로 끝납니다.
설치한 스킬이 에이전트 눈에 보이는 두 줄
스킬은 SKILL.md 파일 하나이고, 에이전트가 시작할 때 컨텍스트에 올라가는 것은 그중 name과 description 두 줄뿐입니다. 본문은 에이전트가 켜기로 결정했을 때 비로소 읽습니다. 저장소의 docs/skill-anatomy.md는 이 구조에 맞춰 규칙을 둡니다. 본문은 500줄 아래로 유지하고 상세 자료는 별도 파일로 빼며, description은 1,024자 이내로 “무엇을 하는지”와 “언제 쓰는지”만 적습니다. 절차 요약을 설명에 넣지 말라는 규칙도 있습니다. 에이전트가 본문을 읽지 않고 요약대로만 움직일 수 있기 때문입니다.
호스트 쪽 사정도 같은 방향입니다. Claude Code 문서에 따르면 스킬 목록에 올라간 설명은 쓰든 안 쓰든 매 턴 컨텍스트를 차지하고, description과 when_to_use를 합친 글은 1,536자에서 잘립니다. 대화가 압축될 때는 호출된 스킬마다 앞 5,000토큰을 다시 붙이고 전체 합계 예산은 25,000토큰입니다. 스킬별 컨텍스트 비용과 쓴 횟수는 /skill-doctor(Claude Code v2.1.252 이상)가 보여 줍니다. 스킬을 부를지 말지는 결국 이 두 줄을 보고 정해진다는 뜻입니다.
쉽게 말하면
서랍 25개가 달린 장이 있고, 직원은 서랍 앞면의 라벨만 읽고 열지 말지 정합니다. 라벨이 “코드 리뷰 매뉴얼”이면 직원은 “리뷰는 내가 아는 일”이라며 열지 않고 알아서 처리합니다. 라벨에 “남이 붙여 넣은 diff를 볼 때도 여기를 연다”가 적히면 그때부터 서랍이 열립니다. 서랍 안의 매뉴얼이 아무리 좋아도 라벨이 직원의 “내가 알아서 하면 되는데”를 못 이기면 한 번도 열리지 않습니다.
같은 이유로 저장소는 9월 18일 0.6.10에서 기본 동작을 하나 바꿨습니다. 세션이 시작될 때 메타 스킬 using-agent-skills를 강제로 주입하던 훅을 플러그인에서 뺐습니다. Claude Code와 Codex는 이미 설명을 보고 스킬을 고르는데, 그 위에 라우터를 하나 더 얹는 꼴이었고 세션마다 약 3.5k 토큰이 들었다는 이유입니다. 그 훅 스크립트는 스킬 라우팅이 없는 호스트용으로만 남아 있습니다.
호출 횟수를 재는 장치가 생긴 순서
스킬은 마크다운이라 “썼다”와 “에이전트가 불렀다”가 별개의 문제입니다. 저장소가 이 간격을 어떻게 좁혀 왔는지는 릴리스 날짜(UTC)를 늘어놓으면 보입니다. 가운데 선 위아래의 점이 릴리스이고, 마지막 빨간 점이 이 글의 중심 사건입니다.
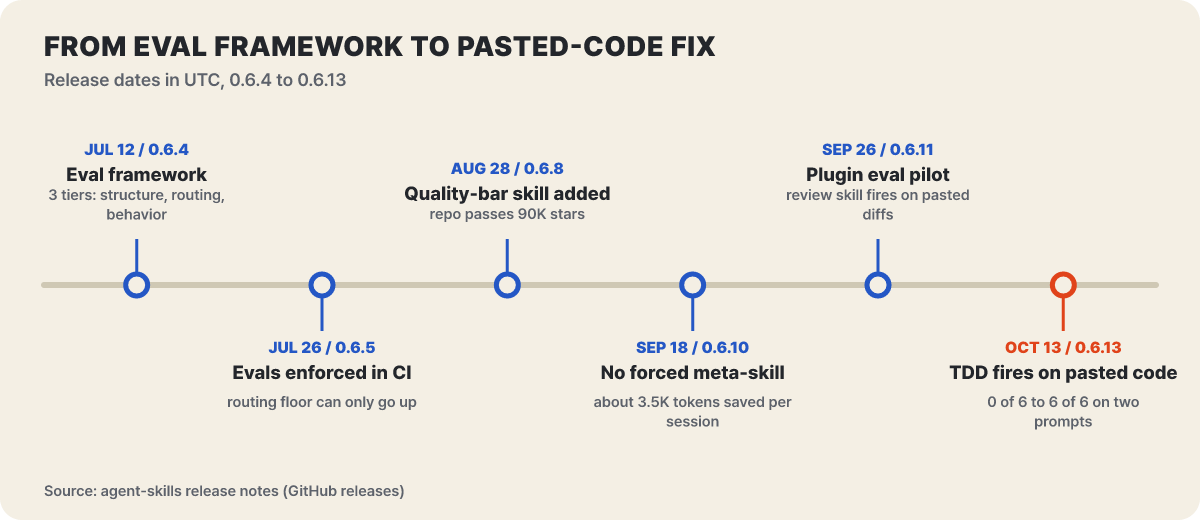 그림 1. 평가 틀이 생기고, CI에서 강제되고, 호출 실측이 스킬 설명 수정으로 이어진 경과
0.6.4(7월 12일)에서 들어온 평가 틀은 세 단계입니다. 1단계는 머리말, 이름, 필수 절, 링크 같은 구조 검사로 CI에서 공짜로 돕니다. 2단계는 설명이 사용자가 쓰는 낱말을 담고 있는지, 두 스킬의 설명이 서로 겹치지 않는지를 어휘(단어 빈도) 기반으로 근사해서 보며 역시 CI에서 돕니다. 의미를 판단하지 못하므로 3단계가 필요하고, 3단계는 실제 에이전트를 돌려 스킬을 따랐는지 채점하기 때문에 토큰이 듭니다. 0.6.5(7월 26일)부터 2단계는 CI의 문턱을 올릴 수만 있게 강제됐고, 지금 문턱은 1순위 적중률 95입니다.
여기에 0.6.11(9월 26일)에서 claude plugin eval 시범이 붙었습니다. Claude Code 2.1.269 이상에서 플러그인 전체를 한꺼번에 올리고, 사례마다 플러그인을 장착한 경우와 하지 않은 경우를 모두 돌려 점수 차(Δ)를 냅니다. 스킬 하나의 설명이 아니라 Claude Code의 라우터가 자연스러운 요청에서 그 스킬을 고르는지를 재는 것입니다.
claude plugin eval . --no-publish                                          # 모든 사례, 두 조건, 각 3회
claude plugin eval . --case code-review-fires --runs 1 --ablation none     # 사례 하나만 싸게 돌려 보기
모든 실행이 실제 모델 호출이라 CI에서는 돌리지 않고 필요할 때만 돌립니다. 이 장치가 처음 내놓은 결과가 바로 다음 절의 리뷰 스킬입니다.
문장 하나로 7회가 21회가 된 리뷰 스킬
첫 시범은 Claude Code 2.1.278, claude-opus-5로 돌렸고, 리뷰 스킬은 사례가 쓰는 문구에서 7번 중 5번 켜졌습니다. 문제는 “합치기 전에 이 diff 리뷰해 줘”, “이 변경을 제대로 코드 리뷰해 줘”, “main에 들어가기 전에 이 풀 리퀘스트를 봐 줘”처럼 평범하게 말했을 때였습니다. 원래 설명으로는 이런 문구에서 스킬이 거의 켜지지 않았습니다. 모델이 스킬 없이 직접 리뷰했고, 솜씨는 좋았지만 판정과 심각도 단계, 다섯 축 점검이 빠져 있었습니다. 에이전트는 diff가 대화창에 붙어 있으면 “이건 내가 바로 할 수 있다”고 보고 스킬을 건너뛴 것입니다.
고치는 길에서 두 가지가 통하지 않았습니다. 스킬이 더해 주는 것을 설명에 적어 보았고, diff와 풀 리퀘스트라는 낱말만 따로 적어 보았지만 효과가 없었습니다. 통한 것은 모델이 “혼자 하면 된다”고 취급하던 바로 그 경우를 짚은 한 절이었습니다.
description: Conducts multi-axis code review. Use before merging any change. Use when reviewing code written by yourself, another agent, or a human. Use when you need to assess code quality across multiple dimensions before it enters the main branch. Use when asked to review a diff or a pull request, even when the diff is pasted inline.마지막 문장이 추가분입니다. 모델을 claude-opus-5-5로 고정하고 쟀더니 이 한 절이 리뷰 요청 문구들의 호출을 27회 중 7회에서 21회로 늘렸습니다. 켜지면 안 되는 인접 요청 아홉 가지는 27회 중 0회로 전과 같았습니다. 가장 평범한 문구는 9회 중 0회에서 3회가 됐으니, README의 표현대로 나아졌을 뿐 해결된 것은 아닙니다. 붙여 넣은 diff에 커밋 메시지만 요청하는 경우에 리뷰 스킬이 켜지면 안 되므로, 그 문장을 지키는 사례(code-review-stays-quiet-on-commit-message)가 따로 있습니다.
측정에서 나온 실무 규칙도 두 개 있습니다. 숫자를 보고할 때는 --model을 고정하고 Claude Code 버전을 적어야 합니다. CLI가 스스로 업데이트되고, 같은 날 아침과 저녁 사이에 기본 모델이 두 번 바뀌었기 때문입니다. 그리고 사례에는 턴 한도를 10 이상으로 줘야 합니다. 모델이 슬래시 명령(agent-skills:review)을 거쳐 code-review-and-quality에 이르는 경로를 타면 두 턴이 들기 때문입니다.
같은 처방이 TDD에서는 세 요청을 0에서 6으로 올렸다
같은 방법을 test-driven-development에 적용한 결과입니다. 아래 그림은 설명 문장 하나를 더하기 전후로 스킬이 켜진 실행의 비율이고, 같은 모델을 고정했으며 막대 쌍이 많이 갈라진 곳일수록 한 문장의 효과가 큰 곳입니다.
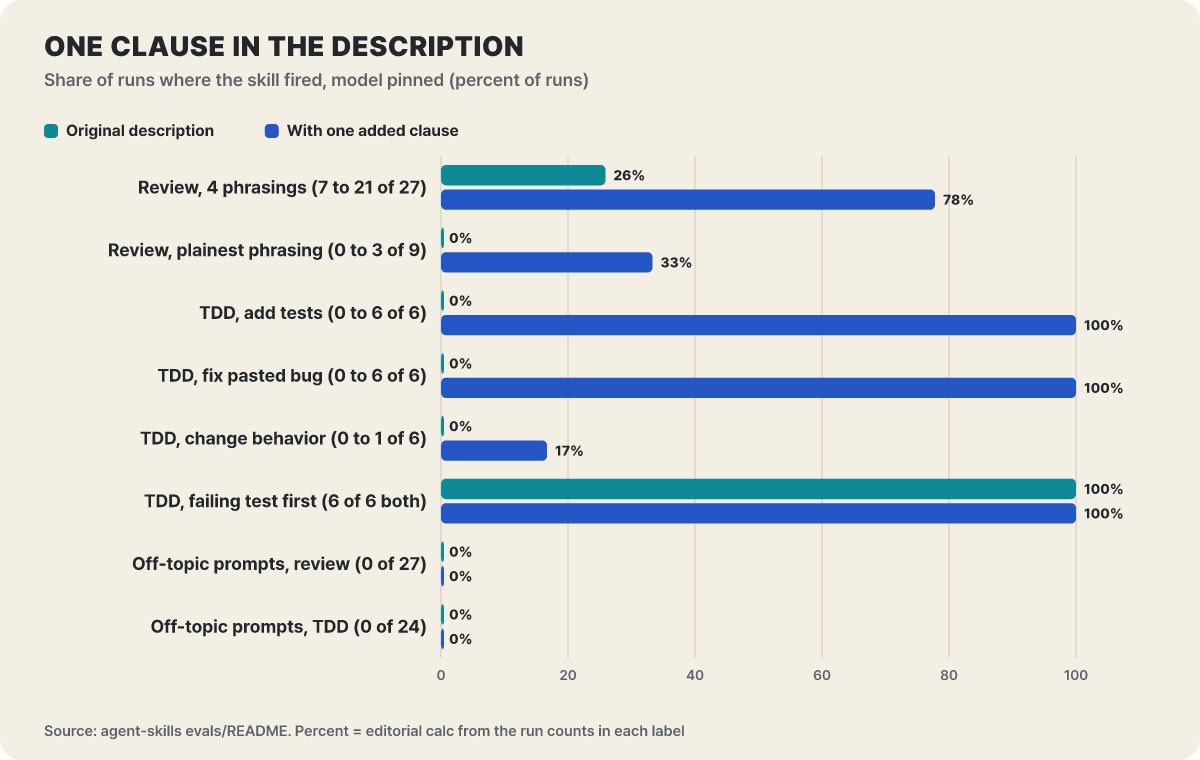 그림 2. 한 문장이 바꾼 호출 비율. 비율은 레이블의 실행 횟수에서 편집부가 계산했다
TDD 쪽은 프롬프트 네 개를 프롬프트당 6회씩 돌렸습니다. 원래 설명에서는 “이 함수에 단위 테스트를 추가해 줘”, “이 함수의 버그를 고쳐 줘”, “이 함수를 바꿔서 크기가 100을 넘지 않게 해 줘”가 각각 6회 중 0회였습니다. “고치기 전에 실패하는 테스트부터 써 줘”처럼 과정을 말하는 요청만 6회 모두 켜졌습니다. 앞 절의 꼬리 문장만으로는 부족했고, 세 요청을 이름으로 부른 뒤 “코드가 대화창에 붙어 있고 요청이 테스트를 말하지 않아도 적용된다”고 덧붙이자 네 프롬프트 합계가 24회 중 6회에서 19회가 됐습니다. 테스트 추가와 버그 수정은 6회 중 6회가 됐고 인접한 요청 여덟 가지는 어떤 변형에서도 0회였습니다.
그림에서 17%에 그친 막대도 눈에 들어옵니다. 한 줄 동작 변경은 6회 중 1회만 켜졌습니다. 트레이스를 보면 모델은 도구 호출 없이 한 번의 편집으로 끝냈고, 그런 작은 일에는 절차를 떠올리지도 않았습니다. 작은 일에 절차를 들이밀지 않는 것은 저장소의 의도와도 어긋나지 않습니다. interview-me는 변수 이름 바꾸기나 오타 수정처럼 뜻이 분명한 요청에는 쓰지 말라고 적고, doubt-driven-development도 결과가 자명한 한 줄 변경을 대상에서 뺍니다. 이 설명 수정은 10월 13일 0.6.13에 들어갔고, 릴리스 노트는 두 프롬프트의 0회에서 6회로의 변화를 “한 절 추가”의 결과로 적습니다.
켜진다고 지켜지는 것은 아닙니다. 붙여 넣은 버그를 다루는 사례(tdd-fires-on-pasted-bug)에서 스킬은 모든 실행에서 켜졌지만, 고치기 전에 실패하는 테스트로 버그를 재현한 비율은 플러그인을 장착했을 때 4회 중 2회, 장착하지 않았을 때 3회 중 0회였습니다. 심사가 일부러 엄격하다고 README가 밝힙니다. 먼저 고치고 나서 “이 테스트는 옛 코드에서 실패했을 것”이라고 덧붙인 경우는 불합격입니다. 이 간격은 셸이 없어 아무것도 실행할 수 없는 세션에서 생긴 준수의 문제이고 호출의 문제가 아니라고 문서는 구분합니다. 켜지는 문제와 지켜지는 문제는 따로 풀어야 한다는 뜻이고, 다음 절부터가 두 번째 문제입니다.
켜진 스킬은 에이전트의 변명을 미리 적어 둔다
모든 스킬은 같은 해부도를 따릅니다. 머리말(name, description) 아래에 개요와 사용 시점(켜야 할 조건과 켜지 말아야 할 조건), 번호 붙은 절차, 변명과 반박표(Common Rationalizations), 위험 신호(Red Flags), 검증(Verification)이 이어집니다. 절차는 “테스트가 되는지 확인”이 아니라 실행할 명령까지 적고, 검증은 끝났다고 말하기 전에 확인할 항목마다 증거를 요구합니다. 이 중 가장 독특한 칸이 변명과 반박표입니다. 에이전트가 단계를 건너뛸 때 대는 말을 미리 적어 두고 그 말이 왜 틀렸는지를 옆에 붙입니다. TDD 스킬의 표에서 옮기면 이렇습니다.
| 에이전트가 대는 변명 | 스킬이 적어 둔 반박 |
|---|---|
| 코드가 돌아가면 테스트를 쓰겠다 | 쓰지 않는다. 나중에 쓴 테스트는 동작이 아니라 구현을 검사한다 |
| 직접 해 봤다 | 수동 확인은 남지 않는다. 내일의 수정이 깨뜨려도 알 길이 없다 |
| 프로토타입이니까 | 프로토타입은 운영 코드가 된다 |
| 안심하려고 테스트를 한 번 더 돌린다 | 코드가 바뀌지 않았다면 같은 명령을 다시 돌려도 얻는 것이 없다 |
위험 신호는 관찰할 수 있는 징후로 적혀 있습니다. 처음 실행에서 바로 통과하는 테스트, 실제로 돌리지 않았는데 전부 통과했다는 보고, 스위트를 통과시키려고 테스트를 건너뛰는 것이 그 예입니다. 첫 테스트를 쓰기 전에 이 저장소가 어떻게 테스트하는지부터 찾으라는 규칙도 있습니다. npm test를 가정하지 말고 package.json, pom.xml, pyproject.toml, CI 설정에서 실제 명령을 확인하라는 것입니다. 스킬을 쓰는 사람을 위한 규칙도 0.6.10에서 문서로 남았습니다. 특정 모델이 틀리는 곳을 우회하는 요령이 아니라 절차 자체를 쓰라는 것입니다.
명령은 입구이고 검토자는 /ship에서만 뜬다
스킬 위에는 두 층이 더 있습니다. docs/agents.md는 명령을 “언제”, 페르소나를 “누가”, 스킬을 “어떻게”로 나눕니다. 명령은 사용자가 치는 입구이고, 페르소나는 한 가지 관점과 출력 형식을 가진 역할이며, 스킬은 단계와 종료 조건이 있는 절차입니다. 아래 그림은 아홉 명령 중 여덟을 여섯 단계에 놓고, 어느 명령이 별도 컨텍스트의 서브에이전트에 닿는지를 선으로 이었습니다. 위쪽 영역에서 끝나는 명령과 아래쪽 영역까지 내려가는 명령이 갈립니다.
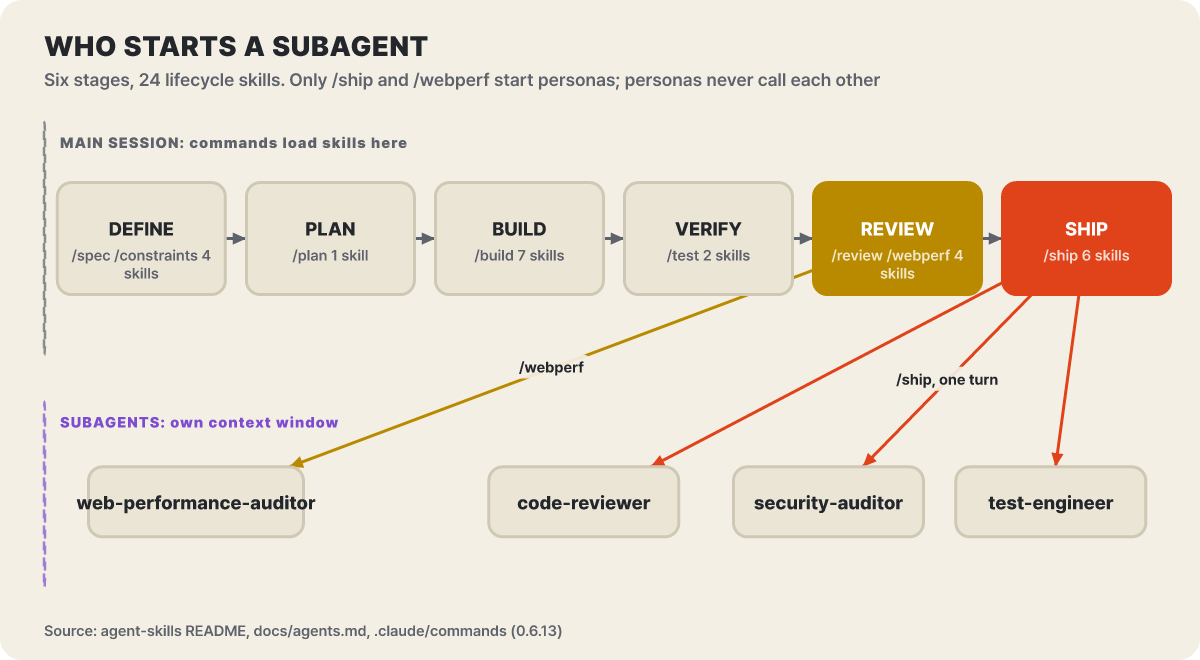 그림 3. 여섯 단계의 24개 생애주기 스킬과 서브에이전트에 닿는 두 명령. 보조 명령
/code-simplify는 생략했다
선 두 가지가 눈에 띕니다. 하나는 /review와 /test가 페르소나를 감싼 명령이 아니라는 점입니다. 두 명령은 code-review-and-quality와 test-driven-development를 메인 세션에서 돌립니다. 0.6.13 이전 문서는 이를 다르게 적었다가 10월 13일에 고쳤고, 새 컨텍스트의 code-reviewer나 test-engineer가 필요하면 페르소나를 직접 부르거나 /ship을 쓰라고 안내합니다. 다른 하나는 /webperf입니다. 이 명령은 웹 앱 전용이고, Lighthouse나 PageSpeed Insights의 JSON, CrUX 응답, DevTools 성능 트레이스, 또는 Chrome DevTools MCP가 붙은 실제 주소가 있으면 심층 모드로, 없으면 소스에서 구조적 문제만 찾는 빠른 모드로 돕니다. 빠른 모드의 발견은 모두 “잠재적 영향”으로 표시됩니다.
페르소나가 다른 페르소나를 부르지 못한다는 규칙은 구조도의 부제에 담았습니다. 조율은 명령이나 사용자의 몫이고, Claude Code에서는 서브에이전트가 서브에이전트를 띄울 수 없다는 플랫폼 제약이 같은 규칙을 강제합니다. Claude Code에서 명령은 플러그인 명령이라 내장 명령과 이름이 같은 /review는 /agent-skills:review로 불러야 합니다.
모호한 요청은 인터뷰와 스펙에서 두 번 멈춘다
정의 단계의 첫 스킬 interview-me는 “대시보드 만들어 줘” 같은 요청을 받으면 곧바로 만들지 않습니다. 현재 짐작을 한 문장과 확신 수치로 적고, 질문을 한 번에 하나씩 하되 매번 자기 추측을 붙이고, 사용자가 “해야 할 것 같은 답”을 하는지 살피고, 의도를 사용자의 말로 다시 적은 뒤 분명한 “예”를 받으면 멈춥니다. 스킬이 든 예를 줄이면 이렇게 흘러갑니다.
사용자: 우리 지표 대시보드 만들어 줘.
에이전트: 가설은 스탠드업에서 “우리 지금 어때?“에 답할 방법이 필요하다는 것입니다. 확신은 약 30%입니다. 누가 쓰는지, 어떤 지표인지, 성공이 무엇인지가 빠져 있습니다. “우리 어때?“라고 묻는 사람이 누구인가요? 스탠드업의 팀일 것 같습니다.
사용자: 사실은 저 혼자 쓸 거예요. 돌아가는 실험이 뭔지 자꾸 놓쳐서요. 목록 자체가 없고 여러 문서에 흩어져 있어요.
(두 질문 만에 필요한 것이 대시보드가 아니라 실험 목록이라는 점이 드러납니다.)
추측을 붙여 묻는 것이 핵심입니다. 빈칸을 채우게 하는 것보다 틀린 추측을 고치게 하는 쪽이 사용자가 더 빨리 반응한다는 것이 스킬의 설명입니다. 끝내는 판정도 기분이 아니라 시험입니다. “다음에 던질 질문 세 개에 대한 사용자의 반응을 내가 예측할 수 있는가”가 예이면 인터뷰를 멈춥니다. 의도를 다시 적을 때는 “범위 밖” 줄을 반드시 넣고, “알아서 해 주세요” 같은 대답은 예로 치지 않으며, 응답할 사람이 없는 CI나 예약 실행에서는 쓰지 말라고 스스로 적어 둡니다.
의도가 확정되면 spec-driven-development가 문서로 만듭니다. 스펙은 목표, 실행 명령, 프로젝트 구조, 코드 스타일(설명 세 문단보다 실제 코드 조각 하나), 테스트 전략, 경계의 여섯 영역을 다루고, 경계는 세 칸으로 나뉩니다. “항상 한다”에는 커밋 전 테스트 실행 같은 것이, “먼저 묻는다”에는 DB 스키마 변경과 의존성 추가가, “절대 하지 않는다”에는 비밀 값 커밋과 승인 없는 테스트 삭제가 들어갑니다. 막연한 지시는 성공 기준으로 바꿉니다. “대시보드를 빠르게”는 4G 환경에서 LCP 2.5초 미만, 초기 데이터 로딩 500ms 미만, 레이아웃 이동 CLS 0.1 미만이라는 조건이 되고, 에이전트는 이 조건을 향해 시도와 수정을 반복할 수 있습니다.
두 스킬 모두 끝에서 멈춰야 한다는 점이 이 절의 요점입니다. 10월 3일 0.6.12는 spec-driven-development가 스펙을 저장한 뒤 턴을 끝내고 승인을 기다리게 고쳤습니다. 스킬만 불러오는 호스트에서 일부 모델이 스펙, 계획, 작업 분해, 구현을 한 턴에 해치웠는데, “진행 전에 확인” 단계가 /spec 명령에만 적혀 있었기 때문입니다. 0.6.11에서는 interview-me에 같은 수정이 들어갔습니다. 규칙을 명령에만 적으면 명령이 없는 호스트에서는 사라진다는 교훈을 저장소가 두 번 치렀다는 뜻입니다.
/build auto가 사람을 빼는 곳과 남기는 곳
/build는 계획에서 다음 작업 하나를 구현하고 멈춥니다. 수용 기준을 읽고, 실패하는 테스트를 쓰고(RED), 통과할 최소한의 코드를 쓰고(GREEN), 전체 테스트와 빌드를 돌린 뒤 커밋하는 순서입니다. /build auto는 계획을 만들어 한 번 승인받은 뒤 모든 작업을 멈추지 않고 구현합니다. 시작 조건이 까다롭습니다.
- 루트의
SPEC.md,docs/SPEC.md,spec/아래에 스펙이 있어야 하며 README나 임의의 문서는 스펙으로 치지 않습니다. 없으면/spec부터 하라고 멈춥니다 git status에 계획 산출물 밖의 미커밋 변경이 있으면 커밋이나 보관을 먼저 확인합니다. 작업마다 커밋이 쌓이므로 남의 변경이 섞이면 깨끗한 되돌리기가 깨지기 때문입니다- 계획을 보여 주고 “승인”, “go”, “yes” 같은 분명한 긍정을 기다립니다. “괜찮아 보이네요”는 승인이 아닙니다
- 이후 작업마다 RED, GREEN, 회귀 확인, 빌드, 개별 커밋을 되풀이하며, 그 작업이 건드린 파일만 올리고
git add -A는 쓰지 않습니다
문서는 자동 모드가 작업당 더 빠른 것이 아니라고 분명히 적습니다. 같은 테스트 주도 고리를 돌리되 작업 사이에 끼는 사람만 뺀다는 것입니다. 멈춰서 묻는 조건은 세 가지입니다. 테스트가 안 풀리거나 빌드가 깨질 때, 스펙이 모호하거나 스펙에 없는 결정이 필요할 때, 그리고 인증·권한, 되돌릴 수 없는 데이터 이전, 결제, 삭제, 배포, 비밀 값처럼 git revert로 되돌릴 수 없는 단계일 때입니다. 사용자가 막힌 곳을 풀고 /build auto를 다시 치면 다음 미완료 작업부터 이어집니다.
마지막 조건에서 쓰는 장치가 doubt-driven-development입니다. 확신에 찬 답이 맞는 답은 아니라는 전제로, 큰 결정마다 반증하려는 새 검토자를 세웁니다.
- 주장 적기"이 캐시 계층은 읽기 위주 부하에서 스레드 안전하다"처럼 두세 줄로
- 추려 내기결과물과 계약만 남기고 내 추론 과정은 지운다
- 의심하기새 컨텍스트의 검토자가 "틀린 점을 찾아라"는 프롬프트로 검토한다. 내 주장은 넘기지 않는다
- 정리하기지적을 계약 오해, 유효, 감수할 절충, 잡음으로 분류
- 멈추기사소한 지적만 남거나, 3회 돌았거나, 사용자가 "출시해"라고 할 때
내 결론을 함께 넘기면 검토자가 그 결론에 동의해 주기 쉬우므로 결과물과 계약만 넘기는 것이 요점입니다. 다른 모델 계열이 같은 맹점을 공유하지 않는다는 이유로 교차 모델 검토를 쓸 수 있는데, 외부 명령줄 도구를 쓰기 전에 사용자에게 매번 묻고 읽기 전용 샌드박스로 돌리라고 안내합니다. 검토 대상 텍스트 안에 숨은 지시가 도구를 움직일 수 있기 때문입니다. 세 번 돌아도 본질적인 지적이 남으면 반복을 늘리지 않고 결과물이 아직 준비되지 않았다고 알립니다.
/ship 한 번에 세 검토자가 읽는 순서
/ship은 저장소가 인정하는 유일한 병렬 조율입니다. 한 번에 서브에이전트 셋을 띄워 같은 변경을 다른 관점으로 읽히고, 보고서가 돌아오면 메인 에이전트가 합칩니다. 아래 그림에서 세 호출이 같은 턴에 나가고, 보고서가 한꺼번에 돌아온 다음에야 판정이 나오는 순서를 보면 됩니다.
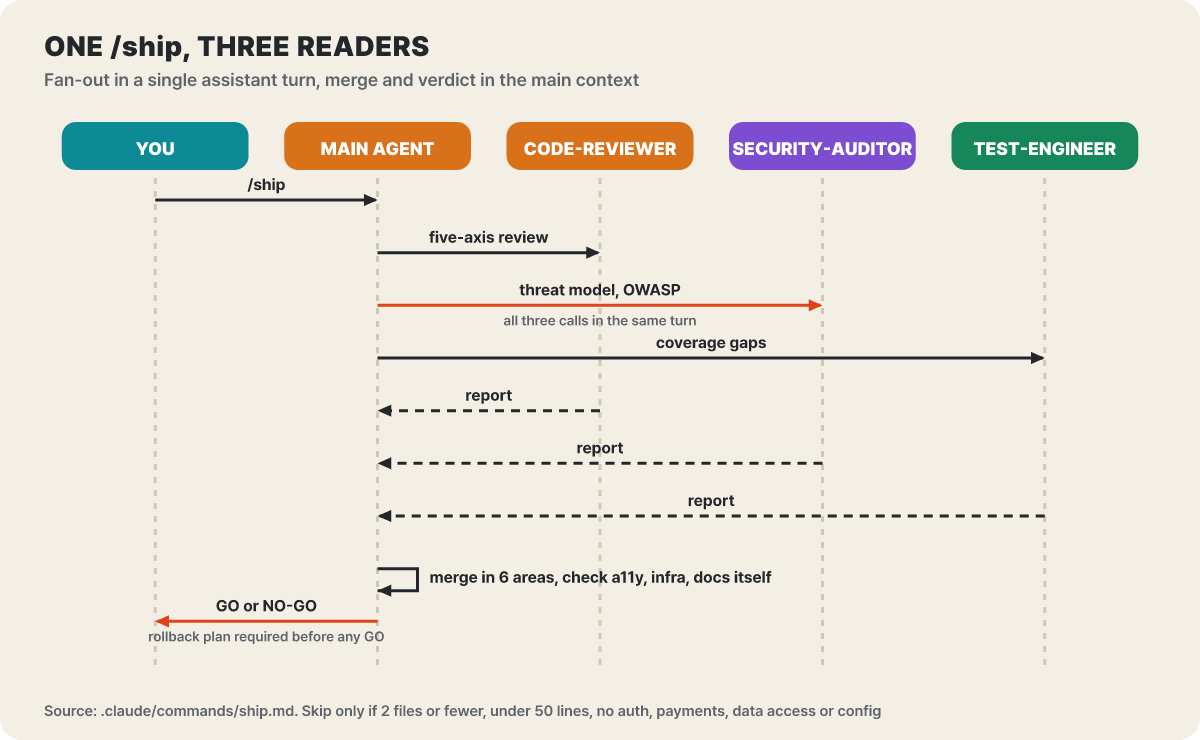 그림 4. 세 검토자는 서로를 부르지 않고 각자 새 컨텍스트에서 일한다. 병합과 판정은 메인 에이전트의 몫
명령 문서는 세 호출을 한 번의 어시스턴트 턴에 모두 내보내라고 못 박습니다. 호출을 차례로 하면 병렬로 나누는 의미가 없어지기 때문입니다. 검토가 서로 의존하지 않고 각자 새 컨텍스트 창에서 돌아 메인 세션이 어수선해지지 않는다는 것이 병렬로 하는 이유입니다. 병합은 코드 품질, 보안, 성능, 접근성, 인프라, 문서의 여섯 영역으로 정리합니다. 접근성·인프라·문서는 세 페르소나가 다루지 않아 메인 에이전트가 직접 확인합니다. 사용자가 .claude/agents/에 같은 이름의 페르소나를 정의해 두었다면 플러그인의 것보다 그쪽이 우선하므로, 팀의 기준에 맞게 고친 검토자가 /ship에 그대로 들어옵니다.
판정 규칙은 단순합니다. Critical 지적이 하나라도 나오면 사용자가 위험을 명시적으로 떠안지 않는 한 기본 판정이 NO-GO이고, 롤백 계획이 없으면 GO를 낼 수 없습니다. 변경이 2개 파일 이하, 50줄 미만이고 인증·결제·데이터 접근·설정을 건드리지 않을 때만 병렬 점검을 건너뛸 수 있습니다. 판정 뒤의 롤아웃은 shipping-and-launch 스킬이 정합니다. 기능 플래그를 끈 채 배포하고, 팀 내부에 켜서 24시간을 보고, 사용자 5%에 켜서 24~48시간 기준선과 비교하고, 25%, 50%, 100%로 넓힌 뒤 전체 공개 후 2주 안에 플래그와 죽은 코드 경로를 치웁니다. 단계를 넘길지는 감이 아니라 임계값으로 정합니다.
| 지표 | 진행 | 보류하고 조사 | 롤백 |
|---|---|---|---|
| 오류율 | 기준선 대비 10% 이내 | 10~100% 높음 | 기준선의 2배 초과 |
| P95 지연 | 20% 이내 | 20~50% 높음 | 50% 초과 |
| 클라이언트 JS 오류 | 새 종류 없음 | 새 오류가 세션의 0.1% 미만 | 새 오류가 세션의 0.1% 초과 |
| 사업 지표 | 중립 또는 개선 | 5% 미만 하락(잡음일 수 있음) | 5% 초과 하락 |
초록불을 만드는 다섯 가지 편법
앞의 스킬들이 일하는 순서를 정했다면 constraint-driven-development는 이 프로젝트의 기준을 숫자로 파일에 남깁니다. 8월 28일 0.6.8에서 들어온 이 스킬은 저장소 루트의 CONSTRAINTS.md 한 장을 만들고, 숫자마다 그것을 재는 검사 명령을 함께 적게 합니다. 코드와 설정에서 읽을 수 있는 것(언어, 테스트 러너, 린터, CI)은 묻지 않고 찾은 뒤 질문을 네 개로 제한하며, 질문마다 기본값이 있어 “모르겠다”도 완성된 답입니다. 목표 수치를 모를 때의 기본값은 변경한 줄의 커버리지 80% 이상(테스트를 쓰게 만들 만큼 높고 설정 한 줄을 허용할 만큼 낮은 값), 프로젝트 전체 커버리지는 오늘의 값에서 떨어지지 않기, 변이 점수는 처음 60%에서 성숙하면 80%, 의존성 취약점은 high 이상 0건, LCP 2,500ms와 CLS 0.1 이하, 예외 수명 90일입니다. 이미 기준 아래인 코드베이스를 위한 장치가 “래칫”입니다. 커버리지가 62%인데 80%를 강제하면 영원히 빨간 빌드가 남고 팀이 빨간 빌드를 무시하게 되므로, 오늘의 값을 기록하고 그 아래로 떨어지는 것만 막습니다.
가장 실용적인 대목은 에이전트가 기준을 슬쩍 낮추는 다섯 가지 수입니다. 에이전트는 교묘한 편법을 쓰는 것이 아니라 빨간불을 만나면 가장 싼 길로 초록불을 만든다고 스킬은 보고, 리뷰 때 git diff만으로 이 다섯 가지를 찾습니다.
| 편법 | git diff에서 보이는 모습 |
|---|---|
| 임계값이 움직였다 | 예산 수치가 낮아졌거나, 심각도가 내려갔거나, 빠른 단계에서 검사가 빠졌다 |
| 테스트가 쉬워졌다 | skip이 붙었거나, 테스트 파일이 지워졌거나, 남은 테스트에서 검증문이 빠졌다 |
| 검사기가 입을 닫았다 | 새 @ts-ignore나 eslint-disable, 커버리지·변이·보안 검사의 제외 주석 |
| 일이 덜 끝났다 | 예외만 던지는 빈 껍데기, 실패를 삼키는 빈 catch, 구현 자리의 TODO |
| 예외가 생겼다 | 아무도 논의하지 않은 새 예외 행 |
원칙은 기준을 조이는 일은 조용히, 푸는 일은 시끄럽게 하는 것입니다. 이 스킬에 딸린 참조 구현 floor-guard는 이 검사의 시작점인데, 0.6.11에서 큰 결함이 고쳐졌습니다. 가드가 잡겠다고 밝힌 14개 사례 중 7개를 조용히 통과시키고 있었고, 추적되지 않은 억제 주석, 삭제된 테스트 파일, 느슨해진 최대 예산이 그 예입니다. 지금은 14개를 모두 잡고 CI에 자체 테스트가 붙었습니다. 자기 프로젝트에 이 참조를 옮겨 썼다면 새 버전을 가져가라는 안내가 릴리스 노트에 있습니다.
검사가 얼마나 믿을 만한지도 따집니다. 에이전트가 동작하지 않는 코드를 써서 통과할 수 있느냐로 나누면, axe나 취약점 데이터베이스, 실제 브라우저를 재는 Lighthouse는 외부 검사라 에이전트가 따질 수 없고, 사람이 소유한 린트 규칙은 중간이며, 에이전트가 쓴 테스트 스위트만이 진짜 순환입니다. 그래서 기준 중 적어도 하나는 외부 검사여야 합니다. 비밀 값 검사 gitleaks에는 반드시 --redact를 붙이라는 주의도 있습니다. 붙이지 않으면 찾아낸 비밀이 에이전트의 기록으로 흘러 들어가기 때문입니다.
리뷰 스킬에서도 같은 맥락의 요령 하나가 나옵니다. 0.6.12에 들어온 것으로, “이 테스트가 회귀를 잡을까”를 읽어서 판단하지 말고 실험하라는 것입니다. 변경이 더한 조건 하나를 뒤집어 보고(부정 하나 빼기, &&를 ||로 바꾸기) 스위트를 돌린 뒤 원래 파일로 되돌렸을 때도 초록이면, 그 변경에는 빠진 테스트가 있다는 발견입니다. 변경 크기 기준도 있어서 약 100줄이면 좋고, 약 300줄은 하나의 논리적 변경일 때만 허용하며, 약 1,000줄이면 쪼개라고 합니다.
첫 달의 순서와 다른 모음과의 거리
설치한 뒤의 문제는 어디부터 켜느냐입니다. docs/adoption-guide.md는 코드베이스의 나이에 따라 두 길을 가릅니다.
| 항목 | 새 프로젝트 | 오래된 코드베이스 |
|---|---|---|
| 시작 | 첫 기능부터 /spec, /plan, /build, /review, /ship |
규칙 파일, 들어오는 변경의 리뷰, 이미 고치던 버그의 디버깅부터 |
| 테스트 | 테스트 주도, 깃 규율, 보안, 결정 기록을 상시로 | 바꿀 곳에만 특성화 테스트(지금 동작을 그대로 고정)를 두고 그 뒤에 단순화 |
| 새 기능 | 같은 흐름 | 새 기능만 전체 흐름, 새 코드와 옛 코드 사이는 계약 먼저. 마지막 4단계에서 폐기·이전, 관측성, 측정 먼저 하는 성능 작업 |
| 가장 비싼 지름길 | “프로토타입이니까” 스펙 건너뛰기 | 테스트 없는 코드를 에이전트에게 리팩터링시키기 |
| 같은 상태에 닿는 데 | 하루 | 한 분기 정도 |
가이드가 안티패턴으로 꼽는 것도 길마다 다릅니다. 새 프로젝트에서는 “25개를 모든 세션에 올리기”가 컨텍스트를 낭비하고 중요한 스킬을 희석한다고 하고, 오래된 코드베이스에서는 첫날 전체 흐름을 얹는 일괄 도입이 이미 있는 코드의 스펙과 안전망 없는 리팩터링을 낳는다고 합니다. 이상한 재시도 루프가 사실은 떠받치는 기둥일 수 있어서 이해하기 전에는 지우지 말라는 Chesterton의 울타리 원칙도 같은 맥락입니다.
같은 계열의 모음과는 docs/comparison.md가 Superpowers(obra), Matt Pocock의 스킬과 나란히 견줍니다. 저장소 쪽이 직접 쓴 비교라 참고로만 읽어야 합니다. agent-skills는 정의부터 배포까지의 제품 생애주기가 중심이고 스킬 25개에 핑계 반박표와 /ship의 병렬 페르소나, 저장소 안의 평가 틀이 특징이며 단계마다 검문소를 두는 것이 기본입니다. Superpowers는 브레인스토밍에서 리뷰까지 한 줄기 개발 방법론으로 약 14개의 스킬이 구현 안쪽 고리에 깊고 중간 확인을 일부러 줄인 자율 실행을 지향합니다. Pocock의 모음은 약 30개로 요구를 캐묻는 “그릴링”과 PRD, TDD 같은 가벼운 일상 고리를 도구 상자로 공개합니다. 비교 문서는 별 수를 일부러 뺐고, 제3자 실험 하나를 인용하면서 벤치마크가 아니라고 선을 긋습니다. Om Mishra의 단일 작업 실험에서 agent-skills는 코드에 도달하는 데 약 8분(비교 대상은 약 12분)이 걸렸고 검증을 7번 거쳐(비교 대상은 5번) 기능 밖의 호환성 문제까지 잡았지만 사전 설계 추론은 Superpowers가 더 많이 투자했습니다. 한 사람이 한 작업으로 잰 값이니 우열의 근거가 아니라 선택 기준의 예입니다. 기능 하나를 앞에서 끝까지 사람이 지켜보며 끌고 간다면 agent-skills, 크고 모호한 덩어리를 맡기고 자리를 비운다면 Superpowers, 가볍게 요구를 다듬는 일상 고리라면 Pocock의 모음이 맞는다는 것이 비교 문서의 결론입니다.
설치 경로별로 걸리는 곳
README가 소개하는 가장 빠른 길은 오픈 skills CLI로, Claude Code, Cursor, Codex, Copilot, Cline을 포함해 70곳 넘는 에이전트에 넣을 수 있다고 합니다. 스킬 한 개만 설치하면 저장소 전체가 공유하는 references/ 폴더가 따라오지 않아 스킬 속 보조 체크리스트 경로가 열리지 않는다는 점은 이슈 #361로 추적되는 알려진 틈입니다. 전체 저장소를 설치하거나 복제하거나, 필요한 체크리스트를 스킬 폴더 안으로 복사하는 것이 대안입니다.
npx skills add addyosmani/agent-skills            # 스킬 25개 전부
npx skills add addyosmani/agent-skills --list     # 설치 전에 목록만 보기
npx skills add addyosmani/agent-skills --skill test-driven-development
Claude Code 마켓플레이스 설치는 /plugin marketplace add addyosmani/agent-skills에 이어 /plugin install agent-skills@addy-agent-skills입니다. 마켓플레이스가 SSH로 복제하므로 GitHub SSH 키가 없으면 실패할 수 있고, 그때는 전체 HTTPS 주소로 추가하라고 안내합니다. Codex는 codex plugin marketplace add addyosmani/agent-skills 뒤 codex plugin add agent-skills@agent-skills, Gemini CLI는 gemini skills install https://github.com/addyosmani/agent-skills.git --path skills입니다. 이 호스트 목록에도 기준이 생겼습니다. 0.6.13부터 README의 설치 절에는 maintainer가 직접 돌려 본 호스트만 싣고 나머지는 docs/other-hosts.md에 한 줄로 둡니다. 0.6.12에 들어갔던 Oh My Pi와 Dojo Workspace 안내문은 이 기준에 따라 철회됐습니다.
훅은 셸 명령입니다. 스킬은 마크다운이라 읽고 판단할 수 있지만, hooks/의 스크립트는 연결하면 에이전트 도구 호출 앞뒤에서 내 컴퓨터의 셸로 실행됩니다. 연결하기 전에 스크립트를 한 번 읽어 보세요. 코드를 단순화할 때 건드리지 말아야 할 블록을 가리는 simplify-ignore는 0.6.10, 0.6.11, 0.6.13에서 작업물을 잃거나, 복원할 때 문자가 깨지거나, 되돌린 변경이 되살아나던 버그가 고쳐졌으니 쓰려면 최신 릴리스를 받으세요.
25개를 한꺼번에 깔아도 되나?
권하지 않습니다. 도입 가이드가 안티패턴으로 꼽는 것이 25개를 모든 세션에 올리는 일이고, 컨텍스트를 낭비하면서 중요한 스킬을 희석한다는 이유입니다. 스킬을 고르는 일은 호스트의 자체 라우팅이나 메타 스킬 중 하나에만 맡기라고 합니다. 둘을 함께 쓰면 라우터가 이중이 됩니다.
Copilot이나 Cursor에서도 /spec과 /ship이 되나?
슬래시 명령은 Claude Code용 래퍼입니다. Copilot에서는 명령이 나타나지 않으니 /spec-driven-development처럼 스킬 이름으로 부르라고 README가 안내합니다. Cursor는 .cursor/skills/와 .cursor/rules/를 내 프로젝트에 두는 방식이고 이 저장소가 그 폴더를 싣고 있지는 않습니다. Gemini CLI에는 각자의 명령 래퍼 폴더가 있습니다.
한 주 동안 켜 둘 구성과 직접 쓸 설명 문장
처음부터 25개를 다 켜지 않고 단계별로 필요한 것만 켜라는 것이 도입 가이드의 방향입니다. 어느 셋이냐는 편집부의 제안으로, 앞 절들에서 본 순서대로 모호한 요청을 받는 interview-me, 구현 쪽의 test-driven-development, 합치기 전의 code-review-and-quality입니다. 세 스킬이 내 작업 방식에 맞는지 한 주 보고, 맞으면 한 기능으로 /spec부터 /ship까지 끝까지 돌려 본 뒤에 나머지를 하나씩 추가합니다.
npx skills add addyosmani/agent-skills --skill interview-me
npx skills add addyosmani/agent-skills --skill test-driven-development
npx skills add addyosmani/agent-skills --skill code-review-and-quality
켜 둔 스킬의 비용은 Claude Code 설정의 skillOverrides로 줄일 수 있습니다. "name-only"는 목록에 이름만 올려 컨텍스트를 아끼고, "off"는 목록에서 완전히 가립니다. 다만 이름만 보이게 한 스킬은 설명이 가려지므로, 앞에서 본 것처럼 설명 문장이 자동 호출을 돕는 효과를 포기하는 선택입니다. 플러그인으로 설치한 스킬에는 적용되지 않고 /plugin에서 관리합니다.
{
  "skillOverrides": {
    "performance-optimization": "name-only",
    "deprecation-and-migration": "off"
  }
}
팀 스킬의 설명에는 이 글에서 본 틀을 그대로 쓸 수 있습니다. 무엇을 하는지, 언제 쓰는지, 그리고 모델이 “혼자 하면 된다”고 판단할 만한 경우에도 적용된다는 한 절입니다. 아래는 저장소의 두 설명을 본떠 편집부가 만든 예시입니다.
---
name: release-notes-check
description: Checks release notes against the merged pull requests. Use before publishing a release. Use when asked to review draft release notes, even when the text is pasted inline and the request does not mention pull requests.
---


