DeepSeek V4.1 Flash 1017, 가격은 그대로인데 터미널 점수가 31에서 42로 올랐다
DeepSeek V4.1 Flash 1017은 단가가 그대로(입력 $0.30·출력 $1.20)인데 Terminal-Bench가 31.2에서 42.3으로 올랐습니다. 점수의 조건, 경쟁 모델과의 승패, 작업당 비용, 시간대별 청구액을 숫자로 읽습니다.
가격표는 9월과 같은 줄이고, 점수표는 열한 줄이 전부 다른 줄이 됐습니다. DeepSeek이 10월 17일 V4.1 Flash를 V4.1-Flash-1017로 교체했는데 100만 토큰당 입력 $0.30(캐시 미스)·출력 $1.20은 그대로이고, 모델 카드의 비교표에서는 Terminal-Bench 4.0이 31.2에서 42.3으로, ProgramBench가 20.3에서 29.1로 올랐습니다. API 모델명 deepseek-flash가 그대로 1017을 가리키니 코드를 고칠 일은 없고, 가중치는 MIT 라이선스로 공개됐습니다. (이 글의 시각은 모두 UTC, 기준일은 10월 27일입니다.)
이 글은 사건 순서가 아니라 숫자 순서로 갑니다. 점수가 얼마나 올랐는지, 그 점수를 누가 어떤 조건에서 쟀는지, 경쟁 모델 앞에서 어디서 지는지, 같은 점수대에서 작업 하나가 얼마인지, 청구서가 시간대와 캐시에 따라 얼마나 흔들리는지를 차례로 읽습니다. Flash 계열은 두 달 반 사이에 세 번 모양이 바뀌었습니다. 7월 31일 V4-Flash-0731(총 2,840억 매개변수), 9월 10일 V4.1 Flash(5,520억 매개변수, 컨텍스트 100만 토큰, 이미지 입력), 그리고 10월 17일의 1017입니다. 아래에서 “이전 버전”은 9월 10일의 V4.1 Flash를 가리킵니다.
열한 칸이 전부 오른 폭을 재 보면
아래 그림은 모델 카드 비교표 중 이전 버전과 1017이 나란히 있는 열한 시험을, 상승폭이 큰 순서로 놓은 것입니다. 회색 점이 이전 버전, 주황 점이 1017이고 이름 옆 숫자가 오른 폭입니다.
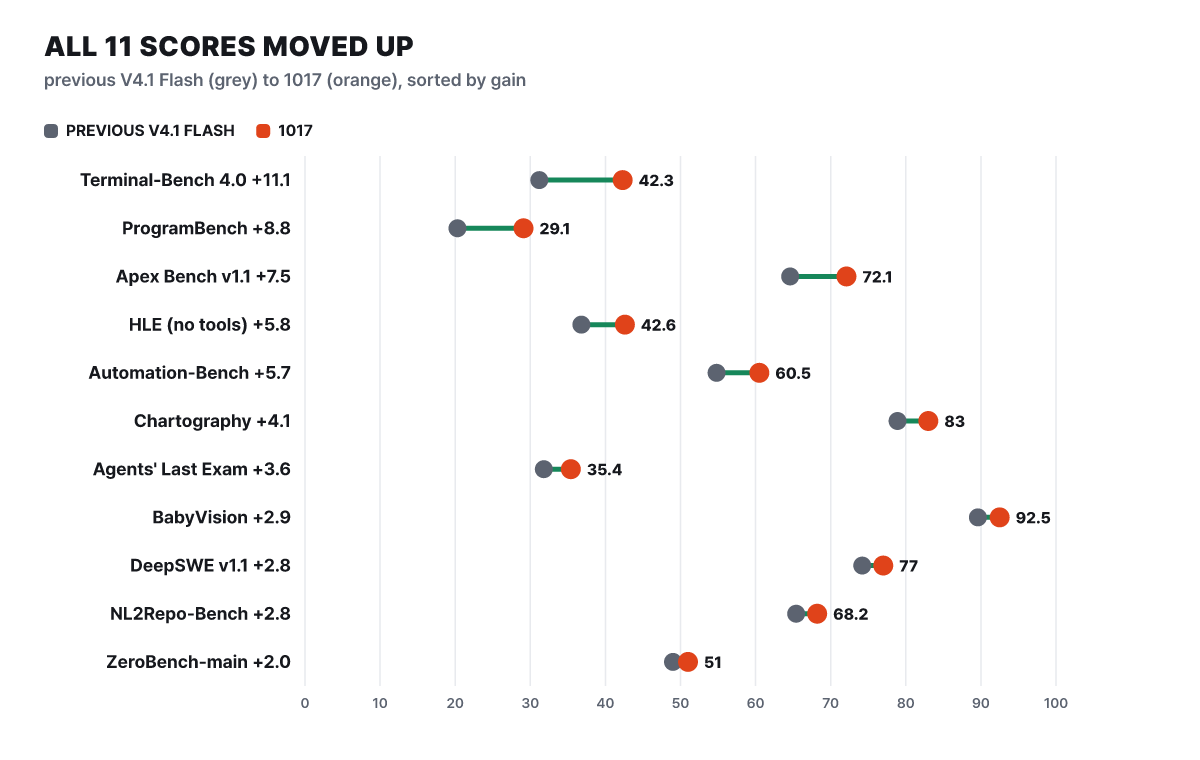 그림 1. 모델 카드 비교표의 이전 버전 대비 변화. DeepSeek이 직접 돌린 값이다
맨 위 두 칸이 눈에 띕니다. 터미널을 직접 다루며 일을 끝내는 Terminal-Bench 4.0이 +11.1점, 프로그램을 통째로 만드는 ProgramBench가 +8.8점입니다. 점수 자체가 낮은 시험이라 상대 증가율로 바꾸면 ProgramBench는 43%(20.3에서 29.1), Terminal-Bench는 36%로 더 극적입니다(편집부 계산). 반대로 아래쪽의 BabyVision(89.6에서 92.5)과 ZeroBench(49.0에서 51.0)는 오른 폭이 작은데, BabyVision은 1017 기준으로 만점(100점)까지 7.5점밖에 남지 않은 시험이기도 합니다. 열한 칸의 평균 상승폭은 5.2점입니다(57.1점의 합을 11로 나눈 편집부 계산).
이 분포는 DeepSeek의 설명과 같은 방향입니다. 릴리스 노트는 이번 학습의 핵심을 자기 피드백을 쓰는 강화학습이라고 부르고, 게임이나 3D 모델링처럼 프롬프트와 참고 자료가 짧아도 결과물을 끝까지 만드는 능력을 키웠다고 설명합니다. 같은 공지는 이를 “같거나 더 낮은 비용에서 더 나은 성능”, 즉 파레토 개선이라고 부릅니다. 점수 쪽 절반은 위 그림이 보여 주고, 비용 쪽 절반은 뒤에서 독립 측정과 청구서로 따져 봅니다.
표에 적히지 않은 조건 네 가지
그림 1의 값이 믿을 만한지는 값 자체보다 조건에 달렸습니다. 모델 카드 표를 읽을 때 걸리는 곳이 네 군데 있습니다.
첫째, 모든 칸이 DeepSeek이 정리한 값입니다. 어떤 시험을 표에 올릴지도 DeepSeek이 골랐으니, 이 표는 “1017이 이전보다 나아졌나”를 읽는 데 가장 잘 맞고 “시험 전체에서 누가 1등인가”를 말해 주지는 않습니다.
둘째, 시험마다 도구 상자가 다릅니다. 표 각주에 따르면 Terminal-Bench 4.0은 Claude Code 하네스(모델을 감싸 명령 실행과 파일 수정을 맡기는 틀)로, DeepSWE v1.1은 Mini-SWE-V2 하네스로 쟀습니다. 같은 모델도 하네스에 따라 점수가 달라지므로, 내가 쓰는 에이전트 도구에서 같은 숫자가 나온다는 보장은 없습니다.
셋째, HLE 칸에는 두 숫자가 있습니다. 1017은 42.6이고 텍스트 전용 부분집합 점수 44.0이 따로 적혀 있는데(이전 버전은 36.8과 39.1), GLM-5.3 칸에는 텍스트 전용 값 42.0만 있습니다. 어느 쪽 기준으로 놓아도 GLM-5.3보다 높지만, 칸마다 기준이 같지 않다는 점은 기억해야 합니다.
넷째, 마지막 세 칸(Chartography, BabyVision, ZeroBench-main)은 도구를 쓴 점수이고 GLM-5.3 칸은 비어 있습니다. 그래서 GLM-5.3과는 열한 칸이 아니라 여덟 칸만 겨룹니다. 이 표에는 경쟁 모델의 생각 수준이나 샘플링 설정도 적혀 있지 않습니다. K3가 Terminal-Bench 4.0에서 12.6으로, 다른 모델의 37.9~51.8과 크게 떨어진 것도 그 자체로 “점수보다 돌린 설정을 먼저 보라”는 신호입니다.
경쟁 모델 네 개 앞에서 이기고 진 칸
표에는 이전 버전 말고도 K3, GLM-5.3, GPT-5.6 Sol, Opus 5의 열이 있습니다. 칸마다 1017이 앞서는지 세어 모델별로 묶었습니다.
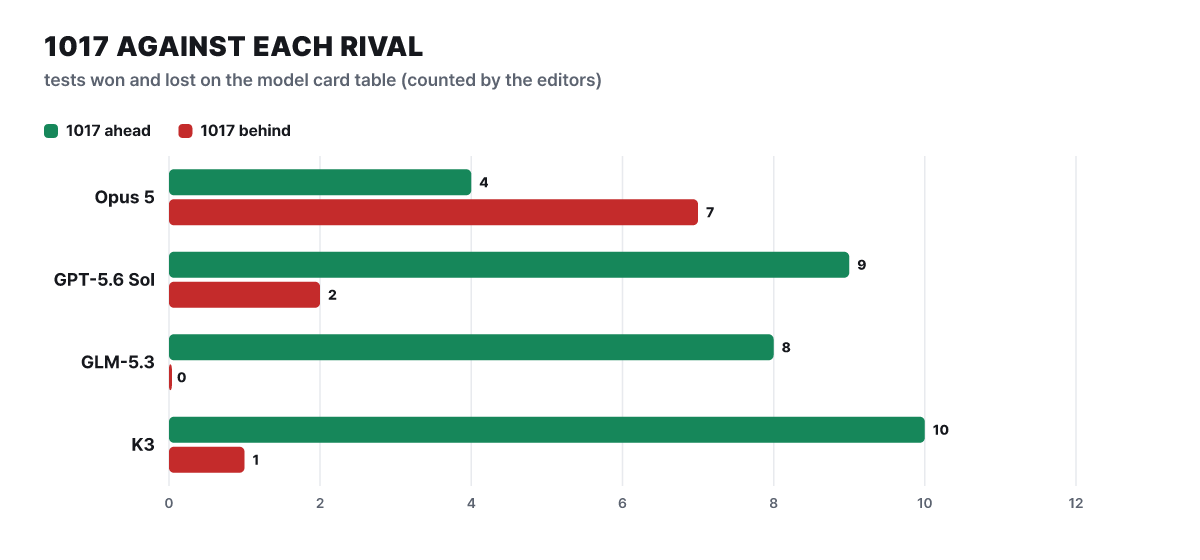 그림 2. 모델 카드 비교표에서 1017이 앞선 칸(초록)과 뒤진 칸(빨강)의 개수. 편집부가 표 값에서 센 것이다
GLM-5.3과는 겨룬 여덟 칸을 모두 이기고, K3에게는 HLE(42.6 대 43.5)만 집니다. GPT-5.6 Sol과는 아홉 칸을 이기고 HLE(42.6 대 44.5)와 ZeroBench-main(51.0 대 53.0) 두 칸을 집니다. Opus 5는 DeepSWE(77.0 대 74.0), Automation-Bench(60.5 대 50.3), Agents’ Last Exam(35.4 대 28.6), Apex Bench(72.1 대 65.8) 네 칸에서만 앞서고 일곱 칸에서 밀립니다. (괄호 안은 1017 대 상대 순서입니다. 이 표의 Opus 5와 뒤에 나오는 Artificial Analysis 리더보드의 Opus 5.5는 이름이 다른 별개의 항목입니다.)
그런데 개수만 세면 격차의 크기가 가려집니다. Opus 5에게 진 일곱 칸 중 Chartography(83.0 대 84.0), ZeroBench-main(51.0 대 52.0), BabyVision(92.5 대 94.1)은 1.6점 이내 차이입니다. 진짜 격차는 HLE의 13.7점(42.6 대 56.3), Terminal-Bench 4.0의 9.5점(42.3 대 51.8), ProgramBench의 7.9점, NL2Repo-Bench의 7.1점에 있고, 모두 어렵고 긴 작업이나 깊은 추론 쪽입니다(격차는 편집부 계산). 같은 숫자 4승 7패라도 “가장 어려운 추론에서는 최상위 모델과 아직 거리가 있고, 나머지에서는 거의 붙었다”로 읽는 것이 정확합니다.
독립 측정이 보태는 네 가지 숫자
업체 표만 보면 불안하니 독립 평가 기관 Artificial Analysis(이하 AA)의 측정을 겹쳐 봅니다. AA의 종합 지수(v4.3.2)는 Terminal-Bench 4.0, SciCode, HLE 등 여러 평가를 묶은 값이고, 1017은 최고 노력(Max) 설정으로 잰 결과가 올라 있습니다. 속도와 비용은 DeepSeek 자체 API 기준입니다.
종합 지수와 속도는 칭찬할 만한 값이고 출력 토큰만 반대 방향입니다. 얼핏 DeepSeek의 “출력이 짧아졌다”와 AA의 “매우 장황하다”가 부딪치는 것 같지만 비교 대상이 다릅니다. 전자는 이전 V4.1 Flash와 견준 말이고, 후자는 비교 집단 중앙값과 견준 말입니다. 이전보다는 짧아졌어도 집단 안에서는 여전히 말이 많은 모델이라는 뜻입니다.
단가도 집단 중앙값보다 쌉니다. AA 표기로 입력은 100만 토큰당 $0.30(중앙값 $0.43), 출력은 $1.20(중앙값 $1.45)이고, 캐시 적중 입력까지 7 : 2 : 1로 섞은 혼합 단가는 $0.18입니다. 캐시 할인이 98%라서 입력 비중이 큰 에이전트 작업일수록 이 혼합 단가 쪽에 가까워집니다.
지수 45점이 작업당 $0.26이면 싼 걸까
AA는 지수 평가 한 작업을 돌리는 데 든 비용도 모델마다 적어 둡니다. 1017은 작업당 $0.26입니다. 이 숫자가 싼지 비싼지는 옆에 놓아야 알 수 있습니다. 아래 그림은 10월 27일 AA 리더보드에서 고른 모델의 작업당 비용이고, 오른쪽 회색 글자가 그 모델의 종합 지수입니다.
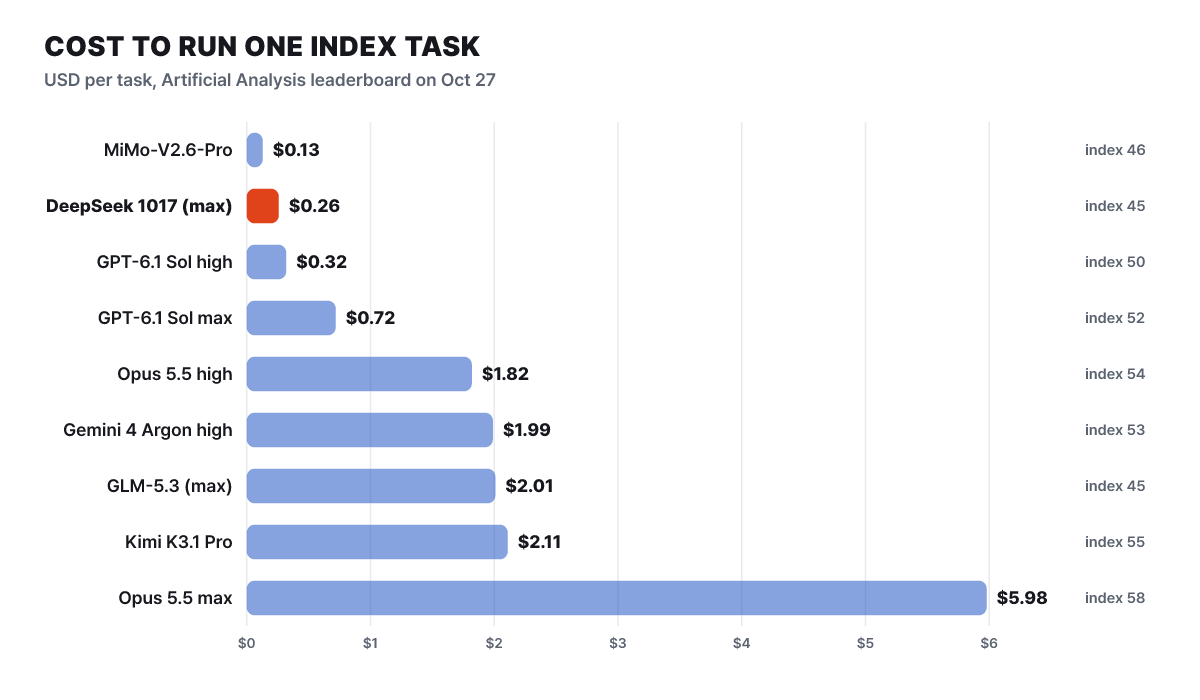 그림 3. Artificial Analysis 리더보드의 작업당 비용(달러)과 종합 지수. 같은 모델의 생각 수준이 다른 항목은 따로 적었다
같은 45점대에서 GLM-5.3(Max)은 $2.01이라 1017보다 약 7.7배 비쌉니다(편집부 계산). 점수를 더 얻으려는 쪽으로 보면 Kimi K3.1 Pro는 55점에 $2.11, Opus 5.5 max는 58점에 $5.98로 13점 위에 약 23배를 치릅니다. 반대로 1017이 가장 싼 쪽은 아닙니다. GPT-6.1 Sol high는 50점에 $0.32이고, MiMo-V2.6-Pro는 46점에 $0.13입니다. 모델을 고르는 문제는 모델 하나가 아니라 생각 수준까지 포함한 짝을 고르는 문제라는 것이 이 그림의 요점입니다.
두 가지는 덧붙여야 합니다. 이 비용은 AA 지수 평가의 입력·출력 길이로 계산한 값이어서 내 작업의 비용과 다릅니다. 또 AA가 적용한 입력 $0.30·출력 $1.20은 피크 시간 단가이니, 오프피크에 돌린다면 단가는 반으로 내려갑니다.
한 주 168시간 중 정가는 35시간
DeepSeek은 시간대에 따라 단가를 둘로 나눕니다. 가격 페이지의 100만 토큰당 가격은 아래와 같습니다.
| 100만 토큰당 | Flash 피크 | Flash 오프피크 | Pro 피크 | Pro 오프피크 |
|---|---|---|---|---|
| 입력, 캐시 적중 | $0.006 | $0.003 | $0.044 | $0.022 |
| 입력, 캐시 미스 | $0.30 | $0.15 | $1.32 | $0.66 |
| 출력 | $1.20 | $0.60 | $3.96 | $1.98 |
피크는 평일 UTC 01:0004:00과 06:0010:00이고 나머지는 모두 반값입니다. 그림에서 주황 칸이 정가, 연한 칸이 반값입니다.
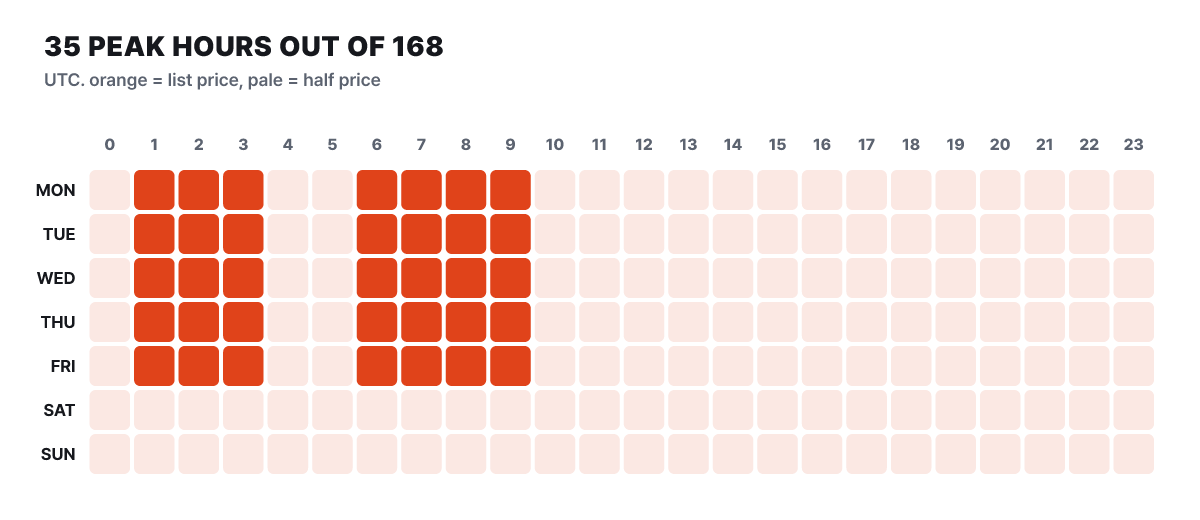 그림 4. UTC 기준 한 주 168칸. 주황 35칸이 정가, 연한 133칸이 반값이다
평일 하루에 피크는 7시간뿐이고 주말과 공휴일은 하루 전체가 오프피크로 계산됩니다. 한 주 168시간 중 피크는 35시간(20.8%), 반값은 133시간(79.2%)입니다. 그림에서 보듯 반값 구간이 사실상 기본값이고, 평일 UTC 04:00~06:00 사이와 10:00 이후에 일정을 잡으면 정가를 피할 수 있습니다. Pro(deepseek-v4-pro)는 DeepSeek-V4-Pro-0813이라는 별도 모델이고 캐시 미스 입력이 Flash의 4.4배, 출력이 3.3배이며, 이미지 입력은 지원하지 않습니다. Flash는 이미지 입력을 지원합니다.
작업 한 건의 영수증을 쪼개 보면
표의 단가가 실제 청구액으로 바뀌는 과정을 한 작업으로 계산해 보겠습니다. 가정은 이렇습니다. 코딩 에이전트가 40번 호출하고, 호출마다 앞부분 15만 토큰을 다시 보내 입력이 600만 토큰, 출력은 호출당 3천 토큰으로 12만 토큰입니다. 실제 호출 횟수와 토큰 수는 작업마다 다르므로 이 값은 가정입니다.
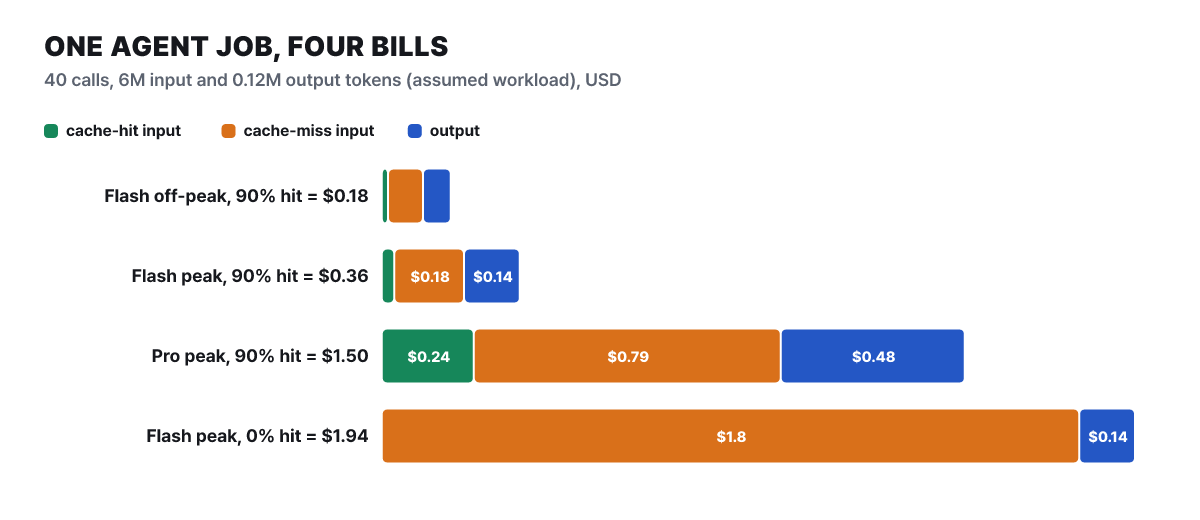 그림 5. 같은 작업의 청구액 구성(가정 워크로드, 가격표로 계산한 편집부 계산)
캐시 적중이 90%인 Flash 피크 청구액은 약 $0.36이고, 오프피크면 정확히 절반인 약 $0.18입니다. 같은 90%를 Pro 피크로 돌리면 약 $1.50(4.2배), 캐시를 하나도 못 맞히면 Flash 피크라도 약 $1.94로 5.5배가 됩니다. 눈여겨볼 것은 막대의 색입니다. 적중이 90%여도 입력의 10%인 60만 토큰이 캐시 미스로 계산되어 가장 큰 칸(약 $0.18)이 되고, 적중한 540만 토큰은 $0.03에 그칩니다. 캐시를 못 맞히면 입력 미스 하나가 청구액을 거의 전부 차지합니다. 그래서 절약의 순서는 캐시, 시간대, 모델 선택입니다.
캐시는 따로 켤 것이 없습니다. 모든 사용자에게 기본으로 켜져 있고, 앞서 보낸 요청과 앞부분이 같으면 그 부분이 적중으로 계산되며 응답의 usage 안에 prompt_cache_hit_tokens와 prompt_cache_miss_tokens가 따로 찍힙니다. 다만 최선 노력(best-effort) 방식이라 100% 적중을 보장하지 않고, 캐시를 만드는 데 수 초가 걸리며, 쓰지 않으면 대개 몇 시간에서 며칠 안에 지워집니다. 적중하려면 앞부분이 글자 단위로 같아야 하니 시스템 프롬프트와 긴 자료를 맨 앞에 고정하고 바뀌는 질문을 뒤에 붙이세요. 결과가 바로 필요 없는 문서 분류 배치 같은 작업은 평일 UTC 10:00 이후나 주말로 옮기는 것만으로 같은 일이 반값입니다.
호출 규칙이 청구서에 닿는 곳
호출하는 쪽의 사양은 한 장으로 모았습니다.
- 호출 이름
deepseek-flash(권장). 옛 이름deepseek-v4-flash등은 요청을 받지만 모델은 퇴역했고 1017이 Flash 요금으로 처리- 모델 버전
- DeepSeek-V4.1-Flash-1017
- 컨텍스트·출력
- 컨텍스트 100만 토큰, 최대 출력 38만 4천 토큰
- 모드
- 생각(thinking) 모드가 기본, 끄고 쓸 수도 있음
- 지원 기능
- JSON 출력, 도구 호출, Responses API, Anthropic API 형식, 이미지 입력, 접두 완성(베타). FIM 완성(베타)은 생각 모드를 끈 상태에서만
- 호환 주소
https://api.deepseek.com(OpenAI 형식),https://api.deepseek.com/anthropic(Anthropic 형식)- 동시 요청 한도
- 계정당 2,500건(Pro는 500건)
생각 모드는 기본으로 켜져 있고 노력 수준(effort) 기본값은 high입니다. 끄려면 thinking을 disabled로 두고, 수준을 바꾸려면 reasoning_effort에 low, high, max 중 하나를 씁니다. 다른 이름은 가장 가까운 값으로 묶여서 minimal은 low, medium과 xhigh는 high, ultra는 max로 처리됩니다. 공식 문서 예시는 다음과 같습니다.
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "이 저장소의 테스트가 왜 깨지는지 알려줘"}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "stream": false
  }'
호출 코드에서 걸리기 쉬운 곳은 세 군데입니다. 첫째, 도구(tools)를 쓰는 대화에서는 이전 턴의 reasoning_content를 모두 다시 보내야 하고, 빼먹으면 API가 400 오류를 돌려줍니다. 둘째, temperature, presence_penalty, frequency_penalty는 오류 없이 무시됩니다. 모델 카드가 권하는 temperature 1.0과 top_p 1.0은 가중치를 직접 서빙할 때의 값입니다. 셋째, top_p는 deepseek-flash의 생각 모드에서만 0.95~1.0 범위로 적용되고 그보다 낮은 값은 0.95로 처리됩니다.
한도도 숫자입니다. 동시 요청이 계정당 2,500건을 넘으면 HTTP 429가 돌아오고, 더 필요하면 추가 비용 없이 증설을 신청할 수 있습니다. 여러 최종 사용자를 상대하는 서비스라면 요청에 user_id(영문·숫자·-·_, 512자 이내)를 넣어 캐시와 스케줄을 사용자별로 나눌 수 있는데, 개인정보를 값에 넣지 말라고 문서가 못박습니다. 추론이 10분 안에 시작되지 않으면 서버가 연결을 닫습니다.
검색·가져오기 요금은 10월 31일 16:00 UTC부터
10월 17일 DeepSeek은 자체 검색 엔진 위에 Search와 Fetch 두 API를 열었습니다. 검색은 질의를 보내 결과 목록(필요하면 본문까지)을, 가져오기는 URL을 주면 제목과 마크다운 본문을 돌려줍니다. 주소는 각각 /v1/tools/search, /v1/tools/fetch이고 인증은 같은 API 키입니다. 각각 1,000회당 $0.75이고, 검색은 결과가 있는 성공 응답(200)만, 가져오기는 본문이 나온 성공 응답만 과금합니다. 빈 결과·실패·시간 초과는 무료입니다. 초당 요청 한도는 검색 100, 가져오기 25(도메인별 한도 별도)이며 넘으면 429가 돌아오고, 모델 동시성 한도와는 별개입니다.
curl https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{"query": "site:docs.python.org lang:en after:2026 asyncio taskgroup", "count": 5}'
질의는 1128자이고 50(기본 10)이고, 결과마다 0site:, -site:, 따옴표 정확 일치, lang:, after:·before: 같은 연산자를 쓸 수 있습니다. count는 13 점수의 4 단계의 rerank_score(1.5 이상이면 고품질)와 0authority(3 이상이면 신뢰도 높음)가 붙어 코드로 거를 수 있습니다. 본문까지 받으려면 need_content를 true로 줘야 하고 기본값 false에서는 content가 늘 빈 문자열입니다.
날짜가 중요합니다. DeepSeek Harness, Claude Code, Codex가 서버 쪽 도구로 이 API를 부르는 호출은 10월 31일 16:00 UTC까지 무료이고 그 뒤로는 요청마다 과금되며, 오늘 기준으로 나흘 남았습니다. 계정당 합산이라 에이전트를 몇 개 돌려도 한 장부에 쌓입니다. 웹 조사 에이전트가 하루 검색 1만 번을 부르고 검색 한 번당 가져오기를 두 번 따라 연다고 가정하면 3만 건, 하루 $22.5이고 30일이면 $675입니다(가정과 편집부 계산). 검색 결과만 쓰고 가져오기는 쓰지 않으면 하루 $7.5, 30일 $225입니다. 무료 기간이 끝나기 전에 검색과 가져오기를 합친 호출 횟수를 세어 두면 11월 청구서를 가늠할 수 있습니다. 재시도는 408·429·5xx에서만 하고, 402(잔액 부족)는 충전부터, 그 밖의 4xx는 요청을 고친 뒤에 보내라는 것이 공식 문서의 안내입니다. 하네스에서는 1017과 검색·가져오기 지원이 10월 17일 v0.2.1-rc.2에 들어갔고 가장 최신 후보는 10월 23일의 rc.3입니다.
내려받는 쪽의 숫자: 5,520억, 160억, 22곳
가중치는 Hugging Face(deepseek-ai/DeepSeek-V4.1-Flash-1017)와 ModelScope에 MIT 라이선스로 올라와 있어 상업 용도로도 쓸 수 있습니다. 10월 27일 모델 카드에는 최근 한 달 다운로드 95,889회, 좋아요 3.12k가 표시돼 있습니다. 모델은 40개 층의 전문가 혼합(MoE) 구조로, 층마다 라우팅 전문가 384개와 모든 토큰이 거치는 공유 전문가 1개를 두고 토큰마다 6개를 고릅니다. 총 5,520억 매개변수 중 답을 만드는 단계에서 실제로 일하는 것은 약 160억이고, 프롬프트를 읽는 단계는 약 80억입니다. 가중치는 FP8, 전문가는 FP4로 저장돼 있어 개인 PC용이 아닙니다. 필요한 GPU 규모는 배포 전에 직접 재 봐야 합니다. KV 캐시가 토큰당 890바이트로 줄어든 과정은 KV 캐시 다이어트 글에 풀어 두었습니다.
서빙은 vLLM(vllm serve 한 줄로 OpenAI 호환 주소가 8000번 포트에 열림), SGLang(pip 또는 lmsysorg/sglang 도커 이미지), Docker Model Runner(docker model run hf.co/deepseek-ai/DeepSeek-V4.1-Flash-1017), Transformers가 안내돼 있습니다. 낯선 점은 채팅 템플릿(Jinja)이 없다는 것입니다. 저장소 encoding 폴더의 파이썬 참조 구현(encoding.py)이 다중 턴 대화, 도구 호출, 생각 모드, 이미지가 섞인 입력을 모두 다루고, 운영용으로는 같은 형식을 Rust 라이브러리와 파이썬 바인딩으로 낸 deepseek-recipe를 권합니다. 이 라이브러리는 요청 변환과 출력 해석만 맡고 추론, 도구 실행, HTTP 전송은 호출하는 쪽이 책임집니다. 직접 서빙하지 않고 업체가 올려서 파는 경로를 고르면 AA 기준으로 1017을 제공하는 곳이 22곳이니 단가와 속도를 견줄 수 있습니다. 허브에 보이는 양자화·파생 모델은 DeepSeek 공식 배포가 아니라 제3자가 만든 것이니 출처를 확인하고 쓰세요.
이 글의 상승폭과 비용은 대부분 9월의 V4.1 Flash를 기준선으로 한 값입니다. Flash 계열이 두 달 반 사이에 세 번 바뀌었으니 다음 교체가 오면 같은 이름의 호출이 다른 점수를 낼 수 있습니다. 점수나 단가를 메모해 둘 때는 deepseek-flash라는 별칭이 아니라 DeepSeek-V4.1-Flash-1017이라는 버전 이름과 잰 날짜를 같이 적어 두는 것이 이 모델에서 가장 값싼 안전장치입니다.



