쉬운 질문에도 비싼 모델을 쓰고 있진 않나요, LLM 라우팅으로 비용 줄이는 법
강한 모델에 질문의 13.4%만 보내도 품질 95%에 닿는다는 논문 표로 비용 곡선을 그리고, 챗봇 100만 건의 청구서와 손익분기, 라우터를 놓을 자리 네 곳을 계산했습니다.
쇼핑몰 챗봇이 한 달에 질문 100만 건을 전부 고급 모델에 보내면 24,700달러가 나오고, 질문의 13.4%만 고급 모델에 보내고 나머지를 값싼 모델에 맡기면 3,518달러로 내려갑니다. 같은 챗봇에 같은 100만 건이고 달라진 것은 질문마다 모델을 고르는 판정기 하나입니다. 이 두 숫자는 RouteLLM 논문의 MT Bench 결과(고급 모델 점수의 95%)를 쇼핑몰 규모로 옮긴 편집부 계산이라서, 어디까지 그대로 믿어도 되는지가 이 글의 주제입니다.
그래서 순서는 계산서 쪽에서 출발합니다. 강한 모델 호출 비율에 따라 비용과 품질이 어떻게 움직이는지 논문 표로 곡선을 그리고, 그 곡선으로 한 달 청구서와 손익분기를 계산합니다. 곡선이 시험마다 왜 달라지는지, 내 질문으로 곡선을 다시 그리는 법, 라우터를 어디에 놓을 수 있는지가 뒤따릅니다. 기준일은 2026년 10월 27일입니다.
백만 토큰 24.70달러와 0.24달러 사이의 직선
LLM API는 처리한 토큰 수에 단가를 곱해 청구합니다. 모델 평가 단체 LMSYS가 낸 RouteLLM 논문(arXiv 2406.18665)이 비용 계산에 쓴 가정 단가는 강한 모델(GPT-4 계열) 백만 토큰당 약 24.7달러, 약한 모델(Mixtral 8x7B) 약 0.24달러입니다. GPT-4의 값은 당시 가격표와 평균 입출력 길이로 섞어 낸 추정치입니다. 두 모델 모두 2024년 기준이므로, 지금 쓰는 모델 쌍의 단가를 넣어도 같은 식이 성립한다는 점이 중요합니다.
그 식은 단순합니다. 강한 모델에 보내는 비율을 r이라 하면 백만 토큰당 섞인 단가는 0.24 + 24.46 × r 달러입니다. 호출마다 토큰 수가 같다는 가정을 깔면 곡선이 아니라 직선이라서, 비율을 반으로 줄이면 비용도 정확히 반으로 줄어듭니다. 절반만 보내면 12.47달러, 10%만 보내면 2.69달러입니다.
비용이 직선이라면 따질 것은 품질뿐입니다. 비율을 낮추는 만큼 품질이 같은 속도로 떨어지면 라우터는 필요 없고 동전 던지기로 섞으면 됩니다. 라우터가 값을 하는 이유는 품질이 직선으로 떨어지지 않고 휘어진다는 데 있습니다.
품질은 직선이 아니라 휘어진다
판정기가 하는 일은 질문을 읽고 “강한 모델이 약한 모델보다 더 나은 답을 낼 확률”을 계산하는 것입니다. 이 값이 사용자가 정한 임계값(논문 기호로 알파) 이상이면 강한 모델로, 아니면 약한 모델로 보냅니다. 판정기의 공부 재료는 LMSYS가 운영하는 Chatbot Arena에 쌓인 사람들의 비교 투표입니다. 두 모델의 답을 나란히 보고 어느 쪽이 나은지 고른 기록으로, 논문은 약 8만 건에서 검증용 5천 건과 짧은 프롬프트를 덜어 내고 6만 5천 쌍(모델 64개, 영어 81%)을 썼습니다. 임계값을 높이면 강한 모델로 가는 길이 좁아져 싸지고 위험해집니다.
품질을 재는 눈금은 PGR(성능 격차 회복률)입니다. 약한 모델만 쓸 때를 0, 강한 모델만 쓸 때를 100으로 두고 라우터가 그 사이 어디까지 올라왔는지를 봅니다. CPT(50%)는 PGR 50에 닿는 데 필요한 강한 모델 호출 비율의 최솟값으로, 낮을수록 좋습니다. 아래 그림은 논문 표 1의 MT Bench 값으로 그린 곡선입니다. 가로축은 강한 모델 호출 비율과 그때의 섞인 단가, 세로축은 PGR입니다.
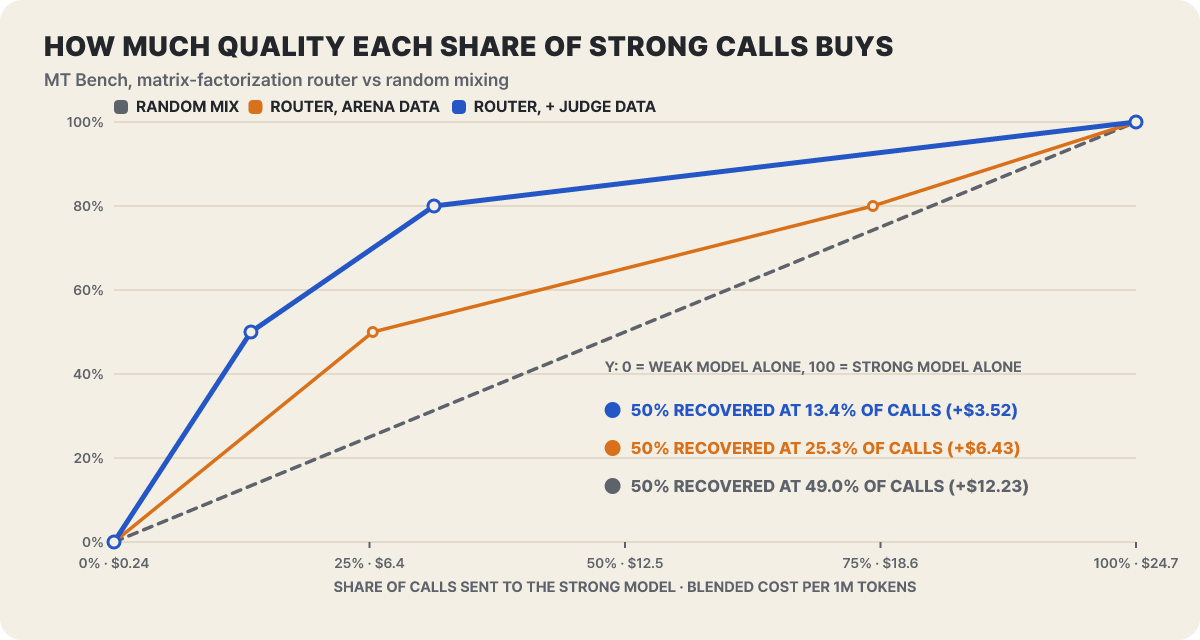 그림 1. MT Bench 기준 회복률 곡선. 표에 나온 점(0, 50, 80, 100)만 찍고 사이는 직선으로 이었다. 단가 환산은 편집부 계산
대각선이 무작위 섞기이고, 위로 솟은 두 곡선이 라우터입니다. 보조 데이터로 GPT-4를 심판으로 쓴 채점 기록을 더해 학습한 라우터는 강한 모델 호출 13.4%에서 PGR 50에 닿고 31.3%에서 80에 닿습니다. Arena 데이터만으로 학습한 쪽은 25.3%에서 50, 74.3%에서 80입니다. 무작위 섞기는 49.0%와 78.1%가 필요합니다. 곡선이 위로 휘는 까닭은 판정기가 질문을 “강한 모델이 필요한 순서”로 줄 세워 앞쪽부터 비싼 모델에 보내기 때문입니다. 처음 보내는 몇 %가 가장 큰 격차를 메우고 뒤로 갈수록 이득이 얇아집니다.
PGR 50이 실제 점수로는 얼마인지도 짚어 둘 만합니다. 논문은 MT Bench에서 PGR 50 지점의 점수가 8.8, GPT-4 단독이 9.3으로 95%라고 적었습니다. 두 값에서 거꾸로 풀면 약한 모델 Mixtral의 점수는 약 8.3이어서(편집부 계산, 반올림에 따른 근사) 아무것도 하지 않아도 GPT-4의 89%는 이미 확보된 셈입니다. MMLU는 PGR 50 지점이 75점, GPT-4가 81점으로 92%이고 약한 모델은 약 69점(85%)입니다. GSM8K는 75점 대 86점으로 87%이고 약한 모델은 약 64점(74%)입니다. “품질 95%“라는 말은 약한 모델이 이미 얼마나 잘하는 시험이냐에 크게 기대고 있습니다.
같은 95%에 붙는 가격표 세 개
논문 표 6은 “절감 3.66배(MT Bench), 1.41배(MMLU), 1.49배(GSM8K)“를 싣고 있습니다. 이 배수를 GPT-4만 쓸 때와 견준 값으로 읽기 쉽지만, 논문 본문은 계산 방식을 다르게 적었습니다. 같은 품질에 닿는 데 필요한 무작위 라우터의 GPT-4 호출 비율을 라우터의 비율로 나눈 값입니다. MT Bench는 49.03 ÷ 13.40 = 3.66이고, 기준은 GPT-4 단독이 아니라 무작위 섞기입니다.
기준선을 셋으로 나누어 같은 PGR 50 지점의 백만 토큰당 비용을 세워 보면 그림이 달라집니다. 아래 막대는 벤치마크마다 GPT-4만 쓸 때, 무작위로 섞을 때, 가장 좋은 라우터를 쓸 때의 값입니다.
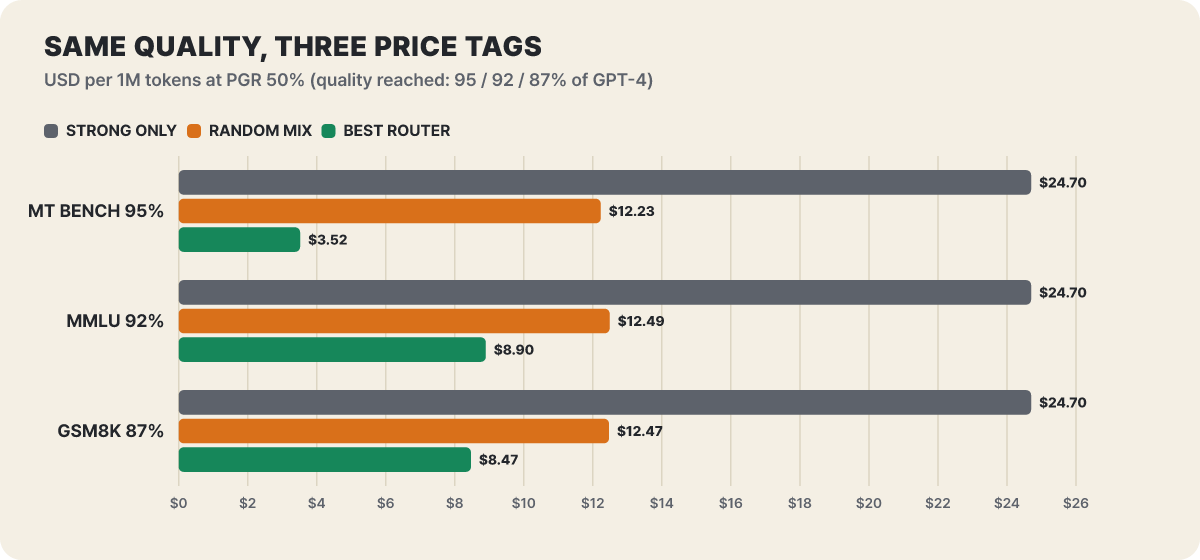 그림 2. 같은 품질 지점(PGR 50%)의 백만 토큰당 비용. 값은 논문 표 1~3의 CPT(50%)를 단가식에 넣은 편집부 계산
세 가지가 읽힙니다. 첫째, 강한 모델 단독 대비 절감은 MT Bench 85.8%, MMLU 64.0%, GSM8K 65.7%로 꽤 큽니다. LMSYS 블로그가 앞세운 “MT Bench 85% 이상”은 이 기준의 숫자입니다. 둘째, 그 절감의 상당 부분은 라우터가 없어도 얻을 수 있습니다. 무작위 섞기만으로도 세 시험 모두 12달러대로 내려가고, 라우터가 더 벌어 주는 몫은 MT Bench 71.2%, MMLU 28.7%, GSM8K 32.1%입니다. 셋째, 그래서 도입 효과를 따질 때는 “강한 모델만 쓸 때보다 얼마나 싼가”와 “그냥 섞을 때보다 얼마나 싼가”를 따로 적어야 합니다. 앞의 것은 모델 두 개의 단가 차이가, 뒤의 것은 판정기가 실제로 가려내는 능력이 만든 숫자입니다.
챗봇 100만 건이 한 달에 내는 돈
가정을 먼저 세웁니다. 쇼핑몰 챗봇이 한 달에 100만 건을 받고 건당 평균 1,000토큰이 오가면 총 10억 토큰, 백만 토큰 단위로 1,000개입니다. 단가는 앞의 24.7달러와 0.24달러를 그대로 쓰고, 라우터는 강한 모델에 13.4%를 보낸다고 둡니다. 이 비율은 논문에서 가장 잘 나온 MT Bench 값이라 쇼핑몰 질문에서 나온다는 보장이 없는 상한에 가까운 가정입니다.
- 전부 강한 모델: 1,000 × 24.7 = 24,700달러
- 라우터 적용: (0.134 × 24.7 + 0.866 × 0.24) × 1,000 = (3.310 + 0.208) × 1,000 = 3,518달러. 절감 21,182달러
- 약한 모델로 간 질문의 10%가 품질 미달로 강한 모델에 다시 간다고 가정(재요청): 강한 모델 비율이 13.4%에서 22.06%로 늘어 (0.2206 × 24.7 + 0.866 × 0.24) × 1,000 = 5,657달러. 재요청분은 약한 모델 호출 비용을 이미 낸 뒤라 약한 쪽 비용은 그대로 남습니다
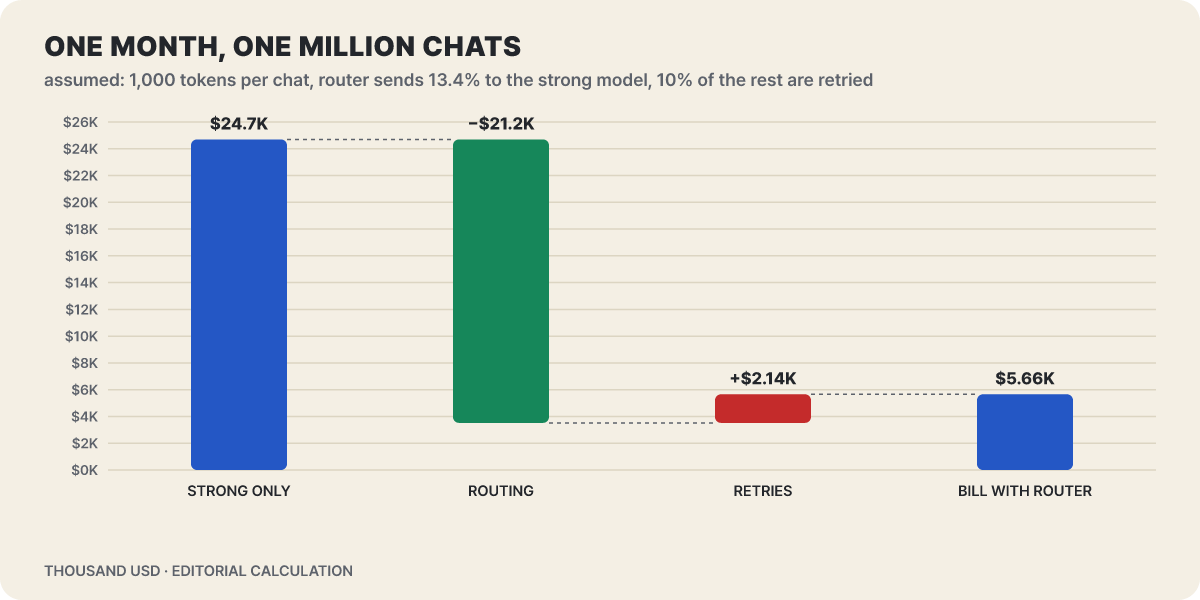 그림 3. 한 달 청구서. 금액은 천 달러 단위이고 모두 가정에 따른 편집부 계산
재요청 10%가 라우터를 붙인 최종 청구서의 38%에 해당하는 2,139달러를 되돌려 가져갑니다. 절감률은 85.8%에서 77.1%로 내려오지만 전부 강한 모델에 보내는 구성보다는 여전히 훨씬 쌉니다. 판정기 자체의 운영비는 청구서에 보이지 않을 만큼 작습니다. 논문이 GPU 한 장짜리 VM(시간당 0.8달러)에서 잰 값으로 행렬 분해 라우터는 백만 요청당 1.42달러, 초당 155건이고 가장 무거운 SW ranking(CPU 전용 VM)도 37.36달러, 초당 2.9건입니다. 이 청구서의 100만 건에는 1.42달러, 전체의 0.006%입니다.
손익분기는 두 방향에서 따져야 합니다. 돈만 보면 놀랍도록 느슨합니다. 약한 모델로 간 질문 중 몇 %를 강한 모델에 다시 보내야 라우터를 붙인 청구서가 전부 강한 모델의 청구서와 같아질까요? 식을 풀면 1 − 0.24 ÷ 24.7, 약 99%이고 라우팅 비율과도 무관합니다. 단가 격차가 100배인 이상 재요청이 거의 전부여도 돈으로는 지지 않습니다.
진짜 경계는 품질입니다. 라우터 때문에 생긴 추가 불량 답 한 건을 바로잡는 데 c달러가 든다면, 절감액을 c로 나눈 건수까지가 손익분기입니다. 위 재요청 포함 절감액 19,043달러로 계산하면 다음과 같습니다.
| 불량 답 1건을 바로잡는 비용(가정) | 손익분기 추가 불량 건수 | 100만 건 중 비율 |
|---|---|---|
| 0.5달러(자동 재시도·재질문) | 38,086건 | 3.81% |
| 2달러(상담원 짧은 개입) | 9,522건 | 0.95% |
| 10달러(상담원 처리·사과 쿠폰) | 1,904건 | 0.19% |
| 20달러(환불·분쟁 처리) | 952건 | 0.10% |
불량 하나의 값이 클수록 라우터에 허용되는 오판이 눈에 띄게 줄어듭니다. 환불 금액 계산처럼 한 건이 20달러짜리인 경로는 1,000건 안팎이 한계선이라서 라우터에 맡기기보다 강한 모델로 고정하는 편이 이득입니다. 반대로 배송 상태 조회처럼 틀려도 다시 물으면 되는 경로가 라우팅의 몫입니다. 여기서 불량 건수는 PGR 같은 점수와 직접 대응하지 않으므로 내 서비스에서 따로 세어야 합니다.
라우터가 이기는 시험과 못 이기는 시험
그림 1의 곡선은 MT Bench의 것입니다. 논문은 시험 세 개와 학습 데이터 두 가지, 라우터 네 종류를 모두 돌렸고, 그 24개 조합이 무작위 라우터(CPT 50 약 50%, CPT 80 약 80%)보다 어디에 있는지가 아래 그림입니다. 가로축은 CPT(50%), 세로축은 CPT(80%)이고 왼쪽 아래일수록 좋습니다.
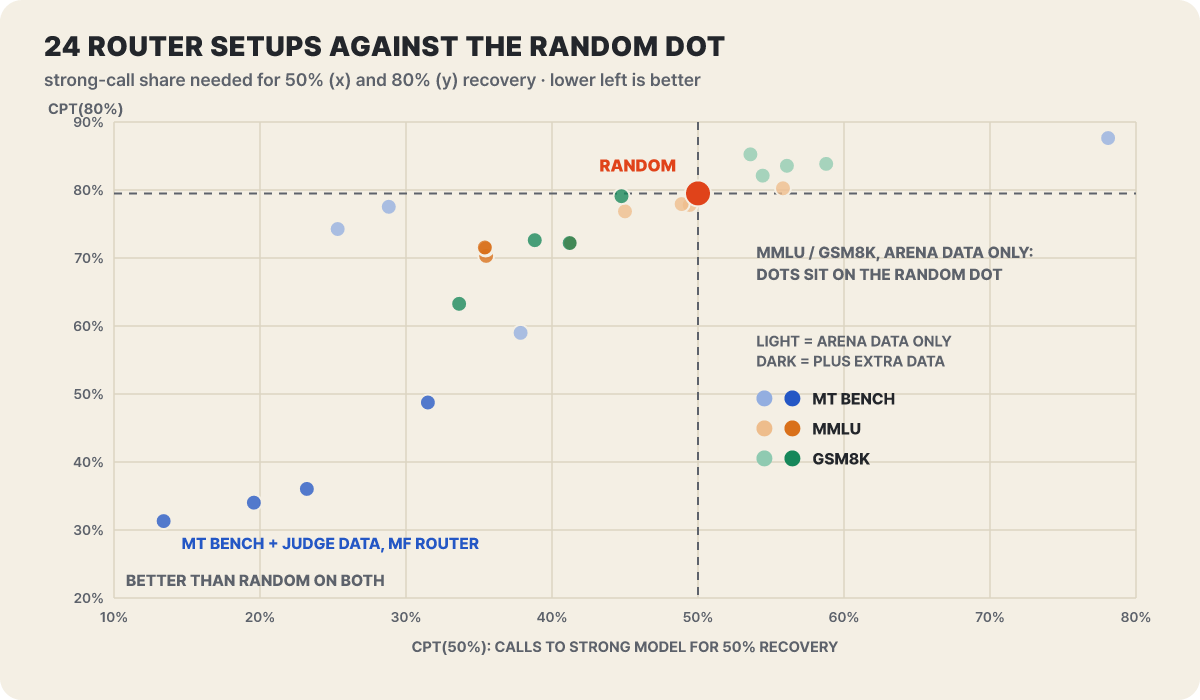 그림 4. 논문 표 1~3 전체. 연한 점은 Arena 데이터만, 진한 점은 보조 데이터를 더한 학습
점이 가장 왼쪽 아래에 있는 것은 MT Bench에 GPT-4 채점 기록을 더한 네 점으로 CPT(50%)가 13.431.5%입니다. 반면 MMLU와 GSM8K에서 Arena 데이터만으로 학습한 라우터는 무작위 점 둘레에 몰려 있습니다. MMLU의 CPT(50%)는 네 라우터가 45.055.8%로 무작위의 50.07%와 비슷하고, GSM8K는 53.6~58.8%로 무작위의 50.0%보다 나쁩니다. 같은 Arena 학습이어도 시험에 따라 결과가 뒤집힙니다.
보조 데이터가 점을 왼쪽으로 옮기는 폭도 두드러집니다. MMLU 검증 문제 약 1,500개(학습 데이터의 2% 미만)를 정답 라벨 그대로 더하자 세 라우터의 CPT(50%)가 35.4~35.5%로 내려왔고, GSM8K에 LLM 심판의 채점 기록을 더하자 가장 좋은 라우터가 33.6%까지 내려왔습니다. 논문은 학습 데이터와 시험 문제가 얼마나 닮았는지를 점수로 매겨(표 4) MT Bench 0.608에서 0.653, MMLU 0.482에서 0.568, GSM8K 0.493에서 0.534로 보조 데이터를 더할수록 유사도가 올랐다고 적었습니다. 닮을수록 라우터가 잘 가려낸다는 뜻이어서, 쇼핑몰 질문과 닮지 않은 Arena 투표로 학습한 판정기는 쇼핑몰에서 이 그림의 오른쪽 위에 놓일 수 있습니다.
라우터 종류도 갈립니다. MT Bench를 Arena 데이터로만 학습하면 행렬 분해는 CPT(50%) 25.32%인데 BERT 분류기는 78.09%로 무작위의 49.03%보다 나쁩니다. 다른 모델 쌍으로의 이식은 비교적 잘 됩니다. Claude 3 Opus와 Llama 3 8B로 바꿔 재학습 없이 MT Bench를 돌려도 행렬 분해(보조 데이터 포함)가 CPT(50%) 30.48%, CPT(80%) 41.81%를 냈습니다. 다만 논문이 다룬 것은 모델 두 개 사이의 선택이며, 저자들도 후보가 셋 이상인 경우를 다음 과제로 남겼습니다.
내 질문으로 곡선을 다시 그리는 순서
곡선이 시험마다 다르다면 내 서비스의 곡선은 내 질문으로 그려야 합니다. 라이브 트래픽에 붙이지 않고 로그만으로 할 수 있는 방식은 이렇습니다.
- 실제 질문 로그에서 쉬운 것과 어려운 것이 섞이도록 표본을 뽑는다. 개수는 편집부 권고로 200~300건이면 점이 흔들리지 않을 만큼이다.
- 각 질문을 강한 모델과 약한 모델 양쪽에 보내 답을 받아 둔다. 이 비용은 한 번만 든다.
- 두 답을 사람이나 심판 모델로 채점한다. 이 채점 기록이 곧 PGR의 분모와 분자다.
- 라우터가 질문마다 낸 점수(강한 모델이 이길 확률)로 질문을 줄 세운다. 상위 10%, 25%, 50%, 75%를 강한 모델에 보냈다고 치고 품질을 계산해 점 네다섯 개를 얻는다.
- 가로축을 단가식(0.24 + 24.46 × r)으로 돈에 환산해 곡선을 그린다. 무작위 섞기 직선과 얼마나 벌어지는지가 이 라우터의 값어치다.
RouteLLM으로 첫 줄을 그어 보는 명령은 저장소 README에 있습니다. 설치하고, 강한 모델 호출을 50%로 맞추는 임계값을 구하고, 같은 설정으로 평가를 돌립니다.
pip install "routellm[serve,eval]"

# 강한 모델 호출 50%에 해당하는 임계값 계산(공개 Chatbot Arena 데이터 기준)
python -m routellm.calibrate_threshold --task calibrate --routers mf --strong-model-pct 0.5 --config config.example.yaml
# 출력 예: For 50.0% strong model calls for mf, threshold = 0.11593

# MT Bench·MMLU·GSM8K에서 라우터 비교 평가 (결과 그래프가 현재 폴더에 생성됨)
python -m routellm.evals.evaluate --routers random sw_ranking bert --benchmark gsm8k --config config.example.yaml
README의 보정 예시는 같은 명령 아래에서 임계값을 0.11593이라고 출력하고 설명 문장에서는 0.1881이라고 적어 두 곳이 어긋납니다. 출력된 값을 쓰면 됩니다. 이 보정은 공개 Arena 데이터 기준이라, README도 받는 질문과 닮은 데이터로 다시 보정하라고 권합니다. 내 표본으로 같은 일을 하려면 4번처럼 점수 상위 몇 %가 강한 모델로 가는지를 직접 세야 합니다. 라우터를 추가하는 방법도 문서에 나와 있습니다. Router 클래스의 calculate_strong_win_rate 하나(질문을 받아 강한 모델의 승률을 돌려주는 함수)만 구현해 ROUTER_CLS에 등록하면 서버와 평가 도구에서 바로 쓸 수 있습니다.
Python에서는 OpenAI 클라이언트 자리에 컨트롤러를 끼웁니다. 모델 이름 규칙은 router-라우터이름-임계값입니다.
from routellm.controller import Controller

# 키는 환경 변수로 넣는다. mf, sw_ranking은 질문 임베딩용 OPENAI_API_KEY가 모델 쌍과 무관하게 필요하다
client = Controller(
    routers=["mf"],
    strong_model="gpt-4-1106-preview",
    weak_model="anyscale/mistralai/Mixtral-8x7B-Instruct-v0.1",
)
response = client.chat.completions.create(
    model="router-mf-0.11593",
    messages=[{"role": "user", "content": "주문 A105 어디까지 왔어요?"}],
)
서버 형태는 python -m routellm.openai_server --routers mf --strong-model … --weak-model …로 띄우고 6060번 포트로 앱의 주소만 바꿔 연결합니다. 모델 공급자는 LiteLLM을 거쳐 Ollama, Anthropic, Gemini, Amazon Bedrock, Together AI 등이 붙고, OpenAI 호환 엔드포인트는 모델 이름 앞에 openai/를 붙입니다.
곡선 위의 손잡이를 쥔 네 곳
같은 일을 하는 도구가 RouteLLM만은 아닙니다. 차이는 판정을 무엇으로 하고, 곡선 위의 어느 점에 설 것인지 정하는 손잡이가 어디 달려 있느냐입니다. 아래 그림은 같은 앱 앞에 네 가지를 놓은 모양으로, 위 세 개는 직접 운영하고 맨 아래는 호스팅 서비스입니다.
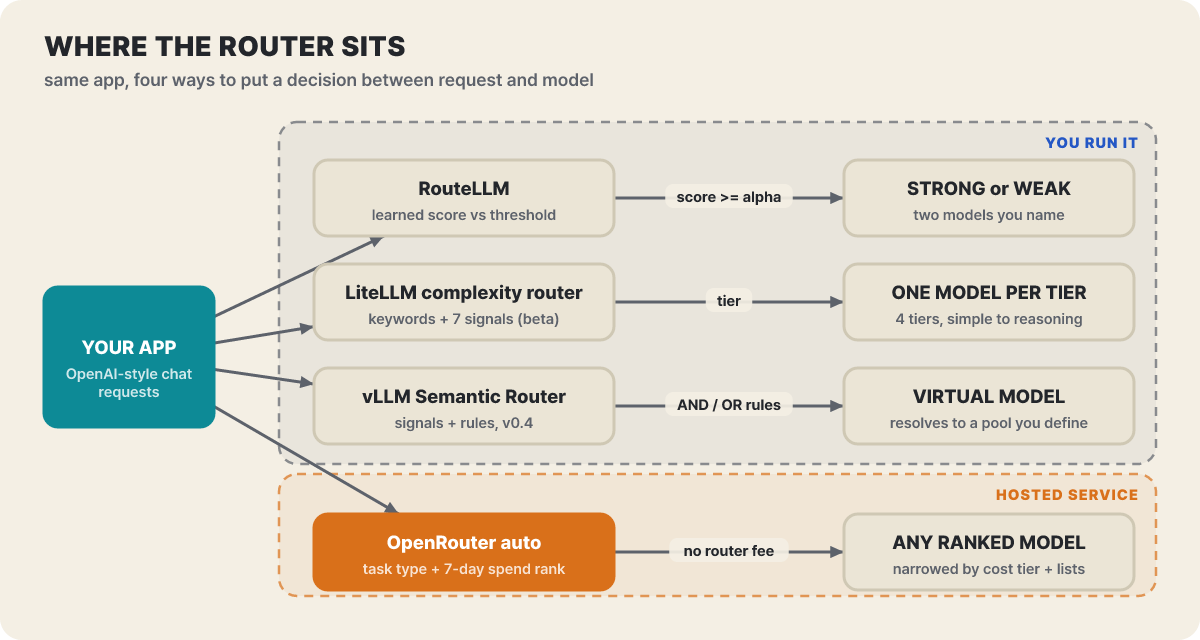 그림 5. 라우터를 놓을 수 있는 자리. 앱 쪽 코드는 요청 주소와 모델 이름이 바뀔 뿐 거의 그대로다
| 도구 | 손잡이 | 판정의 근거 |
|---|---|---|
| RouteLLM | 임계값 알파(router-mf-0.11593) |
선호도 데이터로 학습한 점수 |
| OpenRouter 자동 라우터 | cost_tier(low~max), 허용·제외 목록 |
작업 유형별 최근 7일 이용 순위 |
| LiteLLM 복잡도 라우터 | 티어별 모델 지정 | 키워드와 일곱 차원 휴리스틱 점수 |
| vLLM Semantic Router | 결정 규칙, 가상 모델 | 여러 신호를 AND/OR/NOT 규칙으로 결합 |
RouteLLM은 2024년 6월 3일 저장소가 만들어졌고 논문이 같은 달에 나왔으며, LMSYS 블로그 소개가 7월 1일, 논문은 ICLR 2025 포스터로 실렸습니다. 저장소는 Apache-2.0이고 별 5,636개, 포크 448개, 열린 이슈 45개(2026년 10월 27일 조회)이며 마지막 push가 2024년 8월 10일(UTC)로 릴리스 항목이 없습니다. 내장 라우터는 GPT-4 1106 preview와 Mixtral 8x7B 쌍으로 학습되어 있어서 요즘 모델 쌍에는 구조와 평가 방법을 빌리고 판정기는 내 데이터로 다시 만드는 쪽이 현실적입니다.
OpenRouter는 여러 회사의 모델을 한 API로 파는 서비스이고 openrouter/auto라는 자동 라우터가 있습니다. 가벼운 분류기가 프롬프트를 약 30개 작업 유형(code:debugging, math, customer_support 등) 중 하나로 가르고, 그 유형에서 최근 7일간 이용자 지출 비중이 높은 모델 순으로 줄을 세운 뒤 비용 등급과 허용 목록을 거쳐 남은 상위 모델을 주 모델과 대체 모델로 정합니다. 판정에 쓰는 신호가 학습된 승률이 아니라 다른 이용자들의 선택이라는 점이 RouteLLM과 가장 다릅니다. 라우터 자체에 추가 요금은 없고 선택된 모델의 표준 요금만 청구됩니다. 분류나 순위를 불러오지 못하면 실패하지 않고 기본 모델 집합으로 응답합니다. 설정은 요청의 plugins 배열에 넣습니다.
{
  "model": "openrouter/auto",
  "plugins": [
    {
      "id": "auto-router",
      "allowed_models": ["anthropic/*", "openai/*"],
      "excluded_models": ["openai/gpt-4o"],
      "cost_tier": "medium"
    }
  ],
  "messages": [{ "role": "user", "content": "주문 A105 취소하면 환불액이 얼마예요?" }]
}cost_tier는 low, medium, high, xhigh, max 중 하나이고 상한선이 아니라 해당 등급의 범위여서 더 싼 모델도 더 비싼 모델도 후보에서 빠집니다. 설정을 아예 보내지 않으면 low에 가깝게 라우팅됩니다. 허용 목록을 먼저 적용하고 제외를 나중에 적용하므로 제외가 항상 이기며, 둘 다 걸려 후보가 하나도 안 남으면 404 오류와 “No models match your request and model restrictions”가 돌아옵니다. 응답의 model 필드에 실제로 쓰인 모델이 담기고, 요청에 X-OpenRouter-Metadata: enabled 헤더를 보내면 분류된 작업 유형도 응답 메타데이터에서 볼 수 있습니다. 베타 트랙 openrouter/auto-beta는 플러그인 ID가 auto-beta-router로 달라서 각 슬러그가 자기 ID의 설정만 읽고 다른 쪽은 조용히 무시합니다.
LiteLLM의 복잡도 라우터는 프록시에 설정하는 베타 기능입니다. 질문을 SIMPLE, MEDIUM, COMPLEX, REASONING 네 티어 중 하나로 나누고 티어마다 모델 하나(또는 모델 목록)를 지정합니다. 기본 판정은 토큰 수, 코드 유무, 추론 표지, 기술 용어, 단순 표지, 다단계 패턴, 질문 복잡도 일곱 차원의 휴리스틱 점수이고 LLM 호출이 없어서 1,000분의 1초 미만으로 끝납니다. 추론 표지가 둘 이상이면 점수와 상관없이 REASONING으로 갑니다. 임베딩을 호출하던 예전 시맨틱 라우터는 폐기 예정으로 표시되어 있고 호출마다 100~500ms가 든다고 적혀 있습니다.
vLLM Semantic Router는 변화가 가장 빨랐습니다. 2026년 1월 5일 v0.1이 나온 뒤 3월 10일 v0.2.0, 6월 5일 v0.3.0을 거쳐 9월 24일 블로그로 소개된 v0.4 “Hermes”(릴리스는 9월 27일, 982개 커밋·기여자 130명)에 이르렀고 저장소 별은 6,266개입니다. v0.4는 앱이 가상 모델 이름 하나만 부르면 라우터가 자격을 갖춘 후보 풀에서 백엔드를 고르는 구조를 내세웁니다. Blend, Lite, Flash, Ultra, Vault 다섯 가지 목적의 레시피가 있고, 결정 규칙은 AND/OR/NOT과 티어, 우선순위·신뢰도 순위로 짜며 응답 캐시 같은 플러그인이 붙습니다. 이 도구들은 곡선을 그려 주는 것이 아니라 곡선 위의 점을 정하는 부품이어서, 그림 1의 방식으로 내 질문에서 재 보는 단계는 어느 도구를 고르든 남습니다. 학습된 라우터를 호스팅으로 쓰고 싶다면 Not Diamond처럼 사전 학습 라우터나 내 데이터로 학습한 맞춤 라우터를 Python·TypeScript·REST SDK로 쓰는 서비스도 있습니다.
RouteLLM(직접 운영)
- 손잡이는 임계값 하나, 곡선 위 점을 숫자로 고른다
- 내 질문으로 재보정·재학습이 가능하다
- 서버 운영비와 모델 요금이 든다
- 판정 근거를 내 데이터로 바꿀 수 있지만 모델 두 개 사이만 다룬다
OpenRouter 자동 라우터(호스팅)
- 손잡이는 비용 등급과 허용·제외 목록이다
- 판정 기준을 고칠 수는 없고 후보를 묶어 조절한다
- 모델 요금만 든다. 라우터 추가 요금 없음
- 후보가 여럿이고 직전 모델을 우선하며, 결과는 응답의 모델 이름으로 확인한다
곡선 밖에서 새는 비용
곡선과 청구서만으로 보이지 않는 비용을 마지막으로 모았습니다. 앞의 계산이 모두 성립해도 아래에서 새면 그림 3의 숫자는 어긋납니다.
- 임베딩 호출의 개인정보 경로.
mf와sw_ranking은 판정 때마다 질문 텍스트를 임베딩으로 바꾸는데, README는 모델 쌍과 무관하게 OpenAI API 키가 필요하다고 밝히고 논문은 text-embedding-3-small을 썼습니다. 개인정보가 섞인 질문이라면 이 호출이 어디로 가는지가 점검 대상이고, 이를 피하려면 임베딩을 쓰지 않는bert나causal_llm계열을 보게 됩니다. 단 CPT 표에서 BERT는 Arena 전용 학습의 MT Bench에서 무작위보다 나빴습니다. - 한 대화 안에서 모델이 바뀌는 문제. RouteLLM은 호출마다 판정하므로 같은 대화에서도 모델이 바뀌어 말투와 기억이 어긋날 수 있습니다. OpenRouter는 직전에 쓴 모델을 기억해 다음 턴에도 우선하되 매 턴 순위를 다시 계산해 여전히 상위일 때만 유지합니다. 어느 쪽이든 응답의 모델 이름을 로그로 남겨야 어긋난 대화를 추적할 수 있습니다.
- 허용 목록이 비어 있는 호스팅 라우터. OpenRouter는 허용 목록이 비어 있으면 순위에 오른 모델 전부가 후보입니다. 개인정보 처리 위치나 계약상 쓸 수 없는 모델이 있다면 허용 목록으로 먼저 묶어 두고, 제한 때문에 후보가 비어 404가 나는 경우의 처리 경로도 앱에 정해 둡니다.
- 재요청의 은밀한 가산. 그림 3에서 재요청 10%가 최종 청구서의 38%를 가져갔습니다. 약한 모델의 답을 앱이 검증하지 않으면 재요청은 사용자의 “다시 물어보기”로 나타나서 청구서에도 로그에도 라우팅 탓으로 묶이지 않습니다. 모델 이름과 재질문 여부를 함께 기록해야 이 몫이 보입니다.
- 폴백과 라우팅의 혼동. OpenRouter의
models배열은 첫 모델이 컨텍스트 길이 초과, 속도 제한, 장애로 실패할 때 다음 모델로 넘어가는 장치입니다. 비용을 줄이려고 고르는 것이 아니고 실제로 처리한 모델의 요금이 청구되므로, 청구서에서 라우팅의 선택과 폴백의 대체를 나눠 읽어야 합니다. - 보정의 유통기한. 임계값은 질문 분포와 모델 단가에 묶여 있습니다. 단가가 바뀌거나 약한 모델을 새 버전으로 바꾸면 곡선이 이동하므로, 그림 1의 재측정은 한 번으로 끝나지 않고 모델 쌍이 바뀔 때마다 돌아옵니다. 내장 라우터가 2024년의 모델 쌍으로 학습된 RouteLLM에서 특히 그렇고, 계약상 쓸 수 있는 모델이 처음부터 하나뿐인 서비스라면 곡선을 그릴 필요 자체가 없습니다.



