파일을 뒤지는 대신 그래프에 물어보게 하는 Graphify
Graphify가 만드는 그래프를 겉에서 속으로 뜯어 봅니다. 노드·연결선·꼬리표(EXTRACTED·INFERRED)와 점수 다섯 칸, 입력별 처리 경로, 질의 명령, 갱신, 기록, 벤치마크 읽는 법까지 담았습니다.
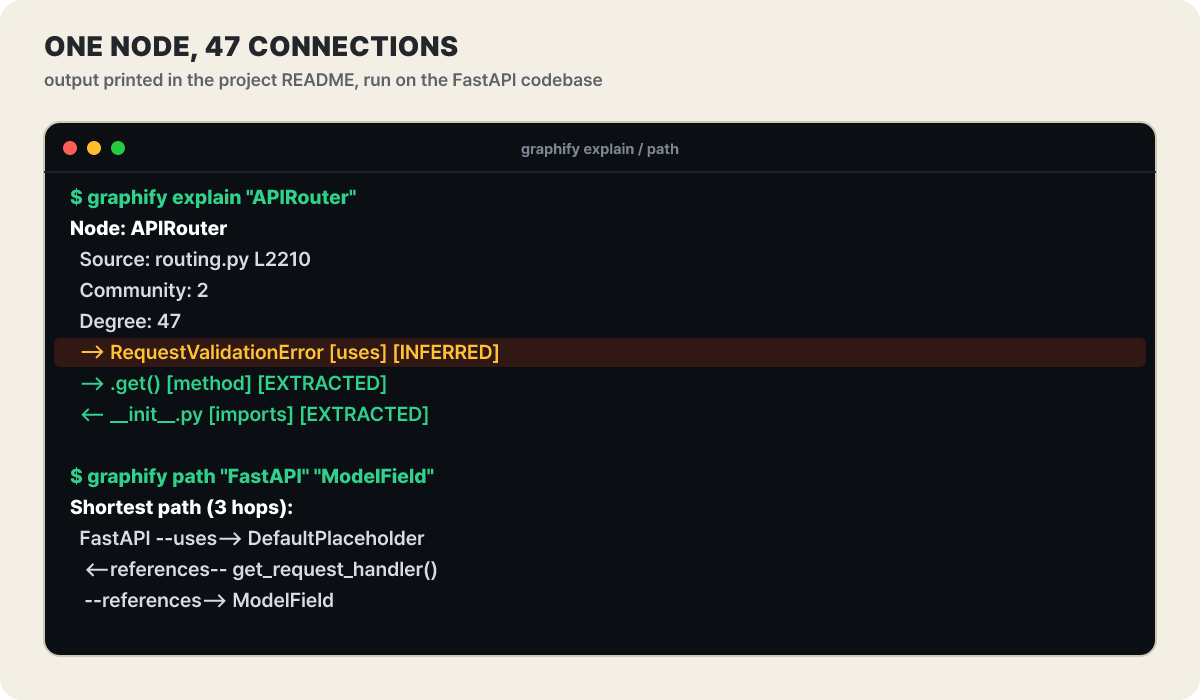 그림 1. Graphify README에 실린 실제 출력. FastAPI 저장소로 만든 그래프에서 노드 하나를 설명하고, 두 노드 사이의 경로를 찾는다
위 화면은 Graphify가 에이전트에게 내주는 답의 전부입니다. 파일 내용이 아니라 이름 하나와 위치 하나(routing.py L2210), 소속 커뮤니티 번호, 연결 개수(Degree: 47), 그리고 연결선 목록입니다. 화살표 방향은 누가 누구를 부르거나 가져오는지를 뜻하고, 줄 끝의 꼬리표는 그 사실을 어떻게 알았는지를 말합니다. 노란 줄의 uses는 해석해서 이은 관계(INFERRED), 초록 줄의 .get()과 imports는 소스에 그대로 적힌 관계(EXTRACTED)입니다. 아래 경로 질의는 FastAPI에서 ModelField까지 세 번 건너뛰는 길을 찾았고, 중간 화살표 방향이 한 번 뒤집혀 있다는 점이 눈에 띕니다. 이 글은 이 출력 한 조각을 부품 단위로 뜯어, 무엇으로 이루어졌고 어디까지 믿어도 되는지 확인하는 순서로 진행합니다. Graphify Labs가 Apache-2.0으로 공개한 오픈소스이고, 코딩 에이전트 안에서 /graphify로 부르거나 터미널의 graphify 명령으로 씁니다. 2026년 10월 27일(UTC) 기준 PyPI 최신판은 10월 26일 15:18에 올라온 0.9.96이고, 4월 4일 첫 업로드(0.1.1) 이후 릴리스는 264개입니다. 저장소 별은 135,857개, 포크는 12,959개입니다.
노드, 연결선, 방향, 커뮤니티: 그래프에 든 것을 세어 보면
그래프의 부품은 넷으로 나뉩니다. 이름과 쓰임을 표로 먼저 놓고, 그림 1의 어느 줄이 어느 부품인지 짚습니다.
| 부품 | 무엇인가 | 그림 1에서 |
|---|---|---|
| 노드 | 개념 하나. 종류는 코드, 문서, 논문, 이미지, 근거(rationale) 다섯 가지이고 레이블과 소스 파일·줄 번호를 가진다 | APIRouter, Source: routing.py L2210 |
| 연결선 | 노드 둘을 잇는 관계. calls, imports, inherits, mixes_in, uses, references, method, semantically_similar_to 등 |
[uses], [method], [imports] |
| 방향 | A calls B와 B calls A는 서로 다른 관계로 저장된다 |
출력 줄 앞의 오른쪽·왼쪽 화살표 |
| 커뮤니티 | 서로 촘촘히 이어진 노드 무리. Leiden 알고리즘으로 나누고 이름은 모델 없이 붙인다 | Community: 2 |
노드 쪽에는 이름이 따로 붙는 것이 둘 있습니다. 연결이 가장 많은 개념은 핵심 노드(god node)라 부르는데, 그림 1의 APIRouter가 연결 47개로 그런 자리에 있습니다. 근거 노드는 코드 주석의 # NOTE:, # WHY:와 ADR·RFC 인용에서 만들어져 해당 코드에 이어집니다. 연결선 쪽에는 노드 셋 이상을 한꺼번에 묶는 하이퍼엣지가 따로 저장됩니다. 저장 형식은 NetworkX의 node-link 구조이고, 파일 안에 스키마 버전과 생성한 Graphify 버전이 기록됩니다. 문서는 필드가 추출기와 릴리스마다 다를 수 있으니 필요한 필드만 읽고, 모든 노드가 함수라거나 모든 연결선에 줄 번호가 있다고 가정하지 말라고 안내합니다.
크기 감각도 하나 잡아 둘 만합니다. 벤치마크 문서는 100만 줄 규모의 파이썬 저장소 ERPNext를 2011년 6월부터 2026년 6월까지 주간 체크포인트 689개로 그려 보았는데, 모델을 쓰지 않는 구문 분석만으로 첫 체크포인트는 노드 3,069개·연결선 2,900개, 마지막은 노드 22,620개·연결선 48,710개였습니다. 15년 동안 노드는 약 7배, 연결선은 약 17배 늘었습니다. 노드보다 연결선이 빨리 느는 것은 프로젝트가 커질수록 부품끼리 얽히는 정도가 더 가파르게 올라간다는 뜻으로 읽힙니다.
함수 세 개짜리 폴더를 그래프로 바꾸는 다섯 줄
작은 예로 직접 보는 편이 빠릅니다. 공식 첫 그래프 가이드는 파일 하나짜리 파이썬 프로젝트를 쓰고 API 키도 요구하지 않습니다. 빈 폴더에 app.py를 만듭니다.
def normalize_email(email: str) -> str:
    return email.strip().lower()


def find_user(email: str) -> dict:
    return {"email": normalize_email(email)}


def login(email: str) -> dict:
    return find_user(email)
uv tool install graphifyy로 설치한다(pipx install graphifyy도 된다. 패키지 이름의 y가 두 개인 점에 주의)- 같은 폴더에서 코드만 추출한다.
graphify extract . --code-only - 모델 없이 묶고 화면을 만든다.
graphify cluster-only . --no-label, 이어서graphify export html graphify path "login" "normalize_email"로 묻는다. 가이드가 기대하는 답은login에서find_user를 거쳐normalize_email에 닿는 경로다- 코드를 한 줄 고치고
graphify update .로 갱신한 뒤 같은 질문을 다시 던져 연결이 바뀌는지 비교한다
그림 2는 이 폴더가 그래프에서 어떤 모양이 되는지 그린 것입니다. 초록 영역의 세 함수와 두 개의 calls 연결선은 위 튜토리얼에서 나오는 구조이고, 오른쪽 노란 영역의 문서 노드와 점선 연결선은 꼬리표 세 종류를 한 화면에 보이려고 편집부가 얹은 가상의 예입니다.
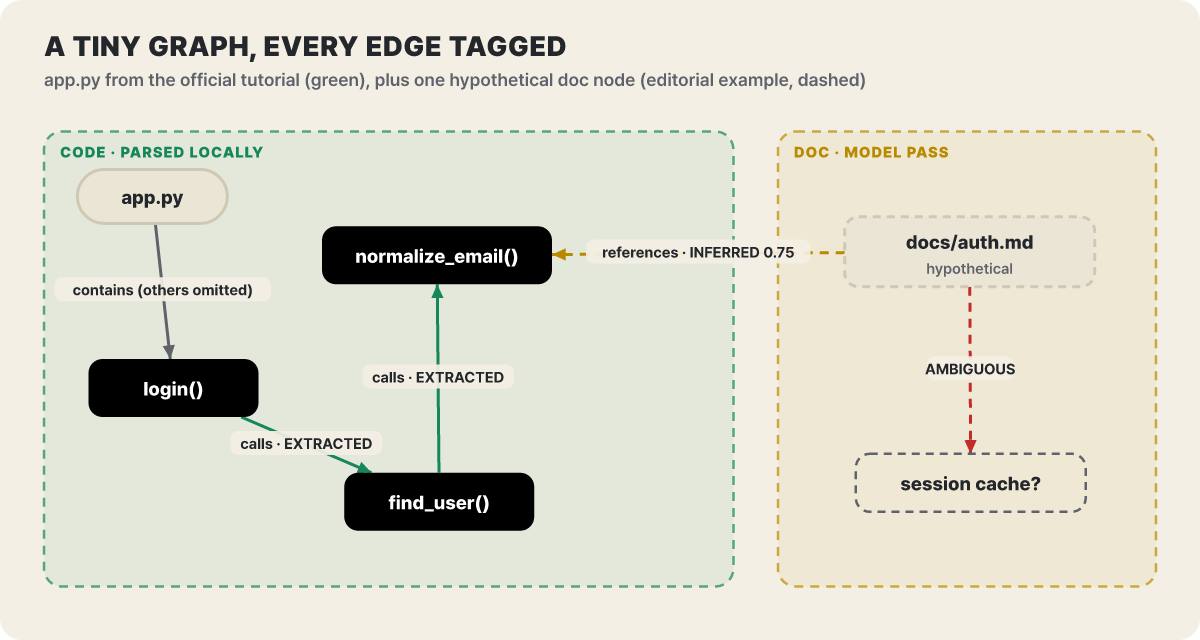 그림 2. 코드 영역은 구문 분석만으로 만들어져 EXTRACTED가 붙고, 문서 영역은 모델이 읽은 뒤 점수나 AMBIGUOUS가 붙는다(문서 노드는 편집부의 가상 예)
그림에서 연결선의 색과 모양이 곧 신뢰의 수준입니다. 실선 초록은 소스에서 곧바로 읽은 사실이고, 점선은 해석이나 보류입니다. 코드 영역 안에서도 INFERRED가 생기는 경우가 있는데, 뒤 절에서 다룹니다.
연결선 꼬리표 셋과 점수 다섯 칸
Graphify에서 가장 쓸 만한 설계는 모든 연결선이 “어떻게 알았나”를 달고 있다는 점입니다. 공식 문서의 정의는 이렇습니다.
- EXTRACTED: 분석한 소스에 관계가 명시되어 있다. 신뢰도 1.0으로 고정되고 소스 위치를 따라가 확인할 수 있다
- INFERRED: 이름이나 import를 풀어서, 또는 의미 분석으로 도출한 관계. 모델 없이 정적 해석만으로도 생긴다. 근거와 점수를 보고 받아들일지 정한다
- AMBIGUOUS: 근거가 하나의 관계를 정하지 못한다. 보고서에 표시되고 사람이 소스를 직접 봐야 한다
INFERRED를 “모델이 지어낸 것”으로 읽으면 곤란합니다. 점수는 연속값이 아니라 다섯 칸으로 떨어집니다.
| 점수 | 붙는 경우 |
|---|---|
| 0.95 | 파일 사이의 명시적 참조가 있고 그럴듯한 대상이 하나뿐 |
| 0.85 | 이름과 문맥이 맞아떨어진다 |
| 0.75 | 문맥상 합리적이지만 명시되지는 않았다 |
| 0.65 | 이름이 비슷하다는 것뿐 |
| 0.55 | 추측 |
이 기준이 느슨해지지 않게 하는 수정이 릴리스마다 들어옵니다. 10월 23일의 0.9.95는 같은 모듈을 import했다는 이유만으로 이름이 같은 심볼에 닿은 호출을 EXTRACTED로 올려 주지 않고 INFERRED로 남기게 고쳤습니다. 같은 이름의 함수가 두 파일에 있을 때 엉뚱한 쪽을 확정으로 표시하지 않으려는 변경입니다. 10월 26일의 0.9.96에서는 파이썬의 run() 호출이 이름 모양만 비슷한 _run()에 붙지 않고 철자 그대로의 메서드에 붙게 되었고, 생성자로 주입받은 필드를 거치는 호출은 대상이 하나로 정해질 때에 한해 INFERRED로 이어집니다.
그러면 INFERRED는 얼마나 맞을까요. 벤치마크 문서에는 날짜가 붙은 표본 점검 하나가 실려 있습니다. FastAPI의 fastapi/ 폴더 안에서 출발점과 도착점이 모두 있는 파일 간 INFERRED 연결선을 10월 5일에 수동으로 전부 확인했더니 12개가 모두 맞았습니다. 문서 스스로 지속 측정이 아니라 한 번의 점검이라고 밝히고, 테스트 폴더에 같은 이름의 보조 함수가 많으면 calls 쪽이 더 시끄러워진다고 덧붙입니다. 12개는 정확도를 말하기엔 작은 수이지만, 꼬리표가 의도대로 작동하는 사례로는 읽을 만합니다.
입력마다 다른 길: 코드는 남고 문서는 나간다
그래프를 만드는 경로는 입력 종류에 따라 셋으로 갈립니다. 이 구분이 비용과 반출을 모두 정합니다.
- 코드는 tree-sitter 구문 분석으로 약 40개 언어의 함수·클래스·import·호출을 로컬에서 뽑는다. 모델은 쓰지 않는다. 0.9.95부터는 YAML도 키 구조를 코드처럼 뽑아 쿠버네티스 매니페스트나 CI 설정이 노드로 들어온다
- 영상·음성은 faster-whisper로 로컬에서 받아쓰고, 결과를 캐시한다
- 문서·PDF·이미지는 모델이 개념과 관계를 뽑는다. 조각을 병렬로 나눠 처리한 뒤 하나로 병합한다. PDF는
pdf, Word·Excel은office, 영상·음성은video선택 패키지가 있어야 한다
코드만 있는 폴더는 세 번째 길이 통째로 생략됩니다. 그래서 API 키 없이 오프라인으로 그래프가 만들어지고, README가 내세우는 “그래프 생성에 드는 LLM 크레딧 0”은 이 경우를 가리킵니다. 문서가 섞이면 그 부분만 모델이 맡습니다. 에이전트 안에서 /graphify를 쓰면 그 세션의 모델이, 터미널의 graphify extract에서는 환경 변수에 있는 키의 제공자가 일합니다. 제공자는 자동으로 고르는데 우선순위가 Gemini, Kimi, Claude, OpenAI, DeepSeek, Azure, Bedrock, Ollama 순이라서, 키가 여러 개 환경에 있으면 의도하지 않은 제공자가 선택될 수 있습니다. 다행히 무엇이 선택됐는지 변수 이름을 출력하고, 직접 정하려면 –backend나 GRAPHIFY_BACKEND를 씁니다. Claude Code가 설치돼 있다면 claude-cli 백엔드로 API 키 없이 구독을 쓰는 길도 있습니다.
문서를 모델로 보내기 곤란하다면 끄는 방법이 셋 있습니다. –code-only는 코드만 처리하고, GRAPHIFY_BACKEND=none은 모든 모델 백엔드를 끕니다. 문서 의미까지 필요하되 밖으로 나가면 안 된다면 –backend ollama로 의미 추출을 로컬에서 돌립니다. 같은 내용의 파일은 SHA256 지문으로 구분해 캐시하므로 다시 실행해도 바뀌지 않은 파일은 건너뜁니다. 사용 추적과 분석은 하지 않는다고 README가 밝힙니다.
graphify-out 폴더 열어 보기
실행이 끝나면 프로젝트 안에 graphify-out/이 생깁니다. README가 약속하는 파일은 셋이고, 나머지는 작동에 필요한 부속입니다.
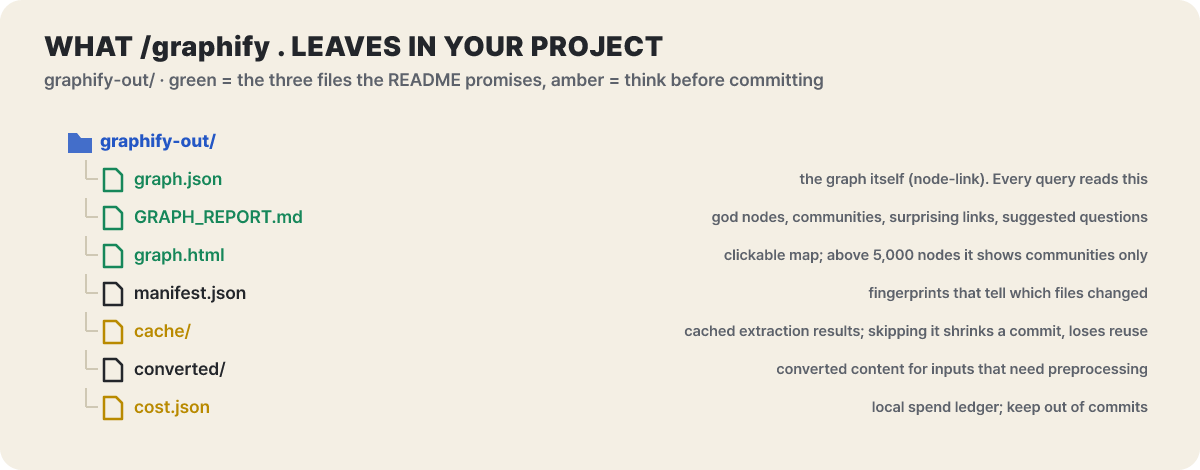 그림 3. 질의가 읽는 것은 graph.json 하나이고, 나머지는 사람이 보는 요약과 갱신용 부속이다
graph.json이 질의의 원천이라서 이 파일만 있으면 소스를 다시 읽지 않고 질문할 수 있습니다. graph.html은 노드가 5,000개를 넘으면 커뮤니티 단위로 요약해 보여 줍니다. GRAPH_REPORT.md는 핵심 노드, 커뮤니티 구성, 뜻밖의 연결, 추천 질문을 정리한 것으로, 넓은 구조를 파악할 때만 읽고 개별 질문은 범위를 좁힌 질의로 하라는 것이 상시 안내의 방침입니다. 그림에서 노란색으로 표시한 두 파일은 공유 전에 생각할 것들입니다. cost.json은 로컬 비용 기록이라 커밋에서 빼라고 권하고, cache/는 저장소 크기를 줄이려고 제외할 수 있지만 그러면 다음 실행에서 캐시 재사용이 줄어듭니다.
브랜치를 여러 개 쓰거나 워크트리를 나눠 작업한다면 환경 변수 GRAPHIFY_OUT으로 출력 폴더를 워크트리마다 다르게 지정하세요. 문서가 직접 권하는 방법이고, 여러 브랜치가 한 graphify-out/에 쓰면 서로의 그래프를 덮어씁니다.
query, explain, path는 서로 다른 질문이다
세 명령은 질문의 모양이 다릅니다. 그림 1은 이 중 둘을 실제로 보여 준 것입니다.
| 명령 | 던지는 질문 | 알아 둘 옵션 |
|---|---|---|
query |
“인증과 세션 저장은 어떻게 이어지나” 같은 개념 하나의 이웃 모으기 | 기본은 너비 우선, –dfs는 깊이 우선. –budget(출력 토큰 예산, 기본 2000), –context call(호출 관계만), –graph(다른 그래프 파일) |
explain |
이 노드는 무엇인가 | 소스 위치, 커뮤니티, 들어오고 나가는 연결 |
path |
둘은 어떻게 이어지나 | 저장된 방향을 따른다. 방향 없이 연결성만 보려면 –undirected |
이름이 여러 노드에 걸리면 Graphify는 추측하지 않고 후보를 보여 주며 거절합니다. 스크립트가 구분할 수 있도록 종료 코드가 갈립니다. 0은 답이 나온 경우, 3은 이름이 모호한 경우, 4는 일치하는 노드가 없는 경우입니다.
답을 해석할 때 지킬 한계가 둘 있습니다. 첫째, 경로가 있다고 해서 실행 중에 그 길로 지나간다는 뜻은 아닙니다. 소스 수준의 관계일 뿐이라 조건부 호출이나 동적 호출은 드러나지 않을 수 있습니다. 둘째, 경로가 없다고 해서 두 개념이 독립이라는 증거도 아닙니다. 그래프에 관계가 빠져 있을 수 있기 때문입니다. query의 결과도 검증된 답이 아니라 그래프 문맥이고 해석은 에이전트가 합니다. 그래서 문서는 에이전트에게 근거와 불확실성까지 같이 달라고 요청하라고 권합니다. 구현 세부가 중요하면 explain의 요약에 기대지 말고 소스를 직접 열어 보라는 것도 공식 안내입니다.
에이전트가 grep보다 먼저 그래프를 열게 하는 장치
그래프가 있어도 에이전트가 습관대로 grep부터 하면 소용이 없습니다. Graphify는 세 가지를 둡니다. graphify install이 쓰는 어시스턴트를 감지해 /graphify 스킬을 등록하고(20종이 넘는 어시스턴트를 지원), 상시 안내를 켜는 graphify claude install 같은 명령이 있으며, 선택적으로 MCP 서버가 있습니다. 상시 안내의 방식은 플랫폼마다 다릅니다. Claude Code와 Gemini CLI는 검색성 도구 호출 앞에서 훅이 그래프를 먼저 보라는 문구를 덧붙이고, Claude Code용 훅은 Read·Glob으로 소스를 하나씩 읽기 전에도 같은 안내를 합니다. Codex·Cursor 같은 곳은 AGENTS.md나 규칙 파일이 같은 역할을 합니다. 훅은 도구 호출을 막지 않고 안내 문맥만 덧붙입니다.
이 안내문에 최근 바뀐 부분이 있습니다. 0.9.96은 훅의 문구를 명령형이 아닌 사실 서술로 고쳤는데, 명령조 문구가 에이전트에게 프롬프트 주입처럼 읽혀 무시되던 문제 때문이라고 변경 기록에 적혀 있습니다. 안내 문구의 어조가 에이전트의 순응 여부를 좌우한 셈입니다.
스킬 대신 도구 호출로 이으려면 MCP 서버를 씁니다. 도구는 10개이고, 연결을 확인할 때는 graph_stats를 먼저 호출한 뒤 query_graph로 묻습니다.
uv tool install "graphifyy[mcp]"
claude mcp add --transport stdio graphify -- graphify-mcp /절대경로/repo/graphify-out/graph.json
그래프 경로는 절대 경로여야 합니다. GUI 클라이언트는 작업 디렉터리가 달라질 수 있기 때문입니다. 스킬과 MCP를 함께 쓰면 어느 그래프를 질의하는지 정하고 한쪽을 주 경로로 삼으라고 README가 안내하며, 같은 지침을 AGENTS.md에 두 벌 복사하면 서로 충돌합니다.
지도가 낡는 속도와 갱신 세 가지
그래프는 저장된 파일일 뿐이라 소스를 바꾸고 갱신하지 않으면 현재 코드와 어긋난 답을 냅니다. 갱신 방법은 세 가지입니다.
| 방법 | 언제 | 알아 둘 점 |
|---|---|---|
graphify update . |
코드를 고친 뒤 직접 | 바뀐 파일만 다시 추출. 0.9.96부터 입력이 그대로면 추출 파이프라인을 통째로 건너뛰고 산출물을 건드리지 않는다. 에이전트 채팅에서는 /graphify . –update |
graphify watch . |
파일 변경을 계속 반영 | watch 선택 패키지 필요. 한 번의 재빌드는 GRAPHIFY_REBUILD_TIMEOUT(기본 600초)로 묶여 멈춘 재빌드가 감시를 붙잡지 않는다 |
graphify hook install |
커밋·브랜치 전환마다 자동 | 백그라운드 실행이라 커밋 직후 질의하면 잠시 이전 그래프. git pull·merge 뒤에는 graphify update .를 직접 |
코드 경로와 문서 경로의 갱신은 따로 돕니다. 코드만 update해도 바뀐 문서의 의미 그래프까지 새로 만들어지지는 않으므로, 문서 변경까지 반영하려면 /graphify . –update를 씁니다. 대규모 리팩터링으로 그래프가 크게 줄면 도구가 기존 그래프를 덮어쓰지 않도록 경고하고, 의도한 삭제일 때만 –force로 허용합니다.
처음 스캔을 깔끔하게 하는 요령도 문서에 있습니다. .gitignore는 기본으로 존중하고, .graphifyignore에 node_modules/, dist/, coverage/, *.generated.py 같은 것을 적습니다. 확장자가 여러 언어로 쓰이는 저장소(.inc, .h, .m)라면 .graphifyrc에 language.inc=php처럼 선언해야 합니다. 그렇지 않으면 파일이 오류 없이 엉뚱한 언어로 파싱되어 노드 몇 개만 나옵니다. 그래프는 채워진 것처럼 보이는데 정작 심볼이 빠지는 조용한 실패이고, 그래프의 노드 수가 예상보다 적게 느껴질 때 먼저 의심할 곳입니다.
기록에 남는 것: 질의 로그와 그래프 파일
질문을 던질 때 흔적이 어디에 남는지도 알아 둘 부분입니다. README의 개인정보 절에는 query·path·explain과 MCP 호출이 ~/.cache/graphify-queries.log에 기록된다고 적혀 있습니다. 그런데 변경 기록과 코드는 다르게 말합니다. 7월 12일의 0.9.13부터 이 로그는 기본 꺼짐입니다. 기본값이 켜져 있어 질문과 코퍼스 경로를 저장소 밖의 평문 파일에 쌓던 것이 on-device·무추적 방침과 어긋난다는 지적에서 바뀌었고, 현재 코드도 같습니다. 켜려면 GRAPHIFY_QUERY_LOG_ENABLE=1(기본 경로) 또는 GRAPHIFY_QUERY_LOG=경로를 주고, 응답 전문까지 남기는 GRAPHIFY_QUERY_LOG_RESPONSES=1은 따로이며, GRAPHIFY_QUERY_LOG_DISABLE=1은 어떤 설정보다 우선해 끕니다. 켜 둔다면 질문에 비밀 값을 적지 않는 것이 좋습니다.
그래프 파일 자체도 조심해서 다룰 대상입니다. graph.json에는 레이블과 소스에서 나온 맥락이 들어 있어서, 문서는 원본 저장소와 같은 접근 통제를 적용하라고 안내합니다. 업스트림은 graphify-out/을 커밋해 시작 지도를 공유하길 권하지만 먼저 내용을 검토하라고 합니다. 여러 사람이 같은 그래프를 쓰는 방식은 세 가지입니다. 커밋해 공유하거나, 각자 복제본에서 만들거나, 공유 HTTP MCP 서버 하나를 두는 것입니다. 어느 쪽이든 누가 언제 갱신하는지, 그래프가 어느 리비전을 가리키는지, 누가 접근하는지를 정해야 합니다.
벤치마크 표에서 읽을 수 있는 것과 없는 것
README의 벤치마크 표는 한 줄로는 화려하지만, 조건을 같이 읽어야 합니다. 전체 표는 BENCHMARKS 문서에 있습니다. 모든 시스템을 같은 하네스, 같은 모델(Kimi K2.6), 같은 예산으로 돌렸고 채점자는 두 번째 채점자와 비교해 일치율 90.6%, Cohen’s kappa 0.81을 냈습니다. 프로젝트가 직접 돌려 공개한 수치라는 점이 첫 번째 조건입니다. 장기 대화 기억을 평가하는 LOCOMO(300문항)와 LongMemEval-S(50문항)의 QA 정확도는 이렇습니다.
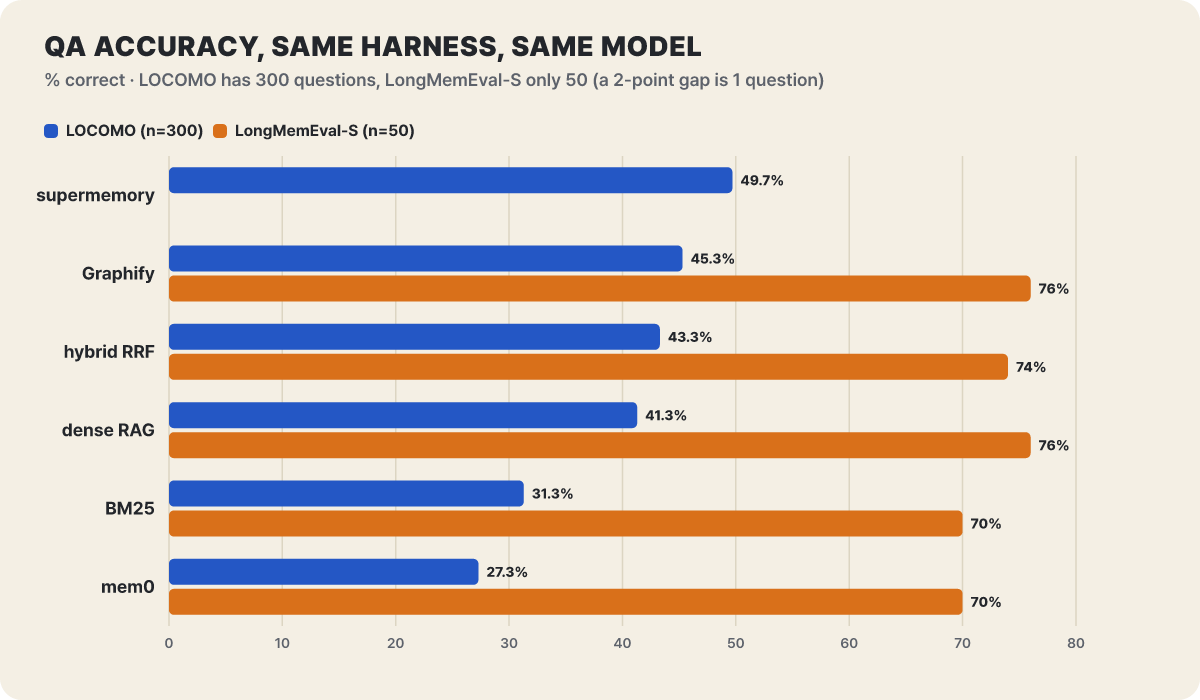 그림 4. 같은 하네스에서 잰 QA 정확도(%). supermemory는 LongMemEval-S 값이 표에 없다
LOCOMO에서 Graphify는 45.3%로 supermemory의 49.7%보다 4.4점 낮고 hybrid RRF(43.3%)보다 2.0점 높습니다. 300문항에서 2점은 여섯 문항 차이입니다. 그래프를 펼쳐 이웃을 더 가져오는 방식이 이웃을 가져오지 않는 변형(42.7%)보다 2.6점 높다는 것이 이 표에서 그래프 확장의 몫으로 읽을 수 있는 크기입니다. 반면 LongMemEval-S에서는 Graphify 76%가 dense RAG와 같고, 50문항에서 2점은 한 문항입니다. 이 구간의 순서는 의미 있는 순위로 읽기 어렵습니다. 홍보 문구가 내세우는 recall@10 0.497은 mem0(0.048)와 supermemory(0.149)를 앞서지만, 문서는 supermemory가 자체 임베더를 쓰는 탓에 이 축이 깨끗한 비교가 아니라고 밝히며 QA 정확도를 보라고 합니다. 같은 인덱스에서 검색한 hybrid RRF는 recall이 0.493으로 거의 같습니다. 비용 쪽은 분명한 차이가 납니다. LOCOMO 데이터를 넣는 비용이 Graphify 약 $1.40, mem0 $3.48, supermemory $15.67이었습니다.
개발자에게 더 와닿는 것은 코드 탐색 실험입니다. 약 100만 줄의 ERPNext에서 Claude Opus 4.8 에이전트가 최대 14턴 동안 grep·읽기·목록 도구만 쓸 때와 그래프 도구를 하나 더 쓸 때를 비교했더니, 핵심 사실 포함률이 70.8%에서 82.0%로 올랐고 질의 하나에 약 140K 토큰이 들었습니다. 저장소 전체를 매 턴 문맥에 밀어 넣는 방식은 토큰이 약 20배라고 문서는 보고합니다. 다만 문항이 6개입니다. 문서도 표본 크기를 한계로 꼽습니다. 이 수치는 “해 볼 가치가 있다”의 근거로 읽고, 결론은 내 저장소에서 평소 던지던 질문 몇 개를 그래프를 쓸 때와 안 쓸 때 던져 읽은 파일 수와 답의 정확도를 비교해서 내는 것이 맞습니다.
막히는 곳 몇 가지
질문하면 답이 없다고 나옵니다. 고장인가요?
그래프는 분석된 입력에 있는 관계만 돌려줍니다. –graph 경로가 맞는지, 소스를 바꾼 뒤 갱신했는지를 확인하고, 함수·클래스 같은 구체적 이름으로 다시 물어보세요. 종료 코드 4는 일치하는 노드가 없다는 뜻이고, 3은 이름이 여러 노드에 걸려 후보를 고르라는 뜻입니다.
그래프를 만드는 데 돈이 드나요?
코드만 대상으로 하면 모델을 쓰지 않으므로 LLM 비용이 들지 않습니다. 문서·PDF·이미지를 넣으면 에이전트 세션의 모델이나 설정한 API 키의 사용량이 듭니다. 0.9.96부터는 터미널의 graphify extract도 토큰 사용량을 graphify-out/cost.json에 기록해, 단독 추출도 비용 이력에 쌓입니다.
어떤 파일 형식까지 읽나요?
코드는 약 40개 언어를 구문 분석하고 SQL(테이블·뷰·외래키)·Terraform·pyproject.toml·go.mod 같은 매니페스트도 다룹니다. 0.9.95부터 YAML도 구조(키)를 추출합니다. PDF·Word·Excel·영상·음성은 앞에서 말한 선택 패키지를 설치해야 합니다.
0.9 버전대인데 업그레이드해도 되나요?
1.0 이전 버전이라 명령과 파일 형식, 캐시 구조가 릴리스마다 바뀔 수 있습니다. 변경 기록에는 “업그레이드 뒤 첫 빌드는 전체를 다시 추출한다”는 문장이 반복해서 나오니, 업그레이드 직후 첫 실행은 평소보다 오래 걸린다고 보면 됩니다. 4월 4일부터 10월 26일까지 264번 릴리스한 속도라서 팀이 함께 쓴다면 버전을 맞추는 편이 안전합니다.
같은 일을 하는 다른 길, 그리고 별개 제품인 클라우드
벤치마크가 실제로 맞붙인 상대는 BM25, 임베딩 검색(dense RAG), 둘을 합친 hybrid RRF, 장기 기억 서비스 mem0·supermemory, 그리고 에이전트의 기본 grep·읽기입니다. 방식 단위로 보면 다음과 같습니다.
설치가 없고 항상 최신입니다. 저장소가 클수록 탐색 비용이 커지며, ERPNext 실험의 비교 기준선이었습니다
의미가 비슷한 글을 찾는 데 좋습니다. 임베딩 저장소를 운영해야 하고, LongMemEval-S에서는 Graphify와 같은 76%였습니다
대화 기억용 서비스입니다. LOCOMO에서 supermemory는 QA 정확도가 더 높고 데이터를 넣는 비용도 더 큽니다
같은 갈래의 도구입니다. 저장소를 로컬 그래프로 색인해 호출 관계를 MCP 도구로 질의합니다
README 곳곳에 반복되는 Graphify Cloud 광고는 같은 회사의 상용 서비스입니다. 폴더마다 필요할 때 만드는 그래프 대신 소프트웨어 개발 전 과정에서 항상 켜져 있는 그래프를 유지하는 쪽이고, 여러 저장소와 모노레포 연결, PR 리뷰, 형식 검증, Sentry·Jira 연결을 내세웁니다. 10월 8일 갱신된 가격 문서 기준으로 Free는 $0(저장소 3개, 저장소당 노드 25,000개, 푸시 기반 빌드 하루 10회), Pro는 월 $15(연간 결제 시 월 $10 환산, 저장소 무제한), Teams는 시트당 월 $29(첫 100팀 혜택가)·$40(표준)에 최소 2시트이고 Enterprise는 견적입니다. 로컬 CLI는 계정이나 구독 없이 무료로 쓸 수 있다고 같은 문서가 밝힙니다. README의 “에이전트 토큰 사용량 80% 절감” 문구는 이 클라우드의 홍보이고, 벤치마크 표에는 그 수치를 측정한 항목이 없으므로 로컬 도구의 성능으로 읽으면 안 됩니다. 같은 갈래의 로컬 도구를 더 비교해 보고 싶다면 이 사이트의 에이전트가 파일을 다 읽지 않아도 되게 코드 구조를 기억하는 MCP 서버 글에 Graphify와의 차이가 정리되어 있습니다.



