54GB 모델이 6GB로 줄었다, 노트북에서 도는 27B 모델 Bonsai 2
Bonsai 2 27B가 54GB를 5.95GB로 줄이는 과정을 파일, 행렬, 128칸 묶음, 회전 변환, 속도, 메모리 순으로 뜯어 보고 점수가 깎인 자리를 14개 항목으로 짚습니다.
Bonsai 2 27B가 54GB를 5.95GB로 줄인 방법은 가중치 273억 개를 -1, 0, +1 세 값으로 바꾸고 128개마다 16비트 배율 하나를 붙인 것입니다. 이 압축은 제작사 측정으로 14개 벤치마크 평균에서 원본(FP16)의 98.2%를 지킵니다. 대가는 두 가지입니다. 회전 변환이 파일에 접혀 있어서 PrismML이 공개한 llama.cpp 포크 같은 전용 실행기가 필요하고, 지식 추론(MuSR)과 비전·OCR 점수가 눈에 띄게 깎입니다. 점수와 속도는 모두 제작사가 모델 카드에 올린 측정값이며, 이 글의 수치는 2026년 10월 27일 UTC에 다시 열어 본 카드와 데모 저장소 기준입니다.
파일이 어떻게 생겼는지부터 바깥에서 안쪽으로 차례로 뜯어 봅니다. 파일 목록, 273.6억 개의 자리 배치, 128칸 묶음 하나, 그 묶음을 읽는 규칙, 그리고 그 위에 올라가는 속도와 메모리 계산 순서입니다.
받는 파일은 몇 개이고 각각 얼마인가
허깅페이스의 27B 저장소에는 가중치 파일이 포장 방식별로 나뉘어 있고, 이미지를 쓸 때만 필요한 비전 파일이 따로 있습니다. 크기는 FP16 원본(약 54GB)을 기준으로 한 배율까지 같이 보면 구조가 보입니다. MLX 행의 배율은 편집부 계산입니다.
| 파일 | 비트/가중치 | 크기 | FP16 대비 |
|---|---|---|---|
| FP16 원본(Qwen3.8-27B) | 16.0 | 약 54GB | 1배 |
| 3진 이론치(128칸 묶음) | 1.72 | 5.8GB | 약 9.3배 |
| GGUF PTQ1_0 | 1.75 | 5.95GB | 약 9.0배 |
| GGUF PQ2_0 | 2.13 | 7.21GB | 약 7.5배 |
| MLX 2비트(애플 전용) | 2.25 | 언어 몸체 7.67GB | 약 7배 |
| 비전 파일(mmproj) | 8비트(Q8_0) | 0.63GB | 이미지를 쓸 때만 |
PTQ1_0은 3진 값을 빽빽하게 채워 이론치 5.8GB에 가장 가깝고, PQ2_0은 값 하나에 2비트 칸을 줘서 1.2GB 남짓 더 큽니다. 둘 다 같은 가중치를 담은 파일이므로 어느 쪽을 받아도 모델의 내용은 같고, 읽는 속도와 메모리에서만 달라집니다. 이 차이가 속도에서 어떻게 뒤집히는지는 뒤에서 기기별로 봅니다.
273.6억 개가 앉은 자리: 몸체, 입출력, 눈
모델 카드에 따르면 총 27.36B 개의 파라미터는 세 곳에 나뉘어 있습니다. 3진으로 바뀌는 범위가 어디까지인지가 “6GB”의 전제입니다.
| 부분 | 개수 | 담는 법 |
|---|---|---|
| 언어 몸체(64블록) | 243.5억 | 어텐션 투영과 MLP 투영 모두 3진 |
| 임베딩과 출력층(LM head) | 25.4억 | 3진 |
| 비전 타워(27블록) | 4.6억 | 별도 파일(mmproj)로 분리, 이미지가 들어올 때만 불러옴 |
| 3진이 되지 못한 텐서 | 2,620만 | 선형 어텐션의 순환 상태 경로와 정규화 가중치. 언어 모델의 0.0976% |
눈여겨볼 곳은 임베딩과 출력층까지 3진이라는 점입니다. 이 두 곳은 압축할 때 흔히 정밀도를 남겨 두는 자리인데, Bonsai 2는 남겨 둔 것이 정규화 가중치와 순환 상태 경로뿐입니다. 그래서 전체 비트 수는 가중치 값 자체의 1.71비트에서 1.72비트로 아주 조금만 올라갑니다.
구조는 원본 Qwen3.8-27B 그대로입니다. 어텐션의 약 75%는 선형 어텐션이고 약 25%가 전체 어텐션인 혼합형이며, 컨텍스트는 262K 토큰입니다. 선형 어텐션 층은 순환 상태 하나를 갱신하므로 토큰이 늘어도 캐시가 따라 자라지 않고, 길이에 비례해 커지는 쪽은 전체 어텐션 층입니다. 훈련을 새로 한 모델은 아니고, 공개된 것은 변환이 끝난 가중치와 실행기입니다.
128칸 묶음 하나를 열어 보면
행렬 하나의 가중치를 128개씩 묶으면 묶음 하나가 압축의 단위가 됩니다. 묶음 안의 가중치는 각각 -1, 0, +1 중 하나가 되고, 묶음에는 16비트 배율 s가 하나 붙습니다. 계산에 실제로 쓰이는 값은 s 곱하기 -1, 0, +1입니다. 0이 있어서 “이 연결은 끊는다”까지 표현됩니다.
출석부로 비유하면
학생 128명의 키를 한 명씩 센티미터로 적는 대신, “평균보다 큼 · 비슷함 · 작음” 세 글자 중 하나만 적고 맨 위에 “글자 한 칸이 몇 센티미터인가”를 한 번만 적어 둡니다. 개개인의 정밀한 숫자는 사라지지만 반 전체의 키 분포는 유지됩니다. 이 글의 128칸 묶음이 이 출석부 한 반이고, 맨 위 한 줄이 배율 s입니다.
비트 수는 두 항의 합으로 계산됩니다. 세 가지 중 하나를 구분하는 데는 log2(3), 약 1.585비트가 듭니다. 16비트 배율을 128개 가중치가 나눠 가지면 하나당 16÷128 = 0.125비트입니다. 합하면 1.71비트이고, 16비트 대비 약 9.3분의 1입니다. 묶음 하나로 환산하면 FP16이 128×16 = 2,048비트(256바이트)인 것이 약 219비트(27.4바이트)로 줄어드는 셈입니다(편집부 계산).
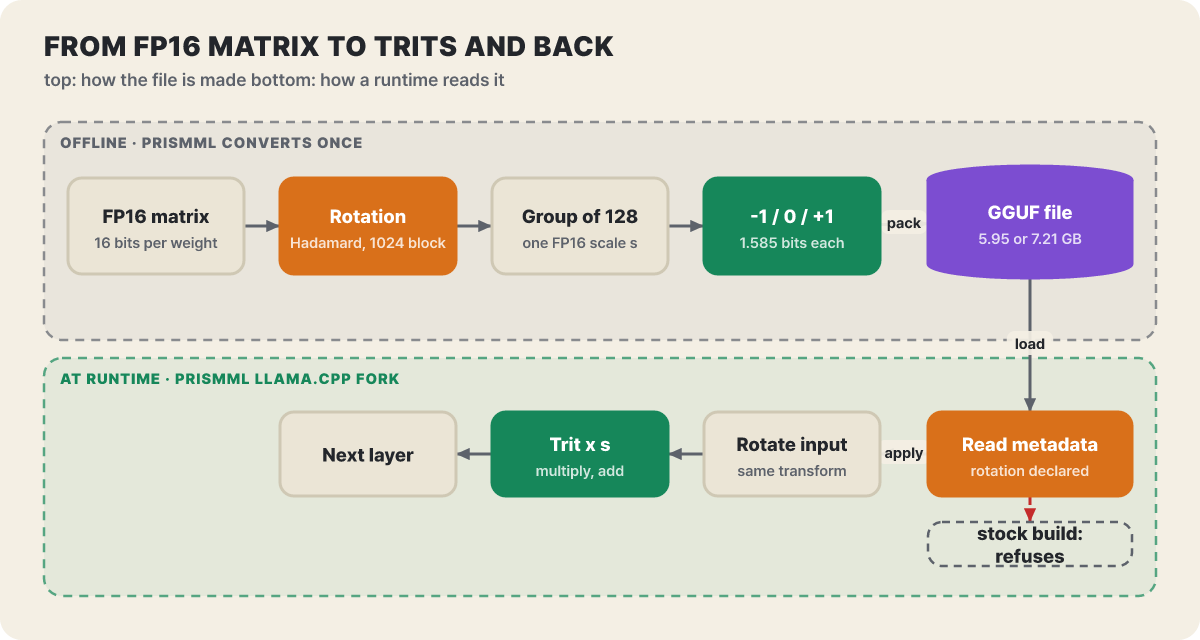 그림 1. 위쪽은 PrismML이 한 번 하는 변환, 아래쪽은 내 컴퓨터의 실행기가 매번 하는 읽기. 그림의 “stock build”는 포크가 아닌 일반 빌드
위 그림에서 두 길이 만나는 곳이 파일의 메타데이터입니다. 변환 쪽에서 가중치에 접어 넣은 회전을 읽는 쪽이 짝으로 되돌려 주어야 계산이 맞습니다. 다음 절이 이 회전 이야기입니다.
파일에 접힌 회전과 실행기가 맡는 짝 변환
모델 카드가 밝힌 회전은 이렇습니다. 행렬마다 1024 크기 블록 단위로 직교 하다마드 변환(고정된 ±1 부호)을 걸고 나서 3진 값을 배정합니다. 이 회전은 저장되는 가중치에 미리 접어 넣기 때문에 비트도, 메모리에서 읽는 양도 늘리지 않습니다. 대신 실행기가 입력(활성값) 쪽에 짝이 되는 변환을 걸어야 합니다. 파일은 회전을 메타데이터로 선언해 두며, 실행기는 변환을 적용하거나 파일 로드를 거부합니다.
이 구조가 “아무 llama.cpp에서나 돌지 않는” 이유입니다. 실행 길마다 어떻게 되는지를 모았습니다.
| 실행 길 | PTQ1_0·PQ2_0 | 근거 |
|---|---|---|
| PrismML llama.cpp 포크 | 읽힘 | 데모가 포크 빌드를 고정해 내려받음(10월 25일 기준 prism-b10826) |
| 일반 llama.cpp | 형식을 몰라 거부 | 데모 README는 최신 업스트림이면 공식 Q2_0 파일만 된다고 안내 |
| Ollama, LM Studio의 GGUF 경로 | 읽지 못함 | 모델 카드 KNOWN_ISSUES |
| 일반 llama.cpp에 FP16 파일 | 열리지만 출력이 엉뚱함 | KNOWN_ISSUES |
| MLX 표준 로더 | 회전을 건너뛰고 오류 없이 엉뚱한 글을 씀 | 번들된 전용 로더를 써야 함. 데모는 mlx-vlm 0.7.8, mlx-lm 0.32.0으로 고정 |
| 내가 직접 PQ2_0·PTQ1_0으로 양자화 | 출력이 엉뚱함 | Prism의 회전된 체크포인트가 있어야 함(KNOWN_ISSUES #242) |
표에서 “열리지만 엉뚱한 출력”인 줄들은 오류도 경고도 없이 틀린 글을 낸다는 점이 위험합니다. 읽기는 되는데 변환이 빠진 실행기는 회전 전 값과 회전 후 값을 섞어 계산하게 되고, 그 결과가 잘못된 글자로만 드러납니다. 모델이 이상하게 답한다고 해서 모델 탓으로 단정하기 전에 실행기가 회전을 아는 빌드인지부터 확인할 이유입니다.
빽빽하게 담기와 풀기 쉽게 담기
같은 3진 가중치를 PTQ1_0은 빽빽하게(1.75비트), PQ2_0은 값마다 2비트 칸으로(2.13비트) 담습니다. 빽빽한 쪽은 읽는 양이 약 17% 적은 대신 값을 풀어 쓰는 계산이 들고, 2비트 칸 쪽은 풀기가 단순한 대신 읽는 양이 더 많습니다. 어느 쪽이 빠른지는 기기에 따라 갈립니다. 카드의 처리량 표(llama-bench, 한 번에 한 요청, 비전 파일 없이, 토큰/초)에서 생성 속도만 옮겼습니다.
| 기기 | PQ2_0 | PTQ1_0 | 빠른 쪽 |
|---|---|---|---|
| RTX 5090 | 129.9 | 120.5 | PQ2_0 |
| RTX PRO 6000 Blackwell | 124.8 | 117.9 | PQ2_0 |
| H100 SXM | 113.9 | 86.9 | PQ2_0 |
| RTX 6000 Ada | 82.8 | 90.4 | PTQ1_0 |
| RTX 4090 | 81.2 | 91.1 | PTQ1_0 |
| L40S | 74.4 | 81.8 | PTQ1_0 |
| A100 SXM | 73.9 | 54.7 | PQ2_0 |
| L4(72W) | 29.8 | 32.1 | PTQ1_0 |
| 애플 M5 Pro(Metal) | 28.1 | 측정 없음 | 애플은 PQ2_0로 측정 |
Ada 세대와 L4에서는 빽빽한 쪽이, 블랙웰·H100·A100에서는 2비트 칸 쪽이 이깁니다. 프롬프트 처리(pp512)는 카드가 시험한 모든 기기에서 PQ2_0이 더 빠르고, 카드는 PTQ1_0을 “메모리가 가장 빠듯할 때 고르는 쪽”이라고 설명합니다. 한 가지 덧붙일 점은 백엔드 문서의 SYCL(인텔 GPU) 항목입니다. XMX 경로에서는 PTQ1_0이 PQ2_0과 같은 크기의 배치로 풀려서, 파일이 작아도 GPU에 올라가는 가중치 메모리까지 작지는 않다고 적혀 있습니다.
속도의 천장은 메모리 읽기 속도 나누기 파일 크기
토큰 하나를 만들 때마다 가중치 전체를 메모리에서 한 번 읽어야 하므로, 생성 속도의 위쪽 한계는 대략 “메모리 대역폭 ÷ 파일 크기”입니다. M5 Pro가 PQ2_0 파일(7.21GB)을 초당 28.1번 읽는다는 측정에서 대역폭은 7.21 곱하기 28.1, 약 203GB/s가 나오고, 카드가 따로 적은 실측 약 204GB/s와 맞습니다. 이 대역폭 하나로 곡선을 그려 파일 크기별 천장을 보겠습니다.
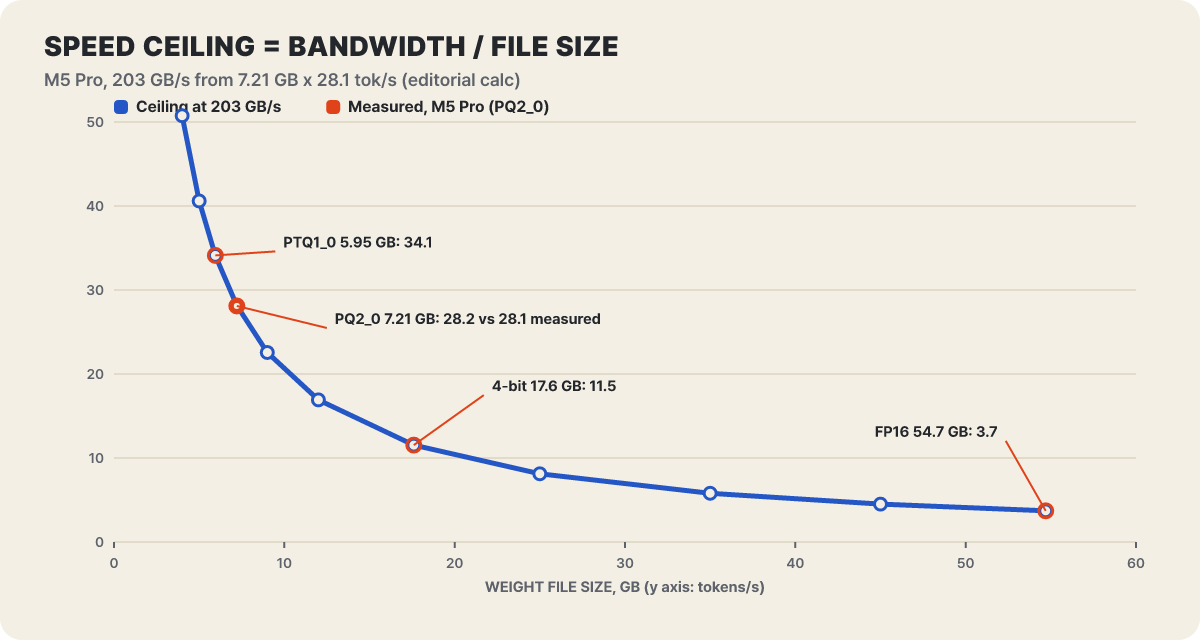 그림 2. 203GB/s를 가정한 속도 상한. 곡선 위 점들은 편집부 계산이고, 빨간 채운 점 하나만 M5 Pro 실측(PQ2_0)
곡선이 6GB 근처에서 가파르게 서 있다는 것이 핵심입니다. 같은 노트북에서 4비트(17.6GB)는 천장이 11.5, 54.7GB의 FP16은 3.7이라 54GB 원본은 속도 이전에 올라가지도 않습니다. 4비트와 FP16의 값은 측정이 아니라 같은 대역폭을 가정한 계산이고, 실제 속도는 커널 구현에 따라 이 상한 아래에서 달라집니다. 이 법칙은 내 기기에도 적용됩니다. 내 기기의 메모리 대역폭을 알면 그 값을 7.21(또는 5.95)로 나눈 것이 낙관적인 어림입니다.
노트북 세 기종은 성격이 다릅니다. M5 Pro만 현재 빌드로 쟀고, M5 Max(47.0)와 M4 Pro(18.0)는 회전을 넣기 전 빌드로 잰 값이라 카드가 재측정 대기로 표시합니다. 같은 이전 빌드에서 M5 Pro는 28.7이었고, 현재 빌드의 28.1은 조용한 상태에서 잰 값이라 백그라운드 작업이 있으면 4% 안팎 움직일 수 있다고 카드가 밝힙니다. 데모 저장소의 커뮤니티 측정 폴더에는 같은 27B가 더 다양한 기기에서 올라와 있습니다. 확인한 값만 몇 개 옮기면 RTX 5090(리눅스, CUDA 12.8)에서 PQ2_0 143.0, 8GB짜리 RTX 3070에서 43.7, 인텔 Arc B580(12GB, SYCL)에서 PTQ1_0 47.9, 애플 M3 Max(36GB, Metal)에서 PQ2_0 24.3, 베이스 M5 에어(16GB)에서 7.82입니다. 제출자와 빌드가 제각각인 값이라 카드의 표와 직접 겹쳐 비교할 수는 없고, “내 기기급이 대략 어느 줄에 있나”를 보는 용도입니다.
속도 표만으로 부족한 경우는 긴 입력입니다. 카드의 프롬프트 처리 값(pp512)은 M5 Max 765, M5 Pro 387, M4 Pro 125토큰/초입니다. 2만 토큰 문서를 요약시키고, 생각 예산을 2,048토큰으로 묶고, 답을 500토큰 쓴다고 가정해 이 값을 그대로 나누면 M5 Max는 26초와 54초를 합쳐 약 80초, M5 Pro는 52초와 91초로 약 142초, M4 Pro는 160초와 142초로 약 302초입니다(512토큰 구간에서 잰 값을 그대로 쓴 편집부 어림, M5 Max·M4 Pro는 이전 빌드 값). M4 Pro에서는 프롬프트 처리만 전체의 절반을 넘습니다. 긴 문서를 자주 넣는다면 생성 속도보다 이 값을 먼저 봐야 합니다.
크기와 점수를 한 평면에 놓으면
제작사는 같은 Qwen3.8-27B를 네 가지로 담아 H100에서 EvalScope와 vLLM으로, 사고(thinking) 모드를 켜고 14개 벤치마크를 쟀습니다. 샘플링은 권장 설정과 같되 min_p만 0.0이었습니다. 아래는 파일 크기를 가로(로그 눈금), 14개 평균을 세로에 놓은 그림입니다.
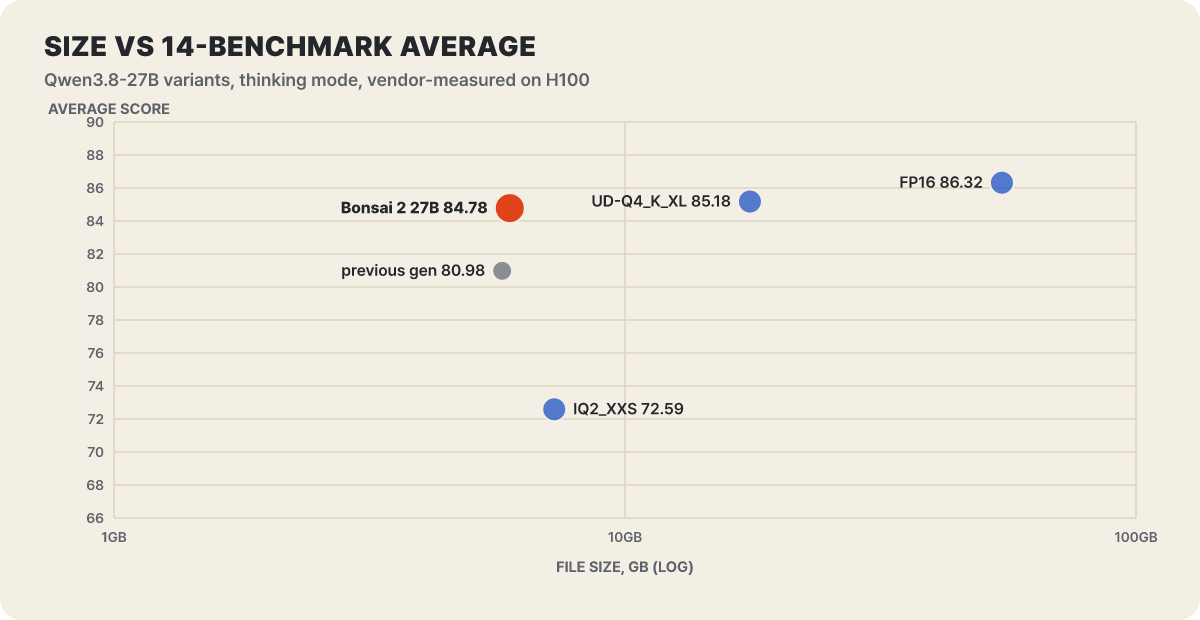 그림 3. 같은 바탕 모델의 담는 방식별 크기와 평균 점수. 이전 세대는 카드의 지능 밀도 표에 함께 오른 값이며 바탕 모델이 달라 참고용
세로로 봅니다. Bonsai 2(84.78)는 3배 큰 4비트(85.18)와 0.4점 차이이고, 크기가 비슷한 일반 2비트(72.59)보다 12점 넘게 위에 있습니다. 가로로 봅니다. 같은 6~7GB 안에서 담는 방식이 점수를 12점 가른 셈입니다. 평균 점수를 “못 푸는 비율”로 뒤집으면 차이가 더 잘 보입니다.
100에서 평균 점수를 뺀 값이고 편집부 계산입니다. Bonsai 2는 원본보다 약 11% 더 많이 틀리고 4비트보다 약 3% 더 틀리지만, 일반 2비트의 약 절반(1.8분의 1)만 놓칩니다. 제작사가 쓰는 지능 밀도 D는 이 놓치는 비율의 로그를 크기로 나눈 값, 곧 −log2(1 − 점수/100) ÷ GB입니다. Bonsai 2가 0.457, 일반 2비트 0.257, 4비트 0.157, FP16 0.053이고, 카드는 이전 세대 3진 Bonsai 27B(5.75GB, 평균 80.98)의 0.416에서 9.9% 올랐다고 적습니다. 모두 제작사가 직접 잰 값이고 비교 대상도 같은 27B의 다른 압축이므로, 내 용도에서의 판단은 같은 메모리 예산의 더 작은 모델 4비트판과 나란히 돌려 본 뒤에 내리는 편이 맞습니다.
열네 칸 중 어디가 깎였나
평균은 항목별 증감을 평평하게 섞습니다. 아래 그림은 FP16 대비 잃은 점수를 항목마다 변형 세 개로 나란히 놓았습니다. 어두울수록 많이 잃은 칸이고, 앞에 + 가 붙은 칸은 FP16보다 점수가 높았다는 뜻입니다.
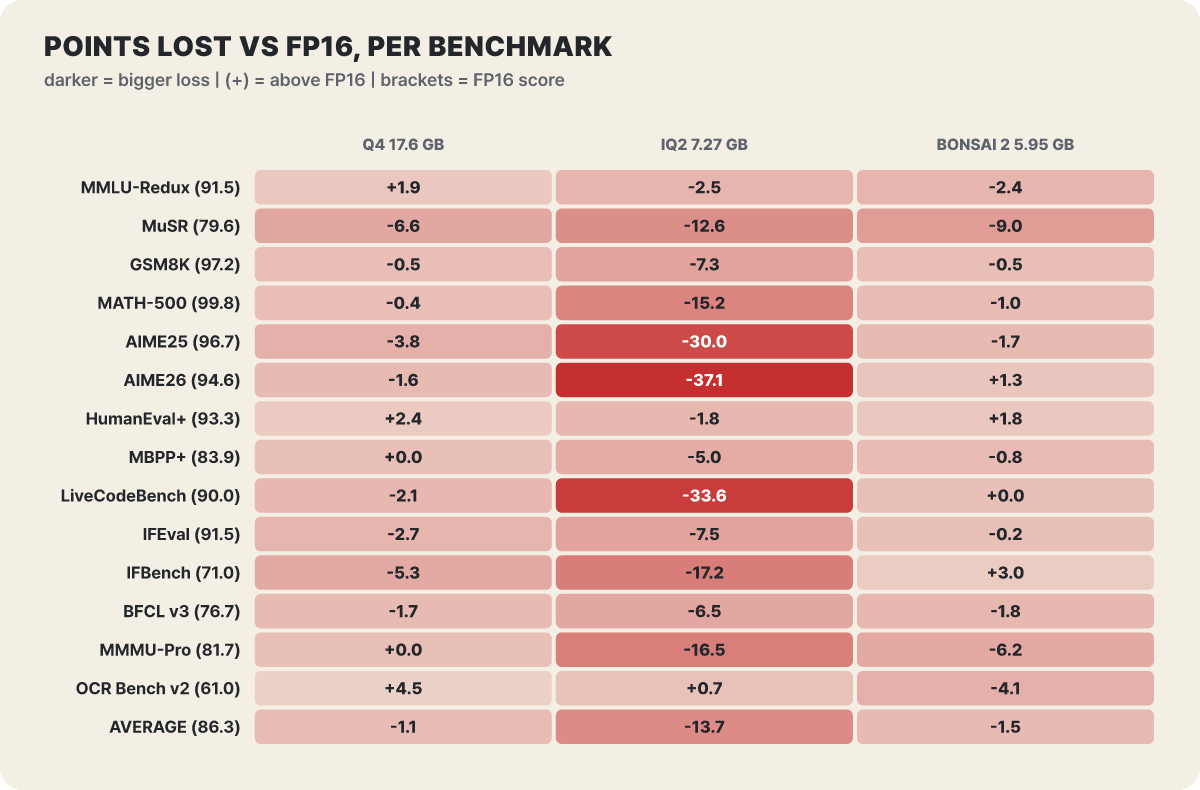 그림 4. FP16 대비 점수 손실. 괄호 안은 FP16 점수, 원값은 모델 카드의 항목별 표, 차이는 편집부 계산
일반 2비트는 긴 추론이 필요한 칸에서 무너집니다. AIME26 −37.1, LiveCodeBench −33.6, AIME25 −30.0이고, 지식 문제(MMLU-Redux)는 −2.5로 버팁니다. 카드도 이 빌드가 지식은 지키고 긴 추론 사슬에서 선택적으로 약해진다고 설명합니다. Bonsai 2는 정반대 모양입니다. 수학과 코딩은 거의 그대로(AIME26 +1.3, LiveCodeBench 0.0, HumanEval+ +1.8, IFBench +3.0)이고, 깎이는 곳은 MuSR −9.0, MMMU-Pro −6.2, OCR Bench v2 −4.1, MMLU-Redux −2.4처럼 지식·상식 추론과 비전에 모여 있습니다. 범주별 평균(FP16 대 Bonsai 2)으로 쓰면 수학 97.06 대 96.57, 코딩 89.07 대 89.42, 지시 이행 81.25 대 82.66은 사실상 같고, 지식·추론은 85.55 대 79.86, 비전은 71.36 대 66.19, 도구 호출은 76.74 대 74.92입니다.
4비트도 공짜가 아닙니다. 17.6GB를 쓰고도 MuSR에서 −6.6, IFBench에서 −5.3, AIME25에서 −3.8을 잃습니다. IFBench와 AIME25에서는 Bonsai 2(+3.0, −1.7)보다 더 깎이고, MuSR에서는 반대로 Bonsai 2(−9.0)가 더 깎입니다. 4비트는 OCR(+4.5)과 MMLU-Redux(+1.9)에서는 FP16보다 높습니다. 그래서 “4비트가 무조건 안전하고 3진이 무조건 위험하다”는 말은 이 표에서 나오지 않습니다. 문서 이미지 판독이 핵심이면 OCR 56.88이라는 값에서, 지식 추론이 핵심이면 MuSR 70.63에서 한 번 더 확인하는 쪽이 맞습니다.
6GB 파일이 실제로 차지하는 메모리
“파일이 6GB니까 램 8GB면 되겠지”로 시작하면 막힙니다. 가중치 위에 얹히는 것 중 가장 크게 자라는 것은 대화 기억을 담는 KV 캐시입니다. 데모 문서 기준 FP16 KV 캐시는 토큰당 약 64KiB이고, 환경 변수 BONSAI_KV4=1로 4비트 캐시를 쓰면 약 18KiB입니다. 비전 프로젝터는 Q8_0 파일이 0.63GB, 메모리로는 약 0.9GiB를 더 쓰며 이미지가 들어올 때만 불러옵니다. 네 가지 장면에 대입했습니다.
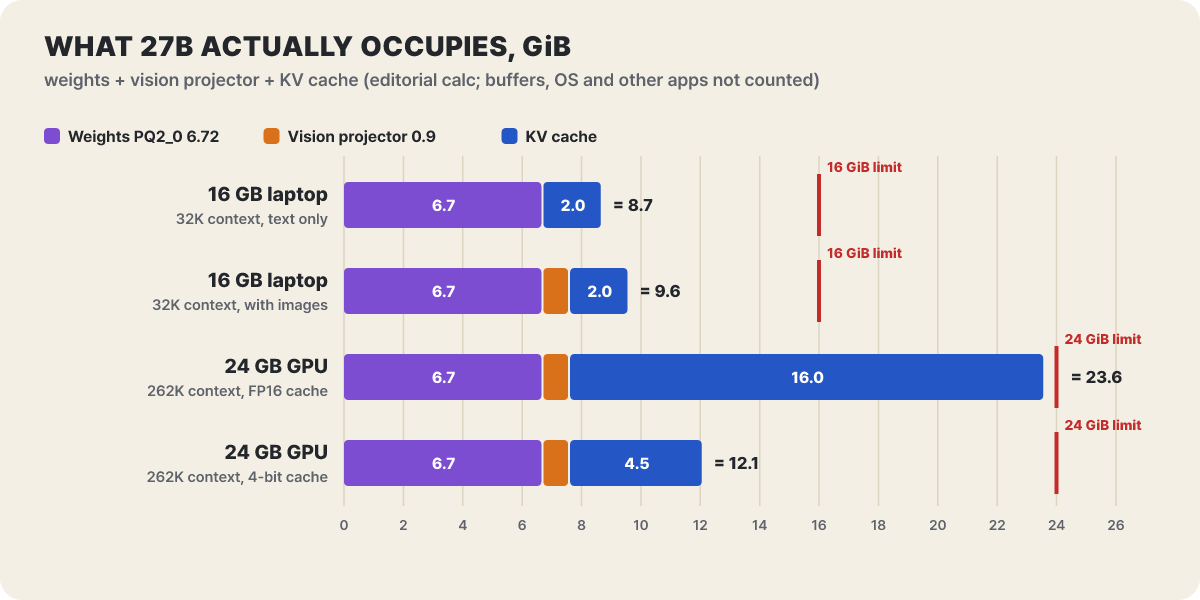 그림 5. 장면별 메모리 구성(GiB). 가중치는 PQ2_0 7.21GB를 GiB로 환산(6.72). 실행 버퍼·운영체제·다른 앱은 빠진 편집부 계산
마지막 막대가 중요합니다. 24GB GPU에서 262K 전체를 FP16 캐시로 채우면 캐시만 16GiB라 합계가 23.6GiB로 한계에 닿고, 같은 설정에서 4비트 캐시로 바꾸면 4.5GiB로 줄어 12.1GiB가 됩니다. 그림에 없는 실행 버퍼와 다른 앱의 몫은 작지 않습니다. 모델 카드의 KNOWN_ISSUES는 기본 32K 컨텍스트가 12GB GPU에는 맞지 않는다고 적고, BONSAI_CTX를 낮추거나 BONSAI_KV4=1을 쓰라고 안내합니다. 그림 5의 첫 두 막대(8.7~9.6GiB)도 16GB 노트북에서 남는 6GiB 안에 운영체제와 브라우저가 들어가야 한다는 뜻입니다.
기본 컨텍스트 길이는 램 크기별 구간으로 자동 정해집니다. 램이 작은 기기는 8K, 71GB를 넘는 기기는 131K까지이고 262,144토큰이 최대입니다. 예전 버전은 시작할 때 262K 전체를 잡아 메모리가 폭주하는 일이 있었습니다. 지금은 BONSAI_CTX=0이 구간별 기본값으로 풀리고, 그래도 시동 때 메모리가 부족하면 BONSAI_CTX=8192처럼 직접 줄이라고 FAQ가 안내합니다.
처음 띄울 때 걸리는 곳들
가장 쉬운 길은 포크 바이너리를 알아서 내려받아 주는 공식 데모 저장소입니다. 27B 기본값은 PQ2_0 약 7.8GB에 비전 프로젝터가 더해지고, Open WebUI와 코드 인터프리터까지 합치면 몇 GB가 더 듭니다. KNOWN_ISSUES는 setup.sh가 약 19GB를 조용히 받는 경우가 있다고 적으며 BONSAI_SKIP_GGUF=1로 건너뛰라고 안내합니다. 받을 용량이 부담이면 BONSAI_OPENWEBUI=0, BONSAI_CODE_INTERPRETER=0도 함께 씁니다.
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
./setup.sh                          # 모델과 포크 바이너리(prism-b10826 고정)를 내려받음
./scripts/start_llama_server.sh     # http://localhost:8080 에서 채팅·이미지·도구 호출
./scripts/run_llama.sh -p "짧게 자기소개 해 줘"   # 서버 없이 한 번만 실행

# 10월 인증서 갱신: 이미 만든 환경은 저장소를 당겨도 패키지가 바뀌지 않으므로 따로 올린다
uv pip install --python .venv/bin/python "certifi>=2026.10.23"
서버는 기본으로 127.0.0.1에만 열리며, BONSAI_HOST를 다른 주소로 바꾸면 같은 네트워크의 다른 기기에도 노출됩니다. 설치 중 마주치기 쉬운 문제는 문서에 이렇게 정리돼 있습니다.
- M5 맥과 macOS 26.2~26.4: Metal 라이브러리 컴파일 오류 뒤에 메모리 부족으로 끝납니다. 실행 앞에 GGML_METAL_TENSOR_DISABLE=1을 붙이면 신경망 가속기를 쓰는 프리필 이득만 잃고 Metal 속도는 유지됩니다. CPU로 돌리는 BONSAI_NGL=0보다 훨씬 빠릅니다
- CUDA 13.3 빌드: 충돌한다는 보고가 열려 있고, 리눅스는 CUDA 12.8, 윈도는 12.4를 권합니다. RTX 5090의 리눅스 사전 빌드는 디코딩이 들쭉날쭉하다는 보고가 있어
120a-real로 직접 빌드하라고 안내합니다 - Vulkan의 PQ2_0: 바이너리 배포본에서는 조용히 CPU로 돌아 초당 2토큰 미만이 나올 수 있습니다. 소스는 고쳐졌고 바이너리에는 아직 반영되지 않아
prism브랜치로 직접 빌드하거나 PTQ1_0을 씁니다 - 윈도 설치 스크립트: NVIDIA에서 Vulkan을 고르던 문제는 수정됐고(Bonsai-demo #176), 지금은 PQ2_0만 내려받아서 PTQ1_0은 직접 받아야 합니다
- 직접 빌드하다 멈추는 경우: CUDA 병렬 컴파일 작업 하나가 수 GB를 쓰므로 VRAM이 16GB보다 작으면 스크립트가 병렬도를 2로 제한합니다
띄운 뒤 가장 자주 부딪히는 곳은 추론 길이입니다. 이 모델은 답하기 전에 길게 생각하고, 기본 추론 강도가 가장 높은 xhigh라서 출력 상한을 256처럼 작게 잡으면 생각 도중에 끊깁니다. 카드는 -n 16384 이상을 권합니다. 짧은 답이 필요하면 medium으로 낮추고, 서버 전체 기본값은 아래처럼 정합니다. low는 지원하지 않아 xhigh와 거의 같게 동작하고, reasoning_effort: "high"는 HTTP 500을 돌려주는 열린 문제가 있으니 xhigh나 medium을 씁니다.
./scripts/start_llama_server.sh --chat-template-kwargs '{"reasoning_effort":"medium"}'
./scripts/start_llama_server.sh --reasoning-budget 2048     # 생각 길이 상한은 이 서버 플래그로
생각 예산은 chat_template_kwargs로 보내면 무시되므로 요청의 최상위 필드나 위의 서버 플래그로 보내야 합니다. 예산 0이 추론을 끄는 것도 아니라서, 끄려면 reasoning_effort: "none"을 보내고 서버는 --reasoning auto로 둡니다. 채팅 화면의 전구 메뉴는 생각 예산을 끔, 512, 2,048, 8,192, 무제한 중에서 고릅니다. 샘플링 권장값은 사고 모드 temperature 1.0, top_p 0.95, top_k 20, min_p 0.05이고 지시 모드는 temperature 0.7, top_p 0.8, top_k 20, presence_penalty 1.5입니다. GGUF 파일에는 min_p와 presence_penalty 값이 들어 있지 않아 이 값을 직접 지정해야 하고, 데모 스크립트는 이미 적용해 둡니다. 서버는 OpenAI 방식의 /v1/chat/completions를 열어 두므로 기존 도구는 주소만 바꾸면 연결됩니다.
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"이 에러 로그의 원인을 세 줄로 요약해 줘: ..."}],"max_tokens":16384}'
이미지와 도구 호출은 무엇을 더 쓰는가
27B는 이미지를 함께 받습니다. 채팅 화면에서 사진이나 스크린샷을 올리거나 API에서 image_url 항목으로 보냅니다. 비전 토큰 하나는 약 32×32 픽셀을 덮고 최대 약 4,096토큰(약 420만 화소)까지 받습니다. 이미지는 프롬프트 처리 비용이라 큰 사진은 첫 글자가 나오기 전까지 수천 토큰의 대기가 붙습니다. 맥·Vulkan·CPU 실행은 기본으로 1,024토큰까지만 쓰도록 이미지를 줄여 넣기 때문에 작은 글씨와 일련번호가 뭉개질 수 있고, CUDA·ROCm은 상한이 없습니다. 세밀함이 필요하면 BONSAI_IMAGE_MAX_TOKENS를 0이나 2048 이상으로 올리거나 필요한 부분만 잘라 올립니다. KNOWN_ISSUES는 작은 이미지의 위치 인식이 약할 때 --image-min-tokens 1024를 주라고 안내하는데, 데모 서버는 아직 이 값을 넘기지 않습니다. 비전 파일은 BF16 대신 Q8_0이 권장됩니다. BF16은 이미지 요청이 동시에 들어오면 서버가 멈출 수 있습니다. VRAM이 빠듯하면 BONSAI_MMPROJ_CPU=1로 프로젝터를 시스템 램에 두며 이때는 이미지 처리만 느려집니다. llama.cpp는 이미지를 한 번만 인코딩해서 같은 이미지에 대한 후속 질문이 바로 나오지만 MLX는 요청 사이에 캐시를 두지 않습니다.
도구 호출은 서버가 OpenAI 방식의 tools와 tool_calls를 그대로 받습니다. 채팅 화면에는 허깅페이스 검색, DeepWiki, Brave 검색 도구 서버가 미리 설정돼 있어 채팅마다 켜고 끌 수 있고, 도구를 부르는 반복은 기본 최대 10번입니다. 도구는 켠 만큼 정의가 프롬프트에 붙어 컨텍스트를 씁니다. 허깅페이스 약 2,600토큰, DeepWiki 약 400토큰, Brave 검색 3종 약 2,900토큰입니다. 컨텍스트가 빠듯한 환경에서는 쓰지 않는 도구를 꺼 두는 것이 곧 메모리와 속도를 아끼는 일입니다. Open WebUI에서는 날씨, 웹 가져오기, 데모 SQL 데이터베이스, 코드 인터프리터, 시간이 기본으로 켜져 있습니다.
KNOWN_ISSUES에 올라 있는 도구 호출 문제도 알아 두면 시간을 아낍니다. arguments가 비어 있으면 서버가 오류(HTTP 500 또는 400)를 내므로 "{}"를 보내야 하고, 시스템 메시지가 첫 번째가 아니거나 두 개 이상이어도 500이 나오므로 하나로 합쳐 맨 앞에 둡니다. 도구 루프에서 프롬프트 캐시가 계속 빗나가는 문제는 생각 내용을 대화에 다시 실어 보내지 않으면 줄어듭니다. 모양이 깨지거나 반복되는 호출은 구조화 출력에서 나오는 모델의 한계로 분류돼 있고, 도구 호출 점수(BFCL v3)도 FP16 76.74에서 74.92로 내려갑니다. API 키는 코드에 넣지 말고 환경 변수나 커밋하지 않는 파일에 두라고 데모 문서가 안내합니다. 데모가 내려받는 실행 파일은 PrismML이 빌드한 것이므로 회사 환경이라면 출처와 버전을 확인하고, 소스(MIT 라이선스)를 직접 빌드하는 길도 있습니다.
같은 방식으로 줄인 동생 셋과 곁가지
27B 발표 약 4주 뒤인 10월 15일에 같은 3진 방식의 소형 세 종(2B·4B·9B)이 소개됐습니다. 허깅페이스 저장소는 9월 23일에 만들어져 있었고, 10월 15일에 4B·9B가 갱신됐습니다. 바탕은 Qwen3.5 계열이고 컨텍스트는 27B와 같은 262K입니다. 모델 카드에는 소형 모델의 벤치마크 평균이 없으므로 고를 때는 같은 질문 세트로 직접 비교하는 편이 확실합니다.
| 크기 | 바탕 모델 | PTQ1_0 | PQ2_0 | FP16 | 비전(Q8_0) | HF 다운로드 |
|---|---|---|---|---|---|---|
| 27B | Qwen3.8-27B | 5.95GB | 7.21GB | 약 54GB | 0.63GB | 약 216만 |
| 9B | Qwen3.5-9B | 2.00GB | 2.42GB | 약 17.9GB | 0.62GB | 약 18.3만 |
| 4B | Qwen3.5-4B | 0.95GB | 1.15GB | 약 8.4GB | 0.37GB | 약 5.7만 |
| 2B | Qwen3.5-2B | 0.43GB | 0.52GB | 약 3.8GB | 0.36GB | 약 8.6만 |
다운로드 수는 2026년 10월 27일 UTC 허깅페이스 GGUF 저장소 기준이고, 27B는 좋아요 2,834개, 데모 저장소는 별 3,447개, 마지막 푸시는 10월 25일입니다. 소형 모델에서는 설정 세 가지를 조심해야 합니다. 사고 모드는 간단한 질문에도 3,000토큰 넘게 쓰는 경우가 있어 출력 상한을 8,192 이상으로 잡아야 하고, temperature 0의 그리디 디코딩은 사고 모드에서 일부 프롬프트가 멈추니 피합니다. 샘플링 기본값도 27B와 다릅니다. 사고를 켜면 temperature 1.0, top_p 0.95, top_k 20, min_p 0, presence_penalty 1.0이고, 끄면 temperature 0.7, top_p 0.8, top_k 20, presence_penalty 1.5입니다. 9B에는 초안 토큰을 미리 예측하는 MTP 헤드 변형(2.68GB)과 별도 초안기(DFlash2, 1.57GB)가 있는데, 반복되는 내용을 베끼는 작업에는 도움이 되지만 일반 대화에서는 더 느릴 수 있어서 2B는 일반 디코딩을 권장합니다. 소형 모델의 비전 파일을 쓸 때는 BF16보다 Q8_0이 권장되고, Open WebUI의 에이전트 데모 실행기는 소형 모델 프로필과 로더 연결이 아직 갱신되지 않았습니다.
27B를 직접 설치하지 않고 써 보는 길은 OpenRouter의 prism-ml/ternary-bonsai-2-27b입니다. reasoning, reasoning_effort, tools, response_format 같은 매개변수를 받으며, 이 길에서는 “데이터가 내 기기 밖으로 나가지 않는다”는 로컬 실행의 이점이 해당되지 않습니다. 앱으로 쓰고 싶다면 LM Studio처럼 자체 엔진을 번들하는 앱이 PTQ1_0·PQ2_0을 읽는지는 앱이 넣은 엔진 버전에 달려 있고 데모 저장소가 그 엔진을 대신 갱신해 주지도 않으니, 형식 지원 여부부터 확인합니다. 모델은 Apache 2.0, 데모 저장소는 Apache-2.0, 포크는 MIT 라이선스이며 바탕이 된 Qwen 모델의 조건까지 함께 읽어 보는 것이 안전합니다. 더 작은 쪽을 찾는다면 첫 세대 Bonsai의 1비트 계열(27B·8B·4B·1.7B)이 데모 저장소에 별도 문서로 남아 있고, 3진이 아닌 일반 4비트 빌드로 더 작은 모델(예: 9B)을 돌리는 길도 있습니다. 3진 방식은 7월 15일 첫 세대 27B(바탕 Qwen3.6-27B)에서 출발해 9월 17일 Bonsai 2 27B로 이어졌습니다. 발표된 유지율은 95%에서 98.2%로 올랐지만 바탕 모델과 벤치마크 구성이 달라 두 값을 곧바로 비교할 수는 없습니다. 소형 세 종은 같은 방식을 2B~9B로 내린 가지입니다.



