쓸수록 스스로 스킬을 만드는 에이전트 Hermes Agent
Hermes Agent의 쓸수록 스킬이 쌓인다는 말을 파일 세 곳, 스킬이 만들어지는 순간, 프롬프트 한도, 14일·30일 큐레이터, 쓰기 승인으로 풀어 봅니다. 설치와 점검 순서까지 정리했습니다.
지침 파일은 사람이 쓰고 사람이 고치지만, Hermes Agent의 스킬은 에이전트가 쓰고, 고치고, 오래 안 쓰면 치우기까지 합니다. Hermes Agent(저장소 NousResearch/hermes-agent)는 오픈 모델 연구로 알려진 Nous Research가 만든 MIT 라이선스 에이전트이고, 확인 기준(2026-10-27 UTC) GitHub 별 25만 7천여 개, 포크 5만 6천여 개, 최신 릴리스는 v0.22.5(10월 23일)입니다. 공식 README는 내장된 학습 고리를 가장 앞세우는데, “쓸수록 스킬이 쌓인다”는 문구만으로는 무엇이 어디에 얼마나 쌓이고, 쌓인 것이 언제 쓰이고, 낡으면 어떻게 되는지 알 수 없습니다. 이 글은 그 한 문장을 공식 문서의 파일 이름, 설정 값, 명령으로 하나씩 바꿔 읽어 봅니다.
말 한마디가 디스크에 남기는 파일 세 곳
먼저 “쌓인다”의 물리적 정체부터 봅니다. Hermes는 모든 것을 사용자 홈의 ~/.hermes/ 아래에 두고, 학습과 관련된 저장소는 세 종류입니다. 방법을 담은 skills/ 폴더, 사실을 담은 작은 마크다운 파일 두 개(memories/), 지난 대화를 통째로 담은 state.db입니다.
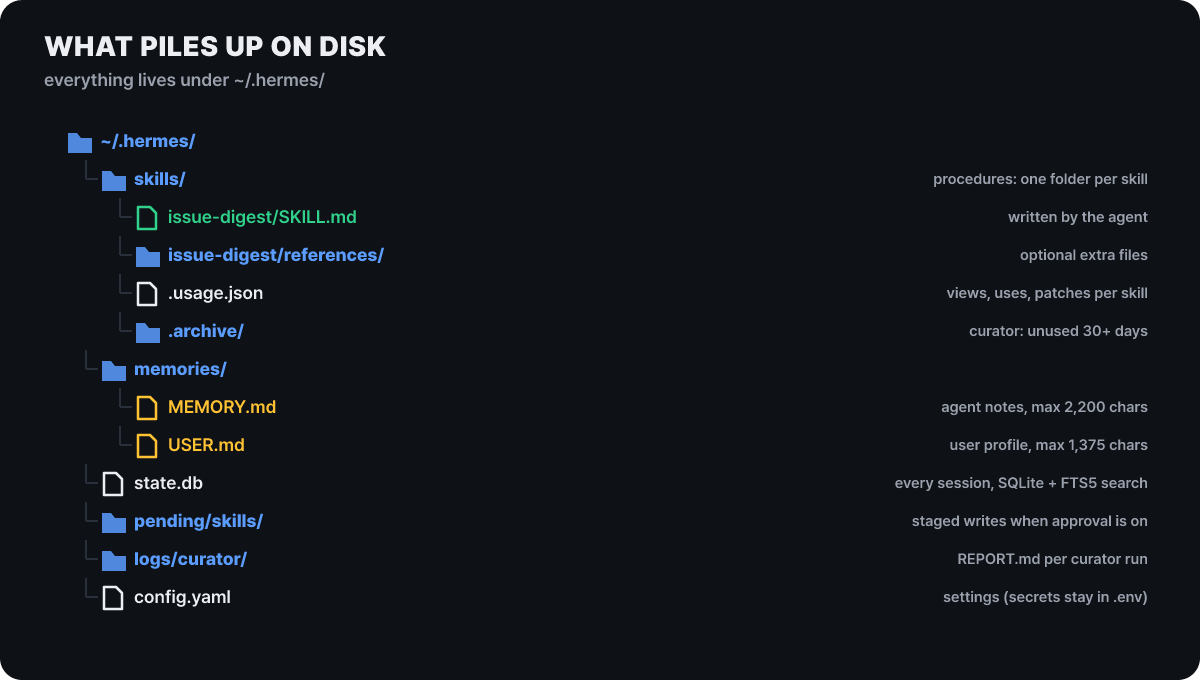 그림 1. 학습과 관련된 파일은 모두
~/.hermes/ 안에 있다
초록색 파일이 에이전트가 새로 쓴 스킬이고, 노란색 두 파일은 매 세션 프롬프트에 들어가는 기억입니다. skills/ 안의 스킬 하나는 SKILL.md가 든 폴더이며, 보조 파일을 두는 references/, templates/, scripts/, assets/ 폴더를 선택적으로 가질 수 있습니다. .usage.json은 스킬마다 몇 번 열었고 몇 번 썼고 몇 번 고쳤는지를 적어 두는 장부이고, 뒤에서 볼 큐레이터가 이 숫자를 보고 판단합니다. 대화 기록 state.db는 SQLite이며 CLI와 메신저의 모든 세션이 들어가고 FTS5 전문 검색으로 찾습니다. 외부 기억 서비스를 붙이면 내장 기억과 나란히 동작하는데, v0.22.0(10월 14일)부터 Honcho, Hindsight, Supermemory, Mem0 같은 제공자는 각 제작사의 플러그인으로 옮겨져 hermes plugins install 이름으로 설치합니다. 기존 사용자는 자동으로 이전됐다고 릴리스 노트에 적혀 있고, 번들로 들어 있는 것은 RetainDB와 ByteRover입니다.
이 구분이 중요한 이유는 저장소마다 쌓이는 방식과 한도가 전혀 다르기 때문입니다. 스킬 폴더에는 사실상 한도가 없고, 기억 파일은 글자 수로 막혀 있고, 대화 기록은 검색으로만 꺼냅니다.
스킬이 태어나는 순간은 네 가지
스킬은 사람이 따로 만들지 않아도 생깁니다. 공식 스킬 문서는 시스템 프롬프트가 에이전트에게 저장을 권하는 경우를 셋으로 적고 있습니다. 여러 단계의 작업 흐름을 알아냈을 때, 오류나 막다른 길에서 빠져나왔을 때, 사용자가 에이전트를 바로잡았을 때입니다. 네 번째는 사용자가 직접 /learn으로 디렉터리, 주소, 방금 한 작업 흐름, 붙여 넣은 메모, 책이나 문서 묶음을 가리키는 경우입니다. 큰 자료는 설명 60자 이내의 가벼운 SKILL.md에 주제마다 참고 파일을 하나씩 둔 지식 스킬이 됩니다.
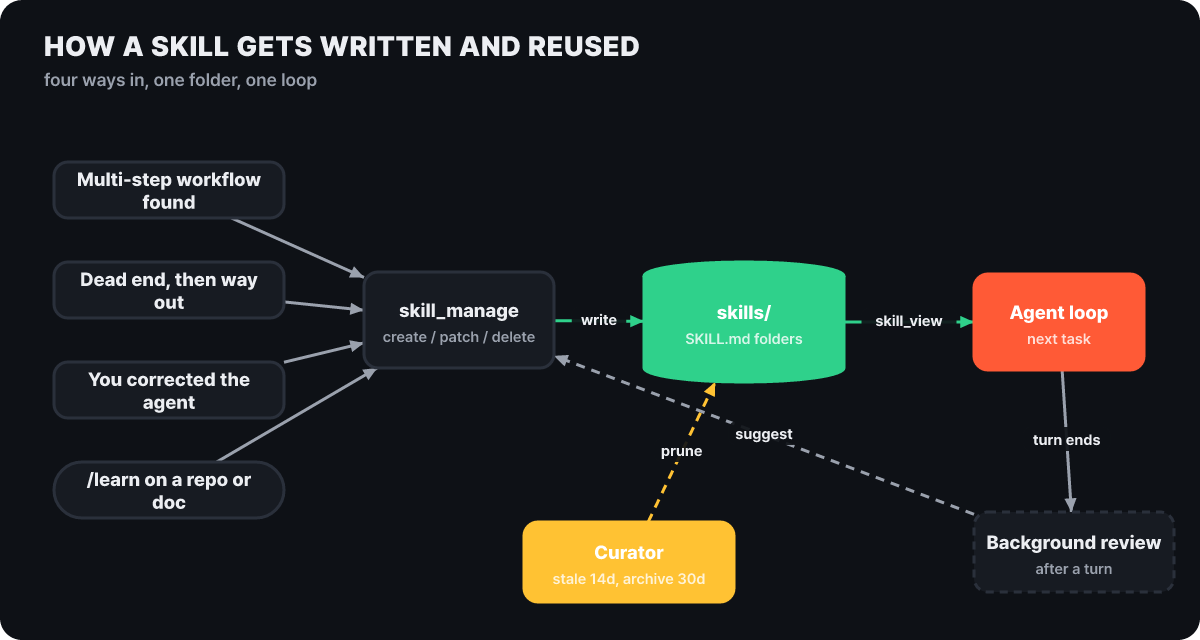 그림 2. 네 입구에서
skill_manage 하나로 모이고, 읽는 쪽과 정리하는 쪽이 같은 폴더를 본다
그림에서 점선은 사람이 개입하지 않는 경로입니다. 턴이 끝나면 백그라운드 검토가 돌아 스킬 변경을 제안하거나 대기 상태로 두고, 큐레이터는 폴더를 정리합니다. 문서는 검토 빈도를 memory.nudge_interval과 skills.creation_nudge_interval 설정으로 조절한다고 적고, 자동 검토 자체를 끄려면 auxiliary.background_review.enabled: false를 쓰라고 안내합니다.
쓰고 고치는 수단은 skill_manage 도구 하나입니다. create는 새 스킬, patch는 old_string을 new_string으로 바꾸는 부분 수정(보내는 글이 적어 문서가 권하는 방식), write_file과 remove_file은 보조 파일, delete는 삭제입니다. 스킬이 실제로 어떤 모양인지는 예를 보는 편이 빠릅니다. 아래는 문서가 안내한 머리말 필드와 본문 절 이름을 따라 쓴 형식 예시이고, 내용은 설명하려고 지어낸 것입니다.
---
name: issue-digest
description: 어제 올라온 이슈를 세 줄로 요약한다
version: 1.0.0
platforms: [macos, linux]
metadata:
  hermes:
    tags: [report, github]
---

# 이슈 요약

## When to Use
"어제 이슈 요약해 줘"라는 요청을 받았을 때

## Procedure
1. 어제 0시부터 24시까지 열린 이슈 목록을 모은다
2. 사용자 영향이 큰 순서로 세 개를 고른다
3. 한 줄에 하나씩, 이슈 번호를 붙여 쓴다

## Pitfalls
- 봇이 만든 이슈는 세지 않는다

## Verification
- 세 줄이고 번호가 모두 실제 이슈인지 확인
머리말의 platforms를 생략하면 어느 운영체제에서나 불러옵니다. metadata.hermes에는 태그와 분류, 특정 도구 묶음이 켜져 있을 때만 보이게 하는 조건(requires_toolsets 등)을 둘 수 있고, 스킬이 비밀 값을 필요로 하면 required_environment_variables에 선언해 로컬 CLI에서만 물어봅니다. 스킬은 Agent Skills 공개 표준(agentskills.io)을 따르므로 다른 도구에서 쓰던 SKILL.md 묶음을 가져다 쓸 수 있습니다. 표준 자체는 Agent Skills가 재단으로 넘어갔다에서 다뤘습니다.
스킬이 늘어도 프롬프트는 부풀지 않는 이유
스킬이 수십 개 쌓이면 매번 모두 읽어야 한다는 걱정이 들 수 있는데, 문서의 답은 점진적 공개입니다. 0단계(skills_list)에서는 이름, 설명, 분류만 읽고 그 크기가 약 3천 토큰입니다. 에이전트가 필요하다고 판단한 스킬만 1단계(skill_view(이름))에서 본문 전체를 열고, 2단계(skill_view(이름, 경로))에서 그 안의 참고 파일 하나를 엽니다. 1단계와 2단계의 크기는 스킬마다 다르다고만 적혀 있습니다.
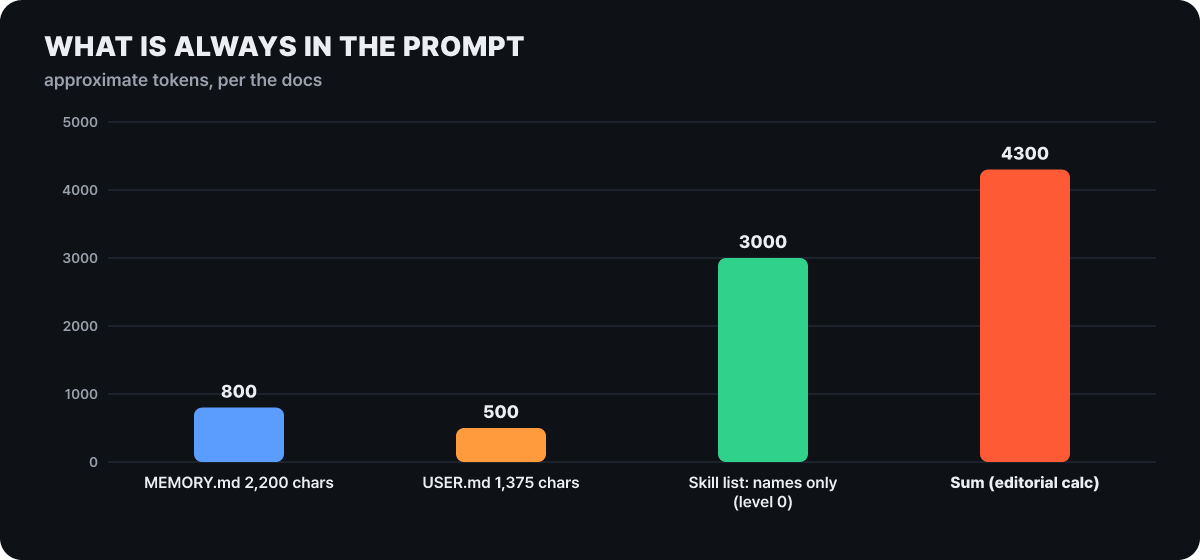 그림 3. 매 세션 항상 들어가는 양. 합계는 편집부 계산이며 세 값은 문서의 근삿값
세 막대를 보면 가장 큰 몫이 스킬 목록이고, 그것도 이름과 설명만이라는 점이 핵심입니다. 스킬 본문은 부를 때 올라오므로 스킬이 늘수록 늘어나는 것은 목록 쪽입니다. 그래서 한 가지 규칙이 눈에 띕니다. 스킬 설명은 짧고 구체적이어야 에이전트가 목록만 보고 고를 수 있습니다. 문서는 참고 파일이 60개를 넘거나 SKILL.md 본문이 약 2만 4천 자를 넘으면 경고를 낸다고 적어, 한 스킬을 비대하게 키우지 말라는 방향을 보여 줍니다.
사람이 부르는 길도 열려 있습니다. 설치된 모든 스킬은 슬래시 명령이 되어 /스킬이름 지시로 호출하고, 한 메시지 앞쪽에 스킬 명령을 최대 5개까지 쌓을 수 있습니다. 같은 이름의 스킬이 여러 위치에 있으면 프로젝트 폴더(.hermes/skills/ 또는 .agents/skills/, hermes skills trust로 신뢰하기 전에는 불러오지 않음), 로컬 ~/.hermes/skills/, skills.create_dir, skills.external_dirs 순으로 위쪽이 가립니다. 한 폴더 안에서 이름이 겹치면 추측하지 않고 “이름이 모호하다”는 오류를 냅니다. 외부 폴더는 쓰기 보호가 없어서 프로세스에 쓰기 권한이 있으면 에이전트가 그 안의 스킬을 고칠 수 있다는 점도 알아 둘 부분입니다.
기억은 3,575자에서 일부러 멈춘다
스킬이 “방법”이라면 기억은 “사실”입니다. MEMORY.md는 에이전트 자신의 메모(환경 사실, 관례, 배운 교훈)로 한도 2,200자(약 800토큰), USER.md는 사용자 프로필(선호, 말투, 기대)로 한도 1,375자(약 500토큰)입니다. 위치는 ~/.hermes/memories/이고 프로필마다 따로여서, hermes -p work로 쓰면 ~/.hermes/profiles/work/memories/를 읽습니다. 두 파일을 합쳐 3,575자입니다.
쉽게 말하면
스킬은 서랍 속 업무 절차서이고 기억은 모니터 가장자리에 붙인 포스트잇 두 장입니다. 절차서는 서랍이 허락하는 만큼 늘어나도 필요한 것만 꺼내 읽으면 되지만, 포스트잇은 붙일 자리가 정해져 있어서 새 메모를 붙이려면 낡은 메모를 떼거나 합쳐야 합니다. 지난 통화 기록부(대화 기록 DB)는 책상 밖 캐비닛에 있고 필요할 때만 뒤져 봅니다.
한도에 닿으면 어떻게 되는지가 이 설계의 성격을 말해 줍니다. 기억 문서는 자동 압축이 없다고 분명히 적고 있습니다. 한도를 넘기는 쓰기는 오류를 돌려주고, 에이전트가 같은 턴에서 항목을 합치거나 지워 자리를 낸 뒤 새 항목을 넣는 한 번의 묶음 작업으로 다시 시도합니다. 문서는 사용량이 80%를 넘으면 정리하라고 권합니다. 쓰는 도구 memory에는 add, patch, remove 세 동작만 있고 읽기 동작은 없습니다. 기억이 세션 시작 때 자동으로 프롬프트에 들어가기 때문입니다. 수정할 때는 old_text가 항목 하나와 정확히 맞아야 하고, 저장하려는 내용에서 프롬프트 주입, 자격 증명 유출, SSH 뒷문, 보이지 않는 유니코드가 검출되면 차단됩니다.
기억에는 한 가지 시간차가 있습니다. 파일은 세션이 시작될 때 한 번 읽어 시스템 프롬프트에 얼린 스냅숏으로 들어갑니다. 대화 도중 저장한 내용은 디스크에는 즉시 쓰이지만 프롬프트에는 다음 세션에야 보입니다. 개발자 문서가 말하는 설계 원칙, 곧 시스템 프롬프트는 대화 중에 바뀌지 않는다(/model 같은 명시적 사용자 동작은 예외)는 규칙의 결과이고, 모델 제공자의 프롬프트 캐시를 지키려는 배려입니다. 메신저에서 한 대화를 아주 길게 이어 가면 /new로 경계를 만들어 줘야 새 기억이 반영됩니다.
지난 대화를 찾는 session_search는 설명이 두 갈래입니다. 기억 문서는 저장된 메시지를 자르지 않고 그대로 돌려주며 LLM 호출이 없다고 적습니다. README는 같은 기능에 LLM 요약이 붙는다고 소개합니다. 어느 쪽이든 과거 대화가 SQLite에 남아 검색된다는 점은 같고, 기억 파일이 3,575자로 막혀 있어도 나머지 과거를 검색으로 꺼낼 수 있는 이유가 이 DB입니다.
쌓아 두기만 하면 낡는다: 14일과 30일
스킬을 에이전트가 계속 만들면 비슷한 스킬이 여럿 생기고, 한 번 쓰고 마는 스킬이 폴더를 채웁니다. 이것을 청소하는 장치가 큐레이터이고, 큐레이터 문서는 이 장치를 에이전트의 자기 개선 고리가 만든 스킬이 거의 같은 복사본으로 늘어나지 않게 하는 용도라고 설명합니다.
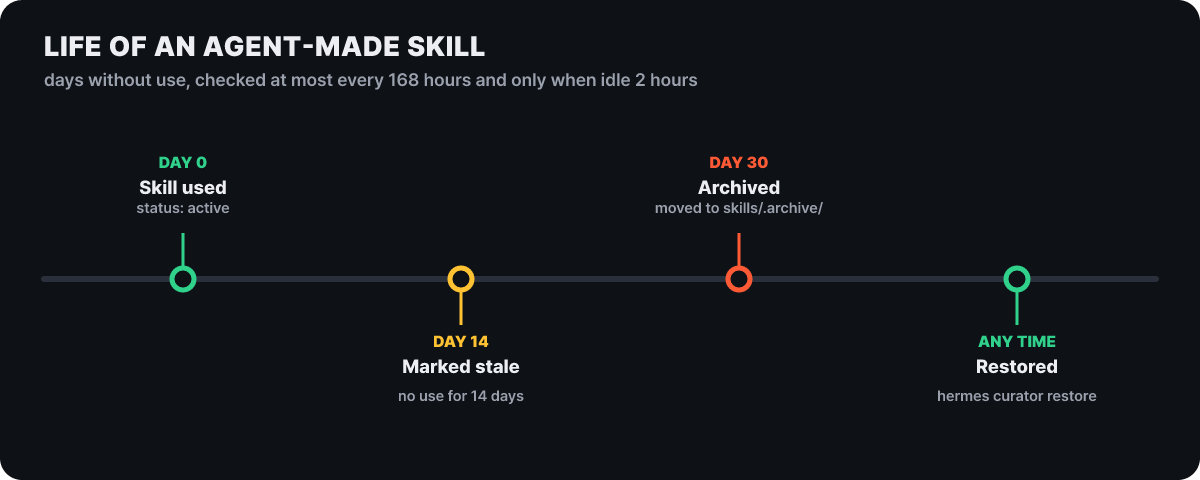 그림 4. 미사용 일수에 따른 상태. 간격은 눈금이 아니라 순서를 보이려고 균등하게 그렸다
큐레이터는 크론이 아니라 한가한 시간에 도는 점검입니다. 마지막 실행 뒤 interval_hours(기본 168시간, 7일)가 지나고 min_idle_hours(기본 2시간)만큼 쉬었을 때만 돌고, 확인은 CLI 세션을 시작할 때, 게이트웨이의 정리 작업 중, hermes serve의 점검 타이머에서 일어납니다. 새로 설치하면 첫 관찰은 기준 시각만 잡고 첫 실제 점검은 한 주기 뒤라서, 그 사이에 스킬을 살펴보고 고정할 시간이 있습니다. 점검의 첫 단계는 LLM을 쓰지 않는 기계적 전환입니다. 14일(stale_after_days) 쓰지 않은 스킬은 stale이 되고, 30일(archive_after_days) 쓰지 않으면 ~/.hermes/skills/.archive/로 옮겨집니다. 한 번도 안 쓴 스킬은 만든 지 stale_after_days가 되기 전에는 보관되지 않습니다. 고정(pin)한 스킬과 크론 작업이 참조하는 스킬(멈춰 둔 작업 포함)은 건너뛰고, 문서는 자동 삭제가 없어서 최악이 보관이며 복구할 수 있다고 적습니다.
둘째 단계인 LLM 통합은 기본으로 꺼져 있습니다. 토큰이 들고 구조를 크게 바꾸기 때문이고, 켜면(curator.consolidate: true 또는 한 번만 hermes curator run --consolidate) 검토 모델이 스킬을 읽어 유지, 수정, 겹치는 스킬 병합, 보관을 고릅니다. 참고 파일 폴더가 딸린 스킬은 한 묶음으로 다뤄 SKILL.md만 납작하게 합치지 못합니다.
curator:
  enabled: true          # 기본값
  interval_hours: 168    # 점검 사이 최소 간격
  min_idle_hours: 2      # 쉰 시간이 이만큼이어야 실행
  stale_after_days: 14
  archive_after_days: 30
  consolidate: false     # LLM 통합은 직접 켤 때만
  backup:
    enabled: true
    keep: 2              # 고쳐 쓰는 점검 전에 스냅숏 2개 유지
범위도 좁습니다. 큐레이터는 에이전트가 스스로 만든 스킬(.usage.json에 created_by: agent로 표시된 것)만 관리합니다. 사람이 쓴 스킬, 사용자의 요청으로 앞쪽 에이전트가 만든 스킬(created_by: learn), 허브에서 설치한 스킬은 건드리지 않고, 번들 기본 스킬도 curator.prune_builtins를 켜지 않으면 그대로입니다. 고정한 스킬은 skill_manage로 삭제하거나 보관할 수 없지만 고치는 것은 여전히 가능합니다. 사람이 쓰는 명령은 hermes curator status, run --dry-run, pin, list-archived, restore 이름입니다. 점검마다 ~/.hermes/logs/curator/ 아래에 REPORT.md와 run.json이 남고, 통합을 되돌릴 때는 hermes curator rollback으로 가장 최근 스냅숏을 복원하며, 변경 하나만 되돌리려면 ledger로 항목을 찾아 rollback 항목ID를 씁니다. 삭제된 스킬도 이 방법으로 되살릴 수 있다고 문서가 적습니다.
월요일에 가르친 것을 화요일 크론이 읽는 길
저장소가 하나라는 점은 입구가 여럿일 때 의미가 커집니다. 개발자 문서에 따르면 에이전트 본체(AIAgent) 클래스는 하나이고 CLI, 메신저 게이트웨이, 편집기용 ACP 어댑터, 배치 러너, API 서버가 모두 같은 본체를 부릅니다. 입구마다 다른 것은 입출력 방식뿐이어서 같은 ~/.hermes/를 읽고 씁니다. 편집기(VS Code·Zed·JetBrains)가 hermes acp로 연결하는 것이 ACP이고, 예약 작업은 게이트웨이 프로세스가 60초마다 확인해 실행합니다.
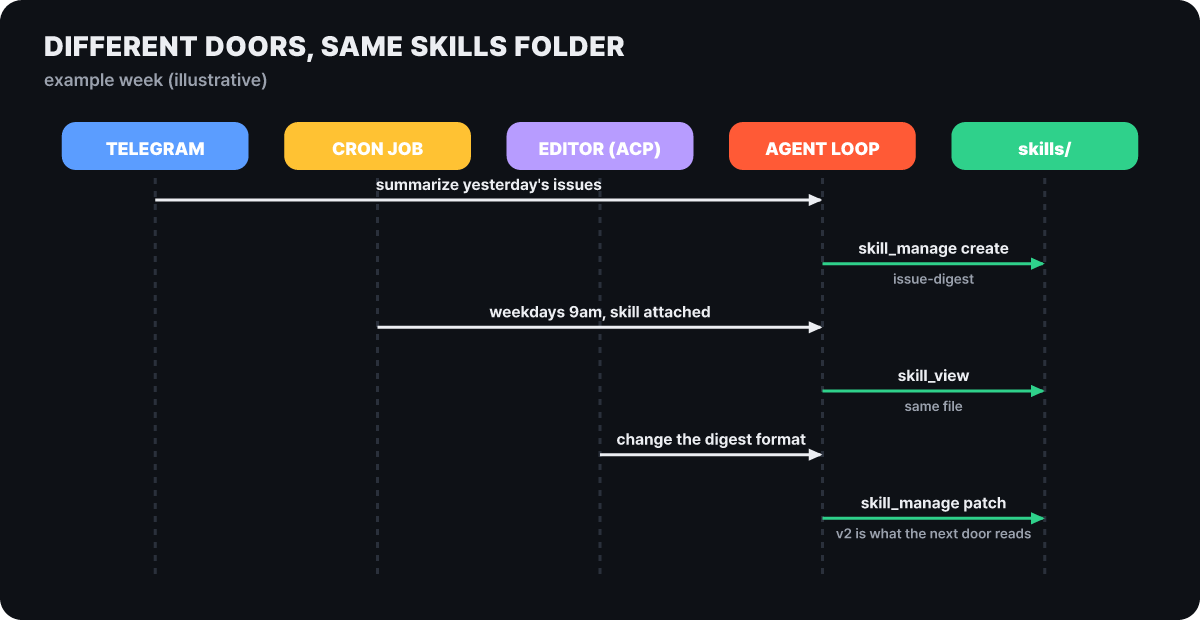 그림 5. 편집부가 만든 예시 한 주. 세 입구가 같은
skills/ 폴더를 읽고 쓴다
그림의 흐름을 말로 풀면 이렇습니다. 월요일에 텔레그램으로 “어제 이슈를 요약해 줘”라고 시켜 몇 번 다듬으면 에이전트가 issue-digest 스킬을 만듭니다. 화요일 아침 9시에는 크론이 같은 일을 맡습니다. 예약은 hermes cron create "weekdays at 9am" "어제 이슈 요약"처럼 명령으로도, 채팅 안에서 /cron add로도 만들 수 있고, 크론은 실행할 때마다 기록 없는 새 에이전트를 만들면서 연결된 스킬을 맥락으로 넣습니다. 즉 사람이 매번 설명하지 않아도 스킬이 지시문 역할을 합니다. 수요일에 편집기에서 “요약 형식을 바꿔 줘”라고 하면 같은 에이전트 본체가 patch로 스킬을 고치고, 다음 날 크론은 고친 버전을 읽습니다. 결과를 어디로 보낼지는 deliver 값이 정하고(원래 대화, 로컬 파일, 홈 채널, telegram:<chat_id> 같은 특정 대상), 홈 채널은 채팅에서 /sethome으로 정합니다.
크론에는 학습을 둘러싼 안전장치가 붙어 있습니다. 크론 안에서 에이전트가 새 크론을 만드는 것은 기본으로 막혀 있고(cron.allow_agent_scheduling: false), 실행 전에 API 키, 스킬, 전달 자격 증명, MCP 서버 설정을 점검해 문제가 있으면 모델을 부르지 않고 멈춥니다. 모델 서버에 닿지 않는 반복 작업은 5분, 15분, 30분 간격으로 자동 재시도합니다. 게이트웨이는 텔레그램, 디스코드, 슬랙, 왓츠앱, 시그널, 이메일 등 25개 이상의 어댑터를 가졌다고 문서가 적고, 설정은 hermes gateway setup 마법사가 안내합니다.
한 가지 예외는 하위 에이전트입니다. delegate_task로 띄운 하위 에이전트(동시에 기본 10개, 기본 깊이 1단)는 memory, send_message, cronjob, clarify 도구를 쓸 수 없고 빈 맥락에서 시작해 최종 요약만 부모에게 돌려줍니다. 결국 하위 에이전트가 알아낸 것을 기억에 직접 남기지는 못하고 부모가 정리해야 합니다. v0.22.5에서는 위임 백엔드도 플러그인으로 바뀌어 모델 맵이나 프로필별로 하위 에이전트를 보낼 수 있게 됐습니다. 에이전트를 용도별로 따로 키우고 싶다면 프로필을 만듭니다. 프로필은 설정, 비밀 키, 인격(SOUL.md), 기억, 세션, 스킬, 크론, 게이트웨이가 모두 분리된 별도의 홈이라서 서랍도 프로필마다 하나입니다. 다만 프로필은 샌드박스가 아니어서 로컬 백엔드에서는 같은 계정의 파일 권한을 가집니다.
틀리게 배운 것은 어디서 걸리나
스킬은 다음 세션부터 에이전트가 따르는 지시문이므로, 틀린 스킬이나 오염된 스킬은 같은 실수를 반복하게 합니다. 공식 문서에서 걸러 주는 지점은 네 군데입니다. 첫째, 허브에서 설치하는 스킬은 데이터 유출, 프롬프트 주입, 파괴적 명령, 공급망 신호를 검사하고, 신뢰 등급은 builtin, official, trusted(openai/skills, anthropics/skills 같은 저장소), community 순입니다. 커뮤니티 스킬은 위험하지 않은 지적만 --force로 넘길 수 있고 dangerous 판정은 계속 막힙니다. 둘째, 에이전트가 만든 스킬에는 skills.guard_agent_created라는 별도 내용 검사가 있습니다. 셋째, 프로젝트의 AGENTS.md, .cursorrules, SOUL.md 같은 맥락 파일에서 이전 지시를 무시하라는 문구, 숨은 HTML 주석, .env를 읽으려는 시도, 보이지 않는 유니코드를 찾아 걸리면 [BLOCKED: …] 안내로 바뀝니다. 문서는 이것이 휴리스틱이라 의도를 의미로 읽는 검사는 아니라고 밝힙니다. 넷째가 사람의 승인입니다.
skills.write_approval: true를 켜면 모든 스킬 쓰기가 ~/.hermes/pending/skills/에 쌓이고, /skills pending으로 목록을 보고 /skills diff 번호로 바뀐 내용을 확인한 뒤 /skills approve 번호 또는 /skills reject 번호를 씁니다. /skills approval on|off로 껐다 켤 수 있고, 기억도 memory.write_approval과 /memory pending, /memory approve가 같은 방식입니다. 둘 다 기본값은 false, 곧 자유롭게 쓰는 쪽입니다. 대화형 CLI에서는 쓰는 순간 물어보고, 메신저나 스크립트, 백그라운드 검토에서는 대기 상태로 쌓입니다. 학습 속도를 늦추는 대신 에이전트가 무엇을 배우는지 눈으로 볼 수 있는 쪽을 택하는 스위치입니다.
스킬이 시키는 일을 실행하는 단계에는 또 다른 층이 있습니다. 위험한 명령에 대한 승인 방식은 approvals.mode 한 값으로 정합니다.
| 모드 | 동작 |
|---|---|
manual |
위험 명령이 나올 때마다 사용자에게 물음 |
smart(기본) |
보조 LLM이 위험도를 평가해 가벼운 것은 그 명령 한 번만 통과, 명백히 위험하면 거부, 애매하면 사람에게 넘김 |
off |
승인 점검을 모두 끔(--yolo와 같음). 신뢰하는 환경에서만 |
물음에 300초(approvals.timeout) 안에 답하지 않으면 거부되고, 크론·단발 실행(hermes chat -q)·웹훅처럼 사람이 없는 세션은 위험 명령을 기본으로 거부합니다. rm -rf /와 변형, 포크 폭탄, 마운트된 루트에 대한 mkfs, 디스크 장치에 쓰는 dd 같은 하드 차단 목록은 off나 YOLO 모드에서도 풀리지 않습니다. 직접 쓰는 거부 패턴(approvals.deny)도 YOLO보다 먼저 적용됩니다. 승인 대화에서 “always”를 고르면 command_allowlist에 저장되고, hermes approvals suggest는 지난 90일 기록에서 허용 후보만 제안합니다.
문제는 백엔드에 따라 이 점검이 아예 사라진다는 점입니다.
| 터미널 백엔드 | 격리 | 위험 명령 점검 |
|---|---|---|
local |
없음 | 함 |
ssh |
원격 호스트 | 함 |
docker |
컨테이너 | 건너뜀 |
modal · daytona · vercel_sandbox |
클라우드 샌드박스 | 건너뜀 |
singularity(플러그인) |
컨테이너 | 건너뜀 |
컨테이너 쪽은 점검 대신 경계에 기댑니다. Docker 백엔드는 리눅스 권한을 모두 내리고 필요한 셋(DAC_OVERRIDE, CHOWN, FOWNER)만 되돌리며, 권한 상승을 막고 프로세스 수를 256개로 제한합니다. 자원 기본값은 메모리 5,120MB, 디스크 51,200MB, CPU 1개입니다. 승인과 격리가 서로 반대편에서 막아 주는 구조라서, 크론이나 게이트웨이처럼 사람이 없는 시간에 도는 에이전트일수록 컨테이너 백엔드가 어울립니다. 문서가 스스로 밝힌 한계도 옮겨 둡니다. 비밀 파일(~/.ssh/, ~/.aws/, .env 등)의 쓰기 차단 목록은 방어 심층화일 뿐 악의적인 에이전트를 막는 샌드박스가 아니고, 터미널 도구가 같은 OS 사용자로 돌아 셸 명령으로는 막힌 경로에 닿을 수 있으며, 거부 규칙은 변수·별칭·이름을 바꾼 실행 파일을 풀어 보지 못합니다. 비밀 값 이름 필터(KEY, TOKEN, SECRET, PASSWORD 등)가 적용되는 곳은 파이썬 스크립트를 돌리는 execute_code이고, Docker·SSH·Modal 백엔드는 기본으로 호스트 환경 변수를 넘기지 않습니다. 파일 변경 쪽에서 되돌리기와 영수증에 초점을 둔 도구가 궁금하다면 Codewhale를 함께 보면 접근 방식이 어떻게 갈리는지 보입니다.
메신저에 붙일 때는 누가 말을 걸 수 있는지가 곧 보안입니다. 게이트웨이는 모르는 사용자를 기본으로 거부하고 허용 목록(TELEGRAM_ALLOWED_USERS 같은 변수)이나 페어링 코드로만 엽니다. 페어링 코드는 암호학적 난수로 만든 8자(0·O·1·I를 뺀 32자 알파벳)이며 1시간 뒤 만료, 사용자당 10분에 요청 1회, 플랫폼당 대기 코드 3개, 승인 5회 실패 시 1시간 잠금이고, 승인은 hermes pairing approve 플랫폼 코드로 합니다.
스킬을 맡기기 전에 나오는 질문
프로그램 자체를 쓰는 데 돈이 드나요?
Hermes Agent는 MIT 라이선스 오픈소스라 프로그램 값은 없습니다. 비용은 연결하는 모델 제공자에게 내는 호출 요금이나 Nous Portal 구독에서 나옵니다. 구독 가격은 공식 문서가 적지 않고 구독 관리 페이지로 안내합니다. 큐레이터의 LLM 통합과 백그라운드 검토도 보조 모델을 부르는 일이라, 켜 두면 그만큼 호출이 늡니다.
내 컴퓨터에서 도는 로컬 모델로도 쓸 수 있나요?
쓸 수 있고 조건은 컨텍스트 창 64K(65,536) 토큰 이상입니다. 이보다 작으면 시작할 때 거부됩니다. 로컬 서버를 띄울 때 llama.cpp는 --ctx-size 65536, Ollama는 -c 65536으로 먼저 올리세요. 사용자 지정 엔드포인트는 OpenAI 호환 방식이어야 합니다. 앞서 본 항상 들어가는 4천여 토큰이 64K 중 작은 몫이라는 점도 이 조건과 맞물립니다.
스킬과 기억을 다른 컴퓨터로 옮길 수 있나요?
hermes backup이 전체 설정을 옮기는 명령으로 안내되어 있습니다. 프로필 단위로는 hermes profile export가 압축 파일(API 키는 빠짐)을 만들고 hermes profile import로 가져옵니다. 계속 갱신할 에이전트라면 git 저장소로 배포하는 방식(hermes profile install, hermes profile update)도 있습니다. hermes profile create work --clone은 설정·스킬·기억을 복사하지만 대화 기록과 크론 작업은 복사하지 않습니다.
설치하고 학습이 이어지는지 확인하기까지
공식 문서가 권하는 설치는 세 갈래입니다. macOS와 Windows는 데스크톱 설치 프로그램(CLI와 데스크톱 앱 함께), 리눅스·macOS·WSL2의 명령줄은 셸 스크립트, 네이티브 윈도우는 PowerShell 스크립트입니다. 한 줄 설치는 실행 전에 스크립트를 열어 보고, 설치 위치(홈 폴더 안 ~/.hermes)와 받는 구성 요소(Python, Node.js, ripgrep, FFmpeg 등)를 확인한 뒤 쓰는 것을 권합니다. 설치 뒤 hermes setup은 세 모드를 내놓습니다. 빠른 설정은 Nous Portal 로그인으로 키 없이 시작하고, 전체 설정은 모든 제공자와 도구를 내 키로 직접 정하고, 빈 판은 제공자·모델과 파일 작업, 터미널 도구 묶음만 켠 채 시작해 필요한 것을 하나씩 켭니다. 학습 기능을 평가하려는 사람에게는 켜진 도구가 가장 적은 빈 판이 어울립니다.
hermes                                       # 대화 시작 (--tui 는 개선된 화면)
hermes config set terminal.backend docker    # 터미널 실행을 컨테이너로
hermes config set approvals.mode manual      # 위험 명령은 매번 묻기
hermes config set skills.write_approval true # 스킬 쓰기는 대기열로
hermes -c                                    # 마지막 세션 이어 가기
hermes curator status                        # 큐레이터가 본 스킬 현황
hermes doctor                                # 환경 진단
학습이 실제로 이어지는지는 사흘쯤 뒤에 세 곳에서 확인합니다. 먼저 hermes -c로 지난 세션이 돌아오는지 보고, 채팅에서 /skills pending으로 에이전트가 쓰려던 스킬이 대기열에 있는지, 쓰기 승인을 껐다면 ~/.hermes/skills/에 새 폴더가 생겼는지 열어 봅니다. 그 SKILL.md를 직접 읽어 보는 것이 가장 빠른 평가이고, 기억 파일 두 개도 같은 방식으로 열어 볼 수 있습니다. 설정 뒤 응답이 비정상이거나 비어 있다면 문서가 권하는 복구 순서는 hermes doctor, hermes model, hermes setup, hermes sessions list, hermes --continue, hermes gateway status이고, 메신저 연결은 일반 대화가 정상일 때 붙이라고 합니다. 여러 API 키를 모으기 번거롭다면 Nous Portal 구독(hermes setup --portal)으로 모델 300여 개와 도구 게이트웨이(웹 검색·추출, FAL 이미지 생성, OpenAI 음성 합성, Browser Use 클라우드 브라우저)를 한 번에 쓸 수 있고, Modal 클라우드 터미널은 선택 기능입니다.
이미 다른 에이전트를 써 온 사람이라면 쌓인 기억과 스킬을 가져올 수 있어서 학습을 처음부터 다시 시작하지 않아도 됩니다. v0.22.5 릴리스 노트에도 들어간 import-agent는 OpenClaw, Claude Code, Codex CLI, Cursor를 대상으로 하고, 먼저 미리보기를 봅니다.
hermes plugins install agent-importers
hermes import-agent openclaw --dry-run   # 아무것도 바꾸지 않고 계획만 확인
hermes import-agent openclaw # 미리보기 후 확인을 거쳐 실행SOUL.md는 그대로 복사되고, MEMORY.md와 USER.md는 항목으로 나뉘어 기존 내용과 합쳐지며 중복이 제거됩니다. 스킬은 ~/.hermes/skills/openclaw-imports/로 들어갑니다. 모델, MCP 서버, 메신저 토큰과 허용 목록은 대응하는 설정으로 옮겨지고, 대응 기능이 없는 파일은 ~/.hermes/migration/openclaw/<시각>/archive/에 보관됩니다. API 키는 --migrate-secrets를 줘야만 옮기고 허용 목록에 있는 이름만 복사됩니다. 실행 전에 ~/.hermes/backups/에 복원용 압축 파일이 남고, 끝난 뒤에는 새 세션을 열어야 가져온 스킬과 기억이 적용됩니다.



