민감한 파일은 내 맥에 남기고 검색만 클라우드로 보내는 Perplexity 하이브리드 컴퓨트
맥에 남는 것과 클라우드로 가는 것의 경계를 따라가며 Privacy Gate의 네 판정, 0.6B 검문 모델 PII-Tracer의 수치, 첫 설정 순서를 풀었습니다.
고객 명단 CSV를 AI에게 맡기려면 지금까지는 번거로운 선택지뿐이었습니다. 클라우드 AI에 통째로 올리면 이름·전화번호·계좌가 서버로 가고, 올리기 전에 직접 가려 두자니 찾아 바꾸기를 돌려도 한두 군데는 빠지기 쉽고, 맥 한 대에서 도는 로컬 모델만 쓰자니 웹 검색과 큰 모델의 추론을 포기해야 했습니다. 어느 쪽이든 “가릴 것을 가리는 일”이 사람 몫이었습니다.
Perplexity가 9월 1일(UTC) 맥 앱에 넣은 하이브리드 컴퓨트는 그 일을 맥 위의 검문 단계에 맡깁니다. 이 글은 기능 소개보다 경계선을 그리는 데 시간을 씁니다. 무엇이 맥 구역에 남고 무엇이 클라우드 구역으로 건너가는지, 문을 지키는 0.6B 모델이 글자 위치를 어떻게 짚는지, 같은 이름이 여러 번 나오거나 글이 길어질 때 경계가 어디서 새는지를 공식 발표·도움말·모델 페이지·논문 수치로 따라갑니다. 상태와 수치는 2026-10-27 기준으로 공식 자료를 다시 열어 확인했습니다.
파일은 맥 구역에 두고 가려진 문장만 건너간다
아래 그림에서 점선 상자 두 개가 경계입니다. 벽을 넘는 화살표는 가려진 초안이 나가는 것과 대역이 섞인 답이 돌아오는 것, 둘뿐입니다.
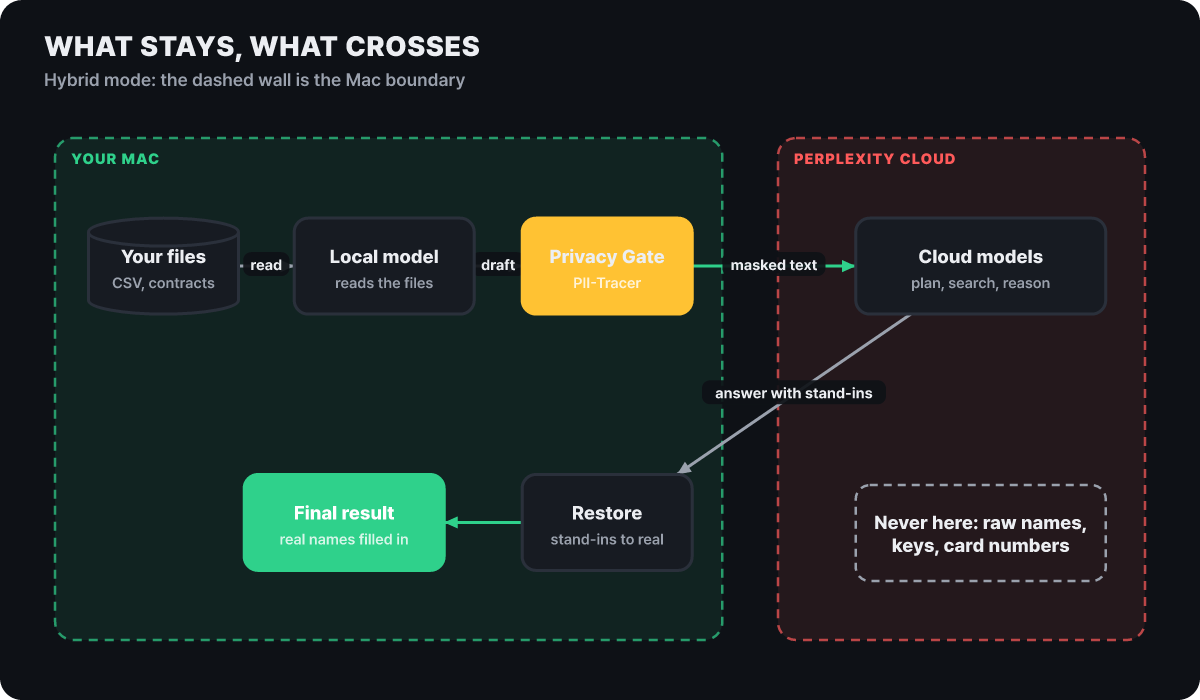 그림 1. 파일은 맥 구역을 떠나지 않는다. 클라우드는 계획·검색·추론을 맡고, 실제 값은 맥에서 채워진다
Perplexity의 설명은 이렇습니다. Computer 작업 하나를 클라우드 모델과 맥의 로컬 모델이 나눠 맡습니다. 계획 수립, 웹 검색, 어려운 추론은 클라우드가, 개인 파일과 민감한 단계는 맥이 맡고, 두 갈래의 결과는 하나의 산출물로 합쳐집니다. 작업은 클라우드에서 시작하므로 일이 시작되면 클라우드 쪽이 먼저 길을 잡고, 파일을 열어야 하는 단계에서 맥의 모델이 일합니다. 클라우드에서 시작한다는 것은 질문 문장과 계획이 경계를 넘는 쪽에 있다는 뜻이기도 해서, 뒤의 절에서 다시 짚습니다.
고객 목록 CSV를 읽고 고객마다 살 만한 맥을 조사하는 일을 예로 들면(편집부가 만든 예시입니다), 목록을 읽는 단계는 맥 안에서 끝나고, 최신 가격과 사양을 찾는 단계만 클라우드 모델이 맡습니다. 클라우드 모델은 “고객 A에게 어울리는 모델”을 조사하되 A의 실제 이름은 보지 못하고, 결과 표가 맥에 돌아온 뒤에 이름이 제자리를 찾습니다. 경계에 선 부품은 맥 위의 검문(Privacy Gate)입니다. 그림의 노란 상자가 그것이고, 뒤에서 판정 네 가지와 안쪽 모델을 차례로 뜯어 봅니다.
맥 쪽에 사는 부품: 모델 셋과 요건
맥 구역에 놓이는 것부터 정리합니다. 공식 도움말과 발표 기준으로 하이브리드는 Apple silicon 맥, macOS 15 Sequoia 이상, 통합 메모리 24GB 이상에서 쓸 수 있고, 32GB 맥에서 가장 좋은 결과가 난다고 안내합니다. 제품 페이지의 권장 메모리는 하이브리드 32GB, 완전 로컬 36GB입니다. 구독은 Perplexity Pro·Max·Enterprise 가운데 하나여야 합니다.
로컬 모델은 출시 때부터 세 가지입니다.
- Gemma 4 E4B: 작은 모델
- Qwen3.6 35B-A3B: 전문가 혼합 구조의 큰 모델
- Perplexity 모델: Computer용으로 후속 학습한 자사 모델
세 가지 중 하나를 앱 안내에 따라 한 번 내려받아 두면 됩니다. 비용 구조도 경계를 따라갑니다. 로컬 모델이 처리한 작업은 Computer 크레딧을 쓰지 않고, 클라우드에서 도는 단계는 다른 Computer 작업처럼 크레딧을 씁니다.
그렇다면 “어디서 무엇을 할지”는 누가 정할까요. 8월 25일 Perplexity 연구 블로그의 로컬 우선 에이전트 글은 조정 장치(오케스트레이터)를 LLM이 아닌 결정적 코드로 설명합니다. 루프를 돌리고, 컨텍스트를 조립하고, 정책을 집행하며, 모델이 제안한 도구 호출 중 승인된 것만 실행하는 역할입니다. 같은 글에는 클라우드 자문 모델을 부르기 전에 하네스가 관련 컨텍스트만 고르고, PII 분류기로 민감한 정보를 표시하고, 무엇이 기기를 떠나는지 사용자에게 보여 준다는 설명이 있습니다. 그 글은 Windows·Linux용 Portable Computer를 다루지만, 경계를 긋는 일을 모델의 기분이 아니라 코드와 정책에 맡긴다는 설계는 이 글의 주제와 그대로 이어집니다. 하이브리드 오케스트레이터는 6월에 처음 소개되었습니다.
검문소가 내리는 네 가지 판정
클라우드로 가는 길목에서 맥 위의 분류 모델은 보호 대상 파일의 내용이 밖으로 나가기 전에 아래 네 가지 중 하나를 고릅니다. 공식 도움말과 발표에서 확인되는 동작입니다.
| 판정 | 하는 일 | 어울리는 때 |
|---|---|---|
| 마스킹 | 값을 대역으로 바꿔 보내고, 최종 결과에서 원래 값으로 복원 | 이름·이메일처럼 값 자체를 몰라도 일이 되는 경우 |
| 로컬 유지 | 그 단계를 맥의 모델이 직접 처리 | 값을 읽고 계산해야 하는 경우 |
| 거부 | 해당 동작을 실행하지 않음 | 내보내면 안 되는 값이 일의 핵심인 경우 |
| 확인 | 보내도 되는지 사용자에게 먼저 물음 | 정책으로 가르기 애매한 경우 |
분류기가 찾는 대상은 이름, 주소, 계좌번호, 비밀 값(secret)입니다. 그중 자격 증명, 카드 번호, 정부 발급 신분증 번호는 가장 엄격한 묶음입니다. 이 값들은 로컬 유지나 거부로 처리되거나, 값을 뺀 채 요청을 다시 써서 클라우드 모델이 그 값 없이 일을 계속하게 합니다. 이름과 이메일, 전화번호는 마스킹이 주된 처리로 소개됩니다.
개인 사용자는 확인 창으로 판정을 정하지만 조직 계정에서는 관리자가 정합니다. Enterprise 관리자는 조직 전체 규칙으로 맥에 남겨야 할 것, 마스킹해도 되는 것, 클라우드로 보내기 전에 사용자 승인이 필요한 것을 지정하고, 데이터가 기기를 떠난 시점을 감사할 수 있습니다. 개인 파일이 걸린 일이라면 확인 창에서 “내 맥에서 처리”를 고르는 쪽이 이 기능의 취지에 맞고, 창을 습관적으로 승인하면 검문은 있으나 마나 해집니다.
이름 하나가 대역이 됐다가 돌아오는 길
마스킹이 어떻게 보이는지는 제품 페이지의 예시가 한 줄로 설명합니다. 이름·이메일·전화번호를 대역(stand-in)으로 바꿔 클라우드로 보내고, 클라우드 모델은 대역을 가지고 조사하며, 최종 결과가 돌아오면 실제 값이 복원됩니다. 앱이 화면에 보여 주는 대역의 모양은 공개되어 있지 않지만, 검문을 맡은 모델 PII-Tracer는 Hugging Face에 MIT 라이선스로 공개되어 있어서 같은 종류의 가림을 가짜 문장으로 직접 볼 수 있습니다. 모델 카드의 사용 예시를 줄이면 아래와 같습니다.
pip install torch "transformers>=5.2"from transformers import AutoModel
model = AutoModel.from_pretrained("perplexity-ai/PII-Tracer", trust_remote_code=True)
text = ("Hi, I'm Daniel Whitfield, you can reach me at "
"daniels@meridiancap.com or 415-555-0123.")
spans, sensitivity = model.predict(text) # 구간 목록과 대화 민감도 점수
for s in spans:
print(s.label, (s.start, s.end), text[s.start:s.end])
print(model.mask(text)) # 구간을 범주 이름의 대역으로 바꾼 문장trust_remote_code=True는 내려받은 저장소의 코드를 실행하겠다는 뜻이므로 신뢰하는 개발용 환경에서만 쓰세요. 모델 카드의 예시 결과는 private_person, private_email, private_phone 세 구간이고, 마스킹된 문장은 아래와 같습니다. 이름·이메일·전화번호는 모두 모델 카드에 실린 가짜 값입니다.
Hi, I'm [PRIVATE_PERSON], you can reach me at [PRIVATE_EMAIL] or [PRIVATE_PHONE].클라우드 모델은 이 문장 하나로도 “이 사람에게 보낼 제안서 초안”까지는 쓸 수 있고, 맥은 답이 돌아오면 대역 자리에 실제 값을 채웁니다. 이 방식이 성립하는 조건은 한 가지입니다. 같은 이름이 문서에 열 번 나오면 열 번 모두 같은 대역이 되어야 합니다. 한 줄이라도 놓치면 클라우드 모델은 그 줄에서 실제 이름을 읽게 되고, 한번 나간 값은 회수할 방법이 없습니다. 뒤의 두 절이 “여러 번 나오는 값”과 “긴 글”에 집중하는 까닭입니다.
글자 위치를 짚는 0.6B 인코더의 속
검문의 눈 PII-Tracer를 뜯어 봅니다. 파라미터 0.6B(약 6억 개)의 작은 모델이고, Qwen3 계열 인코더(pplx-embed-v1-0.6b)를 바탕으로 문장을 앞뒤 양쪽에서 읽도록 만든 구조입니다. 글을 만들어 내는 모델이 아니라 글자마다 라벨을 붙이는 분류 모델이라 작아도 일이 됩니다.
찾는 범주는 아홉 개입니다. 사람 이름, 계좌번호, URL, 날짜, 주소, 이메일, 전화번호, 기타 개인정보, 비밀 값입니다. 토큰마다 붙는 라벨은 “개인정보 아님” 하나에 범주별 4종(시작·중간·끝·한 토큰짜리)을 곱한 36개를 더한 37가지입니다. 이런 표기를 BIOES라고 부릅니다. 모델이 토큰마다 낸 라벨을 그대로 쓰면 “시작 없이 끝만 나오는” 앞뒤가 안 맞는 조합이 생길 수 있어서, 규칙에 어긋나는 조합을 막는 제약 디코더(Viterbi)를 거쳐 글자 구간으로 바꿉니다. 모델은 이와 별개로 대화 전체가 얼마나 민감한지를 점수로 내는 머리도 달고 있지만, 논문의 성능 수치는 구간 탐지 쪽만 다루므로 이 글의 수치도 그쪽입니다.
학습에는 다국어 대화와 한 건짜리 예시를 섞은 약 714,000건을 3회 반복해 썼습니다. 한 번에 읽는 길이는 4,096 토큰이고, 모델 페이지는 더 긴 입력이 잘리므로 먼저 나눠서 넣으라고 안내합니다. 배포 형태도 여럿입니다. 기본(PyTorch) 외에 vLLM(토큰 분류 서빙), GGUF(llama-server용), MLX(8비트 가중치, 별도 MLX 구현 필요)가 따로 공개되어 있습니다. 10월 27일 모델 페이지 기준으로 월 다운로드는 5,434회, 좋아요는 91개입니다. 모델은 MIT이고 논문(arXiv 2609.22200, 8월 31일 제출)은 CC BY-NC-ND 4.0으로 라이선스가 따로입니다.
앱은 이 모델이 낸 구간 목록을 받아 판정을 정합니다. 탐지 모델은 “여기가 이메일”이라는 신호까지만 내고, 마스킹할지 로컬에 둘지는 앞 절의 정책이 정합니다.
같은 이름이 여섯 번 나오면 새는 곳
Perplexity는 모델과 함께 평가 세트 PII-TRACE를 공개했습니다. 합성 대화 13,148건으로 13개 언어, 10개 문자 체계, 식별자 언급 37,431개에 글자 단위 정답이 달려 있습니다. 개인정보 라벨이 있는 대화 5,645건 가운데 63.8%는 같은 식별자가 두 번 이상 나오고, 28.7%는 여러 턴에 걸쳐 되풀이됩니다. 시험 세트에서 식별자 899개는 한 번만 나오고, 959개는 두 번 이상 나오며, 그중 790개는 여러 턴에 걸칩니다. 반복이 예외가 아니라 보통이라는 점이 이 평가의 핵심 설계입니다.
여기서 쓰는 “일관 탐지”는 한 식별자의 모든 언급을 전부 찾아야 성공으로 치는 지표입니다. 아래 그림은 같은 식별자가 나온 횟수별 점수입니다. 곡선이 얼마나 가파르게 내려가는지, 그리고 6~10회 칸에서 다른 시스템과의 간격이 얼마인지를 보면 됩니다.
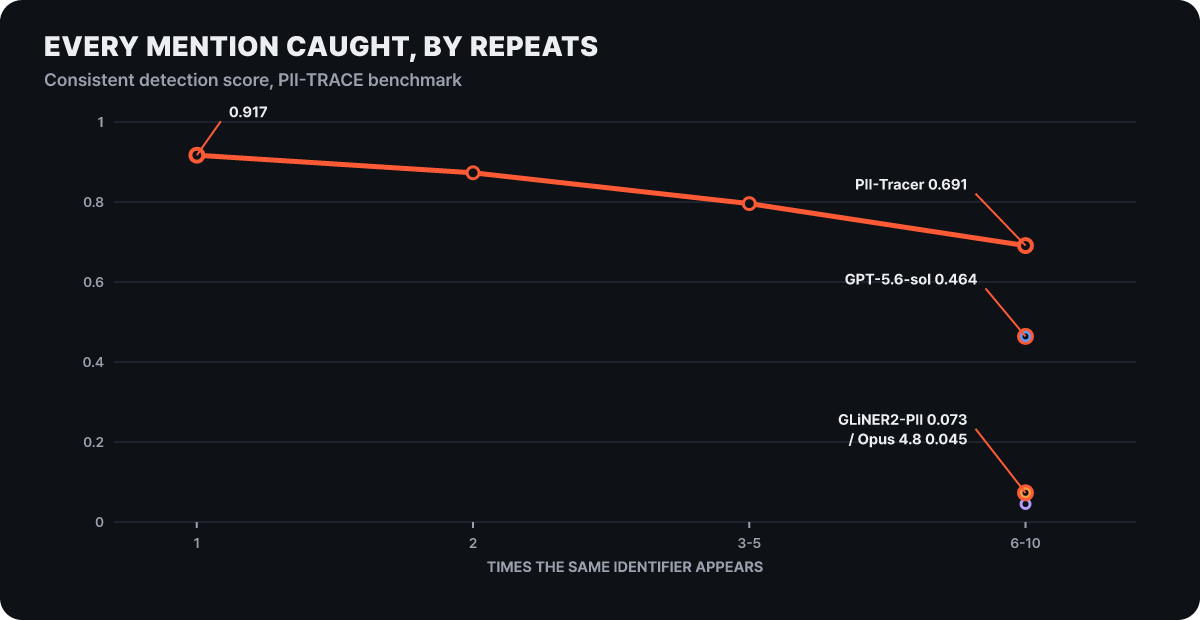 그림 2. 한 번 나올 때 0.917이던 점수가 6~10번 나올 때 0.691로 내려간다
1회에서 0.917, 2회에서 0.873, 35회에서 0.796, 610회에서 0.691입니다. 값이 많이 반복될수록 한 줄이라도 놓칠 기회가 늘어나니 곡선이 내려가는 것은 자연스럽습니다. 같은 칸의 비교 대상은 GPT-5.6-sol 0.464, 오픈 모델 GLiNER2-PII 0.073, Claude Opus 4.8 0.045였습니다. 반복되는 식별자를 끝까지 다 찾은 비율은 전체로 PII-Tracer 79.4%, GPT-5.6-sol 57.0%이고, 여러 턴에 걸친 식별자로 좁히면 77.6%와 55.1%입니다. 그래도 절대 수치로 읽으면 반복이 잦은 값 열 개 중 세 개 안팎(편집부 계산, 1−0.691)는 어딘가 한 줄을 놓친다는 뜻입니다.
전체 점수도 같은 맥락입니다. 글자 단위 F1(찾을 것을 얼마나 찾았는지와 찾은 것이 얼마나 맞는지를 합친 값, 1에 가까울수록 좋음)은 PII-Tracer가 0.629로 비교한 12개 시스템 중 1위입니다. 구간 단위 F1에서는 GPT-5.6-sol이 더 높고 PII-Tracer는 2위입니다. 1위라는 사실과 0.629라는 값을 함께 읽으면, 긴 다국어 대화 속의 반복되는 개인정보가 그만큼 어려운 문제라는 쪽이 정확합니다.
1만 자를 넘으면 시야 밖이 된다
두 번째로 새는 곳은 길이입니다. 모델의 창이 4,096 토큰이라 긴 글을 통째로 넣으면 뒷부분이 시야 밖에 놓입니다. 평가에는 길이별로 세 묶음이 있었습니다. 1,000자 미만 167건, 1,000~10,000자 1,292건, 10,000자 이상 463건입니다. 아래 막대에서 빨간 막대와 초록 막대의 차이를 봅니다.
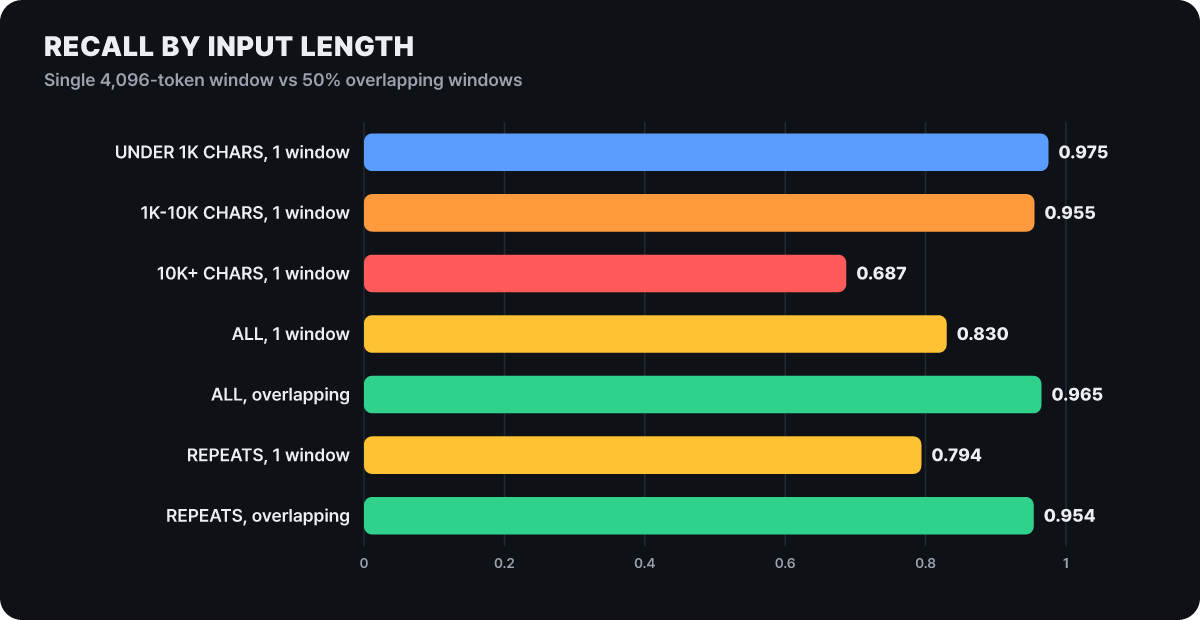 그림 3. 1만 자 이상에서 재현율이 0.687로 꺾이고, 창을 절반씩 겹치면 회복된다
1만 자 미만에서는 재현율이 0.955 이상으로 높습니다. 1만 자 이상에서는 0.687로 떨어지고 정밀도도 약 0.51에 머뭅니다. 그런데 같은 체크포인트를 재학습 없이 50%씩 겹치는 창으로 나눠 읽게 하자 전체 재현율이 0.830에서 0.965로, 여러 번 나오는 식별자의 일관 탐지가 0.794에서 0.954로 올랐습니다. 문제가 모델의 이해력이 아니라 입력을 덮는 범위였다는 이야기입니다.
단, 이 개선은 평가에서 모델을 그렇게 썼을 때의 결과이고 앱 안의 동작을 보증하는 값은 아닙니다. 직접 쓰는 쪽에서는 같은 방식을 코드로 옮길 수 있습니다. 아래는 편집부가 쓴 예시로, 글자 수와 토큰 수는 같지 않아서 한글 문서를 고려해 창을 2,000자로 잡았습니다. 평가에서 쓴 창 설정과는 다른 값입니다.
def find_spans(text, win=2000, stride=1000):   # 창의 절반을 겹쳐 가며 읽는다
    found, i = [], 0
    while True:
        spans, _ = model.predict(text[i:i + win])
        found += [(s.start + i, s.end + i, s.label) for s in spans]
        if i + win >= len(text):
            break
        i += stride
    found.sort()
    merged = []
    for a, b, lab in found:                    # 겹치는 구간은 하나로 합친다
        if merged and a <= merged[-1][1]:
            merged[-1][1] = max(merged[-1][1], b)
        else:
            merged.append([a, b, lab])
    return merged
합성 데이터에서 0.95, 사람이 표시한 TAB에서 0.594
모델 자체의 일반 실력은 다른 사람이 만든 평가에서 볼 수 있습니다. Perplexity는 OpenAI Privacy Filter와 외부 평가 다섯 개에서 글자 단위 F1을 견주었습니다. 아래 그림에서 회색 점이 Privacy Filter, 주황 점이 PII-Tracer이고, 선이 길수록 차이가 큽니다.
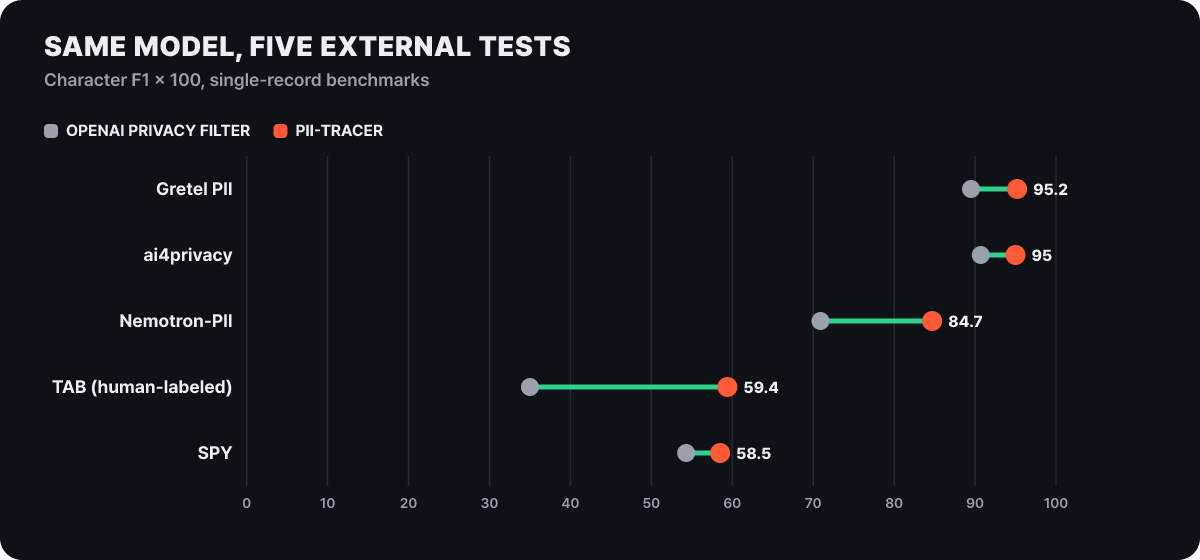 그림 4. 값은 F1에 100을 곱한 것. 모든 평가에서 PII-Tracer가 앞서지만 TAB와 SPY의 절대 값은 낮다
Gretel PII 0.952 대 0.895, ai4privacy 0.950 대 0.907처럼 합성 데이터에서는 두 모델 모두 0.9를 넘습니다. 점수가 확 내려가는 곳은 사람이 직접 표시한 유일한 데이터 TAB입니다(문서 127건). PII-Tracer가 0.594, Privacy Filter가 0.350입니다. TAB의 정밀도는 0.986 대 0.982로 비슷한데 재현율이 0.425 대 0.213이라, 두 모델 모두 찾은 것은 거의 맞지만 사람이 표시한 것의 절반도 못 찾습니다. 앞선 폭이 가장 큰 평가가 이 TAB라는 점은 좋은 소식이고, 절대 값이 낮다는 점은 합성 평가의 0.95를 실제 문서에 그대로 옮겨 읽으면 안 된다는 경고입니다.
평가의 범위도 함께 기억할 만합니다. 주 평가는 합성 대화이고, 도구 호출·에이전트 사이 메시지·이미지 입력은 평가 범위에 들어가지 않았으며, 비교한 시스템마다 추론 설정은 하나씩만 시험되었습니다. 그러니 이 수치는 “검문이 완벽하다”가 아니라 “어느 조건에서 얼마나 믿을지”를 가늠하는 기준입니다.
그래도 경계 밖으로 나가는 것들
경계를 지키는 모델이 아무리 좋아도 처음부터 경계 밖에 놓인 것이 있습니다. 하이브리드는 클라우드에서 시작하므로 질문 문장과 검색어, 계획은 클라우드로 갑니다. 검문이 가려 주는 것은 탐지된 개인정보이고, 탐지에서 빠진 값은 그대로 나갑니다. 클라우드로 아무것도 보내고 싶지 않다면 10월 20일에 추가된 완전 로컬 모드가 맞습니다.
하이브리드 컴퓨트
- 시작: 클라우드에서 시작해 개인 파일 단계만 맥으로 내림
- 클라우드로 나가는 것: 검문을 거친 요청(마스킹·확인)
- 권장 메모리: 32GB(최소 24GB)
- 로컬 모델: Gemma 4 E4B, Qwen3.6 35B-A3B, Perplexity 모델
완전 로컬
- 시작: 맥에서 시작해 계획·추론·파일 처리를 모두 맥에서 함
- 클라우드로 나가는 것: 사용자가 허락할 때만(최신 정보, 브라우저, 연결된 앱)
- 권장 메모리: 36GB
- 로컬 모델: Qwen 3.6, PPLX Pro
완전 로컬에서도 허락하면 15개 이상의 프런티어 모델 가운데 하나를 불러 어려운 추론을 맡길 수 있습니다. 모드는 작업마다 고릅니다. 메시지나 회의 초대를 보내는 단계는 AI가 도는 장소와 무관하게 해당 앱의 서비스를 거치고, 코드와 도구는 격리된 샌드박스에서 실행되며 맥 파일과 앱에는 허락한 범위에서만 접근합니다.
제품 페이지의 예시 두 가지가 경계가 그어지는 모습을 보여 줍니다. 투자 심의 자료(IC deck)를 다루는 하이브리드 예시는 기본·경영진·하방 세 시나리오로 모델을 다시 짜고 수익률을 점검하는 일은 맥에서, 비교 대상 거래를 찾는 일은 클라우드에서 합니다. 완전 로컬 예시는 맥 미니에서 포트폴리오 파일과 시장 데이터를 보고 집중도 한도를 넘는 종목 두 개와 목표에서 벗어난 묶음 세 개를 짚은 뒤 엑셀 파일과 회의 자료를 갱신합니다. 웹 조사가 필요한 일은 하이브리드, 파일 안에서 끝나는 일은 완전 로컬이 맞는 모양입니다.
원격으로도 쓸 수 있습니다. 아이폰에서 작업을 시작하면 로컬 단계는 연결된 맥이 처리하고, 항상 켜 둘 맥 미니는 권장 사항이지 필수가 아닙니다.
처음 돌려 볼 때의 순서
Perplexity 도움말이 안내하는 설정은 네 단계입니다.
- 최신 Perplexity 맥 앱을 내려받아 열고 Pro·Max·Enterprise 계정으로 로그인합니다.
- 안내에 따라 로컬 모델을 하나 내려받습니다. Gemma 4 E4B, Qwen3.6 35B-A3B, Perplexity 모델 중에서 고릅니다.
- 모델 선택기를 열어 Hybrid를 고릅니다.
- 이 작업에 쓸 로컬 모델과 클라우드 모델을 각각 정합니다.
첫 작업에는 진짜 파일을 쓰지 않는 편이 낫습니다. 지어낸 이름·전화번호·이메일 열 몇 줄짜리 CSV를 만들어 “고객별 안내문 초안을 써 줘” 같은 일을 시켜 보고, 어떤 열이 마스킹되고 어떤 항목에서 확인 창이 뜨는지 눈으로 봅니다. 같은 이름을 여러 줄에 넣고, 카드 번호처럼 가장 엄격한 묶음에 들어갈 가짜 값도 하나 섞어 두면 앞 절의 수치가 내 파일에서 어떻게 나타나는지 가늠하기 쉽습니다. 한 번 클라우드로 나간 값은 되돌릴 수 없으므로 이 확인은 실제 업무 파일보다 먼저입니다. 파일이 수만 자라면 한꺼번에 올리지 말고 나눠서 올리세요.
크레딧과 모델 단독 사용에 대한 두 질문
로컬 모델이 처리한 작업은 정말 크레딧이 들지 않나요?
로컬 모델이 처리한 부분은 Computer 크레딧을 쓰지 않습니다. 다만 구독(Pro·Max·Enterprise)이 먼저 필요하고, 같은 작업 안의 클라우드 단계는 다른 Computer 작업처럼 크레딧을 씁니다.
PII-Tracer만 따로 써도 되나요?
모델은 MIT 라이선스로 공개되어 있어 직접 내려받아 쓸 수 있습니다. 한 번에 4,096 토큰까지만 읽으므로 긴 글은 앞의 예시처럼 직접 나눠 넣어야 하고, 논문 파일의 라이선스(CC BY-NC-ND 4.0)는 모델과 별개이니 논문을 옮겨 쓸 때는 따로 확인하세요.
같은 경계를 맥 밖에서 긋는 방법들
맥의 하이브리드는 Perplexity가 이 문제를 푸는 방식 가운데 하나입니다. 날짜순으로 보면 4월에 Personal Computer, 6월에 하이브리드 오케스트레이터 소개, 8월 25일에 Portable Computer가 나왔고, 9월 1일에 맥 하이브리드가 나왔고, 10월 15일에 Computer 뒤의 샌드박스 플랫폼 SPACE가 오픈소스로 공개되었고, 10월 20일에 맥 완전 로컬 모드와 기관용 배포가 나왔습니다.
맥이 아니라면 Portable Computer가 있습니다. 도움말의 로컬 모델 표에는 Windows PC(AMD Ryzen AI Max, NVIDIA RTX)와 Linux PC(NVIDIA RTX), NVIDIA DGX Spark가 올라 있고, 모델은 Qwen 3.8 27B를 후속 학습한 PPLX 27B(일부 환경은 Qwen 27B도)입니다. 요건은 24GB 이상의 GPU 접근 메모리이며 Windows는 빈 디스크 약 20GB가 필요합니다. 맥의 하이브리드와 달리 모델과 에이전트가 기기에서 돌고, 클라우드는 최신 정보나 고급 추론이 필요할 때 사용자에게 먼저 묻고 올라갑니다. 조직 계정에서는 Windows·Linux의 로컬 추론 허용 여부를 관리자가 정합니다.
기관이 경계를 아예 자기 구역 안에 둘 수도 있습니다. 10월 20일 Perplexity는 Valarian과 손잡고 Computer를 기관의 자체 서버와 폐쇄망에서 돌리는 배포를 시작했습니다. 기관이 통제하는 인프라에서 Nemotron·GLM·Kimi·DeepSeek-R1·Qwen 같은 오픈 웨이트 모델을 쓰고, 작업은 데이터·도구·사용자·자격 증명 접근이 정해진 구역(enclave)으로 나뉩니다. 폐쇄망 배포에는 외부 모델 API나 공개 웹으로 가는 연결이 없습니다.
클라우드와 로컬 사이에서 질문마다 모델을 나누는 비용 쪽의 이야기는 LLM 라우팅 글에서 이어집니다.



