에이전트에게 컴퓨터와 금융 분석과 테스트를 맡기는 GitHub 저장소 4곳
컴퓨터를 쓰는 Cua, 금융 문서를 맡는 financial-services, 그림을 짓는 Anatomy, 문장으로 쓰는 테스트 e2e를 '끝났다는 확인은 누가 하나'로 가려 읽었습니다.
18일. Anatomy가 첫 커밋(10월 8일)을 올린 뒤 별 20,989개를 모으기까지 걸린 기간입니다. 같은 주에 별을 모으는 Cua는 633일 만에 31,020개, anthropics/financial-services는 245일 만에 40,802개, e2e는 96일 만에 11,938개입니다. 수치는 2026-10-26 18:30(UTC)에 저장소 페이지와 릴리스, 공식 문서에서 읽은 값입니다.
이 네 곳은 기능 목록으로는 같은 잣대에 올릴 수 없습니다. 하나는 에이전트에게 데스크톱을 내주고, 하나는 투자은행 업무 문서를 맡기고, 하나는 설명 그림을 짓게 하고, 하나는 앱 테스트를 문장으로 쓰게 합니다. 그래서 이 글은 모두에게 같은 질문 하나만 던집니다. 에이전트가 일을 끝냈다고 말할 때, 그 말이 맞는지 무엇이 확인해 주는가입니다. 답이 저장소마다 다르고, 그 차이가 곧 어디에 조심해야 하는지를 알려 줍니다.
Driver가 접근성 정보로 결과를 되읽어 응답에 확인 수준을 적는다. 읽지 못하면 못 읽었다고 말한다
외부 문서를 여는 하위 에이전트와 파일을 쓰는 하위 에이전트를 가르고, 마지막 서명은 사람이 한다
부품이 서로 관통하지 않는지 감사 스크립트가 따지고, 헤드리스 Chrome으로 이음매를 확대해 본다
뒤따르는 검증이 통과한 단계만 기록하고, 다음 실행은 그 기록으로 모델 없이 재생한다
열여드레에 2만 개, 633일에 3만 개
별 수는 인기를 말할 뿐 속도나 성숙도를 말해 주지 않습니다. 아래 그림은 첫 커밋부터 지난 일수를 가로(로그 눈금)에, 별 수를 세로에 놓은 것입니다. 일수는 첫 커밋부터 10월 26일까지 편집부가 센 값입니다.
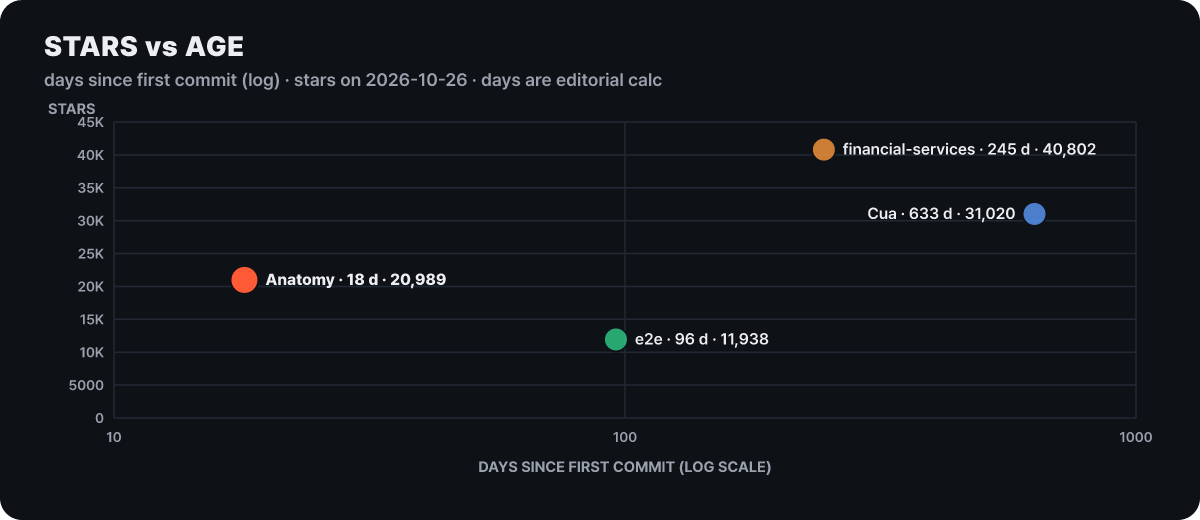 그림 1. 나이와 별 수. 가장 젊은 Anatomy가 e2e보다 위에 있다
Anatomy는 e2e보다 나이가 5분의 1도 안 되는데 별은 약 1.8배입니다. 반대로 financial-services는 가장 높은 곳에 있지만 main의 커밋은 73건이고 마지막이 9월 21일입니다. 저장소가 스스로 참조 템플릿이라고 부르듯 계속 바뀌는 제품보다 한 번 읽을 설계 모음에 가깝습니다. 움직임은 표에서 읽는 편이 정확합니다.
| 저장소 | 첫 커밋 | 커밋 수 | 가장 최근 움직임 | 라이선스 |
|---|---|---|---|---|
| Cua | 2025-01-31 | 5,989 | Spaces v0.16.0(10/25 정식), v0.17.0-beta.1(10/26 사전 릴리스) | MIT, Spaces는 FSL-1.1-MIT, 선택 확장은 AGPL 계열 |
| financial-services | 2026-02-23 | 73 | 마지막 커밋 9/21 | Apache-2.0 |
| Anatomy | 2026-10-08 | 153 | 10/18 인쇄 시트 추가, 릴리스 v1.1.0(10/12) | MIT |
| e2e | 2026-07-22 | 943 | 10/26에도 커밋, npm 0.21.3(10/23) | Apache-2.0 |
포크는 순서대로 2,271개, 5,697개, 1,692개, 627개이고 네 곳 모두 보관(archived) 상태가 아닙니다. e2e의 npm 패키지는 10월 19~25일 한 주 내려받기가 288,757회입니다.
여섯 가지 물건이 한 저장소에 든 Cua
Cua 저장소의 첫 문장은 “AI 에이전트에게 컴퓨터를 주라”입니다. 그런데 설치할 것을 찾으면 구성품이 여섯이라 어느 줄부터 쳐야 할지 헷갈립니다. README의 “길 고르기”를 용도로만 풀면 이렇습니다.
에이전트가 쓸 데스크톱(Space)을 만들고 메뉴 막대에서 관리하는 앱. 텔레포트와 멀티플레이어 포함
내 컴퓨터에 있는 앱과 브라우저를 CLI·MCP·SDK로 조작. macOS·윈도·리눅스
애플 실리콘에서 macOS·Linux 가상 머신을 만들고 관리
Python·TypeScript·Rust SDK. cua sb create ubuntu처럼 샌드박스를 만들고 다룸
폼 채우기 같은 짧은 결정을 내리는 소형 모델 연구 릴리스. 가중치는 Hugging Face에 따로 있음
컴퓨터 사용 에이전트용 작업을 만들고 평가하는 도구. 가상 머신 없이 시뮬레이션으로 시작
내 작업을 하는 컴퓨터에서 에이전트가 앱을 대신 눌러 주게 하려면 Driver, 에이전트에게 별도의 데스크톱을 통째로 빌려 주려면 Spaces입니다. 한 줄 설치 스크립트(cua.ai/install.sh)는 cua 명령을 항상 깔고, Spaces 앱은 기본 선택이지만 Driver는 기본 선택이 아닙니다. Driver를 더하려면 sh -s – –select cua-driver를 쓰고, 선택을 건너뛰려면 –only cua-driver를 씁니다. 나머지 셋(Lume, CUA-S1, Bench)은 가상 머신, 연구 모델, 평가 도구라서 일반 사용자가 먼저 만질 일이 적습니다. 아래부터는 쓰임이 큰 Driver와 Spaces를 봅니다.
Driver가 클릭을 믿기까지 오르내리는 네 단
널리 쓰이는 기본 방식은 화면 그림을 보고 좌표를 찍는 것입니다. Anthropic의 컴퓨터 사용 도구 문서가 그 틀을 보여 줍니다. 호출은 모두 개발자 쪽 애플리케이션이 실행하고, 도구는 screenshot, left_click, type, zoom 같은 화면 기준 동작이며, 문서는 전용 가상 머신이나 컨테이너, 접속 도메인 허용 목록, 결제 같은 결과가 큰 동작의 사람 확인을 권합니다. 이 틀에서 클릭이 먹혔는지는 다음 스크린샷을 보고 짐작해야 합니다.
Driver는 그 짐작을 줄이는 쪽입니다. 모델과 반복 루프는 에이전트(Claude Code, Codex, Cursor 등)가 돌리고, Driver는 에이전트가 제안한 한 단계를 실제 데스크톱의 관찰이나 행동으로 바꿔 결과를 알려 줍니다. 연결은 MCP(cua-driver mcp), 셸 명령(cua-driver call <도구>), SDK, 여러 클라이언트가 한 데스크톱을 같이 쓰게 하는 공유 데몬 네 가지입니다. 관찰은 트리 더하기 픽셀입니다. get_window_state를 부르면 창의 접근성 트리와 스크린샷이 한 번에 오고, 조작 가능한 요소마다 element_token이 붙습니다. 입력 도구는 click, type_text, press_key, hotkey, scroll, drag, move_cursor이고, 호출마다 창을 대상으로 할지(백그라운드가 기본) 화면 전체를 대상으로 할지(포그라운드만) 정합니다.
한 동작은 아래 계단을 위에서부터 내려갑니다. 각 단의 이름 옆에 적힌 것이 그 단에서 쓰는 수단이고, 오른쪽 상자가 응답에 담기는 확인 수준입니다.
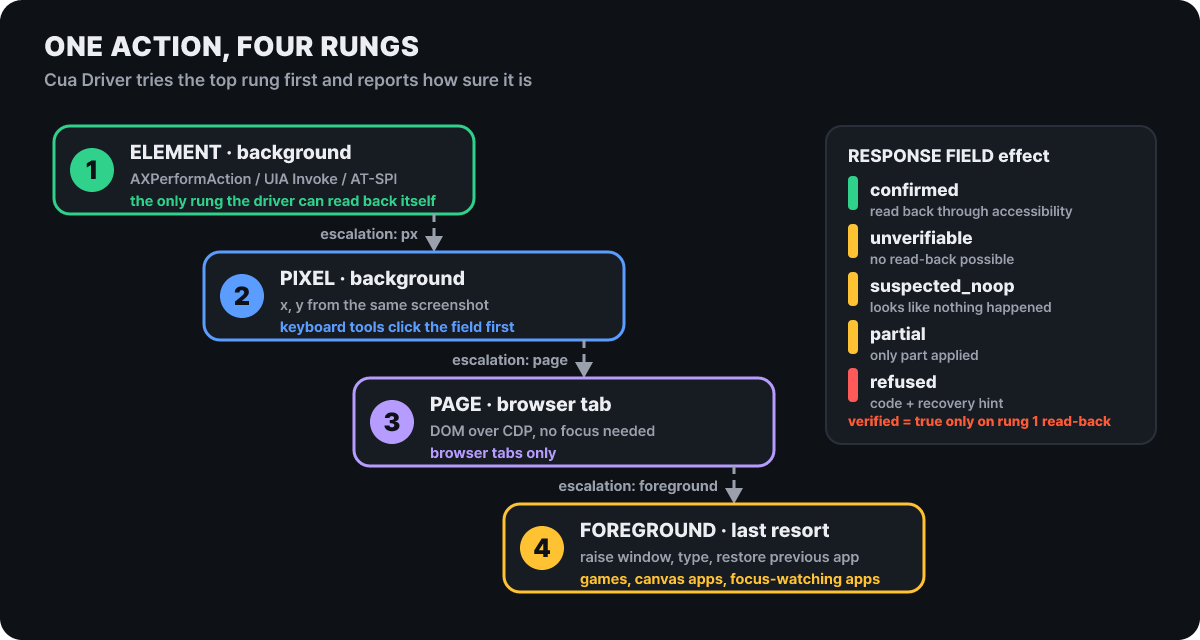 그림 2. Driver의 행동 계단. 위 단에서 확인되지 않으면 응답의 escalation이 다음 단을 권한다
계단에서 의미가 있는 것은 맨 위 단뿐입니다. 요소 토큰으로 접근성 동작을 직접 호출하는 1단은 Driver가 스스로 결과를 읽어 검증할 수 있는 유일한 단이고, 2단은 스크린샷 좌표로 넣는 입력, 3단은 개발자 도구 프로토콜(CDP)로 DOM에 닿는 방식, 4단은 창을 올려 입력하고 이전 앱을 되돌리는 마지막 수단입니다. 응답의 effect는 confirmed(접근성으로 읽어 확인), unverifiable, suspected_noop, partial, refused 중 하나이고, verified가 true가 되는 것도 읽어서 확인한 경우뿐입니다.
이 구분이 쓸모 있는 이유는 Electron·Catalyst·웹 콘텐츠가 쓰기를 되울리기만 하고 실제로는 적용하지 않는 일이 있기 때문입니다. 그런 경우 Driver는 성공이라고 우기지 않고 unverifiable이라고 답하고, 에이전트는 다시 관찰해야 합니다. 요소 토큰이 낡았다는 오류(stale_element_token)는 경로가 틀린 것이 아니라 창을 다시 스냅샷하라는 뜻입니다. 단별 지원 범위는 운영체제마다 다릅니다.
| 운영체제 | 입력과 관찰 | 막히는 곳 |
|---|---|---|
| macOS | 접근성 API, 창 범위 지정 이벤트, 창별 화면 캡처 | 접근성·화면 기록 권한 필요. 다른 Space에 있는 SwiftUI 창은 트리가 사라짐 |
| 윈도 | UI Automation, 대상 창 메시지 | 낮은 권한의 프로세스는 관리자 권한 앱에 입력 불가(우회하지 않고 거부). 데몬은 사용자 세션에서 실행 |
| 리눅스 X11 | AT-SPI, 창 지정 입력 | 툴킷에 따라 거부 |
| 리눅스 Wayland | 일반 원시 입력 불가 | 포커스 없는 창에는 background_unavailable을 돌려주는 것이 의도된 동작 |
브라우저 중 Brave·Vivaldi·Opera·Arc는 감지만 되고 릴리스 승인 전이며, Safari와 Firefox는 깔끔한 거부로 처리됩니다.
트리가 아예 없는 화면(캔버스 앱, 게임, 원격 데스크톱)을 위해 선택 확장 cua-perception이 있습니다. 스크린샷 한 장을 로컬 CPU에서 글자·아이콘·컨트롤 영역으로 해석하고 에이전트에게는 그림 바이트가 아니라 영역 경계와 글자만 넘깁니다. 한 장 해석에 macOS는 22.5초, 리눅스는 3.54초, 윈도는 8~9초가 걸린다고 공식 문서가 적었고, 각 해석은 capture_id에 묶여 60초가 지나면 만료됩니다. 이 확장은 MIT가 아닙니다. 아이콘 검출기가 AGPL-3.0-only라서 재배포하거나 네트워크로 서비스하면 소스 공개 의무가 생길 수 있고, README는 설치 전에 고지문을 읽으라고 안내합니다.
계산기 6×7로 첫 결과를 보는 순서
Driver의 첫 시험은 계산기입니다. 아래는 퀵스타트의 명령을 순서대로 옮긴 것이고, 윈도와 리눅스는 설치 줄과 데몬 시작 줄이 다릅니다.
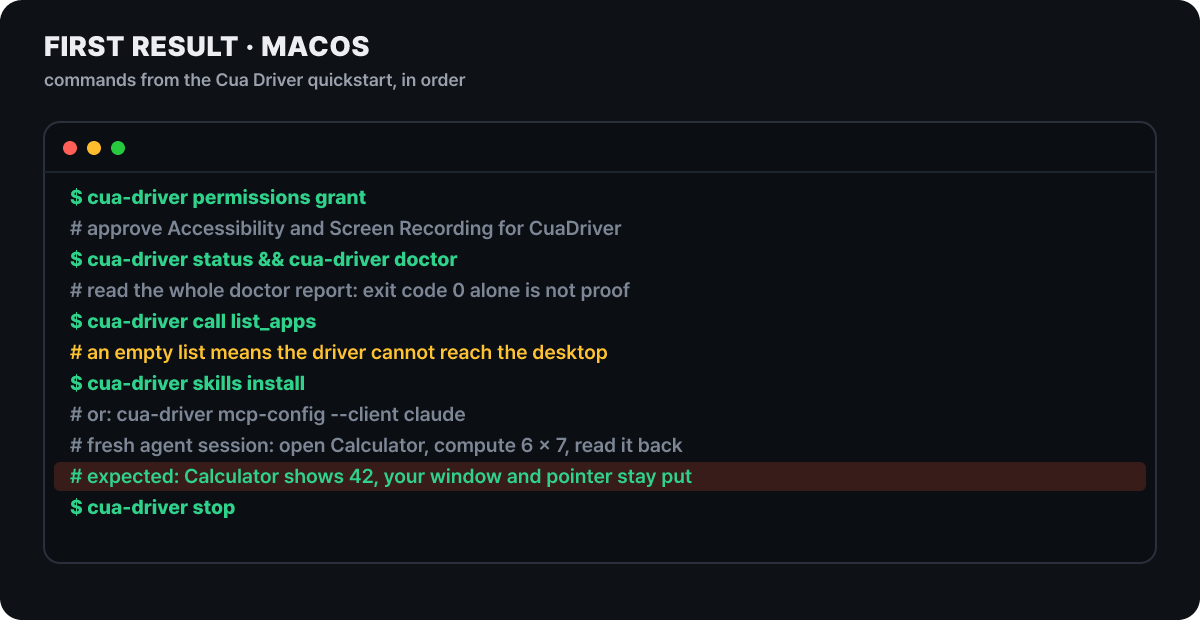 그림 3. macOS 첫 시험. 주석은 퀵스타트가 각 줄에 붙인 설명
설치 줄은 /bin/bash -c “$(curl -fsSL https://cua.ai/driver/install.sh)” 형태로, 내려받아 바로 실행하는 방식이 마음에 걸리면 스크립트를 먼저 열어 읽고 실행하면 됩니다. 권한 프롬프트에는 허용 대신 시스템 설정 열기가 나오고, 거기서 CuaDriver를 켭니다. 거부하면 Driver는 데스크톱을 보지도 조작하지도 못합니다. doctor는 종료 코드가 0이어도 보고서를 끝까지 읽어야 하고, list_apps가 비어 있으면 계산기를 열어 다시 시도합니다. 에이전트에는 스킬(cua-driver skills install)이나 MCP 설정으로 연결하고, 새 세션에서 이렇게 시킵니다.
Using the Cua Driver skill, open the installed calculator app, compute 6 × 7, and read the displayed result back from a fresh snapshot.
기대 결과: 계산기에 42가 뜨고, 에이전트는 마지막으로 읽은 값을 보고한다. 내 창, 키보드 포커스, 포인터는 그대로이고 화면에서 움직이는 커서는 에이전트의 오버레이다
“새 스냅샷에서 읽어 오라”는 문구가 중요합니다. 기억으로 42라고 답하지 않고 앱을 다시 읽게 하기 때문입니다. 이 시험이 보여 주는 것은 계산이 아니라 내 작업이 끊기지 않는다는 점이고, 코딩 에이전트에게 앱 화면 확인을 시키면서 내가 문서를 계속 쓰는 상황이 첫 쓸모입니다.
한계도 같은 문서에 있습니다. 세션이 여럿이어도 화면·키보드·포커스는 하나이고 네이티브 입력은 한 번에 하나씩 처리되므로, 에이전트 여러 개를 같은 데스크톱에서 동시에 굴리는 용도는 아닙니다. 연결마다 암묵 세션이 생기고 유휴 5분이면 정리되며 요소 토큰도 함께 무효가 됩니다. HTTP로 여는 MCP 리스너는 기본으로 꺼져 있고, 켜려면 포트 환경 변수와 베어러 토큰이 필요합니다.
최신 안정판은 10월 21일 05:26(UTC)의 Driver 0.38.0입니다. 노트에 따르면 개발자가 자기 하네스를 만들 수 있도록 cua-sdk와 프로토콜 계약을 공개했고, 수정 25건이 윈도·macOS·리눅스에 나뉘어 들어갔으며, 리눅스 GNOME 50 이상 도우미를 안전하지 않게 시작하는 경우를 거부하도록 바뀌었습니다. 한 줄이 눈에 띕니다. 모든 Cua 클라이언트에서 침해된 eMudhra 중간 인증서를 신뢰하지 않게 했다는 것입니다. 왜 그 인증서들이 막혔는지는 브라우저가 인증기관 8곳을 막은 이유 글에서 다뤘습니다. 야간 빌드(0.38.1-nightly)는 10월 25~26일에도 나왔습니다.
Spaces에서 로그인이 건너가는 길
Spaces는 에이전트에게 별도의 데스크톱을 주는 앱입니다. Space는 내 맥에서 로컬로 만든 macOS 가상 머신이거나 Linux 이미지이고, 내가 가진 다른 기기나 내 클라우드 계정(AWS, Google Cloud, Modal)에서도 돌릴 수 있습니다. 퀵스타트 기준 요구 사항은 macOS 26 이상 맥, 윈도 PC(미리보기), Ubuntu 24.04 중 하나와 Claude Code·Codex·Cursor 같은 에이전트입니다. macOS Space에는 애플 실리콘 맥과 약 50GB의 여유 디스크가, Linux Space에는 Docker 같은 컨테이너 엔진이 필요합니다. 앱의 시작 화면에서 에이전트마다 Connect를 눌러야 Cua가 그 에이전트의 설정 파일에 도구를 추가하고, 이미 열려 있던 에이전트는 다시 시작해야 합니다. 무료 계정은 다른 내 컴퓨터에서 이 컴퓨터의 Space에 접속할 때만 필요합니다.
가장 독특한 기능은 텔레포트입니다. 로그인해 둔 Chrome이나 Slack을 Space로 옮기면 그곳에서 로그인된 채 열립니다.
- 앱과 범위 고르기앱마다 전체(설치와 로그인 상태), 설치만, 지원 안 함으로 갈리고 파일도 함께 옮길 수 있음
- 동의 화면설치 항목의 고정 버전·체크섬, 옮길 파일·폴더, 상태 항목을 전부 나열. 승인 전에는 아무것도 실행되지 않음
- 비밀은 따로 확인쿠키·토큰·로그인은 별도 동의에 macOS의 Touch ID나 암호 요구
- Space에서 열림파일은 Space의 Teleported 폴더, 앱은 로그인된 채로
브라우저는 “로그인 유지”, “저장된 비밀번호”, “방문 기록” 세 가지가 기본으로 꺼져 있고 사이트별 개수를 보고 골라서 보냅니다. 로그인 서비스(인증 제공자) 사이트는 자동으로 선택되지 않습니다. 저장된 Chrome 비밀번호 파일을 그대로 옮기면 Space의 Chrome이 복호화하지 못하므로 cua keyvault import-passwords 경로를 쓰고, 이 경로에서는 에이전트가 비밀번호 자체를 보지 못한 채 로그인합니다.
텔레포트된 로그인은 살아 있는 로그인입니다. Space를 조종하는 사람은 누구든 그 계정으로 행동할 수 있습니다. 문서의 권고는 내가 소유한 Space로만 옮기고, 가능하면 전체 세션 대신 탭 범위(tabs)를 쓰라는 것입니다. 텔레포트는 오픈소스 SDK 패키지에는 없고 Cua Spaces 앱에만 들어 있습니다.
요금은 가격 페이지 기준입니다. 한도는 내 네트워크에서 직접 연결하는 Space에는 적용되지 않고 cua.ai 릴레이를 거쳐 원격으로 접속할 때의 세션 수와 시간에 걸리며, 넘겨도 끊기지 않고 업그레이드 안내가 뜹니다.
| 플랜 | 연 결제(월 환산) | 월 결제 | 릴레이 세션 | 월 원격 시간 |
|---|---|---|---|---|
| Free | $0 | $0 | 2개 | 20시간 |
| Pro(1인) | $15 | $18 | 5개 | 200시간 |
| Teams(1~100좌석) | 좌석당 $25 | 좌석당 $30 | 좌석당 5개를 팀 풀에 합산 | 좌석당 200시간을 합산(2좌석이면 10개·400시간) |
라이선스는 세 겹입니다. SDK, cua 명령, Driver, Lume은 MIT이고 README는 MIT 부분이 FSL 부분에 의존하지 않는다고 밝힙니다. Spaces 앱, cua-spacesd, Keyvault, 텔레포트는 FSL-1.1-MIT로, 쓰고 자체 호스팅하고 그 위에 만들 수 있지만 경쟁하는 호스팅 서비스는 금지이고 각 릴리스는 출시 2년 뒤 MIT가 됩니다. Cua Driver Bench도 10월 11일 이후 버전부터 FSL입니다. 앞서 본 선택 확장 둘(cua-som, cua-perception)은 AGPL 계열입니다.
최근 움직임은 이렇습니다. 10월 25일 21:36(UTC)에 Spaces v0.16.0이 정식으로 나왔고 기능 3건과 수정 14건이 들어 있습니다. 제거 스크립트(uninstall-local.sh)가 로컬 설정과 캐시를 지우고, 이 맥을 릴레이에서 빼고, 코딩 에이전트 쪽 항목까지 지우도록 바뀐 것이 쓰는 사람에게 가장 의미 있습니다. 다음 날 08:35(UTC)에 v0.17.0-beta.1이 사전 릴리스로 올라왔습니다.
예전 글을 보고 cuabot을 설치했다면 지금 지워야 합니다. README가 “알려진 보안 문제가 있어 실행하지 말라”고 표시한 폐기 패키지이고, 정리 절차는 다음과 같습니다. 대체는 MCP로 연결한 Driver나 cua 명령의 샌드박스입니다.
cuabot --stop                          # 이름 붙인 세션이 있으면 세션마다
npm uninstall -g cuabot
docker rm -f cuabot-xpra
docker images -q trycua/cuabot | xargs docker rmi
rm -rf ~/.cuabot
금융 에이전트 10종과 외부 문서를 여는 단 하나의 자리
anthropics/financial-services는 투자은행, 주식 리서치, 사모펀드, 자산관리 업무용으로 Anthropic이 낸 참조 에이전트와 스킬, 데이터 연결 모음입니다. 모든 파일이 마크다운과 JSON이라 빌드 단계가 없고, 같은 원본을 Claude Cowork 플러그인으로 쓰거나 Claude Managed Agents API로 배포합니다. README 맨 위의 경고가 이 저장소를 읽는 틀입니다. 이 에이전트들은 검토를 받을 분석 초안(모델, 메모, 리서치 노트, 대사 결과)을 만들 뿐 투자를 권유하거나 거래를 실행하거나 장부에 기록하거나 온보딩을 승인하지 않고, 모든 결과는 사람의 서명을 기다립니다. 이 글도 투자 판단을 권하는 것이 아니라 도구를 소개하는 것입니다.
| 영역 | 에이전트 | 하는 일 |
|---|---|---|
| 영업·자문 | Pitch Agent | 비교 기업·선례 거래·LBO 분석으로 발표 자료를 끝까지 작성 |
| Meeting Prep Agent | 고객 미팅 전 브리핑 묶음 | |
| 리서치·모델링 | Market Researcher | 업종·주제를 받아 산업 개요, 경쟁 구도, 비교 기업, 아이디어 후보 |
| Earnings Reviewer | 실적 발표와 공시를 읽어 모델 갱신, 노트 초안 | |
| Model Builder | DCF·LBO·3개 재무제표를 엑셀에 직접 작성 | |
| 펀드 운영·재무 | Valuation Reviewer | 운용사 자료를 받아 평가 템플릿 실행, 투자자 보고 대기 |
| GL Reconciler | 원장과 보조원장의 차이를 찾고 원인 추적 | |
| Month-End Closer | 발생 비용, 잔액 이월, 차이 설명 | |
| Statement Auditor | 배분 전 투자자 명세서 점검 | |
| 온보딩 | KYC Screener | 서류 해석, 규칙 엔진, 제재·정치적 주요 인물 목록 대조 |
열 개 중 안전 구조를 가장 자세히 보여 주는 것이 GL Reconciler의 Managed Agents 쿡북입니다. 이 에이전트가 읽는 수탁기관·거래 상대의 명세서는 외부인이 쓴 문서이므로 에이전트를 속이는 지시문이 들어 있을 수 있습니다. 쿡북은 그 문서 속 문장이 셸, 쓰기 도구, 회사 시스템에 닿지 못하게 구역을 나눕니다.
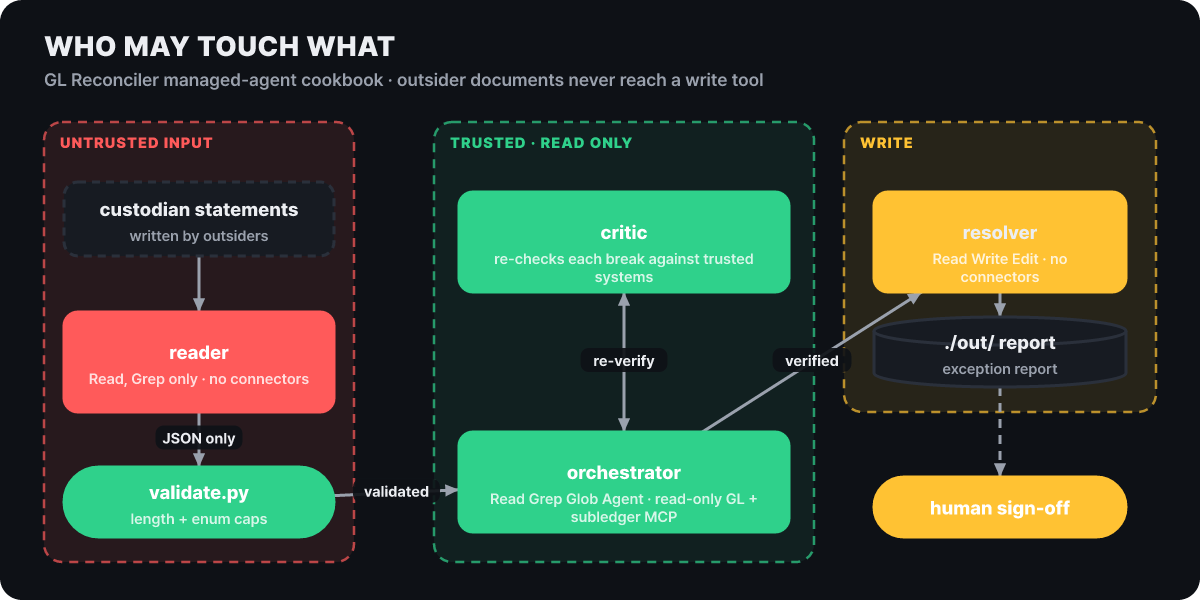 그림 4. GL Reconciler의 권한 구역. 외부 문서를 여는 곳과 파일을 쓰는 곳이 겹치지 않는다
그림에서 외부 문서가 닿는 곳은 왼쪽 구역의 reader 하나입니다. reader는 Read와 Grep만 쓸 수 있고 연결된 시스템이 없으며, 내보내는 것은 스키마를 통과한 JSON뿐입니다. 스키마가 구체적입니다. 자산군 이름은 32자 이내, 계좌 값은 64자 이내에 영숫자와 . _ : -만, 차이 목록은 500건 이내, 의심 원인은 temporal_cutoff, system_drift, reclass, unknown 네 값 중 하나, 근거 링크는 10개 이내에 각 256자 이내이고 정의하지 않은 항목은 허용하지 않습니다. 검증은 scripts/validate.py가 하고, 쿡북은 문서에 박힌 지시문이 이 문턱을 통과해 온전히 살아남지 못하게 하려는 장치라고 설명합니다.
가운데 구역의 orchestrator는 일을 나누고 모으며 읽기 전용 원장·보조원장 연결만 가집니다. critic은 reader가 보고한 차이를 신뢰하는 내부 시스템으로 독립 재검증하고, 그 결과를 받은 orchestrator가 검증된 묶음을 resolver에게 넘깁니다. resolver는 유일하게 Write 권한이 있지만 외부 문서는 열지 못하고 예외 보고서를 ./out/에 씁니다. 쿡북 README는 이 에이전트가 기록 시스템에 아무것도 쓰지 않으며 원장 조정은 에이전트 밖에서 사람이 승인한다고 적습니다.
월말 대사 한 줄이 지나는 길
에이전트를 움직이는 것은 문장 하나입니다. 쿡북의 조종 예시 파일(steering-examples.json)에 세 가지가 들어 있습니다.
Reconcile GL vs subledger, trade date 2026-04-30, classes: equities, fixed-income, derivatives
일일 실행. 자산군 세 개를 지정한다
Reconcile GL vs subledger, trade date 2026-03-31, classes: all, threshold: 10000
월말 실행. 자산군 전체에 변동 임계값 10,000을 명시한다
Re-trace break: account 41200-EQ-US, trade date 2026-04-30
후속 조종 이벤트. 방금 나온 차이 하나만 깊게 다시 추적한다
한 번의 실행은 잔액 조회, 비교와 차이 분리(자산군마다 reader), 원인 추적, critic의 재검증, resolver의 보고서 작성 순서로 흐르고, 거래일과 자산군을 주면 임계값을 넘는 차이 목록, 건별 거래 수준 근거와 원인 분류, 통제자 서명용 예외 보고서가 나옵니다.
같은 틀로 다른 에이전트도 읽을 수 있습니다. Earnings Reviewer는 종목 코드와 분기를 받아 FactSet·Daloopa 연결로 실적을 가져오고, 요약이 아니라 전체 콜 녹취를 불러오고, 가이던스와 어조와 경영진이 피한 질문을 읽고, 모델을 고치고, 엑셀 점검 스킬로 균형·깨진 링크·계산 칸의 직접 입력값을 확인한 뒤 초안 상태로 멈춥니다. 모든 숫자에 출처를 달고 출처를 댈 수 없는 숫자에는 [UNSOURCED]를 붙이며 외부에 게시하지 않는 것이 규칙입니다. KYC Screener는 온보딩 서류에서 법인명, 실소유자, 주소를 뽑고 규칙 엔진의 통과·실패를 근거와 함께 적고 제재·정치적 주요 인물·부정 보도 대조 결과를 신뢰도와 함께 모아 에스컬레이션 묶음을 만듭니다. 서류를 읽는 하위 에이전트에는 같은 격리가 적용되고 위험 등급 결정은 컴플라이언스 담당자 몫입니다.
설치는 두 길입니다.
# Claude Code: 마켓플레이스 추가 → 핵심 플러그인을 먼저 → 에이전트
claude plugin marketplace add anthropics/financial-services
claude plugin install financial-analysis@claude-for-financial-services
claude plugin install gl-reconciler@claude-for-financial-services

# Managed Agents API: 키를 환경 변수로 두고 배포 스크립트 실행
export ANTHROPIC_API_KEY=...        # 본인 키
scripts/deploy-managed-agent.sh gl-reconciler
Cowork에서는 설정의 플러그인 추가에 저장소 URL을 붙여 넣거나 plugins/ 아래 폴더를 zip으로 올립니다. 슬래시 명령 /comps, /dcf, /earnings, /ic-memo 같은 것은 수직 플러그인(investment-banking, equity-research, private-equity 등)에서 따로 설치합니다. 데이터는 FactSet, S&P Global, Moody’s, PitchBook, LSEG, Morningstar, Daloopa 같은 제공사의 MCP 주소로 연결하는데 제공사 구독이나 키가 필요할 수 있다고 README가 안내합니다. 하위 에이전트에 일을 넘기는 기능(callable_agents)은 연구 프리뷰입니다.
시험은 에이전트 하나, 가짜 데이터로 합니다. 쿡북이 쓰는 연결은 내부 원장·보조원장 서버(GL_MCP_URL, SUBLEDGER_MCP_URL)처럼 우리 회사 시스템에 맞춰 바꿔야 하는 값이므로, 격리 구조와 JSON 문턱을 우리 규정에 맞게 고친 뒤에 실제 연결을 붙이는 순서가 안전합니다.
Anatomy가 그림 하나에 거는 검증
wheresryan22/anatomy는 Claude Code 같은 에이전트에게 설명 그림을 물으면 그 개념이 곧 작동 원리인 물체를 만들어 주는 스킬입니다. “캐시 키가 모두 맞아야 일을 건너뛴다”는 문장 대신 핀이 전부 맞아야 돌아가는 핀 텀블러 자물쇠를 만들고, 한 GPU 컨텍스트가 여러 캔버스를 섬기는 구조는 하나의 인쇄 머리가 16칸을 오가는 겐트리 플로터로 그립니다. 결과는 작은 부품 수십 개로 만든 등각 투영 도해이고, 제목·힌트·실시간 수치가 적힌 카드에 담겨 포인터와 키보드에 반응해 천천히 움직입니다. 화면의 수치는 부품을 움직이는 같은 작은 모델에서 나오므로 그림과 숫자가 어긋나지 않습니다.
이 저장소가 다른 세 곳과 다른 점은 만드는 일보다 검증하는 일에 쓰는 도구가 더 많다는 것입니다. SKILL.md가 정한 순서는 진짜 숫자 모으기, 물체 발명, 부품 목록, 세계 계획, 키트로 기하를 한 번 구성, 뒤에서 앞으로 칠하기, 틀, 움직임, 그리고 비평가의 눈으로 하는 검증입니다. 검증 쪽 도구는 다음과 같습니다.
| 도구 | 무엇을 거르나 |
|---|---|
kit/audit.mjs |
어떤 부품도 다른 부품을 관통하지 않는지, 모든 끝이 마운트에 놓였는지, 겹침이 깊이 순서로 풀리는지 |
capture.mjs, drive.mjs |
헤드리스 Chrome으로 스크린샷과 확대, 느린 컨택트 시트를 찍어 이음매를 눈으로 확인 |
lines.mjs |
공중에서 끝나는 선을 실패로 처리 |
turn-check.mjs |
3D(베타) 부품이 돌 때의 궤도 점검 |
출력은 세 종류입니다. 핵심 형식은 SVG(독립 HTML 페이지, 단독 .svg 파일, React/Next.js 컴포넌트)이고, 불·물·빛이 필요한 그림은 SVG에 WebGL 셰이더를 더해 같은 등각 카메라 안에 그립니다(WebGL이 없으면 SVG만 남습니다). 3D 베타는 돌아가는 다이얼이나 구부러지는 손가락처럼 실제로 도는 부품을 만들며 움직이는 부품만 매 프레임 다시 투영합니다. 10월 18일에는 만든 그림을 A4·Letter PDF로 뽑는 인쇄 시트(scripts/print.mjs)가 추가되었습니다. 포스터 1쪽, 도면 1쪽, 상세 2쪽의 세 형식이고 저장소 변경 이력의 미배포 항목에 들어 있습니다.
설치와 첫 사용은 두 줄입니다.
npx skills add wheresryan22/anatomy -g/anatomy explain how a token bucket rate limiter works, interactiveAPI 키는 필요 없고 설치할 의존성도 없습니다(Node 내장 모듈만 사용, Node 20.10 이상). Claude Code, Antigravity, OpenCode, Codex, MiniMax Code에서 쓸 수 있고 Codex에서는 $anatomy로 부릅니다. 저장소 전체(예시 포함 약 10MB)가 복사됩니다. 검증에 헤드리스 Chrome을 띄우므로 Chrome이나 Chromium이 있어야 하고, Codex의 샌드박스가 Chrome을 막으면 그림은 만들어지지만 검증만 실패합니다. 그때는 해당 명령을 샌드박스 밖에서 실행하도록 승인하면 됩니다. README는 그림이 아니라 설명할 개념과 실제 숫자(크기·개수·비율·임계값)를 줄 것, 놓일 곳(독립 HTML, .svg, React 컴포넌트)과 밝은·어두운 테마를 말할 것을 권합니다. 평가용 프롬프트에는 “연결 10개짜리 풀에서 요청이 빌리고 반납하고, 모두 바쁘면 대기열에 선다”는 식의 숫자가 들어 있습니다.
한계는 솔직하게 적혀 있습니다. 차트 라이브러리가 아니라서 축과 계열이 있는 데이터 그래프는 만들지 않고, 기계·도구·가구 같은 사물을 그리며 사람이나 정확한 지도는 그리지 않습니다. 일부러 느립니다. 3D 모드의 전체 궤도 검증은 부품 30개에 1520분이 걸리고, 부품 380개짜리 시험용 손은 1,440px 폭에서 약 20fps가 나왔습니다. 변경 이력에는 스킬이 사용자에게 소요 시간을 말하지 않게 바꾼 기록이 있는데, 3090분이라는 추정이 실제 빌드보다 길었기 때문입니다.
e2e가 두 번째 실행에서 모델을 부르지 않는 이유
tester-army/e2e는 웹과 모바일 앱의 종단 간(end-to-end) 테스트 프레임워크입니다. 목표를 자연어로 쓰면 에이전트가 앱을 조작해 달성하고, 같은 테스트 안에서 로케이터와 단언문으로 결과를 검사합니다. 요구 사항은 Node 24.8 이상(Node 22는 22.22.3 이상)이고 윈도는 WSL에서 돌립니다.
import { test, expect } from 'e2e';

test('a member upgrades to Pro', async ({ app, agent, screen }) => {
  await app.open('/settings/billing');

  await agent.act('upgrade the workspace to the Pro plan');
  await agent.assert('the invoice preview shows a prorated amount');

  await expect(screen.getByRole('status')).toContainText('Pro');
});
한 테스트 안에 세 종류의 줄이 섞여 있고, 비용과 실패 방식이 서로 다릅니다.
| 종류 | 예 | 누가 판단하나 | 모델 호출 |
|---|---|---|---|
| 목표 | agent.act |
에이전트가 동작을 고르고 목표를 이루면 반환, 실패하면 예외 | 첫 실행에만. 뒤의 검증이 통과하면 이후는 기록 재생 |
| 의미 단언 | agent.assert, waitFor, extract |
모델이 화면의 의미를 판정 | 매번 |
| 로케이터 | screen.getByRole와 expect |
정해 둔 요소를 직접 확인 | 없음 |
재생의 원리가 이 글의 질문과 맞닿아 있습니다. agent.act 단계는 뒤따르는 검증이 통과한 뒤에야 기록됩니다. 검증으로 치는 것은 로케이터 매처, toHaveURL, waitFor, agent.assert 같은 것이고, 단계가 그냥 끝났다는 사실이나 agent.extract, 다른 act는 검증으로 치지 않습니다. 에이전트가 맞게 했는지를 따로 확인한 단계만 다음 실행으로 넘어가는 셈입니다.
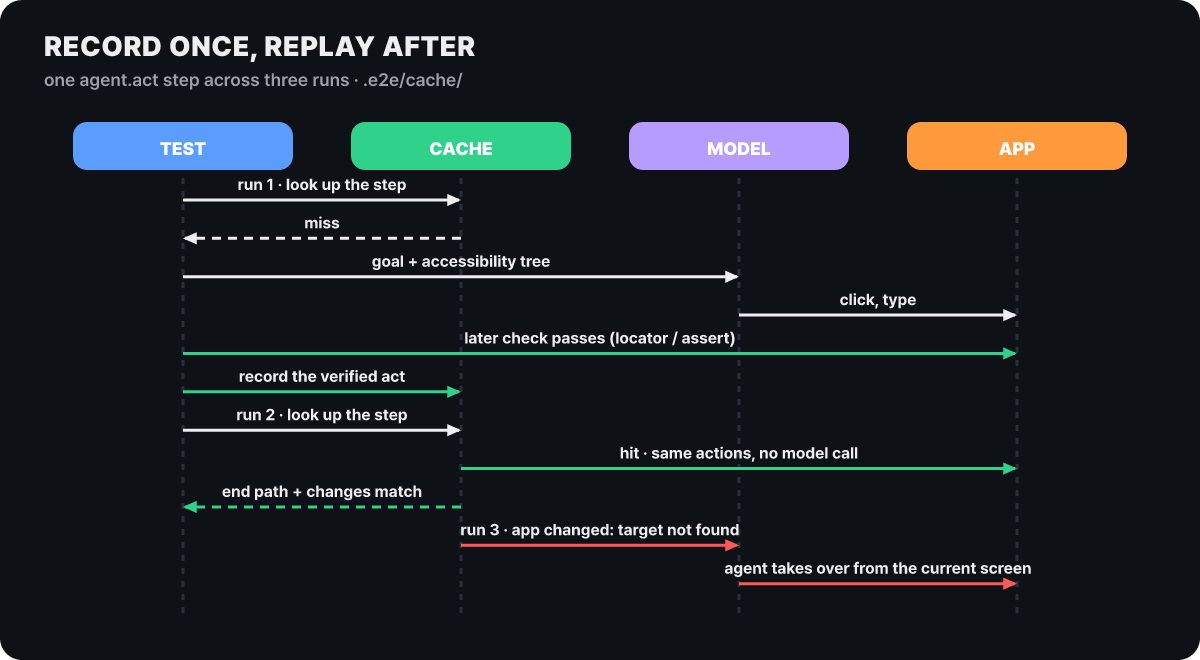 그림 5. 한 단계가 세 번의 실행을 지나는 길. 초록은 모델을 부르지 않는 경로, 빨강은 에이전트가 이어받는 경로
두 번째 실행에서는 시작 경로가 맞는지 보고, 기록된 컨트롤을 역할·이름·테스트 ID·주변 맥락으로 찾아 같은 동작을 반복하고, 끝 경로와 변화를 확인합니다. 앱이 바뀌어 기록이 맞지 않으면 그 자리의 화면에서 에이전트가 이어받습니다. 기록에는 동작, 대상 설명, 입력한 글자, 단계 요약, 끝 확인(경로와 나타나거나 사라진 컨트롤 각 8개까지)이 들어가고, 프롬프트와 스크린샷과 비밀 값은 들어가지 않습니다. 그 말은 비밀이 아닌 입력은 입력한 그대로 저장된다는 뜻입니다. 기록은 테스트, 타깃, 지시문, 매개변수, 에이전트가 같을 때만 재생되므로 테스트 이름을 바꾸거나 파일을 옮기거나 지시문 문장을 고치면 새로 기록되고, 모델을 바꾸는 것은 기록을 무효로 만들지 않습니다. 실행마다 달라지는 값(시각, 새 이메일)은 unique()로 감쌉니다. 한 단계가 동작 50개를 넘거나 4,096자를 넘게 입력하거나 비밀이 섞이면 기록되지 않습니다.
실행 모드는 셋입니다. 로컬 기본은 재생과 기록을 모두 하는 read-write, CI 환경 변수가 있고 캐시를 따로 설정하지 않으면 재생만 하는 read-only, 한 번만 전부 모델로 돌리는 –no-cache입니다. 여기에 CI의 함정이 하나 있습니다. e2e init이 .e2e/cache/를 .gitignore에 넣기 때문에, 기록을 저장소에 커밋하지 않으면 CI는 기록이 하나도 없는 채로 시작합니다. CI에서는 재시도가 켜지는데 재시도는 재생하지 않으므로, 기록 없이 CI에서 돌리면 에이전트 줄이 매번 모델을 부릅니다. 공유하려면 그 줄을 지우고 기록을 커밋한 뒤 풀 리퀘스트에서 검토합니다. 재생이 깨졌을 때 조용히 모델로 넘어가지 않고 실패하게 하려면 –strict-cache를 쓰며 REPLAY_STALE(종료 코드 2)로 끝나고 재시도하지 않습니다.
시작은 이렇게 합니다.
npx e2e init    # 웹(Playwright)/모바일, 모델 제공자 선택 → e2e.config.ts와 예시 테스트 생성
npx e2e run     # 예시 테스트 실행. --headed 로 웹 테스트를 눈으로 볼 수 있음
생성되는 예시 테스트는 모델 호출이 없어 로그인이나 API 키가 필요 없습니다(웹은 /를 열어 body가 보이는지, iOS는 설정 앱의 General 버튼을 확인). 모델은 ChatGPT·GitHub Copilot 구독 로그인, API 키(Vercel AI Gateway, OpenRouter, OpenAI 호환), 로컬 모델 중 고릅니다. 웹은 Playwright로 Chromium·Firefox·WebKit을, 모바일은 시뮬레이터와 에뮬레이터를 씁니다. examples/에는 Vite, Next.js, Astro, Angular, Expo, SwiftUI, Jetpack Compose, Kotlin Multiplatform, Flutter, .NET MAUI별로 통과하는 프로젝트가 있습니다. main 브랜치에는 10월 26일에 e2e init이 웹과 모바일을 함께 고르게 하는 변경이 합쳐졌고, npm 안정판은 0.21.3, nightly는 0.21.4 계열입니다. 저장소가 스스로 “1.0으로 가는 활발한 개발 중”이라고 밝히므로 API와 설정이 마이너 릴리스 사이에 바뀔 수 있습니다.
보안 문서가 인정하는 구멍을 알고 시작해야 합니다. 비밀은 모델에 이름과 용도만 보이고 러너가 직접 입력하며 이후 그 시도에서는 모델 스크린샷이 꺼지지만, 영상은 아무것도 가리지 않고 command.log는 앱 출력을 그대로 담으며 비밀의 일부(끝 네 글자, base64 변환)는 가림막을 통과합니다. 출처 허용 목록이 없어 에이전트가 앱을 따라 다른 사이트로 가서 그 단계의 비밀을 쓸 수 있고, 테스트·설정·앱 명령은 샌드박스 없이 내 OS 권한으로 돕니다. 신뢰할 수 없는 풀 리퀘스트의 코드는 비밀 없는 외부 샌드박스에서 돌리고 모델 키는 신뢰하는 CI 빌드에만 주라는 것이 문서의 지침입니다. CLI는 익명 사용 데이터(테스트·앱 내용과 자격 증명은 제외)를 보내며 npx e2e telemetry disable 또는 E2E_TELEMETRY_DISABLED=1로 끕니다.
같은 일을 다른 길로 하는 곳
컴퓨터 쓰기의 기준선은 앞에서 본 Anthropic의 컴퓨터 사용 도구 문서이고, 거기서 Driver가 어떤 틈을 메우는지 비교해 보면 됩니다. 브라우저 안만 필요하다면 Chrome DevTools MCP처럼 브라우저 전용 도구가 더 좁고 단순한 길입니다. Driver와 financial-services 쿡북은 모두 MCP로 도구와 데이터를 연결하므로 그 개념이 낯설다면 MCP 입문 글을 먼저 읽는 편이 빠릅니다.
Anatomy처럼 폴더 하나를 에이전트에게 설치하는 방식의 다른 후보는 에이전트 스킬 저장소 4곳 글에 모아 두었습니다. 에이전트 줄이 없는 e2e 테스트는 모델 없이 돌기 때문에, 로케이터 줄만 있는 테스트로 시작해 에이전트 줄을 하나씩 늘리는 도입이 가능합니다. 금융 쪽은 에이전트 하나(GL Reconciler)의 정의 파일과 쿡북의 subagents/reader.yaml을 읽는 것만으로도 격리 설계를 따라 쓸 수 있습니다.



