OpenAI·Anthropic·로컬 모델을 한 앱에서 쓰는 오픈소스 Cherry Studio
Cherry Studio를 입구(제공자·가져오기), 내부(채팅·지식 베이스·에이전트), 출구(API 게이트웨이·채널·백업)로 나눠 훑고, 구역마다 켜기 전에 볼 것을 정리했다.
어제는 Claude에서 풀던 문제를 오늘은 다른 모델에게도 물어보고 싶은데, 대화를 복사해 옮기는 순간부터 번거로워집니다. 서비스마다 API 키가 따로 있고, 키는 메모장과 셸 설정과 각 도구의 환경 변수에 흩어져 있고, 회사 문서를 읽히려면 서비스마다 파일을 다시 올려야 합니다. 기록은 각 서비스 안에 갇혀서 나중에 검색할 방법도 없습니다. Cherry Studio는 이 흩어짐을 앱 한 개로 모으려는 오픈소스 데스크톱 클라이언트로, Windows·macOS·Linux용이고 모바일 앱은 따로 있습니다.
2026-10-27 UTC에 GitHub에서 확인한 값은 별 52,999개, 포크 5,132개, 기여자 414명입니다. 저장소는 2024년 5월 24일에 만들어졌고, 최신 릴리스는 10월 26일 08시 56분에 나온 v2.1.8입니다. 기능이 많은 앱이라 기능 이름을 차례로 읽으면 어디에 무엇이 있는지 잡히지 않습니다. 이 글은 데이터가 앱으로 들어오는 곳, 앱 안에 머무는 곳, 앱 밖으로 나가는 곳으로 기능을 나눠 지도로 보고, 구역마다 켜기 전에 확인할 것을 짚습니다.
기능 수십 개를 데이터 방향으로 나눈 지도
공식 문서의 “고급 기능 지도”는 기능 목록이 아니라 “무엇을 하고 싶은가”에서 출발해 입구를 고르게 합니다. 이 글은 한 걸음 더 나아가 같은 기능을 데이터의 방향으로 다시 묶었습니다. 아래 그림에서 왼쪽은 키와 자료가 들어오는 입구, 가운데는 모델 전환기를 중심으로 채팅·지식 베이스·에이전트가 있는 내부, 오른쪽은 모델과 에이전트를 앱 밖으로 내주는 출구입니다.
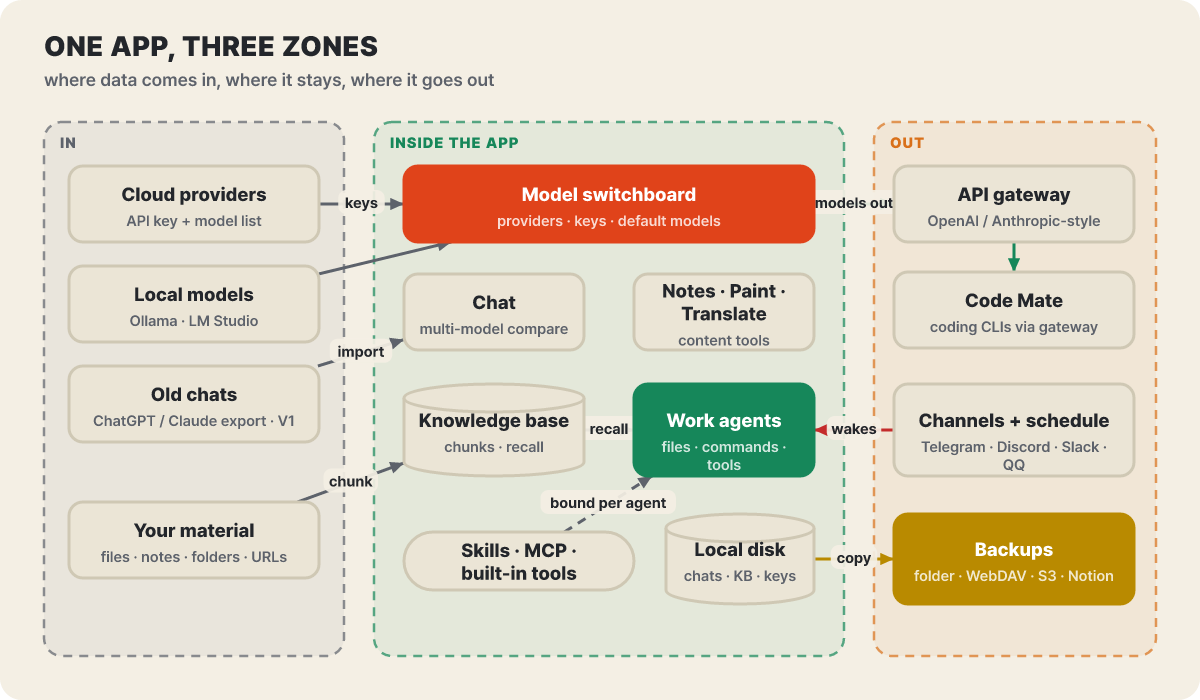 그림 1. 한 앱의 기능을 세 구역으로 나눈 지도. 화살표는 데이터가 움직이는 방향
그림에서 화살표가 가장 많이 모이는 곳은 모델 전환기와 에이전트입니다. 모델 전환기에 등록한 제공자가 채팅, 에이전트, 게이트웨이에 모두 쓰이기 때문에, 키 하나를 어떻게 등록했는지가 나머지 구역의 안전을 정합니다. 에이전트는 반대로 밖에서 들어오는 메시지(채널, 예약)에 깨어나는 유일한 곳이어서 권한 설정이 중요해집니다. 앱의 설정 화면은 이 지도와 비슷한 다섯 묶음으로 갈립니다.
| 설정 묶음 | 담긴 것 | 지도에서의 자리 |
|---|---|---|
| Models | 모델 제공자, 기본 모델, 로컬 모델(오프라인으로 도는 임베딩·OCR 모델), API 게이트웨이 | 입구와 출구 |
| Tools | MCP, 스킬, 웹 검색, 문서 처리, OCR | 내부 |
| Preferences | 일반(프록시·개발자 모드), 외형, 알림, 데이터(백업), 보관함, 사용 통계 | 출구(백업) |
| Efficiency | 채널, 예약 작업, 단축키, 빠른 어시스턴트, 선택 어시스턴트 | 출구와 내부 |
| System | 실행 환경 의존성(uv, bun 등), 버전 정보와 피드백 | 앱 자체 |
입구 하나: 제공자 일곱 유형과 키 입력
연결 템플릿은 60여 개가 들어 있지만 앱은 제공자를 프로토콜로 일곱 유형으로 나눠 다룹니다. 유형을 알면 템플릿에 없는 서비스도 붙일 수 있습니다.
| 유형 | 호환 프로토콜 | 대표 예 |
|---|---|---|
| OpenAI 호환 | /v1/chat/completions | OpenAI, DeepSeek, SiliconFlow, OpenRouter, 대부분의 중계 서비스 |
| Anthropic 호환 | /v1/messages | Anthropic, CherryIN 등. Cherry Agent는 이 유형이 필요 |
| Gemini | Google AI Studio·Vertex | Gemini, Vertex AI |
| Bedrock | AWS Bedrock SDK | AWS Bedrock |
| Azure OpenAI | Azure OpenAI Service | Azure OpenAI |
| 로컬 추론 | 내 컴퓨터의 HTTP 서비스 | Ollama, LM Studio, GPUStack, OpenVINO Model Server |
| 특수 게이트웨이 | 벤더 전용 프로토콜 | NewAPI, OneAPI, AiHubMix, DMXAPI 등 |
제공자를 붙이는 순서는 네 칸입니다. 설정의 모델 제공자에서 제공자를 고르고, API 키를 넣고, “모델 동기화”로 채팅·임베딩·비전 모델을 추가한 다음, 필요하면 “모델 확인”으로 아무 채팅 모델 하나로 연결을 시험합니다. 이어서 채팅 화면에서 방금 추가한 모델을 골라 첫 메시지를 보내 응답이 오면 기본 설정이 끝난 것입니다. API 주소는 기본값이 제공자의 공식 주소이고, 주소 끝에 #을 붙이면 고정 경로를 쓰며, 키는 여러 개를 돌려 쓰도록 등록할 수도 있습니다.
설치 파일을 고르는 일에서 의외로 시간을 쓰는 사람이 많습니다. Windows는 일반(x64) 빌드와 ARM 빌드가 있고, macOS는 Apple Silicon용과 Intel용 DMG, Linux는 .deb, .rpm, .AppImage가 있습니다. 칩이 헷갈리면 터미널에서 읽기 전용 명령 하나로 확인합니다.
uname -m
# x86_64 이면 x64 빌드, aarch64 또는 arm64 이면 ARM64 빌드
키 없이 쓰는 방법은 두 가지입니다. 하나는 Ollama·LM Studio로 모델을 내 컴퓨터에서 돌려 로컬 추론 유형으로 연결하는 것입니다. 다른 하나는 개발사의 내장 모델 서비스인데, 이쪽은 요청이 개발사의 중계 서비스를 거치므로 백업 절의 데이터 표에서 따로 다룹니다. 모델 확인이 통과한 제공자 하나로 시작하고, 나머지는 쓸 때마다 하나씩 늘리는 편이 오류 원인을 가리기 쉽습니다.
입구 둘: 옛 대화와 V1 데이터 들여오기
새 앱에 처음 앉으면 가장 아쉬운 것이 이미 쌓인 대화입니다. 설정의 데이터에서 “외부 앱 데이터 가져오기”를 열면 ChatGPT 또는 Claude 내보내기 파일(conversations.json)을 읽어 옵니다. Claude에서는 설정의 개인정보 메뉴에서 데이터 내보내기를 요청하고, 메일로 온 파일을 풀어 그 안의 conversations.json을 고르면 됩니다. Claude 대화는 텍스트, 생각 과정, 도구 호출, 도구 결과가 함께 들어오고, ChatGPT와 Claude 모두 대화의 분기가 유지됩니다. 이미지와 첨부 파일은 오지 않습니다.
Cherry Studio를 이미 V1으로 쓰던 사람은 사정이 다릅니다. V2는 덮어쓰기 업데이트가 아니라 데이터 구조를 바꾼 버전이어서, 날짜 순서를 알아 두면 이전 절차가 이해됩니다.
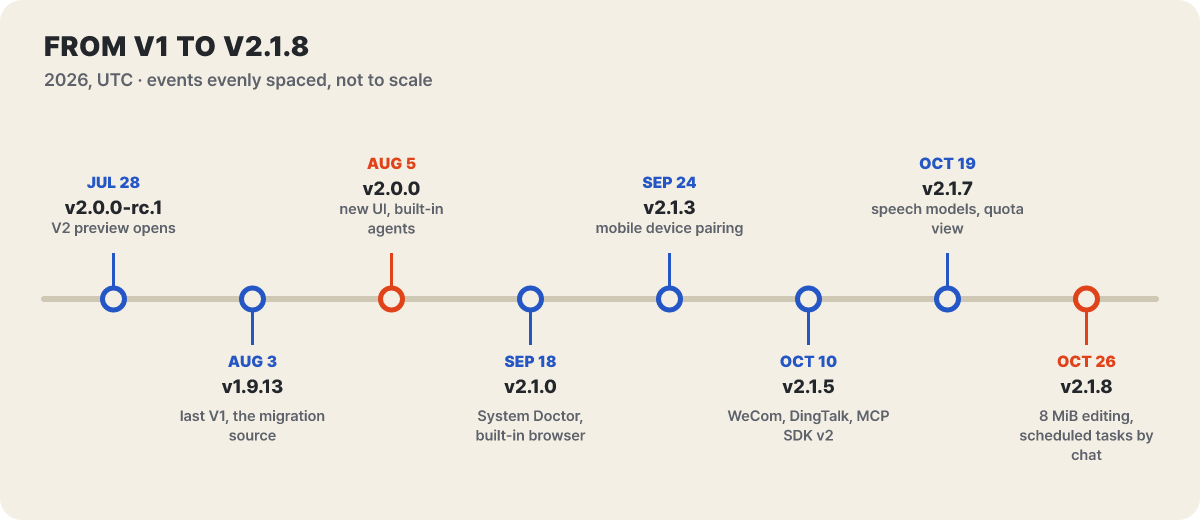 그림 2. V1의 마지막 버전 1.9.13이 V2 정식판(8월 5일)보다 이틀 먼저 나왔다. 간격은 축척이 아니다
V2 정식판 이후 v2.1.8까지 82일 동안 안정 릴리스가 22개 나왔습니다. 월별로는 8월 10개, 9월 8개, 10월 4개(26일까지)입니다(편집부 집계). 이 속도에서 V1 사용자가 지켜야 할 길은 하나뿐입니다. 1.9.13이 이전의 출발점입니다. V1 데이터는 V2로 한 방향으로만 옮겨지고, V2에서 만든 데이터를 V1로 되돌리거나 두 버전의 백업 파일을 서로 복원할 수는 없습니다.
V1 → V2 순서. V1을 1.9.13으로 올려 한 번 정상 실행하고, “압축 백업(Compact Backup)“을 끈 채 전체 백업을 만들고, 앱을 완전히 종료한 뒤 V1 데이터 폴더를 통째로 복사해 두고 나서 V2를 설치합니다. 이전 마법사가 읽는 것은 백업 ZIP이 아니라 현재 V1 데이터 폴더입니다. 이전 뒤에는 제공자·키·기본 모델, 에이전트 도구 권한, 지식 베이스 연결을 점검하세요. Anthropic OAuth 로그인은 이전되지 않아 API 키로 다시 등록해야 합니다. “다시 이전(Re-migrate)“은 현재 V2 데이터를 영구 삭제하고 V1에서 다시 가져오는 기능이니 이전이 실패했을 때만, 그것도 현재 V2 데이터의 전체 백업을 먼저 만든 뒤에 씁니다.
채팅 구역: 같은 질문을 모델 셋에게
내부 구역의 첫 문은 채팅입니다. 입력 영역의 모델 선택에서 다중 선택을 켜고 비교할 모델을 고르면, 질문이 모델마다 따로 나가고 답이 나란히 옆에 놓입니다.
새 구독 가격 정책 초안이야. 실현 가능성, 위험, 비용 세 관점에서 평가해 줘.
편집부가 만든 예시. 모델 3개를 고르면 요청도 3개가 나가고, 응답 3개가 한 화면에 나란히 표시된다.
세 답에서 서로 다른 사실 주장만 뽑아 표로 정리해 줘.
문서가 권하는 사용법의 핵심은 순서입니다. 먼저 목표, 자료, 제약, 원하는 출력 형식을 질문에 다 적고, 그다음에 비교가 필요한 경우에만 모델을 늘립니다. 여러 모델은 질문의 빈틈을 대신 채워 주지 않고 답의 차이만 키우기 때문입니다. “어느 쪽이 낫냐”고만 물으면 가장 긴 답을 고르게 되니, 사실이 서로 일치하는지, 가정이 드러나 있는지, 빠진 것이 무엇인지를 비교하라는 안내가 붙어 있습니다.
모델을 늘리지 않는 편이 나은 경우도 분명합니다. 구체적인 사실 하나를 찾거나 짧은 글을 다듬을 때는 모델 한 개가 화면도 사용료도 단순합니다. 그리고 여러 제공자에게 보내면 안 되는 내용이 든 질문은 모델을 셋 고르는 순간 세 곳으로 전달됩니다. 긴 대화는 컨텍스트 사용량을 보고 요약해 새 주제로 넘어가고, 답을 기다리는 동안 다음 질문을 메시지 대기열에 넣어 둘 수 있습니다. 파일이나 코드를 이어서 다뤄야 하면 답의 아티팩트 미리보기에서 내려받거나 새 작업으로 넘깁니다.
문서 구역: 질문이 조각을 거쳐 답이 되는 순서
지식 베이스는 파일·노트·폴더·웹 페이지를 계속 다시 찾아볼 수 있는 자료 묶음으로 바꿉니다. 모든 자료가 지식 베이스로 가야 하는 것은 아닙니다. 문서는 상황별로 갈림을 이렇게 가릅니다.
| 상황 | 권하는 방식 | 이유 |
|---|---|---|
| 사내 규정·제품 설명서·프로젝트 자료를 반복해서 찾기 | 지식 베이스 | 자료를 재사용하고 안정적으로 인용해야 함 |
| 첨부 파일 하나를 한 번만 분석 | 채팅에 바로 업로드 | 색인과 관리가 필요 없음 |
| 자료를 아직 정리하는 중 | 노트에서 먼저 정리 | 확정 전 내용이 공식 답으로 취급되지 않음 |
| 장기적으로 자동 처리 | 지식 베이스를 만들어 에이전트에 연결 | 에이전트가 같은 범위의 자료를 계속 사용 |
답 하나가 만들어지는 과정을 행위자별로 풀면 아래와 같습니다. 눈여겨볼 곳은 4번째 화살표입니다.
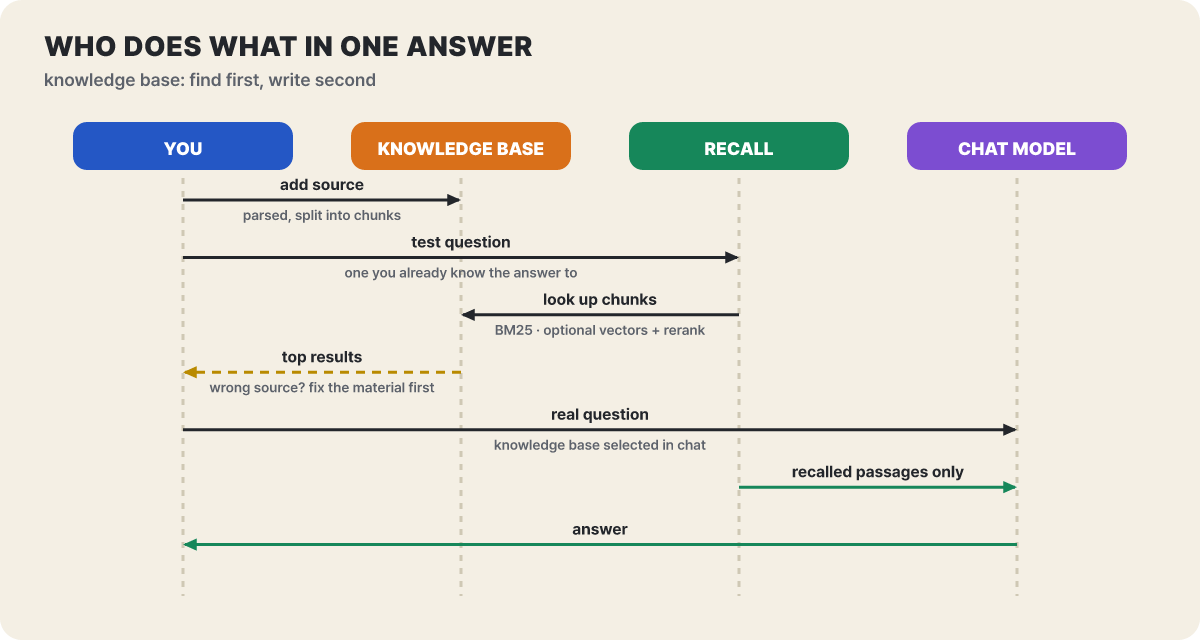 그림 3. 채팅 모델은 검색이 건넨 조각만 보고 답을 쓴다. 위쪽 결과가 틀리면 아래쪽 모델을 바꿔도 소용없다
4번째 화살표에서 시험 결과가 틀렸다면, 모델을 더 좋은 것으로 바꾸기 전에 자료와 설정부터 고쳐야 합니다. 채팅 모델은 검색이 찾아 준 조각만으로 답을 쓰므로 핵심 문장이 조각에 없으면 어떤 모델도 메울 수 없습니다. 공식 문서가 용어로 정리해 둔 것도 이 순서입니다. 자료를 작게 쪼갠 조각이 청크, 질문에 맞는 조각을 찾는 과정이 호출(recall)입니다. 의미는 같지만 표현이 다른 글을 맞춰 주는 임베딩 모델과 후보를 다시 줄 세우는 리랭크 모델은 둘 다 선택 사항이고, 임베딩 모델을 끄면 BM25 키워드 검색이 중심이 됩니다.
- 왼쪽 내비게이션의 지식 베이스에서 새로 만들고 "주제 + 목적"으로 이름을 붙입니다. 임베딩 모델은 처음에는 "사용 안 함"으로 둡니다.
- 데이터 소스 추가에서 파일·노트·폴더·URL 중 자료에 맞는 입구를 고릅니다. 관련 없는 폴더를 통째로 넣지 않습니다.
- 처리가 끝나면 항목 한두 개를 열어 텍스트와 청크에 깨진 글자, 빠진 쪽, 순서 뒤섞임이 없는지 봅니다.
- 호출 테스트에 답을 이미 아는 실제 질문 3~5개를 넣고 맞는 출처가 위쪽에 나오는지 확인합니다.
- 안정적이면 채팅 입력 영역에서 이 지식 베이스를 고르고, 장기 업무라면 에이전트 편집 화면에서 연결합니다.
편집부가 만든 예시: 출장 규정 문서 세 개. 숙박, 교통, 결재 규정 문서 세 개로 “출장 규정” 지식 베이스를 만들고, 임베딩 모델 없이 시작합니다. 호출 테스트에는 “숙박 한도는 얼마인가”, “일정 금액 이상의 경비는 누가 결재하나”처럼 문서 제목이 아니라 실제로 묻는 말투를 씁니다. 합격 기준은 질문마다 올바른 규정 출처가 올라오고, 올라온 조각 하나에 조건과 결론이 같이 들어 있는 것입니다. 구어체 질문이 규정집 문구와 달라서 못 찾을 때만 임베딩 모델을 붙입니다. 클라우드 임베딩 모델을 쓰면 그 비용과 데이터 처리는 그 제공자 기준을 따릅니다.
운영에서 자주 놓치는 것은 두 가지입니다. 청크 분할 설정을 바꿔도 이미 넣은 자료는 자동으로 갱신되지 않으므로 다시 색인(Re-index)을 돌리고 같은 질문 묶음으로 다시 시험해야 비교가 됩니다. 그리고 가져오기 완료 표시는 처리가 끝났다는 뜻일 뿐 결과가 완전하다는 뜻이 아닙니다.
에이전트 구역: 실행 방식 둘, 권한 다섯, 붙이는 부품 넷
왼쪽 내비게이션의 Work는 채팅 어시스턴트(역할 프리셋)와 다른 시스템입니다. 스스로 도구를 부르고, 작업 폴더의 파일을 읽고 쓰고, 목표를 쪼개 하위 에이전트에 나누고, 오래 걸리는 명령을 백그라운드로 돌립니다. 에이전트는 기본 정보, 시스템 프롬프트, 스킬, 지식 베이스 네 단계로 만들고, 첫 단계에서 고르는 실행 방식은 만든 뒤에 바꿀 수 없습니다. Claude Agent 방식은 주 모델·계획 모델·소형 모델을 따로 지정하고 권한 모드 다섯 가지와 하트비트(주기적 점검)를 지원하는, 모를 때의 기본 선택입니다. Pi 방식은 주 모델 하나만 쓰는 가벼운 방식으로 “계획만 세우기”가 없고, 새로 만들면 “나 대신 승인”이 기본입니다.
권한은 가장 신중한 순서로 이렇게 갈립니다.
| 모드 | 동작 | 맞는 상황 |
|---|---|---|
| 행동 전에 묻기(Ask Before Acting) | 파일 수정·명령 실행 전에 묻는다 | 시작점. 실제 프로젝트 폴더 |
| 계획만 세우기(Plan Only) | 파일을 고치지 않고 읽기·검토된 명령만 실행 | 방안 검토, 배포 전 점검 |
| 편집 자동 수락(Auto-accept Edits) | 파일은 자유롭게 고치고 명령은 묻는다 | 되돌릴 수 있는 문서·코드 정리 |
| 나 대신 승인(Approve for Me) | 일상 승인을 생략하되 안전 점검이 위험 동작을 막는다 | 경계가 분명한 작업 |
| 전체 권한(Full Access) | 권한 점검을 건너뛴다 | 격리되고 복구 가능한 환경만. 파일 삭제·네트워크 접근 가능 |
모델이 “나 대신 승인”을 지원하지 않으면 매번 묻는 경우도 있습니다. 문서는 “행동 전에 묻기”로 시작하고, 작업이 파일을 다루면 필요한 폴더 하나만 작업 폴더로 지정하며, 방법이 안정된 뒤에야 손이 덜 가는 모드로 옮기라고 안내합니다.
에이전트의 능력을 넓히는 부품은 네 가지입니다. 서로 해결하는 문제가 달라서 다 설치할 필요가 없습니다.
브라우저·파일·셸·검색·기억·예약·하위 에이전트. 문서를 마크다운으로 바꾸는 도구는 스캔 PDF를 OCR하지 못함
에이전트가 검색할 사설 자료의 경계. 연결하지 않으면 검색 도구가 목록에 나오지 않음
따라야 할 절차·서식·기준 묶음. 외부 시스템에 연결하지는 않고, 스크립트가 들어 있을 수 있음
데이터베이스·브라우저·업무 시스템 같은 외부 도구와 자료. 로컬 명령(표준 입출력)이나 원격 주소(SSE·스트리밍 HTTP)로 등록
켜는 자리에서 막히기 쉽습니다. 스킬과 MCP를 설정에서 설치하고 연결했다고 모든 에이전트가 쓰는 것이 아니고, 에이전트 편집 화면의 스킬·MCP·지식 베이스 탭에서 따로 켜야 하며 다음 메시지부터 적용됩니다. 서버가 연결됐는데 도구가 안 보이면 에이전트에 바인딩됐는지, 도구가 꺼져 있지 않은지, 권한 요청이 대기 중인지를 순서대로 봅니다. 스킬은 에이전트로 만들기, 온라인 검색(GitHub의 SKILL.md 링크 포함), 이 컴퓨터에서 찾기, 로컬 가져오기(ZIP 또는 폴더)로 추가하며, 저장 전에 상세 화면에서 스크립트 유무와 필요한 도구·계정을 확인하라고 안내합니다. 출처를 모르는 스킬과 MCP 서버는 에이전트의 권한을 그대로 물려받는 외부 코드로 보는 편이 맞습니다.
메모리는 작업이나 폴더가 아니라 에이전트에 귀속됩니다. “외부에 내는 글은 존댓말을 쓰고 과장 제목을 피한다” 같은 오래 가는 규칙을 기억시키는 용도이고, 비밀번호·API 키·사생활 정보는 넣지 말라는 주의가 붙어 있습니다. 체계적인 문서 검색은 메모리가 아니라 지식 베이스의 일입니다. 에이전트가 멈춘 것 같을 때는 오른쪽 상태 패널을 먼저 봅니다. 권한 승인을 기다리는지, 백그라운드 명령이 아직 도는지, 하위 작업이 실패했는지, 제공자가 재시도 중인지가 여기에 나옵니다.
출구 하나: API 게이트웨이와 Code Mate
에이전트가 쓸 만해지면 이제 이 앱의 모델을 다른 프로그램에서도 쓰고 싶어집니다. 설정의 API 게이트웨이를 켜면 설정해 둔 모델이 OpenAI·Anthropic 호환 HTTP API로 내 컴퓨터에 열립니다. 에이전트 실행에 필요한 내부 서비스이기도 해서, Cherry Studio 에이전트만 쓴다면 “활성화 및 시작”만 누르면 되고 URL이나 키를 다른 곳에 복사할 일이 없습니다.
로컬 스크립트가 이 API를 부르게 하려면 순서가 있습니다. 포트는 게이트웨이가 멈춰 있을 때만 바꿀 수 있고(다른 프로그램이 쓰는 포트면 시작되지 않습니다), 시작해서 상태가 “실행 중”으로 바뀌면 URL과 API 문서 진입점이 나타납니다. 외부 프로그램은 Authorization: Bearer <API 키> 헤더로 접속하며, 처음에는 모델 목록 요청과 짧은 문장 하나로 연결과 생성을 따로 시험합니다. 게이트웨이는 모델을 제공하지 않고 연결된 제공자를 호환 인터페이스로 바꿔 줄 뿐이어서 제공자 하나 이상이 먼저 있어야 하고, 사용료는 실제 모델 제공자에게 청구되며 설정의 사용 통계에서 기록을 볼 수 있습니다.
열린 범위가 곧 위험의 범위. 다른 기기에서 접근하게 열면 노출 범위가 커집니다. 네트워크 수신 범위, 방화벽, 접근 통제는 직접 확인해야 하므로 디버깅 편의 때문에 LAN이나 인터넷에 여는 일은 피하고 로컬 전용으로 둡니다. 키는 저장소·이슈·로그·튜토리얼 스크린샷에 남기지 않습니다. 완료 기준은 게이트웨이를 멈춘 뒤 클라이언트가 더 이상 호출하지 못하는 것까지 확인하는 것입니다.
같은 게이트웨이를 쓰는 또 하나의 출구가 Code Mate입니다. 터미널 코딩 도구를 설치하고 설정하고 실행하는 화면으로, 목록에는 Claude Code, OpenAI Codex, Antigravity CLI, OpenCode, Qwen Code, Kimi Code, Qoder CLI, GitHub Copilot CLI, Pi, Hermes Agent, OpenClaw, DeepSeek Harness, MiniMax Code가 있고 보이는 항목은 업데이트에 따라 바뀝니다. 모델 서비스가 필요한 CLI에는 호환되는 제공자만 나열하고, “Unified Gateway(어떤 CLI든 모든 모델)“를 고르면 CLI가 Cherry Studio 게이트웨이를 거쳐 내가 설정한 아무 모델이나 씁니다. 자체 계정 로그인을 쓰는 CLI는 그 로그인 방식을 그대로 두면 됩니다. Claude Code는 모델 모드가 둘입니다. “일반”은 모든 요청에 같은 모델을 쓰고, “상세”는 Fable·Opus·Sonnet·Haiku·하위 에이전트 역할마다 모델을 따로 지정하며 비워 둔 역할은 주 모델을 따릅니다.
도구의 설치 출처는 세 가지로 구분됩니다.
| 출처 | Cherry Studio가 하는 일 | 관리하는 쪽 |
|---|---|---|
| Cherry Studio 관리 | 해당 복사본을 설치·업데이트·삭제 | Code Mate 또는 의존성 화면 |
| 시스템 PATH | 감지해서 그대로 사용, 덮어쓰지 않음 | 원래 패키지 관리자 |
| 앱 내장 | 그대로 사용, 시스템 삭제는 제공하지 않음 | Cherry Studio 업데이트 |
실행한 직후 첫 명령은 읽기 전용으로 합니다. 계정, 모델, 작업 폴더가 맞는지 보고 나서 파일 수정을 허락하는 순서입니다. 여기서 MCP와 방향이 반대라는 점도 짚어 둘 만합니다. MCP는 외부 도구를 Cherry Studio 안으로 들여오는 길이고, API 게이트웨이는 Cherry Studio의 모델을 다른 프로그램에 내주는 길입니다.
출구 둘: 메신저와 예약이 에이전트를 깨우는 순서
채널은 에이전트를 메신저에 붙입니다. 문서가 안내하는 플랫폼은 Telegram, Discord, Slack, QQ이고, 릴리스 노트에는 WeCom·DingTalk 채널(v2.1.5)과 Feishu 봇의 그룹 응답 옵션(v2.1.8, @멘션일 때만 응답)이 따로 나옵니다. 플랫폼마다 필요한 자격 증명이 다릅니다. Telegram은 봇 토큰과 채팅 ID, Discord는 봇 토큰과 채널 또는 DM ID, Slack은 봇 토큰과 앱 토큰(소켓 모드)과 채널 ID, QQ는 앱 ID와 클라이언트 시크릿이 필요합니다.
자동화는 구성 요소가 네 개이고 서로 하는 일이 다릅니다. 에이전트가 일을 하고, 채널이 외부 메시지를 받고 알림을 보내고, 예약 작업이 정해진 시각에 에이전트를 실행하고, 하트비트(기본 30분)가 진행 중인 일을 주기로 점검합니다. “오늘 새 소식이 있나”는 하트비트가, “평일 아침 일정 보고서”는 실행 계획과 로그가 남는 예약 작업이 맞습니다. 설정은 한 번에 다 하지 않고 이 순서를 지킵니다.
- 수동 실행Work에서 결과가 안정적일 때까지
- 채널 연결봇 토큰·전용 에이전트·전용 폴더
- 허용 대상 제한시험용 계정·그룹 ID만
- 예약 만들기한 번 직접 실행해 로그 확인
외부 메시지는 에이전트가 일하는 폴더 안에서 실행되므로, 개인 파일이 섞인 홈 폴더 대신 비워 둔 전용 폴더를 지정합니다. 허용 대상 ID 칸을 비워 두면 플랫폼에 따라 모든 발신자가 허용될 수 있어서, 처음에는 시험용 계정만 넣습니다. 형식이 헷갈리면 봇에 /whoami를 보내면 됩니다.
/whoami
(편집부 예시) 이 대화의 ID는 플랫폼 형식에 맞는 숫자 또는 문자열로 돌아온다. 그 값을 허용 대상 칸에 넣는다.
권한은 기본이 "에이전트 설정 상속"이다. 공개 그룹이나 여러 사람이 있는 방은 이보다 엄격하게 두고, 전체 권한은 권하지 않는다.
예약 작업의 알림 대상으로 채널이 목록에 안 나오면 먼저 그 플랫폼에서 봇에게 직접 메시지를 보내 채팅 ID가 기록되게 합니다. v2.1.8부터는 설정에서 새 작업을 만드는 대신 에이전트와 대화하면서 예약 작업을 만들 수도 있습니다. 실패했을 때는 “전송되지 않음”을 “실행되지 않음”으로 잘못 읽지 않도록 해당 작업의 실행 기록부터 봅니다.
출구 셋: 백업 파일 안에 들어 있는 것
마지막 출구는 데이터 자체가 앱을 떠나는 길입니다. 전체 백업에는 대화 기록과 토픽, 어시스턴트와 프리셋, 지식 베이스(벡터 데이터 포함), 노트·그림·파일·첨부, 환경설정, 그리고 제공자 설정과 API 키가 들어갑니다. 대화와 설정만 담는 Lite(슬림) 백업 스위치를 켜면 이미지·지식 베이스 같은 큰 데이터 파일을 건너뛰어 더 작고 빠르지만, 어느 쪽이든 백업 파일은 비밀 파일로 다룹니다.
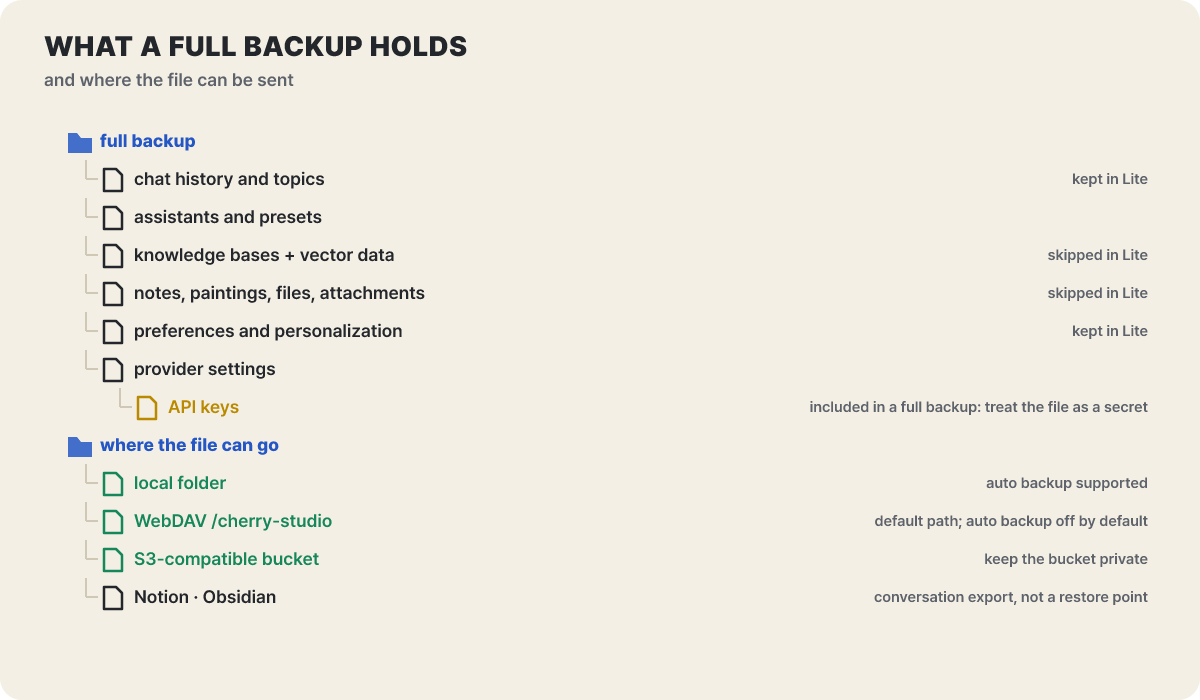 그림 4. 전체 백업은 키까지 담는다. Lite 백업은 이미지·지식 베이스 같은 데이터 파일을 건너뛴다
보관 위치마다 기본값이 달라서 켜기 전에 한 번 읽어 둘 만합니다.
| 보관 위치 | 기본값과 요령 |
|---|---|
| 로컬 폴더 | 백업 폴더를 고르면 자동 백업과 백업 파일 관리를 지원. 외장 드라이브에도 가능 |
| WebDAV | 기본 경로 /cherry-studio, 자동 백업은 꺼짐, 최대 백업 수는 무제한. 서버가 청크 업로드를 지원하지 않으면 스트림 업로드를 끄고, 자체 서명 인증서 허용은 내가 직접 운영하는 서버일 때만 |
| S3 호환 저장소 | 엔드포인트·버킷·리전·액세스 키가 필요. 버킷은 반드시 비공개 읽기·쓰기로 두라고 강조. Cloudflare R2는 리전에 auto |
| Notion·Obsidian | 대화를 보관용으로 내보내는 연동. 복원 지점이 아님 |
자동 백업은 몇 분에서 24시간까지의 주기로 돌고, 컴퓨터 A에서 백업해 B에서 복원하는 방식으로 기기 간 이동에도 씁니다. 백업 말고 앱이 데이터를 어디로 보내는지는 개인정보 처리방침(2026년 8월 20일 개정)과 데이터 설정 문서를 합치면 다음과 같습니다.
| 데이터 | 기본 동작 |
|---|---|
| API 키·대화 기록·지식 베이스 | 내 기기에 로컬 저장. 개발사가 수집하지 않는다고 명시 |
| 내가 설정한 제공자로 가는 요청 | 내 기기에서 그 제공자 서버로 직접 연결. 개발사 서버를 거치지 않음 |
| 내장 모델 서비스(키 없이 쓰는 모델) 요청 | 개발사의 중계 서비스를 거침. 요청 처리 후 저장하지 않는다고 명시 |
| 사용 통계·오류 로그 | 익명 정보를 기본 수집. 설정 → 데이터 설정 → 개인정보 설정에서 끌 수 있음 |
데이터 설정에는 되돌릴 수 없는 버튼도 있습니다. 캐시 정리에서 “V1 레거시 데이터”를 고르면 옛 V1 대화와 설정이 영구 삭제되어 복구할 수 없고, “앱 데이터 초기화”는 대화·어시스턴트·지식 베이스·파일·설정을 모두 지우고 앱을 다시 시작합니다. 문제 해결의 일상 수단이 아니니 실행 전에 전체 백업이 먼저입니다.
- 제공자마다 사용 한도를 낮게 건 전용 키를 만들어 등록한다
- 백업 파일은 키가 든 비밀 파일로 취급하고 공유 폴더나 메신저로 넘기지 않는다
- S3 호환 버킷은 비공개로 두고, WebDAV 자체 서명 인증서 허용은 내 서버에만 켠다
- 에이전트는 필요한 폴더만 열고 "행동 전에 묻기"로 시작한다
- 채널에는 시험 계정·그룹 ID만 허용하고, 게이트웨이는 로컬 전용으로 둔다
AGPL-3.0이 갈라 놓는 사용 범위
커뮤니티 에디션은 AGPL-3.0이고, 저장소는 조건을 모두 지키면 상업적 이용도 허용한다고 적고 있습니다. AGPL은 수정한 버전을 네트워크로 서비스할 때도 소스 공개 의무가 생기는 강한 카피레프트 라이선스입니다. 개인이 설치해 쓰는 데는 보통 걸림이 없지만, 자사 제품에 코드를 넣거나 수정판을 서비스로 제공하는 팀은 법무 검토가 필요합니다. 이 글은 법률 자문이 아니라 저장소가 밝힌 조건의 요약입니다.
팀 전체에 중앙 관리형으로 배포하려는 경우는 소스를 고치는 방식보다 두 가지 경로가 먼저입니다. 중앙 모델 관리, 공유 지식 베이스, 직원 접근 제어, 사설 배포를 갖춘 엔터프라이즈 에디션이 있고, AGPL 의무를 면제받는 상용 라이선스는 개발사(bd@cherry-ai.com)에 문의하라고 저장소가 안내합니다.
이 도구 다음에 이어 볼 글
Cherry Studio가 세 구역을 한 앱에 모아 둔 만큼, 구역마다 더 깊게 파고드는 글이 이 사이트에 있습니다. 입구 쪽에서는 내 컴퓨터에서 모델을 돌려 코딩 에이전트에 붙이는 Unsloth Desktop 글과, 쉬운 질문에 비싼 모델을 쓰지 않게 나눠 주는 LLM 라우팅 글이 이어집니다. 에이전트 쪽에서 외부 도구를 붙일 때는 구조를 설명한 MCP 입문 글을 먼저 읽고, 추천 목록에서 서버를 고르기 전에 보관 처리된 MCP 서버 정리 글을 확인할 만합니다. 출처를 모르는 스킬을 설치하기 전의 검사는 SkillSpector 글이 다룹니다.
한 서비스의 최신 기능만 쓰는 사람은 해당 서비스의 공식 앱이 가장 빨리 기능을 지원하니 Cherry Studio가 필요하지 않습니다. 개발 작업만 하는 사람은 터미널 코딩 에이전트가 더 직접적이고, Code Mate가 그 도구들을 실행하는 창구 역할만 맡습니다. 여러 모델, 내 문서, 에이전트를 한 창에서 오가고 싶은 개인이라면 이 도구를 설치하고 제공자 하나, 작은 지식 베이스 하나, “행동 전에 묻기” 에이전트 하나로 시작해 호출 테스트까지 돌려 보는 것이 가장 빠른 확인입니다.



